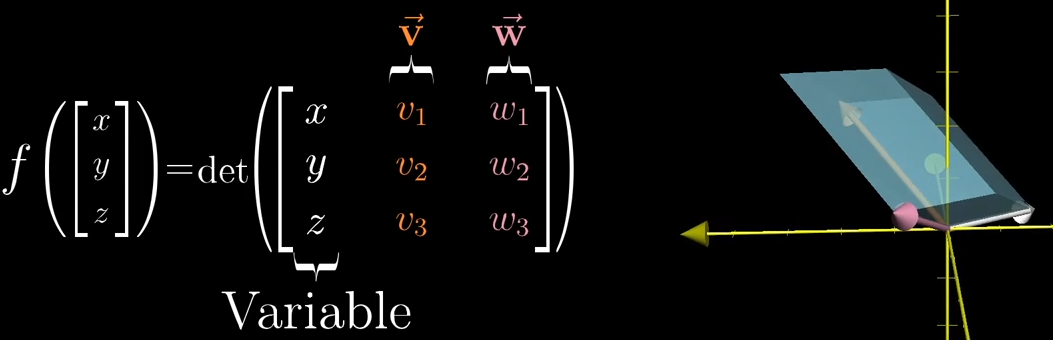
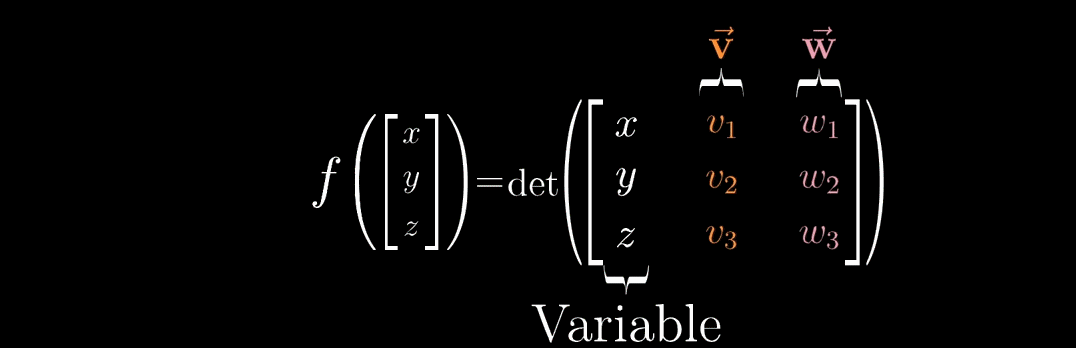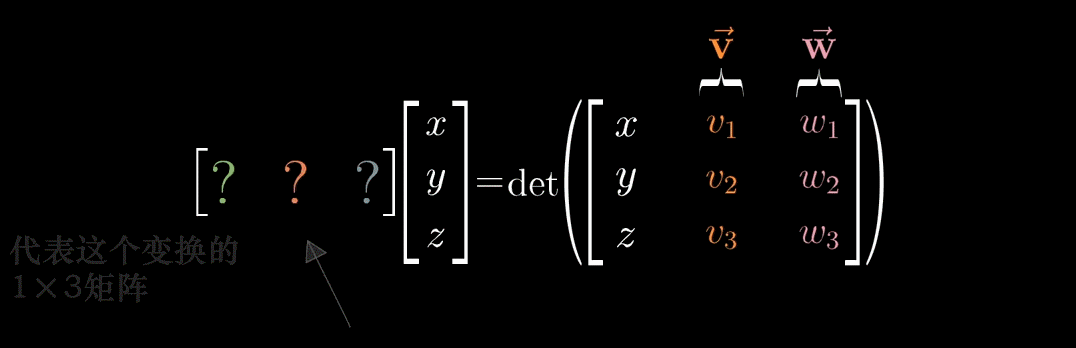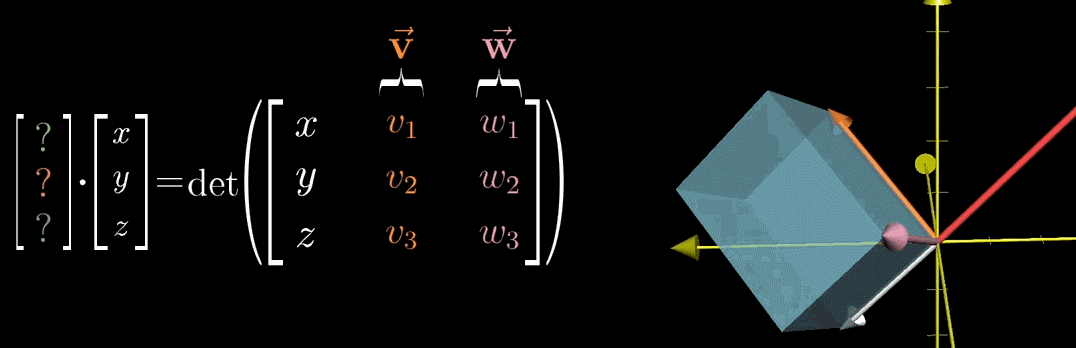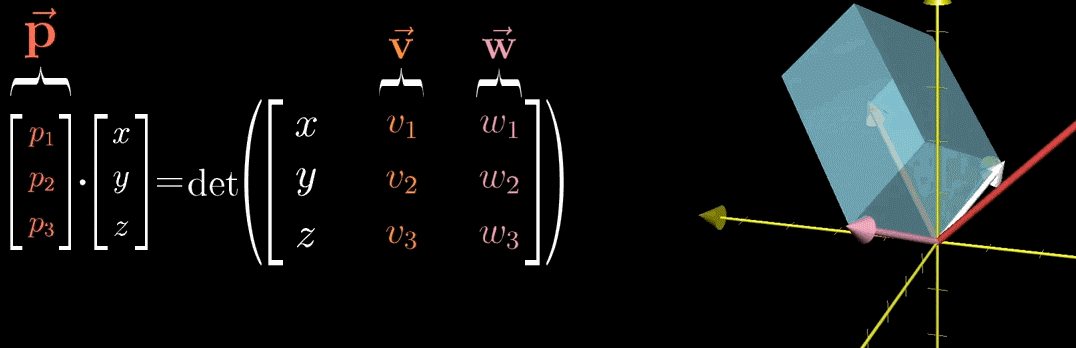<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Go Further</title>
  <icon>https://www.gravatar.com/avatar/3fc7f0484ec48b2da08be4c167579713</icon>
  <subtitle>Stay Hungry, Stay Foolish</subtitle>
  <link href="/atom.xml" rel="self"/>
  
  <link href="https://charlesliuyx.github.io/"/>
  <updated>2019-06-17T13:02:36.549Z</updated>
  <id>https://charlesliuyx.github.io/</id>
  
  <author>
    <name>遥行 Go Further</name>
    <email>297106826@qq.com</email>
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title>【教程】manim动画制作工具</title>
    <link href="https://charlesliuyx.github.io/2019/04/21/%E3%80%90%E6%95%99%E7%A8%8B%E3%80%91manim%E5%8A%A8%E7%94%BB%E5%88%B6%E4%BD%9C%E5%B7%A5%E5%85%B7/"/>
    <id>https://charlesliuyx.github.io/2019/04/21/【教程】manim动画制作工具/</id>
    <published>2019-04-21T04:06:00.000Z</published>
    <updated>2019-06-17T13:02:36.549Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】<br>【阅读内容】3B1B 自用动画生成神器教程<br><a id="more"></a></p><p><a href="https://github.com/3b1b/manim" target="_blank" rel="noopener">Github链接</a> <a href="https://talkingphysics.wordpress.com/2019/01/08/getting-started-animating-with-manim-and-python-3-7/" target="_blank" rel="noopener">教程英文版链接</a> <a href="https://manim.readthedocs.io/" target="_blank" rel="noopener">manim文档</a></p><h1 id="1-安装-manim"><a href="#1-安装-manim" class="headerlink" title="1 安装 manim"></a>1 安装 manim</h1><p>首先参考<a href="https://github.com/3b1b/manim" target="_blank" rel="noopener">Github链接</a></p><h1 id="2-做一个简单的视频"><a href="#2-做一个简单的视频" class="headerlink" title="2 做一个简单的视频"></a>2 做一个简单的视频</h1><h2 id="2-1-场景和动画"><a href="#2-1-场景和动画" class="headerlink" title="2.1 场景和动画"></a>2.1 场景和动画</h2><blockquote><p>Scenes ＆ Animation</p></blockquote><h1 id="3-更多可以使用的形状"><a href="#3-更多可以使用的形状" class="headerlink" title="3 更多可以使用的形状"></a>3 更多可以使用的形状</h1><h2 id="3-1-方向矢量"><a href="#3-1-方向矢量" class="headerlink" title="3.1 方向矢量"></a>3.1 方向矢量</h2><blockquote><p>Direction Vectors</p></blockquote><h2 id="3-2-制作一个简单的动画"><a href="#3-2-制作一个简单的动画" class="headerlink" title="3.2 制作一个简单的动画"></a>3.2 制作一个简单的动画</h2><h1 id="4-添加文字"><a href="#4-添加文字" class="headerlink" title="4 添加文字"></a>4 添加文字</h1><blockquote><p>Text</p></blockquote><h2 id="4-1-文字变形"><a href="#4-1-文字变形" class="headerlink" title="4.1 文字变形"></a>4.1 文字变形</h2><h2 id="4-2-文字的旋转和高亮"><a href="#4-2-文字的旋转和高亮" class="headerlink" title="4.2 文字的旋转和高亮"></a>4.2 文字的旋转和高亮</h2><h1 id="5-数学公式"><a href="#5-数学公式" class="headerlink" title="5 数学公式"></a>5 数学公式</h1><h2 id="5-1-给对象上色"><a href="#5-1-给对象上色" class="headerlink" title="5.1 给对象上色"></a>5.1 给对象上色</h2><h1 id="6-对齐文本并使用大括号"><a href="#6-对齐文本并使用大括号" class="headerlink" title="6 对齐文本并使用大括号"></a>6 对齐文本并使用大括号</h1><h1 id="7-坐标轴和绘图"><a href="#7-坐标轴和绘图" class="headerlink" title="7 坐标轴和绘图"></a>7 坐标轴和绘图</h1><h2 id="7-1-配置文件"><a href="#7-1-配置文件" class="headerlink" title="7.1 配置文件"></a>7.1 配置文件</h2><h1 id="8-更高级的绘图"><a href="#8-更高级的绘图" class="headerlink" title="8 更高级的绘图"></a>8 更高级的绘图</h1><h1 id="9-向量场"><a href="#9-向量场" class="headerlink" title="9 向量场"></a>9 向量场</h1><h2 id="9-1-简单向量场"><a href="#9-1-简单向量场" class="headerlink" title="9.1 简单向量场"></a>9.1 简单向量场</h2><h2 id="9-2-带有变量的向量场"><a href="#9-2-带有变量的向量场" class="headerlink" title="9.2 带有变量的向量场"></a>9.2 带有变量的向量场</h2><h1 id="10-运动电荷场例子"><a href="#10-运动电荷场例子" class="headerlink" title="10 运动电荷场例子"></a>10 运动电荷场例子</h1><h2 id="10-1-更进一步的优化"><a href="#10-1-更进一步的优化" class="headerlink" title="10.1 更进一步的优化"></a>10.1 更进一步的优化</h2><h1 id="11-3D场景"><a href="#11-3D场景" class="headerlink" title="11 3D场景"></a>11 3D场景</h1><h1 id="12-SVG格式支持"><a href="#12-SVG格式支持" class="headerlink" title="12 SVG格式支持"></a>12 SVG格式支持</h1>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】&lt;br&gt;【阅读内容】3B1B 自用动画生成神器教程&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Math" scheme="https://charlesliuyx.github.io/categories/Math/"/>
    
    
      <category term="3B1B" scheme="https://charlesliuyx.github.io/tags/3B1B/"/>
    
      <category term="manim" scheme="https://charlesliuyx.github.io/tags/manim/"/>
    
      <category term="Tutorial" scheme="https://charlesliuyx.github.io/tags/Tutorial/"/>
    
  </entry>
  
  <entry>
    <title>【直观算法】二叉搜索树算法总结</title>
    <link href="https://charlesliuyx.github.io/2018/10/28/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91%E4%BA%8C%E5%8F%89%E6%90%9C%E7%B4%A2%E6%A0%91%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93/"/>
    <id>https://charlesliuyx.github.io/2018/10/28/【直观算法】二叉搜索树算法总结/</id>
    <published>2018-10-28T13:35:54.000Z</published>
    <updated>2018-11-26T22:32:27.327Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】<br>【阅读内容】结合Leetcode相关算法题总结<strong>二叉搜索树</strong>的相关算法，包括基本的二叉搜索构建和应用，附带一些关于AVL树，红黑树的基本概念梳理</p><a id="more"></a><h1 id="是什么"><a href="#是什么" class="headerlink" title="是什么"></a>是什么</h1><p><strong>二叉搜索树</strong>（Binary Search Tree）BST是大名鼎鼎的搜索算法。在算法界，$O(n)$ 到 $O(\log_2 n)$ 的效率优化大多和<code>BST</code>有关</p><p>用白话文来说，二叉搜索树是<strong>一颗对于所有节点<code>左孩子 ＜ 根</code>，<code>右子树 ＞ 根</code>的二叉树</strong></p><h1 id="基本操作"><a href="#基本操作" class="headerlink" title="基本操作"></a>基本操作</h1><h2 id="构建"><a href="#构建" class="headerlink" title="构建"></a>构建</h2><p>相关例题：<a href="https://leetcode.com/problems/convert-sorted-array-to-binary-search-tree/" target="_blank" rel="noopener">108. Convert Sorted Array to Binary Search Tree</a></p><p>已经给出了定义，<code>Leetcode</code>中有一道将<strong>升序数组</strong>转换成<strong>平衡</strong>二叉搜索树的题目。根据<a href="https://charlesliuyx.github.io/2018/10/22/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91%E6%A0%91%E7%9A%84%E5%9F%BA%E6%9C%AC%E6%93%8D%E4%BD%9C/#%E4%B8%AD%E5%BA%8F%E9%81%8D%E5%8E%86">二叉树遍历一节</a>的内容，中序遍历的顺序是<code>左 ➜ 根 ➜ 右</code>，再结合二叉搜索树的定义。观察知，<strong>二叉搜索树的中序遍历就是一个升序数组</strong>。那么问题就转换成了，哪颗<strong>平衡二叉树</strong>的中序遍历是这个<strong>升序数组</strong></p><p>因为题目要求<code>平衡</code>二叉树，保证所有子树的高度一样，必须二分输入序列</p><p>假设输入序列为<code>[-10,-3,0,5,9]</code>，根节点一定在<code>mid = (start + end) // 2</code> 位置，由<strong>递归思维</strong>：假设再次调用的函数的返回值是已经完成的子树，也就是说只需把<code>[0, mid-1]</code>代表的树作为左子树，和<code>[mid+1, end]</code>代表的树作为右子树即可</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">sortedArrayToBST</span><span class="params">(self, nums)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type nums: List[int]</span></span><br><span class="line"><span class="string">        :rtype: TreeNode</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> nums: <span class="keyword">return</span> <span class="keyword">None</span></span><br><span class="line">        </span><br><span class="line">        mid = len(nums) // <span class="number">2</span></span><br><span class="line">        root = TreeNode(nums[mid])</span><br><span class="line">        root.left = self.sortedArrayToBST(nums[ : mid])</span><br><span class="line">        root.right = self.sortedArrayToBST(nums[mid+<span class="number">1</span> : ])</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> root</span><br></pre></td></tr></table></figure><h2 id="查找"><a href="#查找" class="headerlink" title="查找"></a>查找</h2><p>相关例题：<a href="https://leetcode.com/problems/search-in-a-binary-search-tree" target="_blank" rel="noopener">700. Search in a Binary Search Tree</a></p><p>最常见的二叉树操作，查找一个对应节点，平均查找长度为 $\log_2(n)$ 。二叉搜索树性质，左孩子＜根＜右孩子，按照规律进行递归即可。省略迭代写法，只需要按照顺序进行一个节点一个节点顺下即可，非常简单</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">searchBST</span><span class="params">(self, root, val)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :type val: int</span></span><br><span class="line"><span class="string">        :rtype: TreeNode</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> root <span class="keyword">or</span> root.val == val:</span><br><span class="line">            <span class="keyword">return</span> root</span><br><span class="line">        <span class="keyword">return</span> self.searchBST(root.left, val) <span class="keyword">if</span> val &lt; root.val <span class="keyword">else</span> self.searchBST(root.right, val)</span><br></pre></td></tr></table></figure><h2 id="判断"><a href="#判断" class="headerlink" title="判断"></a>判断</h2><p>相关例题：<a href="https://leetcode.com/problems/validate-binary-search-tree" target="_blank" rel="noopener">98. Validate Binary Search Tree</a>    </p><p>【输入】给定一个树的结构【操作】判断这颗树是不是二叉搜索树【输出】<code>True</code> or <code>False</code></p><p>① 使用中序遍历，结果是<strong>升序序列</strong>则为二叉搜索树（前面讲定义的时候已经讲解的原因）</p><p>② 去重复操作。①中在遍历过程就可<strong>做判断</strong>，不需要重新再做一次升序判断</p><p>这里实现使用迭代写法，递归写法比较简单</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span><span class="params">(object)</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">isValidBST</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: bool</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        </span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> <span class="keyword">True</span></span><br><span class="line">        stack, inorder = [], []   </span><br><span class="line">        p_node = root</span><br><span class="line">        pre_node_val = float(<span class="string">"-inf"</span>)</span><br><span class="line">        <span class="keyword">while</span> stack <span class="keyword">or</span> p_node:  </span><br><span class="line">            <span class="keyword">while</span> p_node:</span><br><span class="line">                stack.append(p_node)</span><br><span class="line">                p_node = p_node.left      </span><br><span class="line">            cur_node = stack.pop()</span><br><span class="line">            inorder.append(cur_node.val)</span><br><span class="line">            <span class="keyword">if</span> pre_node_val &gt;= cur_node.val:</span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">False</span></span><br><span class="line">            pre_node_val = cur_node.val      </span><br><span class="line">            <span class="keyword">if</span> cur_node.right:</span><br><span class="line">                p_node = cur_node.right     </span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">True</span></span><br></pre></td></tr></table></figure><h2 id="删除"><a href="#删除" class="headerlink" title="删除"></a>删除</h2><p>二叉查找树中的删除节点操作，<a href="https://zh.wikipedia.org/wiki/%E4%BA%8C%E5%85%83%E6%90%9C%E5%B0%8B%E6%A8%B9#%E5%9C%A8%E4%BA%8C%E5%8F%89%E6%9F%A5%E6%89%BE%E6%A0%91%E5%88%A0%E9%99%A4%E7%BB%93%E7%82%B9%E7%9A%84%E7%AE%97%E6%B3%95" target="_blank" rel="noopener">详见链接</a></p><p>需要分为3种情况进行讨论</p><ul><li><strong>没有孩子</strong>的节点 ➜ 直接将它删除即可，它的父节点的孩子替换成空</li><li>只有<strong>一个孩子</strong>的节点 ➜ 直接上升孩子的位子替代被删除的即可</li><li>有<strong>两个孩子</strong>的节点 ➜ 此种情况比较麻烦，需要参看<a href="https://zh.wikipedia.org/wiki/%E4%BA%8C%E5%85%83%E6%90%9C%E5%B0%8B%E6%A8%B9#%E5%9C%A8%E4%BA%8C%E5%8F%89%E6%9F%A5%E6%89%BE%E6%A0%91%E5%88%A0%E9%99%A4%E7%BB%93%E7%82%B9%E7%9A%84%E7%AE%97%E6%B3%95" target="_blank" rel="noopener">详细链接</a></li></ul><h1 id="相关题目"><a href="#相关题目" class="headerlink" title="相关题目"></a>相关题目</h1>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】&lt;br&gt;【阅读内容】结合Leetcode相关算法题总结&lt;strong&gt;二叉搜索树&lt;/strong&gt;的相关算法，包括基本的二叉搜索构建和应用，附带一些关于AVL树，红黑树的基本概念梳理&lt;/p&gt;
    
    </summary>
    
      <category term="Algorithm" scheme="https://charlesliuyx.github.io/categories/Algorithm/"/>
    
    
      <category term="Tree" scheme="https://charlesliuyx.github.io/tags/Tree/"/>
    
      <category term="Optimization" scheme="https://charlesliuyx.github.io/tags/Optimization/"/>
    
  </entry>
  
  <entry>
    <title>【直观算法】二叉树遍历算法总结</title>
    <link href="https://charlesliuyx.github.io/2018/10/22/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91%E6%A0%91%E7%9A%84%E5%9F%BA%E6%9C%AC%E6%93%8D%E4%BD%9C/"/>
    <id>https://charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/</id>
    <published>2018-10-22T07:53:27.000Z</published>
    <updated>2018-11-06T20:27:02.272Z</updated>
    
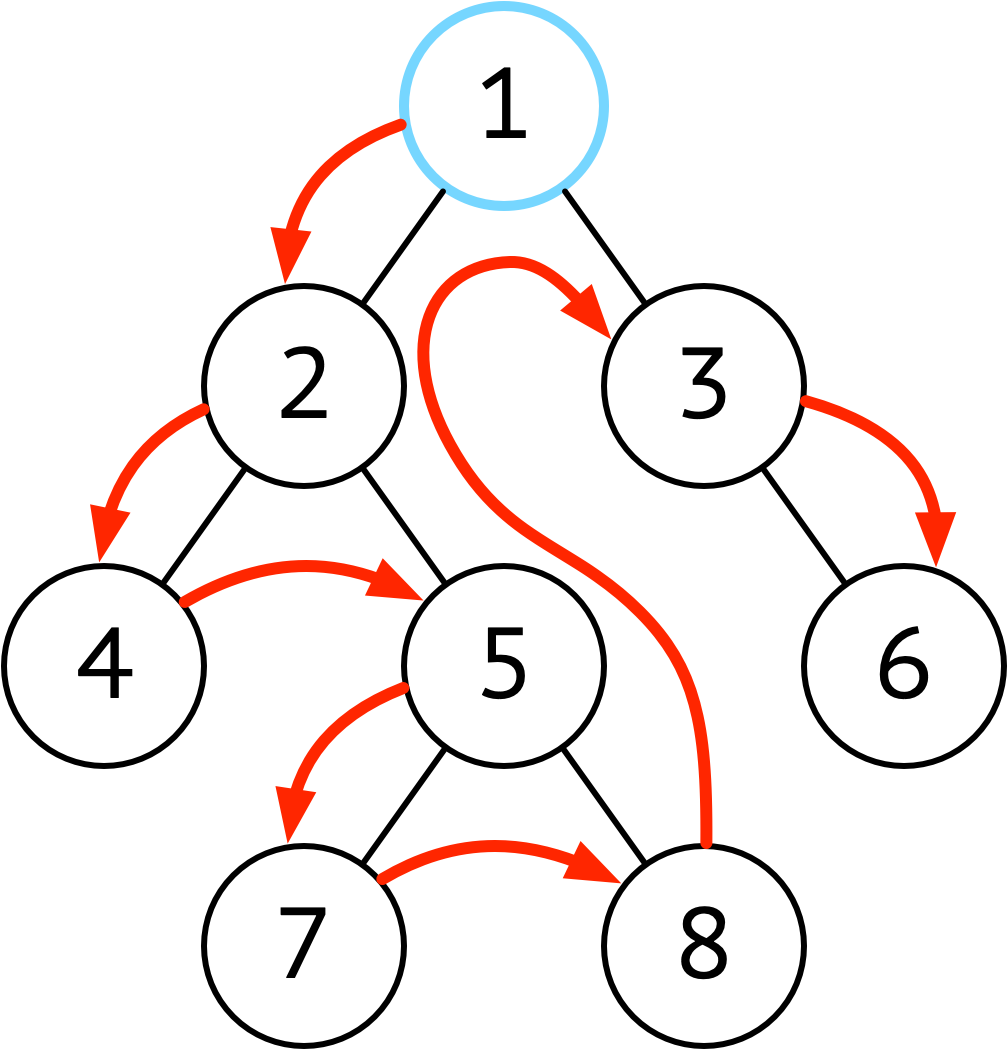
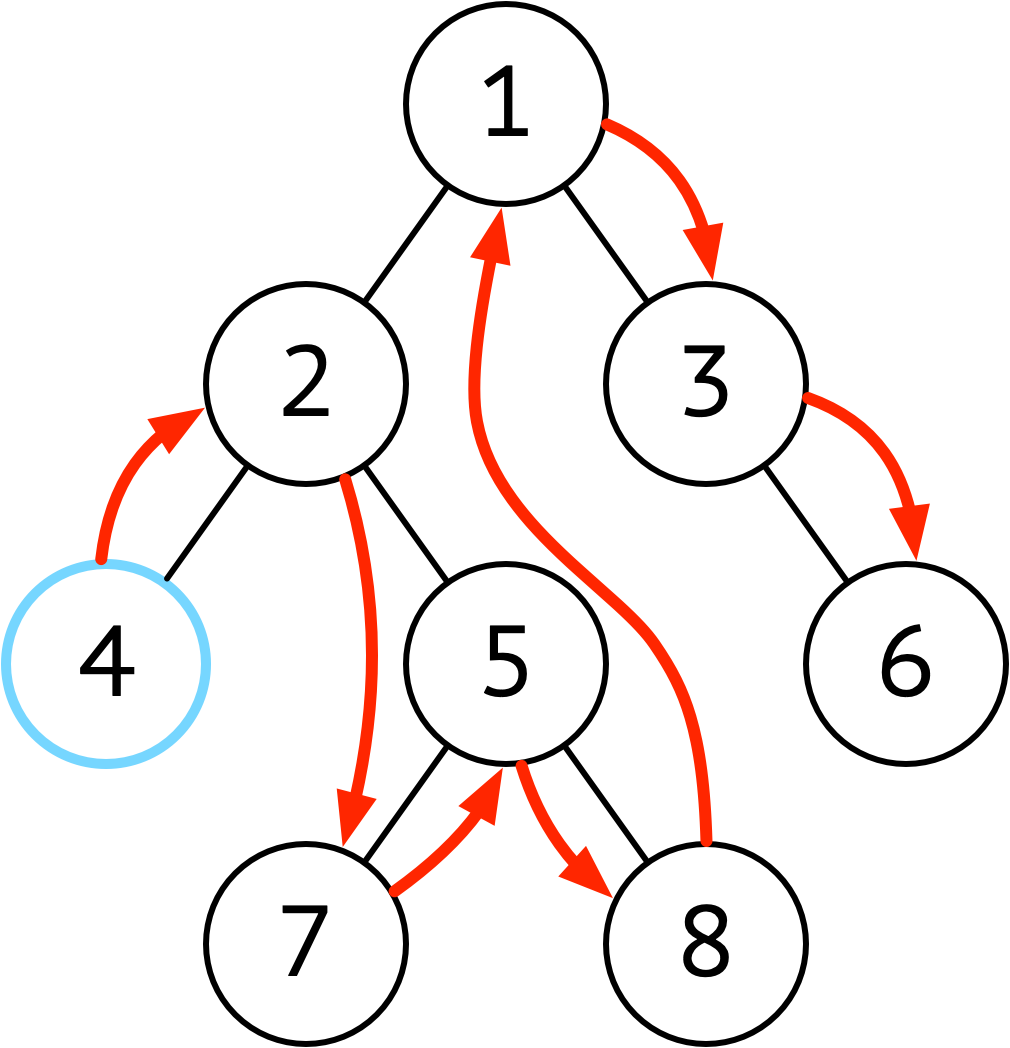
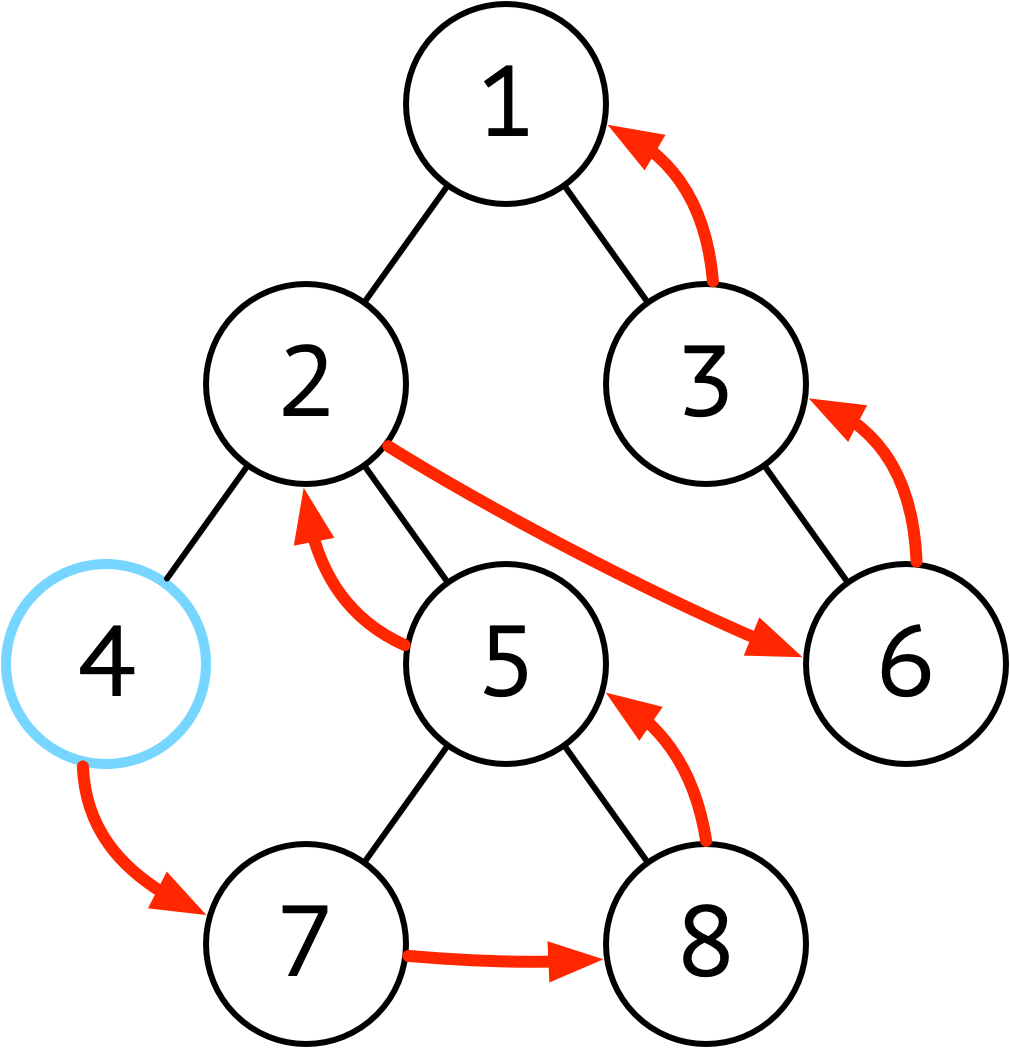
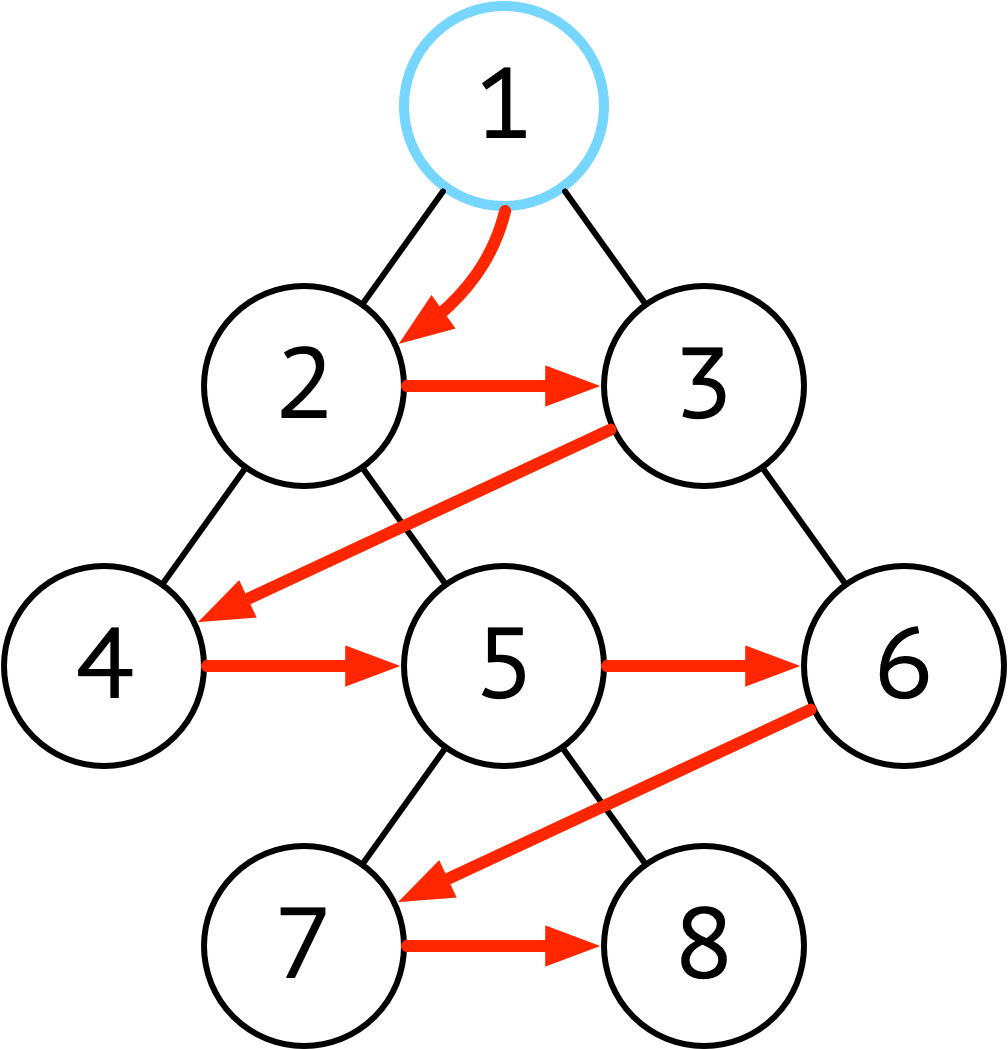
    <content type="html"><![CDATA[<p>【阅读时间】7 - 10 min | 4300字<br>【阅读内容】结合应用场景，总结有关<strong>二叉树遍历</strong>的所有算法和对应Leetcode题目编号。基于<code>Python</code>代码，给出完整逻辑链。<strong>希望给读者一个线头，让你永远忘不了这几个遍历算法</strong></p><a id="more"></a><h1 id="遍历算法总览"><a href="#遍历算法总览" class="headerlink" title="遍历算法总览"></a>遍历算法总览</h1><p>遍历的含义就是把树的所有节点（Node）按照<strong>某种顺序</strong>访问一遍。包括<strong>前序</strong>，<strong>中序</strong>，<strong>后续</strong>，<strong>广度优先</strong>（队列），<strong>深度优先</strong>（栈）5中遍历方法</p><table><thead><tr><th style="text-align:center">遍历方法</th><th style="text-align:center">顺序</th><th style="text-align:center">示意图</th><th style="text-align:center">应用</th></tr></thead><tbody><tr><td style="text-align:center">前序</td><td style="text-align:center"><strong>根 ➜ 左 ➜ 右</strong></td><td style="text-align:center"><div align="center"><img src="//charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/Pre-Order.png" alt="" width="150"></div></td><td style="text-align:center">想在节点上直接执行操作（或输出结果）使用先序</td></tr><tr><td style="text-align:center">中序</td><td style="text-align:center"><strong>左 ➜ 根 ➜ 右</strong></td><td style="text-align:center"><div align="center"><img src="//charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/In-Order.png" alt="" width="150"></div></td><td style="text-align:center">在<strong>二分搜索树</strong>中，中序遍历的顺序符合从小到大（或从大到小）顺序的<br>要输出排序好的结果使用中序</td></tr><tr><td style="text-align:center">后序</td><td style="text-align:center"><strong>左 ➜ 右 ➜ 根</strong></td><td style="text-align:center"><div align="center"><img src="//charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/Post-Order.png" alt="" width="150"></div></td><td style="text-align:center">后续遍历的特点是在执行操作时，肯定<strong>已经遍历过该节点的左右子节点</strong><br>适用于进行破坏性操作<br>比如删除所有节点，比如判断树中是否存在相同子树</td></tr><tr><td style="text-align:center">广度优先</td><td style="text-align:center"><strong>层序，横向访问</strong></td><td style="text-align:center"><div align="center"><img src="//charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/Breadth-First.png" alt="" width="150"></div></td><td style="text-align:center">当<strong>树的高度非常高</strong>（非常瘦）<br>使用广度优先剑节省空间</td></tr><tr><td style="text-align:center">深度优先</td><td style="text-align:center"><strong>纵向，探底到叶子节点</strong></td><td style="text-align:center"><div align="center"><img src="//charlesliuyx.github.io/2018/10/22/【直观算法】树的基本操作/Deep-First.png" alt="" width="150"></div></td><td style="text-align:center">当<strong>每个节点的子节点非常多</strong>（非常胖），使用深度优先遍历节省空间<br>（访问顺序和入栈顺序相关，想当于先序遍历）</td></tr></tbody></table><p>关于应用部分，选择遍历方法的基本的原则：<span style="font-weight:bold;color: red">更快的访问到你想访问的节点</span>。先序会先访问根节点，后序会先访问叶子节点</p><p>需要说明的是，递归是一种<code>拆分思维</code>的具体问题类别的思维方法，其核心的思维我觉得和动态规划非常类似，都是<strong>假设子节点搞定了我现在应该干什么</strong>这个问题</p><p>先确定<code>Python</code>语言下的<code>TreeNode</code>定义</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">TreeNode</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">__init__</span><span class="params">(self, x)</span>:</span></span><br><span class="line">        self.val = x</span><br><span class="line">        self.left = <span class="keyword">None</span></span><br><span class="line">        self.right = <span class="keyword">None</span></span><br></pre></td></tr></table></figure><p>需要输出遍历结果时直接输出保存<code>val</code>的数组即可</p><blockquote><p>关于递归算法的解释，博主打算写一份<a href="">【直观算法】汉诺塔问题最全解答</a>，过后可能会更新，是一篇小品文，比较短，这篇文章只是希望让所有阅读的人能一次就直观的搞明白汉诺塔的算法是怎么做的，永远记住它，也搞懂递归算法</p></blockquote><p>三种遍历方法，都有一个特点，无论是先序<code>根 ➜ 左 ➜ 右</code>，中序<code>左 ➜ 根 ➜ 右</code>，后序<code>左 ➜ 右 ➜ 根</code>，所谓的<strong>访问顺序</strong>，根是最重要，根才代表了<strong>访问</strong>这个动作（在我们的代码中，就是把节点中的<strong>值</strong>加入到输出数组中），⭐️而<code>根</code>在的位置决定了<strong>是否可以访问的条件</strong></p><p>比如对于<strong>中序</strong>来说，<code>根</code>在<code>左</code>的后面，意味着，只要当前操作的节点有<code>左</code>节点，就不能输出<code>根</code>里面的值</p><p>对于<strong>后序</strong>来说，有了这个直观理解，对理解三者的迭代算法有帮助</p><h1 id="先序遍历"><a href="#先序遍历" class="headerlink" title="先序遍历"></a>先序遍历</h1><p>在线刷题：<a href="https://leetcode.com/problems/binary-tree-preorder-traversal/" target="_blank" rel="noopener">Leetcode 44. Binary Tree Preorder Traversal</a></p><h2 id="递归算法"><a href="#递归算法" class="headerlink" title="递归算法"></a>递归算法</h2><p>所谓递归（Recursive），即把函数本身<strong>看成一个已经有解的子问题</strong></p><p>定义函数<code>preorderTraversal(self, node)</code>返回以<code>node</code>为答案的先序遍历结果的数组，假设它的两个孩子<code>node.left</code>和<code>node.right</code>已经搞定了，即可以返回答案的输出数组。那么思考最终的输出数组是什么样的，很明显要满足<code>根 ➜ 左 ➜ 右</code>的规则，应该返回<code>[node.val] + preorderTraversal(self, node.left) + preorderTraversal(self, node.right)</code>（函数返回的就是一个数组，只需要把它们拼接起来即可）</p><p>之后再完善防御性编程的基本步骤（保证函数输入有效），按照这个思路就可以写出先序遍历的递归代码。<code>Python</code>代码的特点是可读性比较强，这样一行代码简洁明了，能简洁的表达上面的<strong>逻辑链推理过程</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">preorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        <span class="keyword">return</span> [] <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span> <span class="keyword">else</span> [root.val] + self.preorderTraversal(root.left) + self.preorderTraversal(root.right)</span><br></pre></td></tr></table></figure><p>当然，如果不使用<code>Python</code>，在语法上无法写的这么简短。常见的<strong>标准</strong>写法是使用<code>helper()</code>函数，具体实现见下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">preorderTraversal1</span><span class="params">(self, root)</span>:</span></span><br><span class="line">    result = []</span><br><span class="line">    self.helper(root, result)</span><br><span class="line">    <span class="keyword">return</span> result</span><br><span class="line">    </span><br><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">helper</span><span class="params">(self, root, result)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> root:</span><br><span class="line">        result.append(root.val)</span><br><span class="line">        self.helper(root.left, result)</span><br><span class="line">        self.helper(root.right, result)</span><br></pre></td></tr></table></figure><h2 id="迭代算法"><a href="#迭代算法" class="headerlink" title="迭代算法"></a>迭代算法</h2><p>同理，递归算法使用系统栈，不好控制，性能问题比较严重，需要进一步了解不用递归如何实现。为了维护固定的访问顺序，使用<strong>栈</strong>数据结构的<strong>先入后出</strong>特性</p><p>先处理根节点，根据访问顺序<code>根 ➜ 左 ➜ 右</code>，先入栈的后访问，为了保持访问顺序（先入后出），<strong>⭐️先把右孩子入栈，再入栈左孩子</strong>（此处需要注意，出栈才是访问顺序）</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">preorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> root: <span class="keyword">return</span> []</span><br><span class="line">        </span><br><span class="line">        result, stack = [], [root]</span><br><span class="line">    </span><br><span class="line">        <span class="keyword">while</span> stack:</span><br><span class="line">            cur_node = stack.pop() <span class="comment"># 访问根节点，直接进行操作(输出到数组)</span></span><br><span class="line">            result.append(cur_node.val)</span><br><span class="line">            <span class="keyword">if</span> cur_node.right: <span class="comment"># 先入栈右节点</span></span><br><span class="line">                stack.append(cur_node.right)</span><br><span class="line">            <span class="keyword">if</span> cur_node.left: <span class="comment"># 后入栈左节点，这样下一轮循环先访问左节点，维护了访问顺序</span></span><br><span class="line">                stack.append(cur_node.left)</span><br><span class="line">                </span><br><span class="line">        <span class="keyword">return</span> result</span><br></pre></td></tr></table></figure><h1 id="中序遍历"><a href="#中序遍历" class="headerlink" title="中序遍历"></a>中序遍历</h1><p>在线刷题：<a href="https://leetcode.com/problems/binary-tree-inorder-traversal/" target="_blank" rel="noopener">94. Binary Tree Inorder Traversal</a></p><h2 id="递归算法-1"><a href="#递归算法-1" class="headerlink" title="递归算法"></a>递归算法</h2><p>同理于前序遍历，一模一样的处理方法，考虑访问顺序为<code>左 ➜ 根 ➜ 右</code>即可，快速模仿并写出代码</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">inorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        <span class="keyword">return</span> [] <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span> <span class="keyword">else</span> self.inorderTraversal(root.left) + [root.val] + self.inorderTraversal(root.right)</span><br></pre></td></tr></table></figure><p>同理在这里也附上使用<code>helper()</code>函数的标准写法，代码上来说，只<strong>变了名称</strong>和<strong>访问顺序</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">inorderTraversal1</span><span class="params">(self, root)</span>:</span></span><br><span class="line">    result = []</span><br><span class="line">    self.helper(root, result)</span><br><span class="line">    <span class="keyword">return</span> result</span><br><span class="line">    </span><br><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">helper</span><span class="params">(self, root, result)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> root:</span><br><span class="line">        self.helper(root.left, result)</span><br><span class="line">        result.append(root.val)</span><br><span class="line">        self.helper(root.right, result)</span><br></pre></td></tr></table></figure><h2 id="迭代算法-1"><a href="#迭代算法-1" class="headerlink" title="迭代算法"></a>迭代算法</h2><p>核心思路依旧是利用栈维护节点的访问顺序：<code>左 ➜ 根 ➜ 右</code>。使用一个<code>p_node</code>来指向当前<strong>访问节点</strong>，<code>p</code>是代表指针<code>point</code>，另外有一个变量<code>cur_node</code>表示当前正在<strong>操作节点</strong>（把出栈节点值加入输出数组中），算法步骤如下（可以对照代码注释）</p><p>① 访问当前节点，如果当前节点有左孩子，则把它的左孩子都入栈，移动当前节点到左孩子，重复第一步直到<strong>当前节点</strong>没有左孩子</p><p>② 当<strong>当前节点</strong>没有左孩子时，栈顶节点出栈，加入结果数组</p><p>③ <strong>当前节点</strong>指向<strong>栈顶节点</strong>的右节点</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">inorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        result, stack = [], []</span><br><span class="line">        </span><br><span class="line">        p_node = root <span class="comment"># 当前访问节点指针</span></span><br><span class="line">        <span class="keyword">while</span> p_node <span class="keyword">or</span> stack:</span><br><span class="line">            </span><br><span class="line">            <span class="keyword">while</span> p_node: <span class="comment"># 把所有当前访问节点的左孩子都入栈</span></span><br><span class="line">                stack.append(p_node)</span><br><span class="line">                p_node = p_node.left</span><br><span class="line">            </span><br><span class="line">            cur_node = stack.pop() <span class="comment"># 操作栈顶节点，如果是第一次运行到这步，那么这是整棵树的最左节点</span></span><br><span class="line">            result.append(cur_node.val) <span class="comment"># 因为已经保证没有左节点，可以访问根节点</span></span><br><span class="line">            <span class="keyword">if</span> cur_node.right:</span><br><span class="line">            p_node = cur_node.right <span class="comment"># 将指针指向当前节点的右节点</span></span><br><span class="line">        </span><br><span class="line">        <span class="keyword">return</span> result</span><br></pre></td></tr></table></figure><p>如果想要精简代码，从逻辑上来看，<code>p_node</code>可以使用<code>root</code>代替，这样写只是为了让代码更可读，和逻辑链相切合，方便理解</p><h1 id="后续遍历"><a href="#后续遍历" class="headerlink" title="后续遍历"></a>后续遍历</h1><p>在线刷题：<a href="https://leetcode.com/problems/binary-tree-postorder-traversal/" target="_blank" rel="noopener">145. Binary Tree Postorder Traversal</a></p><h2 id="递归算法-2"><a href="#递归算法-2" class="headerlink" title="递归算法"></a>递归算法</h2><p>同理<a href="#先序遍历">先序遍历</a>，代码如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">postorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        <span class="keyword">return</span> [] <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span> <span class="keyword">else</span> self.postorderTraversal(root.left) + self.postorderTraversal(root.right) + [root.val]</span><br></pre></td></tr></table></figure><p>节省版面，使用<code>helper()</code>函数的写法只需要改变<strong>函数名</strong>和<strong>访问顺序</strong></p><h2 id="迭代算法-1"><a href="#迭代算法-1" class="headerlink" title="迭代算法 1"></a>迭代算法 1</h2><p>后序遍历<strong>访问顺序</strong>要求为<code>左 ➜ 右 ➜ 根</code>，在对<strong>访问节点</strong>进行<strong>操作</strong>的条件是，它的<strong>左子树和右子树都已经被访问</strong>。这样算法的框架就出来了：只需要对每个节点进行标记，表示这个节点有没有被访问，一个节点能否进行<strong>操作</strong>的条件就是这个节点的左右节点都被访问过了。</p><p>因为栈<code>先入后出</code>，为了维护访问顺序满足条件，入栈顺序应该是<code>根 ➜ 右 ➜ 左</code>（和要求访问顺序相反）。代码如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">postorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        </span><br><span class="line">        result, stack = [], [(root, <span class="keyword">False</span>)]</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">while</span> stack:</span><br><span class="line">            cur_node, visited = stack.pop()</span><br><span class="line">            <span class="keyword">if</span> visited: <span class="comment"># 只有访问状态为True的节点才能被操作</span></span><br><span class="line">                result.append(cur_node.val)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                stack.append((cur_node, <span class="keyword">True</span>))</span><br><span class="line">                <span class="keyword">if</span> cur_node.right:</span><br><span class="line">                    stack.append((cur_node.right, <span class="keyword">False</span>))</span><br><span class="line">                <span class="keyword">if</span> cur_node.left:</span><br><span class="line">                    stack.append((cur_node.left, <span class="keyword">False</span>))</span><br><span class="line">                    </span><br><span class="line">        <span class="keyword">return</span> result</span><br></pre></td></tr></table></figure><h2 id="迭代算法-2"><a href="#迭代算法-2" class="headerlink" title="迭代算法 2"></a>迭代算法 2</h2><p>还有一种迭代算法利用后序遍历的本身属性，注意到后序遍历的顺序是<code>左 ➜ 右 ➜ 根</code>，那么反序的话，就直接倒序的输出结果，即<strong>反后序</strong>：<code>根 ➜ 右 ➜ 左</code>，和先序遍历的<code>根 ➜ 左 ➜ 右</code>对比，发现只需要稍微改一下代码就可以得到<strong>反后序</strong>的结果，参考先序遍历，代码如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">preorderTraversal</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[int]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        </span><br><span class="line">        result, stack = [], [root]</span><br><span class="line">    </span><br><span class="line">        <span class="keyword">while</span> stack:</span><br><span class="line">            cur_node = stack.pop()</span><br><span class="line">            result.append(cur_node.val)</span><br><span class="line">            <span class="keyword">if</span> cur_node.left: <span class="comment"># 修改顺序</span></span><br><span class="line">                stack.append(cur_node.left)</span><br><span class="line">            <span class="keyword">if</span> cur_node.right: <span class="comment"># 修改顺序</span></span><br><span class="line">                stack.append(cur_node.right)</span><br><span class="line">                </span><br><span class="line">        <span class="keyword">return</span> result[::<span class="number">-1</span>] <span class="comment"># 反序操作</span></span><br></pre></td></tr></table></figure><h1 id="广度遍历"><a href="#广度遍历" class="headerlink" title="广度遍历"></a>广度遍历</h1><p><strong>从上到下</strong>的层序<a href="https://leetcode.com/problems/binary-tree-level-order-traversal/" target="_blank" rel="noopener">102. Binary Tree Level Order Traversal</a> </p><p><strong>从下到上</strong>的层序（Bottom-up） <a href="https://leetcode.com/problems/binary-tree-level-order-traversal-ii/" target="_blank" rel="noopener">107. Binary Tree Level Order Traversal 2</a></p><p>按照层序进行遍历的的过程，有两种说法，一种是按照层序的从顶到底的（level order），另一种是从底到顶的（bottom up），具体实现上来说，就是输出反序即可。在具体问题设计上可能有区别，但是基本思路不变</p><p>广度遍历的核心思路就是使用队列，即<code>先进先出 First-in First-out</code>，这里很关键的一点就是以<code>层</code>来作为入队和出队的判断条件。并且因为按照层的顺序，是<strong>从左到右</strong>，所以遍历顺序（入队顺序）为<code>左 ➜ 右</code></p><p>基本思路参看代码注释，逻辑比较简单。实现上，使用<code>Python</code>中的自带类<code>deque</code>来实现，新建为<code>queue = deque([])</code>，入队为<code>queue.append()</code>，出队为<code>queue.popleft()</code></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> collections <span class="keyword">import</span> deque</span><br><span class="line"></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">levelOrder</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: List[List[int]]</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        result, queue = [], deque([root])</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">while</span> queue:</span><br><span class="line">            level_len = len(queue) <span class="comment"># 记录现在队列中的节点数量</span></span><br><span class="line">            level_nodes = [] <span class="comment"># 每层输出</span></span><br><span class="line">            <span class="keyword">while</span> level_len &gt; <span class="number">0</span>: <span class="comment"># 具体出队入队操作，保证本层所有节点的子节点都入队</span></span><br><span class="line">                cur_node = queue.popleft()</span><br><span class="line">                level_nodes.append(cur_node.val)</span><br><span class="line">                <span class="keyword">if</span> cur_node.left:</span><br><span class="line">                    queue.append(cur_node.left)</span><br><span class="line">                <span class="keyword">if</span> cur_node.right:</span><br><span class="line">                    queue.append(cur_node.right)</span><br><span class="line">                level_len -= <span class="number">1</span></span><br><span class="line">            result.append(level_nodes)</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">return</span> result</span><br></pre></td></tr></table></figure><h1 id="Brew作者被拒的题"><a href="#Brew作者被拒的题" class="headerlink" title="Brew作者被拒的题"></a>Brew作者被拒的题</h1><p><a href="https://leetcode.com/problems/invert-binary-tree" target="_blank" rel="noopener">226. Invert Binary Tree</a>，就是一道基本的树的遍历题。有故事说<code>Mac</code>包管理工具<code>Brew</code>的作者<code>Max</code>在Google被面试这道题，没写出来，被拒了。之后<code>Max</code>去了Apple。个人感觉，对于遍历的理解，如果是真的根据<strong>逻辑链理解</strong>，且对<strong>递归有着深刻的理解</strong>，那实在不应该写不出这道题，因为真的很简单</p><p>题目是这样说的，要求把一颗二叉树的所有左右子树互换位置</p><h2 id="递归算法-3"><a href="#递归算法-3" class="headerlink" title="递归算法"></a>递归算法</h2><p>假设左右子树都搞定了，那么当前节点需要的操作为：把当前节点的左右孩子互换即可，写成递归非常简洁</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">invertTree</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: TreeNode</span></span><br><span class="line"><span class="string">        """</span></span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        <span class="comment"># 在本节点的操作，左右孩子互换</span></span><br><span class="line">        root.left, root.right = root.right, root.left</span><br><span class="line">        <span class="comment"># 已经搞定的左右孩子，使用递归的思路写出函数表达式  </span></span><br><span class="line">        self.invertTree(root.right) <span class="comment"># 下面两句的顺序并不重要</span></span><br><span class="line">        self.invertTree(root.left)</span><br><span class="line">        <span class="keyword">return</span> root</span><br></pre></td></tr></table></figure><h2 id="迭代算法-2"><a href="#迭代算法-2" class="headerlink" title="迭代算法"></a>迭代算法</h2><p>因为对于每一个节点，只需要把它的左右孩子互换位置，并且依次遍历即可，使用<code>DFS</code>或<code>BFS</code>都是一样的，这里用使用栈的<strong>深度优先搜索</strong>举例</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span>:</span></span><br><span class="line">    <span class="function"><span class="keyword">def</span> <span class="title">invertTree</span><span class="params">(self, root)</span>:</span></span><br><span class="line">        <span class="string">"""</span></span><br><span class="line"><span class="string">        :type root: TreeNode</span></span><br><span class="line"><span class="string">        :rtype: TreeNode</span></span><br><span class="line"><span class="string">        """</span>   </span><br><span class="line">        <span class="keyword">if</span> root <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> []</span><br><span class="line">        stack = [root]</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">while</span> stack:</span><br><span class="line">            cur_node = stack.pop()</span><br><span class="line">            <span class="comment"># 对当前节点进行操作</span></span><br><span class="line">            cur_node.left, cur_node.right = cur_node.right, cur_node.left</span><br><span class="line">            <span class="comment"># 进行入栈操作，保证访问到每一个节点</span></span><br><span class="line">            <span class="keyword">if</span> cur_node.left: stack.append(cur_node.left)</span><br><span class="line">            <span class="keyword">if</span> cur_node.right: stack.append(cur_node.right)</span><br><span class="line">            </span><br><span class="line">        <span class="keyword">return</span> root</span><br></pre></td></tr></table></figure><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>二叉树遍历问题最关键的<strong>逻辑链记忆点</strong>如下</p><ol><li><p>遍历顺序</p><p>⭐️<strong>遍历顺序</strong>非常重要，即<code>某 ➜ 某 ➜ 某</code>。如果这一点你不太记得，我认为在考试的过程中可以尝试向面试官确认，<code>某</code>的带选项只有三个，就是<code>根</code>，<code>左</code>，<code>右</code>，全排列也只有<code>6</code>种，长时间不用不记得也是情有可原的。所以在这里非常优秀</p></li><li><p>递归 ➜ 假设搞定了</p></li></ol><p>确认遍历顺序后，写出递归方法的核心思维是：⭐️<strong>假设左右孩子搞定了（搞定的方式就是调用函数本身，替换自变量即可），现在怎么做才能得到最终答案</strong></p><ol start="3"><li>迭代 ➜ 根的位置</li></ol><p>一般面试官会继续询问迭代方法如何写，这里的核心思维是：⭐️<strong>关注<code>根</code>的位置</strong>，<code>根</code>对应的就是出栈输出的操作（在例题中就是添加到输出数组）</p><p>那么根据<strong>遍历顺序</strong>，⭐️只要<code>根</code>之前的<code>左</code>或<code>右</code>孩子<strong>不为空</strong>就<strong>不能出栈输出</strong>，要<strong>继续入栈</strong>（办法自己想即可，每次可能写出来的代码都不同，但是思路相同。需要例子，可以参考<a href="#中序遍历">中序</a>和<a href="#后序遍历">后序</a>里的迭代算法部分）</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】7 - 10 min | 4300字&lt;br&gt;【阅读内容】结合应用场景，总结有关&lt;strong&gt;二叉树遍历&lt;/strong&gt;的所有算法和对应Leetcode题目编号。基于&lt;code&gt;Python&lt;/code&gt;代码，给出完整逻辑链。&lt;strong&gt;希望给读者一个线头，让你永远忘不了这几个遍历算法&lt;/strong&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Algorithm" scheme="https://charlesliuyx.github.io/categories/Algorithm/"/>
    
    
      <category term="Tree" scheme="https://charlesliuyx.github.io/tags/Tree/"/>
    
      <category term="Optimization" scheme="https://charlesliuyx.github.io/tags/Optimization/"/>
    
  </entry>
  
  <entry>
    <title>【直观算法】Egg Puzzle 鸡蛋难题</title>
    <link href="https://charlesliuyx.github.io/2018/10/11/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91Egg%20Puzzle%20%E9%B8%A1%E8%9B%8B%E9%9A%BE%E9%A2%98/"/>
    <id>https://charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/</id>
    <published>2018-10-11T14:39:43.000Z</published>
    <updated>2018-11-26T22:33:32.687Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】10000+字 | 17 - 22 min<br>【阅读内容】Google面试题：100层楼，两个鸡蛋<strong>最少用多少次</strong>能测出鸡蛋的<strong>会在哪一层碎</strong></p><a id="more"></a><p>分享者是最大的受益者，感谢您的阅读！<a href="https://zhuanlan.zhihu.com/p/47184570" target="_blank" rel="noopener">知乎文章链接，走过路过求个赞</a>，<a href="">相关问题答案</a></p><h1 id="1-题目描述"><a href="#1-题目描述" class="headerlink" title="1. 题目描述"></a>1. 题目描述</h1><p>有栋楼高<code>100层</code>，一个鸡蛋从<code>第x层</code>以上($&gt;$)的楼层落下来会<strong>摔碎</strong>， 在<code>第x层</code>和以下($\leqslant$)的楼层落下<strong>不会摔碎</strong>。给你<code>2</code>个鸡蛋，<strong>设计方案</strong>找出<code>x</code>，保证在<strong>最坏情况</strong>下， <strong>最小扔鸡蛋尝试的次数</strong></p><p>有时候仍的东西会变，比如<strong>瓶子</strong></p><p>这道题目的整个解答过程涉及给类<strong>逻辑思维</strong>，<strong>工程思维</strong>，当真是一道海纳百川的面试题，也难怪Goolge会以这道题做了多年的试金石</p><h2 id="1-1-求什么？"><a href="#1-1-求什么？" class="headerlink" title="1.1 求什么？"></a>1.1 求什么？</h2><p>利用<code>抽象思维</code>，<strong>符号化</strong>题目描述</p><p>⭐️〔题目要求〕找到 $x$ 层落下不会碎，$x+1$ 层落下会碎的<strong>临界层</strong>所需要的最少尝试次数 $r$ (r for result)</p><h1 id="2-解题思路"><a href="#2-解题思路" class="headerlink" title="2. 解题思路"></a>2. 解题思路</h1><p>使用<code>等价思维</code>，如何<strong>计算出</strong>最小的尝试次数？使用函数方法表示为：<strong>如何计算出这个结果</strong>，找出公式 $r = f()$</p><h2 id="2-1-一个鸡蛋"><a href="#2-1-一个鸡蛋" class="headerlink" title="2.1 一个鸡蛋"></a>2.1 一个鸡蛋</h2><p>假设最后结果设为 $r$ 次（r for result）。使用<code>归纳思维</code>，先看只拥有<code>1</code>个鸡蛋的情况，思考什么是<code>最坏情况</code>。你可能说可以直接使用二分法，请注意，只有<code>1</code>个鸡蛋，必须保证找到<strong>临界层</strong>。所以，<code>1</code>个鸡蛋的情况下，<strong>最坏情况</strong>为 $r = 100$ （楼高）</p><blockquote><p>大多数情况下，我们都低估了<strong>理解题意</strong>的重要性</p></blockquote><p>这么思考<strong>还不够究竟</strong>，缺乏<code>抽象思维</code></p><p>通过逻辑思考，可得 $r =100$ ，但有没有一个抽象的<strong>公式化结论</strong>？或者说，如何通过<strong>一个公式</strong>算出 $r$ ？接下来就来解决这个问题</p><p>假设<strong>临界层</strong>分别为 $x = 1,2,3 \dots 100$ ，因为你只有<code>1</code>个鸡蛋，不知道会在哪层碎，所以唯一<strong>策略</strong>是从<code>1</code>层开始<strong>一层一层</strong>试，对应的每个策略都有一个<strong>尝试步数</strong>（比如 $x = 95$ ，从<code>1</code>层开始尝试为<code>95</code>次），可得到<strong>临界层</strong> $x$ 在<strong>所有可能取值下</strong>对应的 $r = 1,2,3 \dots 99,100$，最终选择<strong>最坏情况</strong>，即 $r = 100$ </p><p>可抽象化得到<strong>待求的符号表达式</strong><br>$$<br>r = \max_{1 \leqslant x \leqslant N}(\forall S_i(x)) \tag{1}<br>$$<br>公式的<strong>语言型描述</strong>是：对于每一个可能的<strong>临界层</strong> $x$，得到使用可选择策略 $S_i()$ 需要的<strong>尝试步数</strong>。在每一轮 $x$ 的遍历中，取<strong>最大值</strong>（即<strong>最坏情况</strong>），为 $r$。无论<strong>临界层</strong> $x$ 在哪一层，<strong>只有一个鸡蛋的情况下</strong>，总需考虑<strong>最坏情况</strong></p><blockquote><p>这道题，对<code>1</code>个鸡蛋问题的深刻理解异常重要。只有深刻理解基石逻辑才能更好的解决问题</p></blockquote><h2 id="2-2-两个鸡蛋"><a href="#2-2-两个鸡蛋" class="headerlink" title="2.2 两个鸡蛋"></a>2.2 两个鸡蛋</h2><h3 id="2-2-1-粗调和细调"><a href="#2-2-1-粗调和细调" class="headerlink" title="2.2.1 粗调和细调"></a>2.2.1 粗调和细调</h3><p>依据<code>粗条细调思维</code>，我们有一次试错的机会。可以思考，假设第一个鸡蛋在 $k$ 层<code>碎了</code>，意味着什么？意味着，待求的<strong>临界层</strong> $x$ 一定满足 $1 \leqslant x \lt k$ ，记为 $[1,k)$ ，就把待求量<strong>限制到了一个更小的范围</strong>内，可以提高找到目标值的效率</p><p>也就是说，使用第一个鸡蛋做<strong>粗调</strong>，<code>碎了</code>后，用第二个鸡蛋，参照<code>1</code>个鸡蛋的尝试策略<strong>细调</strong>。下一步，问题就变成了一个策略问题，即<strong>❓第一个鸡蛋应该在哪些层仍</strong></p><p>在某层楼，丢一个鸡蛋，有两种结果：<code>碎了</code>和<code>没碎</code>。这句话是一个<strong>极为关键的信号</strong>，背后告诉我们这是一个<strong>树形结构</strong>问题</p><blockquote><p>把<strong>数据结构与问题描述的勾连能力</strong>是衡量算法能力的重要指标</p></blockquote><ul><li>没有分叉，一路推理 ➜ <strong>〔线性结构〕</strong></li><li>看到决策结果<strong>有分叉</strong> ➜ <strong>〔树形结构〕</strong></li><li>若在推理过程中，产生<strong>交汇</strong> ➜ <strong>〔图结构〕</strong></li></ul><p>下一节主要<strong>分析这条树形结构链</strong></p><h3 id="2-2-2-树形结构"><a href="#2-2-2-树形结构" class="headerlink" title="2.2.2 树形结构"></a>2.2.2 树形结构</h3><p>假设第一个鸡蛋的楼层策略是 $k_1, k_2,\cdots,k_p$ ，其中 $p$ 是<code>仍的总次数</code>，楼高记为 $N$ 。比如如果你选择在 $20,40,60,80$ 层仍，那么 $p=4$ ，根据题意，有 $1 \lt k_1 \lt k_2 \lt \cdots \lt k_{p-1} \lt k_p \lt N$ 。画出树形示意图，如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/Tree.png" alt="" width="700"></div><blockquote><p>图最上方的数轴就是一个<strong>横放的楼</strong>，$k_0 = 1$ 为第一层</p><p><strong>〔解释这棵树〕</strong>在每一层扔下一个鸡蛋时，都有两种可能，<code>碎了</code>和<code>没碎</code>，分别对应了两个子树。一旦<code>碎了</code>，那么就使用<code>1</code>个鸡蛋的问题思路来解题，直到找到<strong>临界层</strong>。在 $k_1$层<code>没碎</code>，那么需在 $k_2$ 层继续尝试，直到最高层 $N$ 找到<strong>临界层</strong>（上图的标注不是树高，是<strong>灰色图例标识出部分</strong>的<strong>树高</strong>）</p></blockquote><p>观察这颗树，怎样从树中得到对应问题的答案呢？</p><p>〔输入自变量〕 $k_1, k_2,\cdots,k_p$ 〔待求〕最小的尝试次数（即所有策略中<strong>最大值的最小值</strong>）等价于➜  求一个策略组合 $k_1, k_2,\cdots,k_p$，使得<strong>树的高度最小</strong></p><p>如果还是有些无法理解，此时，最好的方法就是<strong>看特例（举例子）</strong></p><p>🌰 比如 $k_1 = 50$，意思是在<code>50层</code>扔下第一个鸡蛋</p><ul><li>如果<code>碎了</code>，那么接下来的尝试方法就是从第<code>1</code>层开始<strong>一个一个往上</strong>尝试，直到<code>49</code>层，所以我们的答案 r = 50 （不记得如何计算这个值可以参考<a href="#2-1-一个鸡蛋">一个鸡蛋</a>） </li><li>如果<code>没碎</code>，那么第一个鸡蛋继续在 k_2 = 75 层扔，假设还是<code>没碎</code>，继续从 k_3 = 90 层的地方扔下，此时碎了，那么第二课鸡蛋就需要从<code>76</code>层开始，一层一层往上尝试直到<code>89</code>层，需要 89-76+1=24 次，第一个鸡蛋已经扔了<code>3</code>次，最后得到<code>没碎</code>情况下的例子的答案 r=27 次</li></ul><blockquote><p>在上面的例子中，$k_1=50,k_2=75, k_3=90$ 就是一个可选策略</p><p>体会<strong>最坏情况下的最小值</strong>的意义非常重要，或者说，尝试的<strong>最大步数的最小值</strong>。如何判断对一道题目有没有完全吃透，看能否清晰的走完每一个例子，就能一窥一二</p></blockquote><h3 id="2-2-3-最优解的情况证明"><a href="#2-2-3-最优解的情况证明" class="headerlink" title="2.2.3 最优解的情况证明"></a>2.2.3 最优解的情况证明</h3><p>⭐️ 接下里需要<strong>确定树的形状（同时也是确定策略的过程）</strong>。从<strong>直觉</strong>来看，如果树的形状倾向于<strong>满二叉树</strong>，那么树的<strong>高度最小</strong>。❓ 如何证明<strong>这个直觉</strong>的正确性呢？既然要计算树高，那么就把每一个<strong>叶子节点的树高</strong>一个一个<strong>列出来</strong><br> $$\left.\begin{array}{l}k_1 \\k_2 -k_1 +1 \\k_3-k_2 +2 \\\cdots \\k_p - k_{p-1} +{p-1} \\N- k_p + p \\\end{array}\right\} \sum = N + \frac{(1+p)p}{2} \tag{2}$$</p><p>经计算发现，<strong>所有树高的和</strong>是个<strong>定值</strong>。那么使用<strong>反证法</strong>，假设这棵树不是满树，因为高度和为定值，那么必定有一个<strong>高于平均值得树</strong>存在，记为 $T$ 。根据最高树的最小值的要求 $H_a ＜ H_T$ （$H_a$为满树的高度），答案是$H_a$ ，与不是满树的假设矛盾 。所以，是满树。证毕</p><div align="center"><img src="//charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/Tree.png" alt="" width="400"></div><p>再参考树的示意图，所谓<strong>类似满二叉树</strong>是指<strong>每棵子树的树高相等</strong>，比如列出下面等式（每一行都是左右两颗子树相等，比如 $k_2$ 那棵树的树高即 $k_2 - k_1 -1 +2$），一层一层带入，都换成 $k_1$ 的表达式<br>$$\begin{array} \\k_1 &= k_2 - k_1 + 1 &\implies &k_2 = 2k_1 - 1 = k_1 + (k_1 - 1) \\k_2 -k_1 +1 &= k_3-k_2 +2 &\implies &k_3 = 3k_1 -3 = k_1 + (k_1 -1) + (k_1 -2) \\\cdots \\k_{p-1} -k_{p-2} +p-2 &= k_{p}-k_{p-1}+ p - 1 &\implies &k_p = \underbrace{ k_1 + (k_1-1) + (k_1-2) + \cdots }_{p项}\end{array} \tag{3}$$</p><p>根据上述推倒发现规律：要满足条件<strong>每颗子树的树高相等</strong>，$k_p$ 的表达式是一个<strong>递减等差数列</strong>，最终必须在第 $N$ 层尝试（最后一次尝试走 $N - k_p$ 步，必须覆盖最后一层 $N$） 。即<strong>在最小可分割的整数等差递减数列中</strong>，令 $k_p \sim N$ （趋近于），前半句加粗的话翻译成公式为</p><p>$$<br>k_1 + (k_1-1) + (k_1-2) + \cdots + 1 \sim N \implies \frac{k_1(k_1 + 1)}{2} = N \tag{4}<br>$$</p><p>解得 $k_1 \approx 13.65$ ，考虑到，所有<strong>尝试楼层都是整数</strong>，第一颗鸡蛋最后一次<code>1</code>颗鸡蛋的<strong>尝试区间</strong>需包含第 $N$ 层，所以 $k_1 = \lceil k_1\rceil = 14$ 。如果不明白为什么取上整数不取下整数，试试 $k_1 = 13$ 或 $k_1 = 14$ 对比一下答案，看看谁的尝试次数少即可</p><p>有了 $k_1$ ，带回<a href="#2-2-3-最优解的情况证明">（2）式</a>，可以知道<strong>第一个鸡蛋</strong>的<strong>尝试楼层策略</strong>为 $14,27,39,50,60,69,77,84, 90,95,99$ </p><p>使用这个策略，带回<a href="#2-1-一个鸡蛋">（1）式</a>，假设<strong>临界层</strong>从<code>1</code>到<code>N</code>层，<strong>分别计算</strong>所需要的<strong>最多尝试次数</strong>，可得 $r = 14$ </p><p>如果楼高 $N=200$，可计算得 $r = k_1 = 20$，策略为：第一次从<code>20</code>层开始尝试，没多一次尝试递减<code>1</code> </p><p>⭐️ 到此为止，<code>2</code>个鸡蛋问题解决：找到了一个明确的函数，利用<code>抽象思维</code>，写出它的表达式 $r = f(2, N)$，而这个 $f()$ 即求方程 $\frac{x(x+1)}{2} = N$ 解 $x$ 的上整数 $\lceil x \rceil$</p><h1 id="3-问题拓展"><a href="#3-问题拓展" class="headerlink" title="3. 问题拓展"></a>3. 问题拓展</h1><p><code>2</code>个鸡蛋<code>100</code>层楼已经解决，深究下去，<code>H</code>层楼<code>M</code>个鸡蛋的问题呢？Leetcode有这道题：<a href="https://leetcode.com/problems/super-egg-drop/description/" target="_blank" rel="noopener">887. Super Egg Drop</a></p><blockquote><p>刷题多的读者会<strong>快速反应出</strong>，这个问题是一道<strong>动态规划</strong>题，但在这里我还是想用一种<strong>推理的思维</strong>来尝试分析一遍，<strong>逻辑链上的关键锚点才是知识的精华</strong></p><p>如果你通过观察题目，快速确定此题<strong>可用动态规划求解</strong>，这种能力是<strong>熟练能力</strong>，类似弹钢琴的熟能生巧，背书的死记硬背。与之相对，即<strong>分析能力</strong>。很有趣的是，这两种能力的分野十分明显，前者对应<strong>高效</strong>，后者对应<strong>求知</strong></p><p>如果你需要<strong>快速通过面试</strong>，<strong>找工作</strong>或<strong>通过考试</strong>，那大量做题才是最短路径，可学习的目的不止是谋生，还有一种<strong>更高级的快乐</strong>来自于<strong>钻研本身</strong>，心理学管这种快乐为<strong>心流</strong></p></blockquote><p>回到问题，总结一下，通过<a href="#2-解题思路">上面的解答</a>我们有了什么一些什么<strong>直观的结论</strong></p><p>① <code>1</code>个和<code>2</code>个鸡蛋的问题已经解决</p><p>② 理解了<strong>最大值的最小值</strong>在本题中的含义</p><p>③ 答案的值只和<strong>楼层高度</strong>有关，和最低楼层与最高楼层无关</p><p>以这三个结论为基石，想一想这道更一般化的问题怎么解决</p><h2 id="3-1-符号化描述"><a href="#3-1-符号化描述" class="headerlink" title="3.1 符号化描述"></a>3.1 符号化描述</h2><p>首先，最容易想到的思考链条来自一个设问：❓我们能不能尝试把<strong>鸡蛋的数量减少</strong>？即不断的往<code>2</code>个鸡蛋的问题上靠拢？有一个很简单的办法，就是<strong>扔</strong> ➜ 扔碎一个，鸡蛋数量就减少一个</p><p>照这个思路，进行一个<strong>抽象推演</strong>：假设在某一个时刻，我们拥有 $m$ 个鸡蛋，需要实验的层高为 $h$ （h for height），此刻在 $k \in [1, h]$ 层楼扔下一个鸡蛋</p><h3 id="〔情况-1〕-碎了"><a href="#〔情况-1〕-碎了" class="headerlink" title="〔情况 1〕 碎了"></a>〔情况 1〕 碎了</h3><p>假设我们已经知道 $1$ 到 $k-1$ 层楼<strong>最优解的值</strong>，❓ 那怎么用<strong>一个函数</strong>来表示这个值呢？首先看我们需要的自变量有哪些</p><ul><li>1）此时<strong>剩下的鸡蛋数</strong>，这个非常明显，符号化记为 $m$ 个鸡蛋</li><li>2）根据<code>2个鸡蛋</code>难题时的结论可知，第二个自变量是此时<strong>未知情况楼层的层高</strong>（未知情况只楼层范围内还从来没有用鸡蛋尝试过，无法缩小范围），符号化记为 $h$ 层（h for height）</li></ul><p><span id="define_status">⭐️ 用一个表达式 $r = f(h, m)$ 表示<strong>楼高</strong>为 $h$ 时，还<strong>剩下 $m$ 个鸡蛋</strong>时的<strong>最少尝试步数</strong></span></p><p>因为在 $k$ 层碎了，所以不用考虑<code>[k+1, N]</code>层的情况（肯定都碎），并且因为此刻这一个鸡蛋<code>碎了</code>，剩下 $m-1$ 个鸡蛋，用式子 $f(k-1, m-1)$ 表示已经知道的 $1$ 到 $k-1$ 层楼<strong>最少尝试步数</strong>的值，总最小尝试次数为 $f(k-1, m-1)+1$</p><h3 id="〔情况-2〕没碎"><a href="#〔情况-2〕没碎" class="headerlink" title="〔情况 2〕没碎"></a>〔情况 2〕没碎</h3><p>在 $k$ 层没碎，直接不用考虑<code>[1, k]</code>情况了（肯定都不碎），同理，计算出<strong>此时楼高</strong> $h_{now} = h - (k+1) + 1 = h - k$，且因为此刻这个鸡蛋<code>没碎</code>，剩下 $m$ 个鸡蛋，即 $f(h-k, m)$ ，总最小尝试次数为 $f(h-k, m)+1$</p><h2 id="3-2-构造逻辑链"><a href="#3-2-构造逻辑链" class="headerlink" title="3.2 构造逻辑链"></a>3.2 构造逻辑链</h2><p>此时，我们已经有了三个表达式</p><p>1️⃣ 楼高为 $h$ ，剩下 $m$ 个鸡蛋时的<strong>最少尝试步数</strong>：$f(h, m)$ </p><p>2️⃣ 在第 $k$ 层扔下<code>1</code>个鸡蛋<code>碎了</code>后的<strong>最少尝试步数</strong>：$f(k-1, m-1)$</p><p>3️⃣ 在第 $k$ 层扔下<code>1</code>个鸡蛋<code>没碎</code>后的<strong>最少尝试步数</strong>：$f(h-k, m)$ </p><p>那么，假设2️⃣3️⃣的表达式的<strong>答案已知</strong>，是否能用这二者<strong>推出</strong>1️⃣？如果上述逻辑链成立，就可以用<code>归纳思维</code>（数学归纳法）算出任意 $f(h, m)​$ 。因为1️⃣只能从2️⃣3️⃣推出</p><p>〔推倒 $a$〕考虑到2️⃣3️⃣是一种<strong>策略选择后的可能性</strong>，根据<a href="#2-1-一个鸡蛋">上面的分析</a>（最大值的最小值原理）两种策略中临界层 $x$ 可能在任何一层。遍历所有 $x$ 的情况时，最终尝试步数的结果是<strong>其中的最大值</strong>，所以选择2️⃣3️⃣中<strong>值更大的那个</strong></p><p>〔推倒 $b$〕1️⃣需要仍一次鸡蛋，尝试步数 $+1$</p><p>〔推倒 $c$〕$k$ 是一个自变量，在这个情况下，可取到 $[1, h)$ 中的任意值，⭐️假设2️⃣3️⃣已知，只要在定义域内<strong>穷举</strong>出所有 $k$ 的可能值，并找出<strong>最大尝试步数中的最小值</strong>即可</p><p>接下来就可以把这个逻辑链的用<strong>抽象化的公式</strong>表达出来<br>$$<br>f(h, m) = \underbrace{\min_{1 \leqslant k \leqslant h} {\overbrace{\overbrace{\max [f(k-1, m-1), f(h-k,m)]}^{a}+1}^{b}}}_{c}\tag{5}<br>$$</p><p>有了具体的公式，为了锻炼工程思维，要时刻<strong>保持严谨</strong>，思考全集和完备性，再来看看<strong>边界条件</strong>和<strong>自变量定义域</strong></p><h3 id="3-2-1-自变量的定义域"><a href="#3-2-1-自变量的定义域" class="headerlink" title="3.2.1 自变量的定义域"></a>3.2.1 自变量的定义域</h3><p>依据题意楼高 $h \geqslant 1$ 且为整数，剩余鸡蛋数 $m \geqslant 1$ 且为整数 </p><h3 id="3-2-2-边界条件"><a href="#3-2-2-边界条件" class="headerlink" title="3.2.2 边界条件"></a>3.2.2 边界条件</h3><p>$f(h, 1) = h$ ，当剩余鸡蛋数为<code>1</code>的时候，答案为现在的楼高</p><p>$f(0, m) = 0$ ，当楼高为<code>0</code>时，无法尝试，答案<strong>记为</strong><code>0</code> ，或者 $f(1,m) = 1$，表示楼高为<code>1</code>时，最小尝试次数为<code>1</code> </p><h2 id="3-3-动态规划"><a href="#3-3-动态规划" class="headerlink" title="3.3 动态规划"></a>3.3 动态规划</h2><p>现在反过头来再看，计算机学科中，有一部分专门研究这类问题的工具，即<strong>动态规划</strong></p><p>上面的<code>符号化描述</code>被称为<a href="#define_status">定义状态</a>，<code>构造逻辑链</code>被称为<a href="#3-2-构造逻辑链">构造状态转移方程</a>，而背后的工程思维是<code>拆分思维</code>、<code>抽象思维</code>和<code>归纳思维</code>。再究竟一些，动态规划是一类特殊的<code>图算法</code>。</p><ul><li>〔拆分思维〕<strong>拆分问题</strong>的能力。大问题化小问题，无后效性，当前状态与未来状态无关。</li><li>〔抽象思维〕<strong>使用状态来描述问题</strong>的能力，或说用抽象符号或状态机来描述问题的能力</li><li>〔归纳思维〕数学归纳法，<strong>逻辑推导</strong>能力。由 $\lt i$ 的所有状态推倒出 $i$ 时刻状态的能力</li></ul><p>之所以要研究这类问题和<strong>计算机本身是一个巨大的状态机</strong>有关。动态规划提供了一套<strong>工具</strong>和<strong>思维框架</strong>去优化问题，找到最优解。<strong>思维框架和优化方法</strong>才是最厉害最有价值的，看到后面优化部分的详解你就能直观的体会到这点。</p><h1 id="4-实现优化和分析"><a href="#4-实现优化和分析" class="headerlink" title="4. 实现优化和分析"></a>4. 实现优化和分析</h1><p>这部分，通过一步一步<strong>剖析优化思路</strong>，和对应的代码实现（使用<code>python</code>，所有代码可在Leetcode题目中AC），希望能直观的说明一个问题，<code>❓ 到底高级程序员和一般的码农程序员区分在哪里？</code></p><p>每个人都有自己擅长的领域，管理大师<strong>吉姆·柯林斯</strong>的第一本畅销书《基业长青》，书内研究了18家企业成功的秘密。</p><p>后来，他又出了一本书《从平庸到伟大》，对这个变化的界定是非常严格的。<code>平庸</code>意味着这家公司的业绩低于市场的平均水准，<code>变得伟大</code>意味着业绩保持在平均水准的3倍以上，并持续至少15年。他研究了1435家公司，只找到了11家</p><p>通过研究，他总结了这些企业的6个秘诀。其中一个就是著名的<strong>三环理论</strong>，如果把企业的三环理论推广到个人，就是问自己下面<strong>三个问题</strong>：<code>我的擅长是什么？我的热爱是什么？我的机会是什么？</code></p><p>而选择三者<strong>交集</strong>作为一辈子的<strong>努力方向</strong>大概率就算是走对了路</p><p>作为程序员，可能只是你开始职业生涯的第一步，后面如何发展，<strong>需要对自己的追求和个人能力做一个更深入的挖掘</strong>，才能有个定论</p><p>下面即将<strong>剖析的优化过程</strong>完美的阐述了作为一个<code>伟大</code>的程序员需要什么样的<strong>基础能力</strong>（至少在算法优化这个小领域），这需要<strong>长时间的训练和极强的天赋</strong>。如果你感觉想出这些解答很吃力，相对应的，你又想<strong>这辈子有所作为</strong>，<strong>追逐伟大</strong>。那么应该尝试去找一条<strong>非程序员的路努力一生</strong>。毕竟，<strong>计算机思维，数据分析和机器学习未来会成为像数学一样的基础能力</strong>，无论在哪一行都<strong>对解决问题有极大的助益</strong></p><h2 id="4-1-基础版"><a href="#4-1-基础版" class="headerlink" title="4.1 基础版"></a>4.1 基础版</h2><p>根据思路直接写出的最直观代码。如果对<a href="">递归</a>理解的深，容易读懂。用我能想到最直白的语言来描述就是：<strong>假设子状态的结果已知，现在需要做些什么操作，就能得到此状态的答案，并且把这个答案返回给函数</strong>（借鉴知乎回答的答案，加上了<code>lru_cache</code>装饰器用于优化）</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> functools</span><br><span class="line"><span class="comment"># python3的functools的一个自带函数, 可以对函数返回结果进行LRU cache, 下次以相同参数调用就不重复计算了</span></span><br><span class="line"><span class="comment"># maxsize=None 不限制大小, 其实就变成是全部都cache下来, 不考虑LRU了</span></span><br><span class="line"><span class="meta">@functools.lru_cache(maxsize=None) # 装饰器 </span></span><br><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">f</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h == <span class="number">0</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line">    <span class="keyword">if</span> m == <span class="number">1</span>: <span class="keyword">return</span> h</span><br><span class="line"></span><br><span class="line">    result = min ( [ max ( [ f( i - <span class="number">1</span>, m - <span class="number">1</span> ), f( h - i, m ) ] ) <span class="keyword">for</span> i <span class="keyword">in</span> range( <span class="number">1</span>, h + <span class="number">1</span> ) ] ) + <span class="number">1</span></span><br><span class="line">    <span class="keyword">return</span> result</span><br></pre></td></tr></table></figure><p>🔄〔优化〕Recursive（递归）的写法虽然清晰明了，但在工程上有调用函数的开销，系统栈深度限制等弊端，所以最好写成<strong>循环版本</strong>，否则在工作中可能返工</p><h2 id="4-2-循环版本"><a href="#4-2-循环版本" class="headerlink" title="4.2 循环版本"></a>4.2 循环版本</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">solve</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    f = [ [ i <span class="keyword">for</span> i <span class="keyword">in</span> range(h+<span class="number">1</span>) ] <span class="keyword">for</span> j <span class="keyword">in</span> range(m+<span class="number">1</span>) ]</span><br><span class="line"></span><br><span class="line">    <span class="keyword">for</span> m_i <span class="keyword">in</span> range( <span class="number">2</span>, m + <span class="number">1</span> ):</span><br><span class="line">        <span class="keyword">for</span> h_j <span class="keyword">in</span> range( <span class="number">1</span>, h + <span class="number">1</span> ):</span><br><span class="line">            <span class="keyword">for</span> k <span class="keyword">in</span> range( <span class="number">1</span>, h_j ):</span><br><span class="line">                f[m_i][h_j]= min ( f[m_i][h_j], <span class="number">1</span> + max( f[m_i <span class="number">-1</span>][k - <span class="number">1</span>], f[m_i][h_j - k]) )</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">return</span> f[m][h]</span><br></pre></td></tr></table></figure><p>🔄〔优化〕分析一下时间复杂度和空间复杂度，时间复杂度为 $O(mh^2)$ ，空间复杂度为 $O(hn)$ ，很明显，空间上可以优化到 $O(h)$，原因是状态转移方程只和 $m$ 与 $m-1$ 有关，使用两个数组滚动即可</p><h2 id="4-3-空间优化版本"><a href="#4-3-空间优化版本" class="headerlink" title="4.3 空间优化版本"></a>4.3 空间优化版本</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">solveSpace</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line">    </span><br><span class="line">    f_pre = f_cur = [i <span class="keyword">for</span> i <span class="keyword">in</span> range(h + <span class="number">1</span>)]</span><br><span class="line"></span><br><span class="line">    <span class="keyword">for</span> m_i <span class="keyword">in</span> range( <span class="number">2</span>, m + <span class="number">1</span> ):</span><br><span class="line">        <span class="keyword">for</span> h_j <span class="keyword">in</span> range( <span class="number">1</span>, h + <span class="number">1</span> ):</span><br><span class="line">            <span class="keyword">for</span> k <span class="keyword">in</span> range ( <span class="number">1</span>, h_j ):</span><br><span class="line">                f_cur[h_j] = min ( f_cur[h_j], <span class="number">1</span> + max( f_pre[k - <span class="number">1</span>] , f_cur[h_j - k]) )</span><br><span class="line">        f_pre = f_cur[:]</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">return</span> f_cur[h]</span><br></pre></td></tr></table></figure><p>基本到这，对美国<code>FAANG</code>的入门级SDE，就十分优秀了。后面的所有的内容，属于<code>高手</code>的领域（博主完全不是高手，只是好奇，所以阅读了<strong>其他人的牛逼的解题报告</strong>，重新做了理解和整理）</p><p>对于这一套状态描述和状态转移方程，优化方向在<strong>时间复杂度</strong>上。思考，❓是否有一些数学定理可以提供答案<strong>取值的下界</strong>呢？<strong>（找边界是剪枝的有效方法）</strong></p><p>🔄〔优化〕这里需要使用数据结构中<a href="https://blog.csdn.net/qq_28409193/article/details/50484638" target="_blank" rel="noopener">折半查找判定树</a>理论。假设我们对鸡蛋的数量不做限制，那么这棵树</p><div align="center"><img src="//charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/FullTree.png" alt="" width="700"></div><p>就会变为一个<strong>满二叉树</strong>，而叶子节点数量有 $h+1$ 个（因为最大尝试步数能取到的总数就是 $h+1$ 种，需包含0次）树的高度至少为 $\lceil \log_2(h+1)\rceil$。假设鸡蛋 $m$ 的数量大于 $\lceil \log_2(h+1)\rceil $ ，那么上面的树<strong>变成满树</strong>，无论怎么尝试，答案（树高）都有一个下界（不可能大于这个值）</p><p>如果还不明白，即在 $m \geqslant \lceil \log_2(h+1)\rceil $ 时，这道题会变成<strong>二分查找</strong>（鸡蛋太多，随便扔，就当楼层是排序好的即可）最终答案直接取 $\lceil \log_2(h+1)\rceil$ </p><p>🌰 如果还是不明白，上终极杀招，<strong>举例子</strong>。假设<code>16</code>层楼，但有<code>4</code>个鸡蛋。<strong>根本不用设计，二分查找即可</strong>，效率肯定最高。比如<code>16</code>层楼，只要鸡蛋数大于<code>4</code>，最大尝试次数就是<code>4</code>，可以直接算出答案</p><h2 id="4-4-下界优化"><a href="#4-4-下界优化" class="headerlink" title="4.4 下界优化"></a>4.4 下界优化</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">solveBoundary</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line">    </span><br><span class="line">    f_pre = f_cur = [i <span class="keyword">for</span> i <span class="keyword">in</span> range(h + <span class="number">1</span>)]</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">for</span> m_i <span class="keyword">in</span> range( <span class="number">2</span>, m + <span class="number">1</span> ):</span><br><span class="line">        <span class="keyword">for</span> h_j <span class="keyword">in</span> range( <span class="number">1</span>, h + <span class="number">1</span> ):</span><br><span class="line">            t = math.ceil( math.log2( h_j + <span class="number">1</span> ) )</span><br><span class="line">            <span class="keyword">if</span> m_i &gt;= t:</span><br><span class="line">                f_cur[h_j] = t</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                <span class="keyword">for</span> k <span class="keyword">in</span> range ( <span class="number">1</span>, h_j ):</span><br><span class="line">                    f_cur[h_j] = min ( f_cur[h_j], <span class="number">1</span> + max( f_pre[k - <span class="number">1</span>] , f_cur[h_j - k]) )</span><br><span class="line">        f_pre = f_cur[:]</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">return</span> f_cur[h]</span><br></pre></td></tr></table></figure><p>这时候时间复杂度优化为 $O(mhlog_2(h))$。此时，如果列出所有状态转移的过程（行为鸡蛋数 $m$，从2开始；列为楼高 $h$ ，从1开始），如下图（红色框表示 $k$ 的移动，蓝色双向箭头表示 $\max$ 操作，然后还需要加1后和之前的 $f(m,h)$ 进行 $\min$ 操作。下图展示的是 $m_i=2,h_j=11,k=5$ 时的情况）（这幅图也能帮助理解下界优化，注意 $m_i=5$ 和 $m_i=4$ 在 $h &lt; 20$ 的情况）</p> <div align="center"><img src="//charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/f.png" alt="" width="1000"></div><p>🔄 观察发现，有一个很重要的规律，即<strong>单调性</strong>，写成公式为 $f(m, h) \geqslant f(m, h-1)$ 当 $h \geqslant 1$ 。如果满足<strong>单调性</strong>，那么又可以在搜索时使用<strong>二分查找</strong>。先姑且不考虑<strong>如何证明单调性</strong>，工程上，在<strong>资源允许</strong>的情况下，先尝试，看看能不能得到<strong>正确结果</strong>（用正确算法和这个尝试算法进行验证）直到验证在很大的定义域内<strong>都正确</strong>，可大胆猜测这个<strong>猜测性质</strong>是对的（不严谨，但效率较高）</p><p>通过这一层优化，体现出了<strong>理论和工程的分野</strong>，即你猜想出了一个优化方法，当然可以先直接尝试，<strong>不管这个猜测的条件是不是正确</strong>。</p><p>反过头来仔细一寻摸，总是心里不踏实（可能出现<strong>特殊情况</strong>就让整个算法崩溃）此时，<strong>理论出山</strong>，用严谨的数学逻辑去证明这些结论，让算法具有完备性（本题单调性是正确的，证明过程参见参考文献）</p><blockquote><p>另外，<strong>观察和总结答案的分布规律</strong>也是非常重要的思考手段，你会发现，这简单的一句话说开去，是一个新的学科，名叫<strong>统计学</strong></p></blockquote><h2 id="4-5-单调性优化"><a href="#4-5-单调性优化" class="headerlink" title="4.5 单调性优化"></a>4.5 单调性优化</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">solveBinarySearch</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    t = math.floor( math.log2( h ) ) + <span class="number">1</span></span><br><span class="line">    </span><br><span class="line">    <span class="keyword">if</span> m &gt;= t: <span class="keyword">return</span> t</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        f_cur = f_pre = [i <span class="keyword">for</span> i <span class="keyword">in</span> range(h + <span class="number">1</span>)]</span><br><span class="line"></span><br><span class="line">        <span class="keyword">for</span> m_i <span class="keyword">in</span> range(<span class="number">2</span>, m + <span class="number">1</span>):</span><br><span class="line">            f_cur[<span class="number">0</span>] = <span class="number">0</span></span><br><span class="line">            <span class="keyword">for</span> h_j <span class="keyword">in</span> range(<span class="number">1</span>, h + <span class="number">1</span>):</span><br><span class="line">                f_cur[h_j] = <span class="number">1000000</span></span><br><span class="line">                start, stop = <span class="number">1</span>, h_j</span><br><span class="line">                <span class="comment"># 二分查找</span></span><br><span class="line">                <span class="keyword">while</span> start &lt;= stop:</span><br><span class="line">                    mid = (start + stop) // <span class="number">2</span></span><br><span class="line">                    <span class="keyword">if</span> f_pre[mid - <span class="number">1</span>] &gt; f_cur[h_j - mid]:</span><br><span class="line">                        <span class="keyword">if</span> f_pre[mid - <span class="number">1</span>] + <span class="number">1</span> &lt; f_cur[h_j]:</span><br><span class="line">                            f_cur[h_j] = f_pre[mid - <span class="number">1</span>] + <span class="number">1</span></span><br><span class="line">                        stop = mid - <span class="number">1</span></span><br><span class="line">                    <span class="keyword">elif</span> f_pre[mid - <span class="number">1</span>] &lt; f_cur[ h_j - mid]:</span><br><span class="line">                        <span class="keyword">if</span> f_cur[h_j - mid] + <span class="number">1</span> &lt; f_cur[h_j]:</span><br><span class="line">                            f_cur[h_j] = f_cur[h_j - mid] + <span class="number">1</span></span><br><span class="line">                        start = mid + <span class="number">1</span></span><br><span class="line">                    <span class="keyword">else</span>:</span><br><span class="line">                        f_cur[h_j] = f_cur[h_j - mid] + <span class="number">1</span></span><br><span class="line">                        <span class="keyword">break</span></span><br><span class="line">            f_pre = f_cur[:]</span><br><span class="line">        <span class="keyword">return</span> f_cur[h]</span><br></pre></td></tr></table></figure><p>🔄 结果的简单特性部分挖掘完了，继续观察上面的<strong>状态转移图</strong>，发现<strong>很多项是相等的</strong>，那么可不可以找到，在某种条件满足时，状态可以直接推出，而不用进行 $k$ 的<strong>遍历搜索</strong>？这个时候就需要从状态转移方程本身入手是挖掘其中的数学特性，<a href="#4-6-状态转移方程优化">这部分不是非常关键，较难，可直接跳过</a></p>$$\begin{array}&f(h, m) = \min\limits_{1 \leqslant k \leqslant h} \{\max [f(k-1, m-1), f(h-k,m)]+1\} \\f(h, m) \leqslant \max [f(k-1, m-1), f(h-k,m)]+1 \quad(1 \leqslant k \leqslant h) \\令\; k = 1 \implies f(h, m) \leqslant f(h - 1, m) + 1\end{array} \tag{6}$$<p>又因为 $f$ 具有单调性，可得 $f(h - 1, m) \leqslant f(h, m) \leqslant f(h - 1, m) +1$ 其中 $h\geqslant 1$  </p><p>上面的式子非常有意思，使用标准的逻辑推理来看</p><ul><li><p>若某个决策 $k$ 可使得 $f(h - 1, m) = f(h, m)$ ，则一定 $f(h, m) = f(h-1, m)$</p></li><li><p>若所有决策 $k$ 都<strong>不能</strong>使 $f(h - 1, m) = f(h, m)$ ，则一定 $f(h, m) = f(h - 1, m) + 1$ </p></li></ul><p>那么，是否可以构造这样一个决策，使得状态转移直接计算呢？<strong>具体过程略过</strong>，有兴趣的读者详见参考文献</p><p>假设这个决策的楼高 $h = p$ ，推倒出当 $f(m, p)&lt;f（m-1， h-p-1)$ 时，无论任何决策都不能使 $f(m, h) = f(m, h-1)$，所以，此时 $f(m, h) = f(m, h-1) + 1$ </p><p>也就是说，根据 $f(m, p)$ 和 $f(m-1,h-p-1)$ 的大小关系就可以直接确定 $f(m, h)$ </p><h2 id="4-6-状态转移方程优化"><a href="#4-6-状态转移方程优化" class="headerlink" title="4.6 状态转移方程优化"></a>4.6 状态转移方程优化</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">solveTransferFunction</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    t = math.floor( math.log2( h ) ) + <span class="number">1</span>  </span><br><span class="line">    <span class="keyword">if</span> m &gt;= t: <span class="keyword">return</span> t</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        f_cur = [i <span class="keyword">for</span> i <span class="keyword">in</span> range(h + <span class="number">1</span>)]</span><br><span class="line">        f_pre = [i <span class="keyword">for</span> i <span class="keyword">in</span> range(h + <span class="number">1</span>)]</span><br><span class="line"></span><br><span class="line">        <span class="keyword">for</span> m_i <span class="keyword">in</span> range(<span class="number">2</span>, m + <span class="number">1</span>):</span><br><span class="line">            p = f_cur[<span class="number">0</span>], f_cur[<span class="number">1</span>] = <span class="number">0</span>, <span class="number">1</span></span><br><span class="line">            <span class="keyword">for</span> j <span class="keyword">in</span> range(<span class="number">2</span>, h + <span class="number">1</span>):</span><br><span class="line">                <span class="keyword">if</span> f_cur[p] &gt;= f_pre[j - p - <span class="number">1</span>]:</span><br><span class="line">                    f_cur[j] = f_cur[j - <span class="number">1</span>]</span><br><span class="line">                <span class="keyword">else</span>:</span><br><span class="line">                    f_cur[j] = f_cur[j - <span class="number">1</span>] + <span class="number">1</span></span><br><span class="line">                    p = j - <span class="number">1</span></span><br><span class="line">            f_pre = f_cur[:]</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">return</span> f_cur[h]</span><br></pre></td></tr></table></figure><p>此时，<strong>状态转移过程时间复杂度</strong>变成 $O(1)$，整体时间复杂度随之变成 $O(m\log_2{h})$ </p><p>在这种依照题意<strong>直接定义状态</strong>并<strong>找到状态转移方程</strong>的方法已经<strong>优化到极致</strong>了。那么，❓ <strong>如果从不同的角度定义问题</strong>呢？</p><h2 id="4-7-不同角度看问题"><a href="#4-7-不同角度看问题" class="headerlink" title="4.7 不同角度看问题"></a>4.7 不同角度看问题</h2><h3 id="4-7-1-状态定义"><a href="#4-7-1-状态定义" class="headerlink" title="4.7.1 状态定义"></a>4.7.1 状态定义</h3><p>改变对问题的状态描述方法，用 $h(i,j)$ [h for height]表示用 $j$ 个鸡蛋尝试 $i$ 次在<strong>最坏情况下</strong>能找到的<strong>最小尝试次数</strong>的<strong>楼高</strong>。</p><h3 id="4-7-2-边界条件"><a href="#4-7-2-边界条件" class="headerlink" title="4.7.2 边界条件"></a>4.7.2 边界条件</h3><p>当尝试次数 $i=1$ 时，$h(1,j)=1\quad(j \geqslant 1)$ </p><p>当使用 $j = 1$ 个鸡蛋时，尝试 $i$ 次可以尝试 $i$ 层楼，即 $h(i,1)=i$</p><h3 id="4-7-3-状态转移方程"><a href="#4-7-3-状态转移方程" class="headerlink" title="4.7.3 状态转移方程"></a>4.7.3 状态转移方程</h3><p>核心思路：每一次 $h()$ 所能<strong>尝试的楼高</strong>必须要<strong>尽可能的大</strong>，这样才能做到<strong>尝试次数最小</strong></p><p>在某层扔下一个鸡蛋</p><ul><li>〔碎了〕那么在后面的 $i-1$ 次里，需用 $j-1$ 个鸡蛋在下面的楼层中确定<strong>楼高</strong>。为了使 $h(i,j)$ 达到最大，希望下面的楼层数（楼高）最大，根据状态定义，记为 $h(i-1, j-1)$ </li><li>〔没碎〕那么在后面的 $i-1$ 次里，需用 $j$ 个鸡蛋在上面的楼层中确定<strong>楼高</strong>。同理，需要楼层数达到最大，记为 $h(i-1,j)$ </li></ul><p>综上，状态转移方程写为 $h(i,j) = h(i-1, j-1)+h(i-1,j) + 1$</p><p>而最终结果可以写为，找到一个 $x$ ，使得 $x$ 满足 $h(x-1, M) &lt; H$ 且 $h(x, M) \geqslant H$ （$M$ 为鸡蛋总数，$H$ 为楼层总高度），其实也就是用公式描述的临界层的具体含义</p><h3 id="4-7-4-代码实现"><a href="#4-7-4-代码实现" class="headerlink" title="4.7.4 代码实现"></a>4.7.4 代码实现</h3><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">g</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    t = math.floor( math.log2( h ) ) + <span class="number">1</span> </span><br><span class="line">    <span class="keyword">if</span> m &gt;= t: <span class="keyword">return</span> t</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        g_cur = g_pre = [ <span class="number">1</span> <span class="keyword">for</span> i <span class="keyword">in</span> range(m + <span class="number">1</span>) ]</span><br><span class="line">        g_cur[<span class="number">0</span>] = g_pre[<span class="number">0</span>] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> g_cur[m] &gt;= h: <span class="keyword">return</span> <span class="number">1</span></span><br><span class="line">        <span class="keyword">elif</span> h == <span class="number">1</span>: <span class="keyword">return</span> h</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">for</span> i <span class="keyword">in</span> range(<span class="number">2</span>, h + <span class="number">1</span>):</span><br><span class="line">                <span class="keyword">for</span> j <span class="keyword">in</span> range( m, <span class="number">1</span>, <span class="number">-1</span>):</span><br><span class="line">                    g_cur[j] = g_pre[j - <span class="number">1</span>] + g_pre[j] + <span class="number">1</span></span><br><span class="line">                    <span class="keyword">if</span> g_pre[j] &lt; h <span class="keyword">and</span> g_cur[j] &gt;= h:</span><br><span class="line">                        <span class="keyword">return</span> i</span><br><span class="line">                g_cur[<span class="number">1</span>] = i</span><br><span class="line">                <span class="keyword">if</span> m == <span class="number">1</span> <span class="keyword">and</span> g_cur[<span class="number">1</span>] &gt;= h:</span><br><span class="line">                    <span class="keyword">return</span> i</span><br><span class="line">                print( g_cur, end=<span class="string">"\n"</span>)</span><br><span class="line">                g_pre = g_cur[:]</span><br></pre></td></tr></table></figure><h3 id="4-7-5-继续优化"><a href="#4-7-5-继续优化" class="headerlink" title="4.7.5 继续优化"></a>4.7.5 继续优化</h3><p>这又是一个全新的状态定义和状态转移方程，同理，可尝试<strong>输出整个转移矩阵的具体值</strong>，先观察一下总没有错，如下图所示 </p> <div align="center"><img src="//charlesliuyx.github.io/2018/10/11/【直观算法】Egg Puzzle 鸡蛋难题/g.png" alt="" width="400"></div><p>从形式上来说，不需要滚动数组，在转移过程中，使用一个 $g$ 函数即可。在最后输出的时候，只需要判断<code>g[m]</code>的情况输出 $i$  </p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">gOptimization</span><span class="params">(h, m)</span>:</span></span><br><span class="line">    <span class="keyword">if</span> h &lt; <span class="number">1</span> <span class="keyword">and</span> m &lt; <span class="number">1</span>: <span class="keyword">return</span> <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    t = math.floor( math.log2( h ) ) + <span class="number">1</span></span><br><span class="line">    </span><br><span class="line">    <span class="keyword">if</span> m &gt;= t: <span class="keyword">return</span> t</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        g = [ <span class="number">1</span> <span class="keyword">for</span> i <span class="keyword">in</span> range(m + <span class="number">1</span>) ]</span><br><span class="line">        g[<span class="number">0</span>] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> g[m] &gt;= h: <span class="keyword">return</span> <span class="number">1</span></span><br><span class="line">        <span class="keyword">elif</span> h == <span class="number">1</span>: <span class="keyword">return</span> h</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">for</span> i <span class="keyword">in</span> range(<span class="number">2</span>, h + <span class="number">1</span>):</span><br><span class="line">                <span class="keyword">for</span> j <span class="keyword">in</span> range( m, <span class="number">1</span>, <span class="number">-1</span>):</span><br><span class="line">                    g[j] = g[j - <span class="number">1</span>] + g[j] + <span class="number">1</span></span><br><span class="line">                    <span class="keyword">if</span> j == m <span class="keyword">and</span> g[j] &gt;= h:</span><br><span class="line">                        <span class="keyword">return</span> i</span><br><span class="line">                g[<span class="number">1</span>] = i</span><br><span class="line">                <span class="keyword">if</span> m == <span class="number">1</span> <span class="keyword">and</span> g[<span class="number">1</span>] &gt;= h:</span><br><span class="line">                    <span class="keyword">return</span> i</span><br></pre></td></tr></table></figure><p>要分析时间复杂度，挺难的。通过证明可以有一个结论（具体证明详见参考文献）$xM \leqslant H$ ，再通过一系列骚操作，可以证明时间复杂度为 $O(\sqrt{h})$，空间复杂度 $O(m)$ </p><p>至此，Leetcode上这道题目的执行时间<strong>打败了85.7%的答案</strong>（虽然Leetcode时间并不靠谱），做这道题的人不多，前面只有一个答案，思路类似，代码写的更漂亮</p><h1 id="5-工程思维总结和感悟"><a href="#5-工程思维总结和感悟" class="headerlink" title="5. 工程思维总结和感悟"></a>5. 工程思维总结和感悟</h1><h2 id="5-1-工程思维"><a href="#5-1-工程思维" class="headerlink" title="5.1 工程思维"></a>5.1 工程思维</h2><p>⭐️ 这一部分是【直观算法】系列的最终目的。<strong>求同遵异</strong>，寻找每一道算法题背后的工程思维，提升自己真正解决工程问题的能力。博主对自己的定位是【机器学习+区块链产品经理】，但同时对技术也有好奇心，喜欢钻研，才开坑写【直观算法】系列</p><h3 id="5-1-1-抽象思维"><a href="#5-1-1-抽象思维" class="headerlink" title="5.1.1 抽象思维"></a>5.1.1 抽象思维</h3><p>把语言描述转化为符号描述的能力，符号是信息和逻辑的纽带</p><h3 id="5-1-2-等价思维"><a href="#5-1-2-等价思维" class="headerlink" title="5.1.2 等价思维"></a>5.1.2 等价思维</h3><p><strong>沟通的效率和信息的冗余度成正比</strong>，所以一个人能否把同一个概念，<strong>从不同的角度，用不同的案例类比，抑或各类精彩直观的比喻</strong>表达出来，这个能力很重要，它可以让人们更加<strong>准确快速的</strong>理解你想表达的意思</p><p>⭐️ <strong>学习的真正本质</strong>：<strong>是在一个领域内不断的去建立这种沟通共识的框架</strong>。举个例子，学过线性代数的人，只要<strong>提到矩阵，就能想到变换</strong>。这就是都学过线性代数的人交流密码，如矩阵的逆 = 一个具体的反向变换。没学过这门课的人是无法和<strong>学过的人</strong>进行沟通的。这也从很大程度加强了人们沟通的效率，所以，<strong>学习带来的终极成效之一</strong>其实是降低了<strong>人类社会的沟通时间，提高了效率</strong></p><p>再举个例子：机器学习中，提到<strong>正则化</strong>，必须建立一套与之相关的知识架构，包括，<strong>过拟合，最优化函数曲面空间理解，范数</strong>等，成<strong>树状结构</strong>继续推而广之，这每一个名词，背后也对应了一个<strong>更加直观，更加易懂的描述方式</strong>。但是我们需要知道，如果我为了表达正则化，为了让你明白我的意思，我需要用一大堆描述性语言，那我们两人的<strong>沟通效率就十分低下了</strong></p><p>这也就是知识体系，一门学科，一门专业的最终含义，学习是为了<strong>构建这门学科的通识沟通框架</strong>，降低同行之间的沟通成本。当然，这有一个<strong>必要前提</strong>，把<strong>学习的目的</strong>理解<strong>降低沟通成本</strong>必须是你做的工作<strong>是规模化的</strong>，涉及<strong>协作</strong></p><p>如果你是爱因斯坦，是能<strong>开拓学科新领域</strong>的<code>0</code>级工程师（来自于吴军老师谷歌方法论），独自想象钻研。那么，学习的本质可能在于给你更多的角度（认知能力），更多的工具（锤子锯子）去更好的<strong>探索这个世界的本质和规则</strong>，在这样的条件下，关于<strong>学习本质的描述</strong>就需要调整了</p><h3 id="5-1-3-反推思维"><a href="#5-1-3-反推思维" class="headerlink" title="5.1.3 反推思维"></a>5.1.3 反推思维</h3><p>从结论出发反推逻辑链</p><h3 id="5-1-4-归纳思维"><a href="#5-1-4-归纳思维" class="headerlink" title="5.1.4 归纳思维"></a>5.1.4 归纳思维</h3><p>数学归纳法，使用已有的条件信息，归纳推出待求的内容</p><h3 id="5-1-5-粗条细调思维"><a href="#5-1-5-粗条细调思维" class="headerlink" title="5.1.5 粗条细调思维"></a>5.1.5 粗条细调思维</h3><p>对于这道题，首先考察的是程序员的粗条细调思维。工程中经常会有对<strong>测量精度</strong>的要求，那么是如何做的？比如常见的<strong>千分尺</strong>，首先是一个横向的卡尺来接近目标值，然后用一个滚轮形的第二级继续细调。同样，显微镜也有对应的调整方法。都可以总结为<code>粗条细调思维</code></p><p>首先大步接近最优解，再调整迭代速度，更加细微的接近最优解。机器学习中的，Adam优化器也是用类似的思维来设计的</p><h3 id="5-1-6-拆分思维"><a href="#5-1-6-拆分思维" class="headerlink" title="5.1.6 拆分思维"></a>5.1.6 拆分思维</h3><p>问题是否能拆分几个黑盒，只给输入输出，里面的逻辑链做到精简，或者<strong>有已经可用的轮子</strong>和<strong>算法</strong>直接应用的能力。</p><blockquote><p>能看到这的读者我衷心感谢您的求知欲和耐心（我写的比较啰嗦，为了权衡不同背景的读者），下面的一部分个人认为<strong>才是最重要的</strong></p></blockquote><h2 id="5-2-工程应用"><a href="#5-2-工程应用" class="headerlink" title="5.2 工程应用"></a>5.2 工程应用</h2><p>到了这一步，基本压榨了本题所有的潜力。但是，下一个值得思考的问题就是，这道题目对应的算法在<strong>实际工程和解决问题的具体情况</strong>中有没有什么应用呢？答案是肯定的</p><p>🌰 如果要找学科分类，鸡蛋难题属于<strong>运筹学问题</strong>，典型应用是破坏性试验，如测试汽车、飞机、火箭等的若干极限性能。举个例子，汽车保全乘客安全的最高碰撞末速，那么为了保证能找这个值，一定会用类似的思路来解决问题。</p><p>你可能也已经发现，<strong>具体问题一定还是具体分析</strong>，但这道题目对应的工程思维更像是工具箱里面的一种<strong>更强大的工具。</strong></p><p>记得罗辑思维中提过一个问题：为什么物理学领域老一辈的物理学家现在拿奖的人越来越少？其中一个重要的原因是他们<strong>熟悉的物理学工具</strong>没有新生一辈的能力强大的。不同于数学这类逻辑学科，物理学是可验证学科，实验，测量工具和理论工具等都必不可少</p><p>博主笃定，算法<strong>80%是要为解决问题服务的</strong>，勾起人们学习的最佳动力就是<strong>举实际生活中遇到的难题是如何用这个算法解决</strong>。从这个侧面，有关<strong>字符串的算法</strong>就非常能勾起学习的兴趣，正是因为涉及到字符串处理的情景太多。</p><p>关于鸡蛋难题，总的看下来，完美的诠释了直观 ➜ 抽象的思维链条。所有高效的，精简的算法，就是要<strong>找到事物或者逻辑发生的本质规律</strong>，如果不谈完备性的证明，用<strong>图表和直观的性质来描述</strong>，这道题目的优化思路并不难（相对的，完备性时间复杂度的证明才是难点）</p><p>关于剩下的20%，此时又想起<a href="https://charlesliuyx.github.io/2018/09/20/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E9%80%9A%E4%BF%97%E6%98%93%E6%87%82%E4%BA%86%E8%A7%A3%E4%BB%80%E4%B9%88%E6%98%AF%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3/">黎曼猜想</a>，<strong>所有</strong>非平凡零点的有关性质。<code>趋向于无穷</code>、<code>所有</code>、<code>任意</code>这些定义方式是人类为了<strong>寻找边界</strong>而设计的工具。趋向于无穷大，趋向于无穷小都还有很多问题没有解决。罗胖说，创业者是在<strong>开垦商业的边疆</strong>，那么理论科学家就是拿着这些强大的工具开拓<strong>逻辑和思维的边疆</strong>，在一片荒芜上<strong>安营扎寨，仰望星空</strong>。这可能就是人类群体中<strong>最有魅力的事业</strong>吧？</p><p>【参考文献】</p><p>非常感谢计算机信息学奥赛国家队朱前辈的论文，对这道题目做了完美的剖析，也勾起了我的好奇心，一探究竟，才有了这篇<strong>万字长文</strong></p><p><a href="https://www.zhihu.com/question/19690210/answer/18079633" target="_blank" rel="noopener">吴育昕的回答 - 知乎</a></p><p><a href="https://github.com/ericliu859/AcmPaper/tree/master/%E5%8A%A8%E6%80%81%E8%A7%84%E5%88%92/%E4%BC%98%E5%8C%96/2004%20-%20%E6%9C%B1%E6%99%A8%E5%85%89%EF%BC%9A%E3%80%8A%E4%BC%98%E5%8C%96%EF%BC%8C%E5%86%8D%E4%BC%98%E5%8C%96%EF%BC%81%E2%80%94%E2%80%94%E4%BB%8E%E3%80%8A%E9%B9%B0%E8%9B%8B%E3%80%8B%E4%B8%80%E9%A2%98%E6%B5%85%E6%9E%90%E5%AF%B9%E5%8A%A8%E6%80%81%E8%A7%84%E5%88%92%E7%AE%97%E6%B3%95%E7%9A%84%E4%BC%98%E5%8C%96%E3%80%8B" target="_blank" rel="noopener">参考文献：朱晨光：《优化，再优化！——从《鹰蛋》一题浅析对动态规划算法的优化》</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】10000+字 | 17 - 22 min&lt;br&gt;【阅读内容】Google面试题：100层楼，两个鸡蛋&lt;strong&gt;最少用多少次&lt;/strong&gt;能测出鸡蛋的&lt;strong&gt;会在哪一层碎&lt;/strong&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Algorithm" scheme="https://charlesliuyx.github.io/categories/Algorithm/"/>
    
    
      <category term="Optimization" scheme="https://charlesliuyx.github.io/tags/Optimization/"/>
    
      <category term="DP" scheme="https://charlesliuyx.github.io/tags/DP/"/>
    
  </entry>
  
  <entry>
    <title>博客文章总目录</title>
    <link href="https://charlesliuyx.github.io/2018/10/04/%E5%8D%9A%E5%AE%A2%E6%96%87%E7%AB%A0%E6%80%BB%E7%9B%AE%E5%BD%95/"/>
    <id>https://charlesliuyx.github.io/2018/10/04/博客文章总目录/</id>
    <published>2018-10-04T11:18:48.000Z</published>
    <updated>2021-07-20T06:37:10.211Z</updated>
    
    <content type="html"><![CDATA[<p><a href="https://mubu.com/doc/3nIWmLzEPl" target="_blank" rel="noopener">幕布版本总目录</a>  ║  ⭐️ 推荐文章  ║  📝 正在更新</p><p>﹝信息流转学﹞<a href="https://gofurther.feishu.cn/docs/doccnbZAjYhNeH6q0MZVasdrXLb" target="_blank" rel="noopener">2021-07-01 信息流转学综述</a> </p><p>﹝机器学习﹞<a href="https://charlesliuyx.github.io/2018/01/19/%E5%BE%AE%E4%BF%A1%E8%B7%B3%E4%B8%80%E8%B7%B3%E8%A7%A3%E9%A2%98%E6%8A%A5%E5%91%8A/">2018-01-19 微信跳一跳解题报告</a> ┃<a href="https://charlesliuyx.github.io/2017/10/18/%E6%B7%B1%E5%85%A5%E6%B5%85%E5%87%BA%E7%9C%8B%E6%87%82AlphaGo%E5%85%83/">⭐️2017-10-18 深入浅出看懂AlphaGo元</a> ┃<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/">⭐️2017-05-27 深入浅出看懂AlphaGo如何下棋</a> ┃<a href="https://charlesliuyx.github.io/2017/09/30/Pandas-Wiki/">2017-09-30 Pandas-Wiki</a> ┃<a href="https://charlesliuyx.github.io/2017/10/03/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AF%E6%AD%A3%E5%88%99%E5%8C%96/">⭐️2017-10-03【直观详解】什么是正则化</a> ┃<a href="https://charlesliuyx.github.io/2017/10/05/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AFPCA%E3%80%81SVD/">📝【直观详解】什么是PCA、SVD</a> ┃<a href="https://charlesliuyx.github.io/2017/09/20/%E6%8B%89%E6%A0%BC%E6%9C%97%E6%97%A5%E4%B9%98%E6%B3%95%E5%92%8CKKT%E6%9D%A1%E4%BB%B6/">2017-09-20【直观详解】拉格朗日乘法和KKT条件</a> ┃<a href="https://charlesliuyx.github.io/2017/09/19/%E6%94%AF%E6%8C%81%E5%90%91%E9%87%8F%E6%9C%BASVM%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/">2017-09-19【直观详解】支持向量机SVM</a> ┃<a href="https://charlesliuyx.github.io/2017/09/12/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E5%88%86%E7%B1%BB%E5%99%A8%E6%80%A7%E8%83%BD%E6%8C%87%E6%A0%87%E8%AF%A6%E8%A7%A3/">2017-09-12 【直观详解】机器学习分类器性能指标详解</a> ┃<a href="https://charlesliuyx.github.io/2017/09/11/%E4%BB%80%E4%B9%88%E6%98%AF%E4%BF%A1%E6%81%AF%E7%86%B5%E3%80%81%E4%BA%A4%E5%8F%89%E7%86%B5%E5%92%8C%E7%9B%B8%E5%AF%B9%E7%86%B5/">⭐️2017-09-11【直观详解】信息熵、交叉熵和相对熵</a> ┃<a href="https://charlesliuyx.github.io/2017/09/04/LogisticRegression%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/">2017-09-04【直观详解】Logistic Regression</a></p><p>﹝理论基础﹞<a href="https://charlesliuyx.github.io/2018/09/20/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E9%80%9A%E4%BF%97%E6%98%93%E6%87%82%E4%BA%86%E8%A7%A3%E4%BB%80%E4%B9%88%E6%98%AF%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3/">⭐️2018-09-20【直观详解】通俗易懂了解什么是黎曼猜想</a> ┃<a href="https://charlesliuyx.github.io/2018/02/18/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E8%AE%A9%E4%BD%A0%E6%B0%B8%E8%BF%9C%E5%BF%98%E4%B8%8D%E4%BA%86%E7%9A%84%E5%82%85%E9%87%8C%E5%8F%B6%E5%8F%98%E6%8D%A2%E8%A7%A3%E6%9E%90/">⭐️2018-02-18【直观详解】让你永远忘不了的傅里叶变换解析</a> ┃<a href="https://charlesliuyx.github.io/2018/02/16/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E6%B3%B0%E5%8B%92%E7%BA%A7%E6%95%B0/">⭐️2018-02-16【直观详解】泰勒级数</a> ┃<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">⭐️2017-10-06【直观详解】线性代数的本质</a> ┃<a href="https://charlesliuyx.github.io/2017/10/17/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E4%B8%AD%E7%9A%84%E6%AD%A3%E4%BA%A4%E6%AD%A3%E8%A7%84%E6%AD%A3%E5%AE%9A%E8%BD%AC%E7%BD%AE/">2017-10-17【直观详解】线性代数中的转置正交正规正定</a>  </p><p>﹝区块链﹞<a href="https://charlesliuyx.github.io/2018/03/03/%E3%80%90%E5%8C%BA%E5%9D%97%E9%93%BE%E3%80%91%E5%A6%82%E4%BD%95%E8%A7%A3%E5%86%B3%E6%8B%9C%E5%8D%A0%E5%BA%AD%E5%B0%86%E5%86%9B%E9%97%AE%E9%A2%98/">⭐️2018-03-03【区块链】共识算法与如何解决拜占庭将军问题</a> ┃<a href="https://charlesliuyx.github.io/2017/09/25/%E5%8C%BA%E5%9D%97%E9%93%BE%EF%BC%88%E6%AF%94%E7%89%B9%E5%B8%81%EF%BC%89%E4%B8%8E%E9%87%91%E8%9E%8D/">2017-09-25【区块链】比特币与金融、ICO和监管</a> ┃<a href="https://charlesliuyx.github.io/2017/09/25/%E7%8E%B0%E4%BB%A3%E5%8C%BA%E5%9D%97%E9%93%BE%E4%B8%8E%E6%96%B0%E6%8A%80%E6%9C%AF/">2017-09-25【区块链】现代区块链与新技术</a> ┃<a href="https://charlesliuyx.github.io/2017/09/24/%E4%B8%80%E6%96%87%E5%BC%84%E6%87%82%E5%8C%BA%E5%9D%97%E9%93%BE-%E4%BB%A5%E6%AF%94%E7%89%B9%E5%B8%81%E4%B8%BA%E4%BE%8B/">⭐️2017-09-24【区块链】一文看懂区块链：一步一步发明比特币</a>  </p><p>﹝计算机技术﹞<a href="https://charlesliuyx.github.io/2019/04/21/%E3%80%90%E6%95%99%E7%A8%8B%E3%80%91manim%E5%8A%A8%E7%94%BB%E5%88%B6%E4%BD%9C%E5%B7%A5%E5%85%B7/">📝2019-10-01【教程】manim 动画制作工具</a>┃ <a href="https://charlesliuyx.github.io/2018/10/11/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91Egg%20Puzzle%20%E9%B8%A1%E8%9B%8B%E9%9A%BE%E9%A2%98/">⭐️⭐️2018-10-11【直观算法】Egg Puzzle 鸡蛋难题</a>┃ <a href="https://charlesliuyx.github.io/2017/10/13/%E7%A8%8B%E5%BA%8F%E5%91%98%E6%8A%80%E8%83%BD%E5%9B%BE%E8%B0%B1/">⭐️2017-10-13 程序员技能图谱</a> ┃<a href="https://charlesliuyx.github.io/2017/08/28/Xpath%E4%BD%BF%E7%94%A8%E6%8C%87%E5%8D%97/">2017-08-28 Xpath-Wiki</a> ┃<a href="https://charlesliuyx.github.io/2017/07/01/LeetcodeNote/">📝2017-07-01 LeetcodeNote</a></p><p>﹝能力提升﹞<a href="https://charlesliuyx.github.io/2018/06/20/%E9%82%A3%E4%BA%9B%E5%80%BC%E5%BE%97%E4%B8%80%E7%9C%8B%E7%9A%84TED%E6%BC%94%E8%AE%B2%E9%99%84%E5%85%A8%E6%96%87%E6%96%87%E7%A8%BF%E7%AC%94%E8%AE%B0/">⭐️2018-06-20 那些值得一看的TED演讲附全文文稿笔记</a> ┃<a href="https://charlesliuyx.github.io/2017/07/29/PDF%E5%A4%8D%E5%88%B6%E7%B2%98%E8%B4%B4%E5%8E%BB%E9%99%A4%E5%A4%9A%E4%BD%99%E7%9A%84%E5%9B%9E%E8%BD%A6%E7%AC%A6/">2017-07-29 PDF复制粘贴去除多余的回车符</a> ┃<a href="https://charlesliuyx.github.io/2017/05/13/English-abbreviation/">2017-05-13 English-abbreviation</a></p><p>﹝原创﹞<a href="https://charlesliuyx.github.io/2017/06/17/%E5%B9%95%E5%B8%83-%E5%85%A8%E5%B9%B3%E5%8F%B0%E7%AC%94%E8%AE%B0%E6%80%9D%E7%BB%B4%E5%AF%BC%E5%9B%BE%E5%B7%A5%E5%85%B7/">⭐️2017-06-17 幕布-全平台笔记思维导图工具</a> ┃<a href="https://charlesliuyx.github.io/2017/05/13/%E6%9C%89%E5%85%B3%E4%B8%AD%E5%9B%BD%E8%AF%97%E7%9A%84%E9%82%A3%E4%BA%9B%E4%BA%8B/">⭐️2017-05-13【散文】有关中国诗的那些事</a>  </p><a id="more"></a><p>﹝清单和百科﹞<a href="https://charlesliuyx.github.io/2017/11/05/Dota2-A%E5%B8%90%E6%95%88%E6%9E%9C/">2017-11-05 Dota2-A帐效果</a> ┃<a href="https://charlesliuyx.github.io/2017/09/18/Dota2%E4%BC%A4%E5%AE%B3%E7%B1%BB%E5%9E%8B%E8%AF%A6%E8%A7%A3/">2017-09-18 Dota2伤害类型详解</a> ┃<a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/">2017-09-05 Dota2机制总结</a> ┃<a href="https://charlesliuyx.github.io/2017/05/14/%E6%B8%85%E6%AC%A2/">2017-05-14 【摘抄】清欢 - 林清玄</a>  </p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;&lt;a href=&quot;https://mubu.com/doc/3nIWmLzEPl&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;幕布版本总目录&lt;/a&gt;  ║  ⭐️ 推荐文章  ║  📝 正在更新&lt;/p&gt;
&lt;p&gt;﹝信息流转学﹞&lt;a href=&quot;https://gofurther.feishu.cn/docs/doccnbZAjYhNeH6q0MZVasdrXLb&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;2021-07-01 信息流转学综述&lt;/a&gt; &lt;/p&gt;
&lt;p&gt;﹝机器学习﹞&lt;a href=&quot;https://charlesliuyx.github.io/2018/01/19/%E5%BE%AE%E4%BF%A1%E8%B7%B3%E4%B8%80%E8%B7%B3%E8%A7%A3%E9%A2%98%E6%8A%A5%E5%91%8A/&quot;&gt;2018-01-19 微信跳一跳解题报告&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/18/%E6%B7%B1%E5%85%A5%E6%B5%85%E5%87%BA%E7%9C%8B%E6%87%82AlphaGo%E5%85%83/&quot;&gt;⭐️2017-10-18 深入浅出看懂AlphaGo元&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/&quot;&gt;⭐️2017-05-27 深入浅出看懂AlphaGo如何下棋&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/30/Pandas-Wiki/&quot;&gt;2017-09-30 Pandas-Wiki&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/03/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AF%E6%AD%A3%E5%88%99%E5%8C%96/&quot;&gt;⭐️2017-10-03【直观详解】什么是正则化&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/05/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AFPCA%E3%80%81SVD/&quot;&gt;📝【直观详解】什么是PCA、SVD&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/20/%E6%8B%89%E6%A0%BC%E6%9C%97%E6%97%A5%E4%B9%98%E6%B3%95%E5%92%8CKKT%E6%9D%A1%E4%BB%B6/&quot;&gt;2017-09-20【直观详解】拉格朗日乘法和KKT条件&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/19/%E6%94%AF%E6%8C%81%E5%90%91%E9%87%8F%E6%9C%BASVM%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/&quot;&gt;2017-09-19【直观详解】支持向量机SVM&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/12/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E5%88%86%E7%B1%BB%E5%99%A8%E6%80%A7%E8%83%BD%E6%8C%87%E6%A0%87%E8%AF%A6%E8%A7%A3/&quot;&gt;2017-09-12 【直观详解】机器学习分类器性能指标详解&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/11/%E4%BB%80%E4%B9%88%E6%98%AF%E4%BF%A1%E6%81%AF%E7%86%B5%E3%80%81%E4%BA%A4%E5%8F%89%E7%86%B5%E5%92%8C%E7%9B%B8%E5%AF%B9%E7%86%B5/&quot;&gt;⭐️2017-09-11【直观详解】信息熵、交叉熵和相对熵&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/04/LogisticRegression%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/&quot;&gt;2017-09-04【直观详解】Logistic Regression&lt;/a&gt;&lt;/p&gt;
&lt;p&gt;﹝理论基础﹞&lt;a href=&quot;https://charlesliuyx.github.io/2018/09/20/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E9%80%9A%E4%BF%97%E6%98%93%E6%87%82%E4%BA%86%E8%A7%A3%E4%BB%80%E4%B9%88%E6%98%AF%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3/&quot;&gt;⭐️2018-09-20【直观详解】通俗易懂了解什么是黎曼猜想&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2018/02/18/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E8%AE%A9%E4%BD%A0%E6%B0%B8%E8%BF%9C%E5%BF%98%E4%B8%8D%E4%BA%86%E7%9A%84%E5%82%85%E9%87%8C%E5%8F%B6%E5%8F%98%E6%8D%A2%E8%A7%A3%E6%9E%90/&quot;&gt;⭐️2018-02-18【直观详解】让你永远忘不了的傅里叶变换解析&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2018/02/16/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E6%B3%B0%E5%8B%92%E7%BA%A7%E6%95%B0/&quot;&gt;⭐️2018-02-16【直观详解】泰勒级数&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/&quot;&gt;⭐️2017-10-06【直观详解】线性代数的本质&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/17/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E4%B8%AD%E7%9A%84%E6%AD%A3%E4%BA%A4%E6%AD%A3%E8%A7%84%E6%AD%A3%E5%AE%9A%E8%BD%AC%E7%BD%AE/&quot;&gt;2017-10-17【直观详解】线性代数中的转置正交正规正定&lt;/a&gt;  &lt;/p&gt;
&lt;p&gt;﹝区块链﹞&lt;a href=&quot;https://charlesliuyx.github.io/2018/03/03/%E3%80%90%E5%8C%BA%E5%9D%97%E9%93%BE%E3%80%91%E5%A6%82%E4%BD%95%E8%A7%A3%E5%86%B3%E6%8B%9C%E5%8D%A0%E5%BA%AD%E5%B0%86%E5%86%9B%E9%97%AE%E9%A2%98/&quot;&gt;⭐️2018-03-03【区块链】共识算法与如何解决拜占庭将军问题&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/25/%E5%8C%BA%E5%9D%97%E9%93%BE%EF%BC%88%E6%AF%94%E7%89%B9%E5%B8%81%EF%BC%89%E4%B8%8E%E9%87%91%E8%9E%8D/&quot;&gt;2017-09-25【区块链】比特币与金融、ICO和监管&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/25/%E7%8E%B0%E4%BB%A3%E5%8C%BA%E5%9D%97%E9%93%BE%E4%B8%8E%E6%96%B0%E6%8A%80%E6%9C%AF/&quot;&gt;2017-09-25【区块链】现代区块链与新技术&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/09/24/%E4%B8%80%E6%96%87%E5%BC%84%E6%87%82%E5%8C%BA%E5%9D%97%E9%93%BE-%E4%BB%A5%E6%AF%94%E7%89%B9%E5%B8%81%E4%B8%BA%E4%BE%8B/&quot;&gt;⭐️2017-09-24【区块链】一文看懂区块链：一步一步发明比特币&lt;/a&gt;  &lt;/p&gt;
&lt;p&gt;﹝计算机技术﹞&lt;a href=&quot;https://charlesliuyx.github.io/2019/04/21/%E3%80%90%E6%95%99%E7%A8%8B%E3%80%91manim%E5%8A%A8%E7%94%BB%E5%88%B6%E4%BD%9C%E5%B7%A5%E5%85%B7/&quot;&gt;📝2019-10-01【教程】manim 动画制作工具&lt;/a&gt;┃ &lt;a href=&quot;https://charlesliuyx.github.io/2018/10/11/%E3%80%90%E7%9B%B4%E8%A7%82%E7%AE%97%E6%B3%95%E3%80%91Egg%20Puzzle%20%E9%B8%A1%E8%9B%8B%E9%9A%BE%E9%A2%98/&quot;&gt;⭐️⭐️2018-10-11【直观算法】Egg Puzzle 鸡蛋难题&lt;/a&gt;┃ &lt;a href=&quot;https://charlesliuyx.github.io/2017/10/13/%E7%A8%8B%E5%BA%8F%E5%91%98%E6%8A%80%E8%83%BD%E5%9B%BE%E8%B0%B1/&quot;&gt;⭐️2017-10-13 程序员技能图谱&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/08/28/Xpath%E4%BD%BF%E7%94%A8%E6%8C%87%E5%8D%97/&quot;&gt;2017-08-28 Xpath-Wiki&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/07/01/LeetcodeNote/&quot;&gt;📝2017-07-01 LeetcodeNote&lt;/a&gt;&lt;/p&gt;
&lt;p&gt;﹝能力提升﹞&lt;a href=&quot;https://charlesliuyx.github.io/2018/06/20/%E9%82%A3%E4%BA%9B%E5%80%BC%E5%BE%97%E4%B8%80%E7%9C%8B%E7%9A%84TED%E6%BC%94%E8%AE%B2%E9%99%84%E5%85%A8%E6%96%87%E6%96%87%E7%A8%BF%E7%AC%94%E8%AE%B0/&quot;&gt;⭐️2018-06-20 那些值得一看的TED演讲附全文文稿笔记&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/07/29/PDF%E5%A4%8D%E5%88%B6%E7%B2%98%E8%B4%B4%E5%8E%BB%E9%99%A4%E5%A4%9A%E4%BD%99%E7%9A%84%E5%9B%9E%E8%BD%A6%E7%AC%A6/&quot;&gt;2017-07-29 PDF复制粘贴去除多余的回车符&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/05/13/English-abbreviation/&quot;&gt;2017-05-13 English-abbreviation&lt;/a&gt;&lt;/p&gt;
&lt;p&gt;﹝原创﹞&lt;a href=&quot;https://charlesliuyx.github.io/2017/06/17/%E5%B9%95%E5%B8%83-%E5%85%A8%E5%B9%B3%E5%8F%B0%E7%AC%94%E8%AE%B0%E6%80%9D%E7%BB%B4%E5%AF%BC%E5%9B%BE%E5%B7%A5%E5%85%B7/&quot;&gt;⭐️2017-06-17 幕布-全平台笔记思维导图工具&lt;/a&gt; ┃&lt;a href=&quot;https://charlesliuyx.github.io/2017/05/13/%E6%9C%89%E5%85%B3%E4%B8%AD%E5%9B%BD%E8%AF%97%E7%9A%84%E9%82%A3%E4%BA%9B%E4%BA%8B/&quot;&gt;⭐️2017-05-13【散文】有关中国诗的那些事&lt;/a&gt;  &lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
  </entry>
  
  <entry>
    <title>TensorSpace 一个3D神经网络可视化框架</title>
    <link href="https://charlesliuyx.github.io/2018/09/28/TensorSpace-3D%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C%E5%8F%AF%E8%A7%86%E5%8C%96%E6%A1%86%E6%9E%B6/"/>
    <id>https://charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/</id>
    <published>2018-09-28T08:00:20.000Z</published>
    <updated>2018-11-13T18:39:29.724Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】5min | 2k字<br>【阅读内容】<a href="https://tensorspace.org" target="_blank" rel="noopener">TensorSpace</a> - 是一款3D模型可视化框架，支持多种模型，帮助你可视化层间输出，更直观的展示模型的输入输出，帮助理解模型结构，输出方法。<a href="https://github.com/tensorspace-team/tensorspace" target="_blank" rel="noopener">Github</a></p><a id="more"></a><blockquote><p> 机器学习入门？先上手玩玩看！</p></blockquote><h1 id="是什么（What）"><a href="#是什么（What）" class="headerlink" title="是什么（What）"></a>是什么（What）</h1><p><code>TensorSpace</code>是一款<strong>3D模型可视化框架</strong>，一动图胜千言。<a href="tensorspace.org">官网链接</a>，<a href="https://github.com/tensorspace-team/tensorspace" target="_blank" rel="noopener">Github链接</a></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/TensorSpaceLeNet.gif" alt="" width="1000"></div><p>⭐️<code>TensorSpace</code>擅长直观展示<strong>模型结构</strong>和<strong>层间数据</strong>，生成的模型<strong>可交互</strong>。官方支持<a href="https://tensorspace.org/html/playground/lenet.html" target="_blank" rel="noopener">手写字符识别</a>，<a href="https://tensorspace.org/html/playground/mobilenetv1.html" target="_blank" rel="noopener">物体识别</a>，<a href="https://tensorspace.org/html/playground/acgan.html" target="_blank" rel="noopener"><code>0-9</code>字符对抗生成网络案例</a>等</p><h1 id="为什么（Why）"><a href="#为什么（Why）" class="headerlink" title="为什么（Why）"></a>为什么（Why）</h1><p>本部分说明：<strong>❓为什么要使用这个框架❓这个框架主要解决了什么问题❓我们的灵感来源于何处</strong></p><h2 id="3D神经网络可视化一片空白"><a href="#3D神经网络可视化一片空白" class="headerlink" title="3D神经网络可视化一片空白"></a>3D神经网络可视化一片空白</h2><p>在<strong>机器学习可视化</strong>上，每个<strong>机器学习框架</strong>都有自己的【御用工具】，<a href="https://github.com/tensorflow/tensorboard" target="_blank" rel="noopener">Tensorboard</a>之于<code>Tensorflow</code> ，<a href="https://github.com/facebookresearch/visdom" target="_blank" rel="noopener">Visdom</a>之于<code>Pytorch</code>，<a href="https://github.com/awslabs/mxboard" target="_blank" rel="noopener">MXboard</a>之于<code>MXnet</code>。这些工具的Slogan不一而同的选择了<code>Visualization Learning</code>(TensorBoard的Slogan)，也就是<strong>面向专业机器学习开发者</strong>，针对<strong>训练过程，调参</strong>等设计的专业向可视化工具</p><p>但面向一般的<strong>计算机工程师</strong>和<strong>非技术类人才（市场，营销，产品）</strong>，一片空白，没有一个优秀的工具来帮助他们理解<span sytle="font-weight:bold; color: red">❓机器学习模型到底做了什么，能解决一个什么问题</span></p><p>机器学习开发和工程使用并不是那么遥不可及，<code>TensorSpace</code>搭建桥梁链接<strong>实际问题</strong>和<strong>机器学习模型</strong></p><h2 id="3D可视化的信息密度更高更直观"><a href="#3D可视化的信息密度更高更直观" class="headerlink" title="3D可视化的信息密度更高更直观"></a>3D可视化的信息密度更高更直观</h2><p>市面上常见的机器学习可视化框架都是<strong>基于图表</strong>（2D），这是由它们的<strong>应用领域</strong>（训练调试）决定的。但3D可视化<strong>不仅能同时表示层间信息，更能直观的展示模型结构</strong>，这一点是2D可视化不具备的。例如在何凯明大神的Mask-RCNN论文中：</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/Show.png" alt="" width="600"></div><p>有这么一幅图来<strong>描述模型结构</strong>（很多模型设计类和应用落地类的论文都会有这么一副图）而<code>TensorSpace</code>可以让用户使用浏览器方便的构建出一个<strong>可交互的神经网络3D结构</strong></p><p>更进一步的，利用3D模型的表意能力特点，结合<a href="https://js.tensorflow.org/" target="_blank" rel="noopener">TensorFlow.js</a>，可在<strong>浏览器中进行模型预测</strong>（跑已经训练好的模型看输入输出分别是什么❗️），帮助理解模型</p><h2 id="【模型结构】黑盒子的真面目是什么？"><a href="#【模型结构】黑盒子的真面目是什么？" class="headerlink" title="【模型结构】黑盒子的真面目是什么？"></a>【模型结构】黑盒子的真面目是什么？</h2><p>模型就像是一个盛水的容器，而预训练模型就给这个容器装满了水，可以用来解决实际问题。<strong>搞明白一个模型的输入是什么，输出是什么，如何转化成我们可理解的数据结构格式</strong>（比如输出的是一个物体标识框的左上角左下角目标）就可以方便的理解某个模型具体做了什么</p><p>例如，❓<a href="http://tensorspace.org/html/playground/yolov2-tiny.html" target="_blank" rel="noopener">Yolo</a>到底是如何算出最后的物体识别框的？❓<a href="http://tensorspace.org/html/playground/lenet.html" target="_blank" rel="noopener">LeNet</a>是如何做手写识别的？❓<a href="http://tensorspace.org/html/playground/acgan.html" target="_blank" rel="noopener">ACGAN</a>是怎么一步一步生成一个<code>0-9</code>的图片的？这些都可以在提供的<code>Playground</code>中<strong>自行探索</strong></p><p>如下图所示，模型层间的链接信息可通过直接鼠标悬停具体查看</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/ShowStruc.png" alt="" width="1000"></div><p><br></p><h2 id="【层间数据】神经网络的每一层都做了什么？"><a href="#【层间数据】神经网络的每一层都做了什么？" class="headerlink" title="【层间数据】神经网络的每一层都做了什么？"></a>【层间数据】神经网络的每一层都做了什么？</h2><p>3D模型不仅仅可以直观的展示出神经网络的结构特征（哪些层相连，每一层的数据和计算是从哪里来），结合<a href="https://js.tensorflow.org/" target="_blank" rel="noopener">Tensorflow.js</a>，可在<strong>浏览器中进行模型预测</strong>。由于我们已经有了模型结果，所有的层间数据直观可见，如下图所示：</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/InData.png" alt="" width="1000"></div><p>可以通过 <code>TensorSpace</code> Layer的<strong>对象属性</strong>方便的拿到每一层的输出数据（未经处理），工程和应用上，了解一个模型的原始输出数据方便工程落地</p><h1 id="怎么建（How）"><a href="#怎么建（How）" class="headerlink" title="怎么建（How）"></a>怎么建（How）</h1><p>首先你需要有一个使用常用框架训练好的的<strong>预训练模型</strong>，常见的模型都是只有<strong>输入输出</strong>两个暴露给用户的接口。<code>TensorSpace</code>可以全面的<strong>展示层间数据</strong>，不过需要用户将模型转换成<strong>多输出的模型</strong>，过程详见<a href="https://tensorspace.org/html/docs/preIntro_zh.html" target="_blank" rel="noopener">此文档</a>。具体流程如下图所示：</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/Flow.png" alt="" width="900"></div><p>用<code>TensorSpace</code>构建对应模型这一步，下面一段构建<code>LeNet</code>的代码可能更加直观，如果要在本地运行，需要Host本地Http Server</p><iframe height="400" scrolling="no" title="TensorSpace LetNet" src="//codepen.io/syt123450/embed/667a7943b0f23727790ca38c93389689/?height=300&theme-id=33158&default-tab=js,resultundefined&editable=true" frameborder="no" allowtransparency="true" allowfullscreen="true" style="width: 100%;">See the Pen TensorSpace Hello World by syt123450 (@syt123450) on CodePen. </iframe><p>你最需要的是<strong>模型结构的相关信息</strong>，<code>Tensorflow</code>，<code>Keras</code>都有对应的API打印模型结构信息，比如<code>Keras</code>的<code>model.summary()</code>。还有类似生成结构图的方式，生成如下图的模型结构2D示意图</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/28/TensorSpace-3D神经网络可视化框架/LeNet-Model.png" alt="" width="300"></div><p>是的，<strong>你需要对模型结构非常了解</strong>才可能构建出对应的<code>TensoSpace</code>模型，未来版本已计划推出自动脚本，通过导入对应的模型预训练文件，<strong>一键生成多输出模型</strong>。但是<code>TensoSpace</code>的Playground会未来子项目会力所能及的收集更多的模型，在模型应用落地和直观展示这个领域努力做出自己的贡献</p><h1 id="谁可能用（Who）"><a href="#谁可能用（Who）" class="headerlink" title="谁可能用（Who）"></a>谁可能用（Who）</h1><p>做这样一款开源框架，除了填补3D可视化的一般解决方案的框架空白外，还思索了几个可能可行的<strong>应用场景</strong></p><h2 id="前端开发者过度机器学习"><a href="#前端开发者过度机器学习" class="headerlink" title="前端开发者过度机器学习"></a>前端开发者过度机器学习</h2><blockquote><p>前端（全栈）开发者，产品经理等</p></blockquote><p>未来，前端的重复性工作可能会慢慢减少。最近有一个<a href="https://zhuanlan.zhihu.com/p/48580981" target="_blank" rel="noopener">原型图 ➜ HTML代码的项目</a>，另一个2017年的<a href="https://github.com/tonybeltramelli/pix2code" target="_blank" rel="noopener">开源项目</a>都在尝试利用机器学习自动化一些Coding中的<strong>重复劳动，提高效率</strong></p><p>机器学习一定<strong>不会</strong>取代前端工程师，但掌握机器学习工具的工程师会有优势（这种工具会不会整合进Sketch等工具不好说），既然入了工程师行，终身学习势在必行！</p><p><code>TensorSpace</code>虽然不是能帮忙训练和设计模型，但擅长帮助工程师<strong>理解已有的模型</strong>，找到<strong>可应用的领域</strong>。并且在接驳光法开发者到机器学习的大道上做了一点微小的工作，走一个可视化的<code>Model Zoo</code></p><h2 id="机器学习教育"><a href="#机器学习教育" class="headerlink" title="机器学习教育"></a>机器学习教育</h2><blockquote><p>机器学习课程教育者</p></blockquote><p>使用<code>Tensorspace</code>直观的在浏览器上显示模型细节和数据流动方向，讲解常见模型的实现原理，比如ResNet，Yolo等，可以让学生更直观的了解一个<strong>模型的前世今生</strong>，输入什么，输出什么，怎么处理数据等等</p><p>我们只是提供了一个框架，每一个模型如果需要直观的展示对数据的处理过程，都<strong>值得3D化</strong></p><h2 id="模型演示和传播"><a href="#模型演示和传播" class="headerlink" title="模型演示和传播"></a>模型演示和传播</h2><blockquote><p>机器学习开发者</p></blockquote><p><code>JavaScript</code>最大的优势就是可以<strong>在浏览器中运行</strong>，没有烦人的依赖，不需要踩过各种坑。有一个版本不那么落后的浏览器和一台性能还成的电脑就可以完整访问所有内容</p><p>如果您的项目对展示<strong>自己的模型可以做什么</strong>，<strong>是怎么做</strong>的有需求，私以为，不应错过<code>TensorSpace</code></p><p>用<code>TensorSpace</code><strong>教学模型原理</strong>效果非常好。提供了一个接口去写代码，搞清楚每一个输出代表了什么，是如何转化成最后结果（从输出到最后结果的转换还是需要写<code>JavaScript</code>代码去构建模型结构，在这个过程中也能更进一步<strong>理解模型的构造细节</strong>）</p><p>现在还没有完成的<code>Yolov2-tiny</code>就是因为<code>JavaScript</code>的轮子较少（大多数处理轮子都使用Python完成），所有的数据处理都需徒手搭建。时间的力量是强大的，我们搭建一个地基，万丈高楼平地起！</p><h1 id="致谢"><a href="#致谢" class="headerlink" title="致谢"></a>致谢</h1><h2 id="机器学习部分"><a href="#机器学习部分" class="headerlink" title="机器学习部分"></a>机器学习部分</h2><p>我们最初的灵感来源于一个真正教会我深度卷积网是如何工作的网站：<a href="http://scs.ryerson.ca/~aharley/vis/conv/" target="_blank" rel="noopener">http://scs.ryerson.ca/~aharley/vis/conv/</a>（源码只能下载，我Host了一份在<a href="https://github.com/CharlesLiuyx/3DVis_ConvNN" target="_blank" rel="noopener">Github</a>上）</p><p>这个网站的效果，<strong>也是团队未来努力的方向</strong>（大网络上，因为实体过多，性能无法支持。为了解决性能问题，我们优化为：不是一个Pixel一个Pixel的渲染，而是一个特征图一个特征图的处理）</p><h2 id="前端部分"><a href="#前端部分" class="headerlink" title="前端部分"></a>前端部分</h2><p>使用<a href="https://js.tensorflow.org/" target="_blank" rel="noopener">Tensorflow.js</a> <a href="https://threejs.org/" target="_blank" rel="noopener">Three.js</a> <a href="https://github.com/tweenjs/tween.js/" target="_blank" rel="noopener">Tween.js</a> 等框架完成这个项目，感谢前人给的宽阔肩膀让我们有机会去探索更广阔的世界</p><h2 id="开发团队们"><a href="#开发团队们" class="headerlink" title="开发团队们"></a>开发团队们</h2><p>感谢每一个为这个项目付出的伙伴，没有你们每个人，就没有这个开源项目破土而出！团队中负责开发的<a href="https://github.com/syt123450" target="_blank" rel="noopener">syt123450</a>（主力）和<a href="https://github.com/zchholmes" target="_blank" rel="noopener">Chenhua Zhu</a>，设计师<a href="https://github.com/lq3297401" target="_blank" rel="noopener">Qi(Nora)</a>，感谢他们！还有负责机器学习模型部分和文档的<a href="https://github.com/CharlesLiuyx" target="_blank" rel="noopener">我</a></p><p>也欢迎你有什么想法给我留言，或直接在<a href="https://github.com/tensorspace-team/tensorspace/issues" target="_blank" rel="noopener">Github</a>上提出Pull Request</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】5min | 2k字&lt;br&gt;【阅读内容】&lt;a href=&quot;https://tensorspace.org&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;TensorSpace&lt;/a&gt; - 是一款3D模型可视化框架，支持多种模型，帮助你可视化层间输出，更直观的展示模型的输入输出，帮助理解模型结构，输出方法。&lt;a href=&quot;https://github.com/tensorspace-team/tensorspace&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;Github&lt;/a&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Visualization" scheme="https://charlesliuyx.github.io/tags/Visualization/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】通俗易懂了解什么是黎曼猜想</title>
    <link href="https://charlesliuyx.github.io/2018/09/20/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E9%80%9A%E4%BF%97%E6%98%93%E6%87%82%E4%BA%86%E8%A7%A3%E4%BB%80%E4%B9%88%E6%98%AF%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3/"/>
    <id>https://charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/</id>
    <published>2018-09-20T15:49:58.000Z</published>
    <updated>2020-12-10T03:55:31.440Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】15min - 20min | 9000+字 | 23张动图 | 11张图片<br>【阅读内容】一文搞懂什么是<strong>黎曼猜想</strong>。在复数域直观可视化黎曼$\zeta$函数（读作<code>/zita/</code>），解释什么是<strong>解析延拓</strong>（analytic continuation），探究黎曼猜想和素数的关系</p><a id="more"></a><p><strong>分享者是最大的受益者，感谢各位莅临阅读！</strong></p><p>【说明】本文<strong>科普为主</strong>，是<a href="https://www.youtube.com/watch?v=sD0NjbwqlYw&amp;list=UUYO_jab_esuFRV4b17AJtAw&amp;index=76&amp;t=0s" target="_blank" rel="noopener">3B1B视频</a>（版权来源）的笔记。会有很多废话来<strong>增加信息冗余度</strong>，方便对复分析之类概念<strong>不熟悉的读者</strong>理解。有基础的读者可以选择<strong>跳过</strong>一些在你们看来是在说废话的内容。就像重要的事情说三遍一样，<strong>废话</strong>增加信息的冗余度，减慢节奏，降低认知负担，希望这么做后能有更多人真正看懂<strong>什么是黎曼猜想</strong>。</p><h1 id="八卦黎曼"><a href="#八卦黎曼" class="headerlink" title="八卦黎曼"></a>八卦黎曼</h1><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/Riemann.jpeg" alt="黎曼头像" width="400"></div><p>黎曼全名<code>格奥尔格·弗雷德里希·波恩哈德·黎曼 〔德语〕Georg Friedrich Bernhard Riemann</code>（1826 - 1866），德国数学家。黎曼的父亲是个<strong>牧师</strong>，在他长大之后，就读于哥廷根大学（德国西南部）<strong>神学系</strong></p><p>后来在大学听了一场<code>高斯</code>有关<strong>最小二乘法</strong>的讲座，发现了命中天赋所在。征得父亲同意后，转到<strong>柏林大学</strong>改修数学，拜入<a href="https://zh.wikipedia.org/wiki/%E9%9B%85%E5%8F%AF%E6%AF%94" target="_blank" rel="noopener">雅可比</a>和<a href="https://zh.wikipedia.org/wiki/%E7%8B%84%E5%88%A9%E5%85%8B%E9%9B%B7" target="_blank" rel="noopener">狄利克雷</a>门下（雅克比行列式，第一个玩椭圆的人；机器学习中的狄利克雷分布，证明费马大定理 n=5 的人；没错就是这两个大牛）</p><h2 id="历史背景"><a href="#历史背景" class="headerlink" title="历史背景"></a>历史背景</h2><p><strong>不谈历史背景的人物介绍都是耍流氓</strong>，好，回过头来看看黎曼生长的德国（当时还不能叫德国）当时在干啥</p><p>1806年<strong>拿破仑</strong>覆灭统治几百年的<a href="https://zh.wikipedia.org/wiki/%E7%A5%9E%E8%81%96%E7%BE%85%E9%A6%AC%E5%B8%9D%E5%9C%8B" target="_blank" rel="noopener">神圣罗马帝国</a>。1815年以<strong>日耳曼民族</strong>为主的<a href="https://zh.wikipedia.org/wiki/%E5%BE%B7%E6%84%8F%E5%BF%97%E9%82%A6%E8%81%94" target="_blank" rel="noopener">德意志邦联</a>成立，在这个联邦中，以<a href="https://zh.wikipedia.org/wiki/%E6%99%AE%E9%AD%AF%E5%A3%AB" target="_blank" rel="noopener">普鲁士</a>和<a href="https://zh.wikipedia.org/wiki/%E5%A5%A7%E5%9C%B0%E5%88%A9" target="_blank" rel="noopener">奥地利</a>最为强大，两大势力得争个高下。一直到1862年<strong>脾斯麦</strong>执政，才走向一统。最终，1871年，<a href="https://zh.wikipedia.org/wiki/%E5%BE%B7%E6%84%8F%E5%BF%97%E5%B8%9D%E5%9B%BD" target="_blank" rel="noopener">德意志帝国</a>成立，黎曼没能见到这一天</p><p>19世纪5、60年代<strong>普鲁士</strong>完成了工业革命，这必定伴随着<strong>思想和科学</strong>的蓬勃发展。黎曼是生在一个好时代，这个时代，整个科学领域，一片蓝海，名家辈出，群星璀璨</p><p>有意思的是，<code>K12</code>这个名词就发源于<strong>普鲁士</strong>。<code>K</code>指Kindergarten，及幼儿园，<code>12</code>指12年级，也就是高三。<code>K12</code>泛指<strong>基础教育</strong>。虽然这<strong>工业化的流水线教育模式</strong>可能更多的是为了<strong>培养流水线式</strong>的工业人才或士兵，但不能否认，<strong>重视教育则学界兴盛</strong></p><h2 id="成就"><a href="#成就" class="headerlink" title="成就"></a>成就</h2><p>黎曼成就斐然，最有名的当然是<strong>黎曼几何（积分）</strong>，黎曼流形和复分析之父。当然还有本篇文章的主人公，<strong>1859年</strong>提出的<strong>黎曼猜想</strong></p><p><strong>黎曼猜想</strong>被收录进1900年希尔伯特（Hilbert）提出的<a href="https://zh.wikipedia.org/zh-hans/%E5%B8%8C%E5%B0%94%E4%BC%AF%E7%89%B9%E7%9A%8423%E4%B8%AA%E9%97%AE%E9%A2%98" target="_blank" rel="noopener">23个重大难题</a>，这些难题经过100年的岁月，<strong>还剩下6道</strong>没有被完全解决</p><blockquote><p>【补充1】因为代数几何中有关<strong>椭圆曲线</strong>的相关研究还没有兴盛，著名的费马大定理：$x^n + y^n = z^n \; 当\;n&gt;2\;没有整数解$ 未出现在列表中，虽然当时这个猜想也没有被证明</p><p>【补充2】在希尔伯特的问题列表中，黎曼猜想并不<strong>单独</strong>为一题。包含黎曼猜想的第8题是：<a href="https://zh.wikipedia.org/wiki/%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">黎曼猜想</a>及<a href="https://zh.wikipedia.org/wiki/%E5%93%A5%E5%BE%B7%E5%B7%B4%E8%B5%AB%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">哥德巴赫猜想</a>和<a href="https://zh.wikipedia.org/wiki/%E5%AD%AA%E7%94%9F%E7%B4%A0%E6%95%B0%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">孪生素数猜想</a>，这每一个猜想都闻名遐迩。三位一体，由此可见这三个问题之间是存在关联的</p></blockquote><p>21世纪<strong>黎曼猜想</strong>又被列为<a href="https://baike.baidu.com/item/%E5%8D%83%E7%A6%A7%E5%B9%B4%E5%A4%A7%E5%A5%96%E9%9A%BE%E9%A2%98/3890057" target="_blank" rel="noopener">千禧年7道世纪难题</a>之一，<a href="https://zh.wikipedia.org/wiki/%E5%85%8B%E9%9B%B7%E6%95%B8%E5%AD%B8%E7%A0%94%E7%A9%B6%E6%89%80" target="_blank" rel="noopener">克雷数学研究所</a>承诺：解决一道题 ➜ 100万美元</p><blockquote><p><a href="https://zh.wikipedia.org/wiki/P/NP%E9%97%AE%E9%A2%98" target="_blank" rel="noopener">P/NP问题</a> | <a href="https://zh.wikipedia.org/wiki/%E9%9C%8D%E5%A5%87%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">霍奇猜想</a> | <a href="https://zh.wikipedia.org/wiki/%E5%BA%9E%E5%8A%A0%E8%8E%B1%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">庞加莱猜想</a>（已证明）| 黎曼猜想 | <a href="https://zh.wikipedia.org/wiki/%E6%A5%8A-%E7%B1%B3%E7%88%BE%E6%96%AF%E5%AD%98%E5%9C%A8%E6%80%A7%E8%88%87%E8%B3%AA%E9%87%8F%E9%96%93%E9%9A%99" target="_blank" rel="noopener">杨-米尔斯存在性与质量间隙</a> | <a href="https://zh.wikipedia.org/wiki/%E7%B4%8D%E7%B6%AD-%E6%96%AF%E6%89%98%E5%85%8B%E6%96%AF%E5%AD%98%E5%9C%A8%E6%80%A7%E8%88%87%E5%85%89%E6%BB%91%E6%80%A7" target="_blank" rel="noopener">纳维-斯托克斯存在性与光滑性</a> | <a href="https://zh.wikipedia.org/wiki/%E8%B4%9D%E8%B5%AB%E5%92%8C%E6%96%AF%E7%BB%B4%E8%AE%B7%E9%80%9A-%E6%88%B4%E5%B0%94%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">贝赫和斯维讷通-戴尔猜想</a></p></blockquote><h1 id="黎曼猜想的专业定义"><a href="#黎曼猜想的专业定义" class="headerlink" title="黎曼猜想的专业定义"></a>黎曼猜想的专业定义</h1><p>先搬运<a href="https://zh.wikipedia.org/wiki/%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">Wiki百科对黎曼猜想的定义</a>：黎曼$\zeta$函数，$\zeta(s) = \frac{1}{1^s} + \frac{1}{2^s} + \frac{1}{3^s} + \frac{1}{4^s} + \cdots$ 的<strong>非平凡零点</strong>（在此情况下是指 $s$ 不为-2，-4，-6…等点的值）的<strong>实数部分</strong>是 $\cfrac{1}{2}$</p><p>这个表述可以继续简述为：<strong>所有黎曼$\zeta$函数非平凡零点的实数部分是</strong> $\cfrac{1}{2}$</p><blockquote><p>【补充（只为严谨，可以跳过）】把上面的式子称为黎曼$\zeta$函数并不严谨，<a href="https://zh.wikipedia.org/wiki/%E9%BB%8E%E6%9B%BC%CE%B6%E5%87%BD%E6%95%B8" target="_blank" rel="noopener">严谨的来说</a>：定义域必须纳入考虑，才能完整写出黎曼$\zeta$函数的形式</p><p>设一<a href="https://zh.wikipedia.org/wiki/%E8%A4%87%E6%95%B8" target="_blank" rel="noopener">复数</a><em>s</em>，其<a href="https://zh.wikipedia.org/wiki/%E5%AF%A6%E6%95%B8" target="_blank" rel="noopener">实数</a>部份 &gt;1 ${s: Re(s) &gt; 1}$ 且<br>$$<br>\zeta(s) = \sum_{n=1}^{\infty} \frac{1}{n^s}<br>$$</p><p>它亦可以用积分定义<br>$$<br>\zeta(s) = \frac{1}{\Gamma(s)}\int_{0}^{\infty} \frac{x^{s-1}}{e^x - 1} dx<br>$$</p><p>在区域{<em>s</em> : Re(<em>s</em>) &gt; 1}上，此<a href="https://zh.wikipedia.org/wiki/%E6%97%A0%E7%A9%B7%E7%BA%A7%E6%95%B0" target="_blank" rel="noopener">无穷级数</a>收敛并为一<a href="https://zh.wikipedia.org/wiki/%E5%85%A8%E7%BA%AF%E5%87%BD%E6%95%B0" target="_blank" rel="noopener">全纯函数</a>。黎曼认识到：$\zeta$ 函数可以通过<a href="https://zh.wikipedia.org/wiki/%E8%A7%A3%E6%9E%90%E5%BC%80%E6%8B%93" target="_blank" rel="noopener">解析开拓</a>来扩展到一个定义在复数域 $ s, s≠ 1$上的全纯函数 $\zeta(s)$</p></blockquote><p>相信大部分读者如果是第一次看到这个定义，估计头都大了，但是<strong>列出不明白概念的清单</strong>是学习一个全新事物的有效办法，就按照这个思路来<strong>列一个清单</strong></p><ul><li>❓ 黎曼$\zeta$函数是个<strong>什么函数</strong>？ <code>若读者的数学基础为高中，那么博主猜测您有疑惑的是…这个符号，它的含义很简单：按照1 2 3 4每次加1的规律一直重复前一项的形式。举个例子：</code></li></ul><p>$$<br>\zeta(s) = \frac{1}{1^s} + \frac{1}{2^s} + \frac{1}{3^s} + \frac{1}{4^s} + \frac{1}{5^s} + \frac{1}{6^s} + \frac{1}{7^s} + \frac{1}{8^s} + \cdots = \sum_{n=1}^{\infty} \frac{1}{n^s}<br>$$</p><ul><li>❓ 什么是<strong>非平凡零点</strong>？ <code>本博文想说清楚的问题</code></li><li>❓ <strong>实数部分</strong>指的什么？难不成还有虚数部分？ <code>这部分涉及虚数的概念，虚数定义为</code> $\sqrt{-1}$ <code>记为符号 i，接下来就需要一些复数基础，这一点跳不过，但本博文也尝试帮你解决这个问题</code></li><li>❓ $\frac{1}{2}$ 这个数是怎么来的？ <code>本博文想说清楚的问题</code>  </li></ul><p>从知识构建的角度来说，搞清楚黎曼猜想的<strong>知识网父节点</strong>有<strong>基础复分析</strong>（知道复数以及如何分析）和<strong>微积分</strong>中的求导</p><p>还有另一个说法也和黎曼猜想有关，即 $1 + 2 + 3 + \cdots = - \cfrac{1}{12}$ ，怎么看这个式子都应该是无穷大啊，为啥等于 $-\cfrac{1}{12}$ 呢？看完后，你应该就能明白<strong>为什么</strong>会有这个令人不解的说法</p><h1 id="可视化黎曼-zeta-函数"><a href="#可视化黎曼-zeta-函数" class="headerlink" title="可视化黎曼$\zeta$函数"></a>可视化黎曼$\zeta$函数</h1><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/0-Riemann.gif" alt="" width="400"></div><p>第3部分就一步一步<strong>展开</strong>黎曼猜想这副瑰丽的<strong>“画卷”</strong>，希望在图穷过程中，能带来给您带来几个<code>Aha时刻</code>，感受数学之美</p><h2 id="黎曼-zeta-函数"><a href="#黎曼-zeta-函数" class="headerlink" title="黎曼$\zeta$函数"></a>黎曼$\zeta$函数</h2><p>首先，我们为了逻辑链的完整，先用一副动图再<strong>定义</strong>一下我们的主角黎曼$\zeta$函数，并且假设我们带入$s=2$ 会是什么情况</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/1-fdefine.gif" alt="定义" width="450"></div><p>你可以继续带入其他值，如果 $s&gt;1$ ，可算出一个<strong>确定的值</strong>，但你会发现如果 $s&lt;1$ ，那这个<strong>无穷级数</strong>（级数就是一长串数字 or 序列的数学专有名词）就会越加越大，无法<strong>收敛</strong>，又称<strong>发散</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/2-value.gif" alt="带入数值" width="500"></div><p>参考上面的动图，带入<strong>负数</strong>，明显越来越大呀？其实这里和<strong>定义域的选取</strong>有关，黎曼$\zeta$函数只有在 $s&gt;1$ 的时候<strong>能求出值</strong>（收敛），这个函数<strong>才有意义</strong>，那么<strong>定义域外的情况</strong>怎么处理呢？</p><p>如果你对黎曼猜想研究过，可能看过类似的结论 $\zeta(-2n) = 0$ 和 $\zeta(-1) = -\cfrac{1}{12}$ ，这又是为啥呢？</p><h2 id="定义域扩展到复数"><a href="#定义域扩展到复数" class="headerlink" title="定义域扩展到复数"></a>定义域扩展到复数</h2><p>在传统的定义域中，就是把 $s$ 作为<strong>输入</strong>带入黎曼$\zeta$函数，重新映射到数轴上的另一个数上，如下面的动图所示。如果你很好奇为什么这个级数的和是 $\cfrac{\pi^2}{6}$，<strong>这个数从何而来</strong>，<a href="">另一篇博文</a>会解答这个问题（3B1B的另一个视频的总结笔记），我会晚些时候更新</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/3-trans.gif" alt="" width="500"></div><p>黎曼做了一个<strong>扩展</strong>，他说：如果 $s$ 能取到<strong>复数</strong>会是一种什么情况呢？先添加一个复平面，并另 $s=2+i$，过程参看下面的动图</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/4-trans.gif" alt="" width="500"></div><p>所谓定义域扩展其实非常好理解：之前 $s=1$，它是一个实数。现在让 $s = 2 + i$ ，变成一个复数，这就是复数域扩展 </p><p>❓这里可能会出现<strong>两个问题</strong> ➜ ① 什么是复平面？ ② $\left(\cfrac{1}{2}\right)^{2+i}$ 怎么计算？<strong>几何含义</strong>是什么？</p><h3 id="复平面"><a href="#复平面" class="headerlink" title="复平面"></a>复平面</h3><p>复数是<strong>拥有实部和虚部</strong>的表示法，写为 $a + bi$ ，$a$ 为实部，$b$ 为虚部， $\sqrt{-1}$ 定义为 $i$，称为虚数单位 。而复平面（complex plane）是用水平的<strong>实轴</strong>与垂直的<strong>虚轴</strong>建立起来的复数的几何表示，如下图所示（来源维基百科）</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/complex-plane.png" alt="" width="200"></div><p><strong>研究复数有什么意义？</strong>其中有一点和我们这个主题有关，$i$ 虚数单位和幂指数函数勾连起来在复分析中能连接上<strong>旋转</strong>这个概念。具体来说，参看我的这篇<a href="https://charlesliuyx.github.io/2018/02/18/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E8%AE%A9%E4%BD%A0%E6%B0%B8%E8%BF%9C%E5%BF%98%E4%B8%8D%E4%BA%86%E7%9A%84%E5%82%85%E9%87%8C%E5%8F%B6%E5%8F%98%E6%8D%A2%E8%A7%A3%E6%9E%90/#%E6%AC%A7%E6%8B%89%E5%85%AC%E5%BC%8F%E4%B8%8E%E6%97%8B%E8%BD%AC">【直观详解】让你永远忘不了的傅里叶变换解析</a>博文</p><h3 id="虚数单位为幂指数"><a href="#虚数单位为幂指数" class="headerlink" title="虚数单位为幂指数"></a>虚数单位为幂指数</h3><blockquote> <font color="red">这一小节的思路非常重要，不仅仅对理解黎曼猜想有帮助，对信号分析，傅里叶变换等也非常有帮助</font></blockquote><p>$2^x$ ，这个 $x$ 就是<strong>幂指数</strong>，$2^i$ 即虚数单位为幂指数</p><p>第二个问题，我们可以把 $\left(\cfrac{1}{2}\right)^{2+i}$ <strong>拆开</strong>写成 $\left(\cfrac{1}{2}\right)^{2}× \left(\cfrac{1}{2}\right)^{i}$ ，前面一半很好理解，关键是后面一半怎么理解</p><p>这里涉及到一个<strong>非常基础并且十分重要</strong>的理念：<font color="red"><strong>复平面中，纵轴（虚数部分）的幂指数函数的映射关系代表的是旋转</strong></font>。一下子不懂没关系，下面有通过两幅动图来帮助理解，如果还是有疑惑并且十分想了解，参看博文<a href="https://charlesliuyx.github.io/2018/02/18/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E8%AE%A9%E4%BD%A0%E6%B0%B8%E8%BF%9C%E5%BF%98%E4%B8%8D%E4%BA%86%E7%9A%84%E5%82%85%E9%87%8C%E5%8F%B6%E5%8F%98%E6%8D%A2%E8%A7%A3%E6%9E%90/#%E5%A4%8D%E5%B9%B3%E9%9D%A2-Complex-Plane">复平面和旋转</a></p><p>首先，下面这副动图表示，假设我们把指数 $i$ 前加一个自变量 $t$ ，就构造了一个函数 $f(t) = \left(\cfrac{1}{2}\right)^{ti}$ ，可以看到左边的<strong>黄色点在纵轴（虚轴）上移动</strong>，表示的就是引入一个自变量</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/5-complex.gif" alt="" width="500"></div><p>接着，我们把左边的输入带入 $f(t)$ 得到右边的<strong>output像空间</strong>，即 $\left(\cfrac{1}{2}\right)^{ti}$ 的值。会有下面一副动图<strong>所示的对应关系（移动黄色点，粉色点作为输出联动）</strong>。如果改变底数 $\cfrac{1}{2}$ ➜ $\cfrac{1}{9}$ ，左边黄点移动的时候，右边粉点的<strong>旋转速度变快</strong>，这就是幂指数函数在复数域上的<strong>映射规律</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/6-complex.gif" alt="" width="500"></div><p>总结一下，以上<strong>对两个问题</strong>的阐述是为了建立一个直观概念：<strong>幂指数是虚数单位的乘法</strong>对应了<strong>复平面内的旋转</strong>，接下来一张动图就来看看 $\left( \cfrac{1}{2} \right) ^{2+i}$ 是怎么算的：（关注红色线段，即最后的结果）</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/7-complex.gif" alt="" width="500"></div><p>① 实部把点收缩到 $\cfrac{1}{4}$ 的位置 </p><p>② $\left( \cfrac{1}{2}\right)^i$ 不改变长度（因为是虚部），只<strong>旋转一个对应的角度</strong></p><h2 id="⭐️一步一步可视化"><a href="#⭐️一步一步可视化" class="headerlink" title="⭐️一步一步可视化"></a>⭐️一步一步可视化</h2><h3 id="进行旋转"><a href="#进行旋转" class="headerlink" title="进行旋转"></a>进行旋转</h3><p>下面这副动图<strong>非常重要</strong>！先把实部部分加起来，再对每一项还需要乘一个 $(\cfrac{1}{2})^i$ ，<b><font color="red">也就是每一个线段都需要进行一个同样角度的旋转</font></b></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/8-cotrans.gif" alt="" width="650"></div><p>这副动图可以多看几遍，应该是挺好理解的。这里有个很细节的问题：<strong>第一段线段没动，是不是意味着没有进行旋转呢？</strong>，对应相乘的部分是 $1^i$ ，这可能意味着这个旋转恰好是<strong>转过了一圈</strong>（时间有限，未能求证，大概率是这样理解）</p><p>接下来的动图展示了在 $s$ <strong>变化</strong>的过程中，<strong>对应的螺旋线的变化情况</strong>，这幅动图看的有点上瘾</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/9-cotrans.gif" alt="" width="600"></div><p>考虑定义域的话，实数部分要能收敛：即在<strong>下图右侧黄色高亮区域</strong>， $s$ 的实部<strong>大于1</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/define.png" alt="" width="600"></div><h3 id="变换黎曼-zeta-函数"><a href="#变换黎曼-zeta-函数" class="headerlink" title="变换黎曼$\zeta$函数"></a>变换黎曼$\zeta$函数</h3><p>理解这个复函数一个好方法是通过<strong>变换来将其可视化</strong>，即将复函数看作<strong>变换</strong>，为了加深理解，在变换黎曼$\zeta$函数前，先<strong>变换</strong>一个比较简单的函数<br>$$<br>f(s) = s^2<br>$$<br>按照下面的动图，带入 $2$ 得到 $4$ ，带入 $-1$ 得到 $1$ ，带入 $1i$ 得到 $-1$ </p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/10-map.gif" alt="" width="500"></div><p>最后把所有的网格都<strong>标记彩色</strong>，下一幅动图同时变换网格上所有的点，形成<strong>新的网格</strong>：</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/11-mapall.gif" alt="" width="550"></div><p>同时观察所有点的变换比较吃力，你可以尝试在<strong>看的时候关注一个点的变化过程</strong>，比如关注 $(-1, 0)$ 这一点：它逆时针旋转了180° 。这副动图给了我们<strong>丰富的信息</strong>来直观的展现<code>复函数变化到底做了什么</code></p><p>同理，可视化黎曼$\zeta$函数，如下列动图所示</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/12-RiemannMap.gif" alt="" width="600"></div><p>如果这么<strong>漂亮的图像</strong>都完全无法激起你继续<strong>钻研复分析</strong>的兴趣，那么……</p><h2 id="难受的停顿"><a href="#难受的停顿" class="headerlink" title="难受的停顿"></a>难受的停顿</h2><p>你可能已经发现了，变换的图像左边有一个<strong>十分突兀的切面</strong>，停顿的很不自然，整个图像一场明显的表露除了一种希望冲破定义域的渴望</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/stop.png" alt="" width="800"></div><p>那么，我们<strong>专门高亮</strong>两条线：虚部等于 $i$ 和 $-i$ 的两条横线，然后进行变换。难道你没有<strong>冲动去补全它</strong>吗？ </p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/13-stop.gif" alt="" width="400"></div><h2 id="解析延拓"><a href="#解析延拓" class="headerlink" title="解析延拓"></a>解析延拓</h2><p>可以去想象，在 $Re(s)=1$ 的左半边，有一个<strong>改良版的函数（即下图蓝紫色的函数）</strong>，可以完美的<strong>补全整个空间</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/all_0.png" alt="" width="1000"></div><p> 用数学的形式来表示的话，问题就变成了，在<strong>左边一半的定义域</strong>内，<strong>这个函数是什么</strong>的问题，如下图（Re表示实部）</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/formula.png" alt="" width="500"></div><p>此时，我们就可以可视化出开篇提到的那个表达式 $\zeta(-1) = 1 + 2 + 3 + \cdots = - \cfrac{1}{12}$ ，你现在知道这个公式怎么来的了，因为钻了定义域不同函数形式不同的空子，其实上面这个式子的论断是<strong>很荒谬的</strong></p><p>新的问题又出来了，补全的部分，如果<strong>没有条件限制</strong>，随便怎么画都行，补全这条路难道走不通?</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/14-1to12.gif" alt="" width="600"></div><p>真的是这样吗？并不是，黎曼$\zeta$函数自带一个限制（约束）条件：<font color="red">函数是<strong>解析函数</strong>，补全部分形式<strong>处处可导</strong></font></p><p>这里有一个<strong>更加优雅的方法</strong>来理解<strong>处处可导（解析）</strong>这个条件</p><p>我们先来看 $f(s) = s^2$ ，它的导数形式是 $f’(s) = 2s$ ，在可视化部分来看，<strong>处处可导</strong>等价于变换后<strong>任意两条线段的夹角不变</strong>，又称保角（保证交角不变）特性，参看下图</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/15-angle.gif" alt="" width="500"></div><p>这个规律在所有网格线中都成立，所以，解析的 = 保持交角不变，即可以把<strong>解析的</strong>理解成<strong>保角的</strong>。如果你是一个追根究底的人，就能发现其实还是有例外的，比如<strong>在原点的交角</strong>变换后呈<strong>整数倍的关系</strong>，没有保角特性</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/angle.png" alt="" width="700"></div><p>下面给一副<strong>平移</strong>的动图，<strong>解析函数处处保角</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/16-move.gif" alt="" width="700"></div><p>黎曼$\zeta$函数就是一个保角函数，或说解析函数，网格出处垂直，处处可导</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/angle_2.png" alt="" width="500"></div><p>因为黎曼$\zeta$函数是一个解析函数，那么要想<strong>在左定义域延拓</strong>，又要满足解析的性质，有且仅有一种延拓方法，这也是<code>解析延拓</code>的含义</p><h2 id="可视化黎曼-zeta-函数总结"><a href="#可视化黎曼-zeta-函数总结" class="headerlink" title="可视化黎曼$\zeta$函数总结"></a>可视化黎曼$\zeta$函数总结</h2><p>按照<strong>解析延拓的方式进行了补全操作</strong>后，我们就走完了黎曼$\zeta$函数的可视化过程了，总结一下逻辑链</p><font color="blue">右定义域内假设自变量为复数，扩展到复数域 ➜ 进行变换，获得复数域可视化形态 ➜ 左定义域内无意义，进行<strong>解析延拓</strong></font><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/17-zeta-compress.gif" alt="" width="800"></div><p>另，这里补充<strong>左半边延拓的解析形式</strong>，数学家们已经给出了解<br>$$<br>\zeta(s) = 2^s{\pi}^{s-1}\sin(\frac{\pi s}{2})\Gamma(1-s)\zeta(1-s)<br>$$</p><h1 id="素数规律和黎曼猜想"><a href="#素数规律和黎曼猜想" class="headerlink" title="素数规律和黎曼猜想"></a>素数规律和黎曼猜想</h1><h2 id="再看黎曼猜想"><a href="#再看黎曼猜想" class="headerlink" title="再看黎曼猜想"></a>再看黎曼猜想</h2><p>在有了上述的<strong>直观理解</strong>后，我们再反回来看看黎曼猜想</p><p>有了<strong>变换的思维</strong>后，那么在这个变化后哪些点会<strong>落在原点</strong>呢？这个问题非常关键，因为它和求黎曼$\zeta$函数的零点等价</p><p>首先，所有满足 $Re(s) = -2n$ 的点都会落在原点，这些点被称为<code>平凡零点</code>（根据数学家的传统，他们太容易被发现了，太好理解了，所以被称为“平凡”）</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/18-zero.gif" alt="" width="700"></div><p>那么<strong>非平凡零点</strong>呢？我们已知所有的非平凡零点都落在下图的这个<strong>临界带（Critical Strip）</strong>中。至于原因，如果再仔细看一下这个复数域可视化变换所有点<strong>移动的趋势</strong>，大概就知道为什么这么说了，简单来说，是复分析变换计算出来的结果</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/CriticalStrip.png" alt="" width="600"></div><p>更加令人不可思议的是，<font color="red">这些非平凡零点的具体分布，蕴含着<strong>有关素数</strong>的海量信息</font>。至于为什么有<strong>素数的海量信息</strong>，之后会写<a href="">一篇博文</a>讲讲这其中的奥妙（3B1B的另一个视频的总结笔记）</p><p>黎曼猜想就是在说：这些<strong>非平凡零点</strong>，都在实部 $Re(s)=\cfrac{1}{2}$ 的这条<strong>临界线（Critical Line）</strong>上，如下图所示。如果它成立，那么它能让我们深刻理解<strong>素数分布的规律</strong>，根据最新进展中和其他证明，这个规律应该<strong>符合某种分布</strong>的均匀分布</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/CriticalLine.png" alt="黎曼猜想" width="600"></div><p>假设在<strong>变换过程中高亮</strong> $Re(s)=\cfrac{1}{2}$ 这条线，以我们可以看到的可视化区域（就是动图中前面跳动的一下的部分）的<strong>变换过程</strong>如下图所示，貌似它并没有过零点？</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/19-critical.gif" alt="" width="550"></div><p>其实不然，这个动图只绘出了<strong>可视区域内的线段的变换结果</strong>，如果我们把这个<strong>线段加长</strong>（不理解可以参考上面的动图，黄色就是可视化时候原图像的线），就得到了下面一个动图了</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/20-critical.gif" alt="" width="600"></div><p>其中，如果你能证明所有的<strong>非平凡零点</strong>都在这条临界线上（也就是原命题中的 $\cfrac{1}{2}$），那黎曼猜想变成黎曼定理！同时你也<strong>证明了成百上千的现代数学结论</strong>，当然，还有100万美元的奖金</p><p>有趣的是，现在很多现代数学理论的证明，不管<strong>黎曼猜想是正确还是不正确</strong>都能被证明是正确的。看到一个叫做littlewood定理的证明就是这样，可算是数学奇妙的冰山一角了</p><h2 id="素数规律"><a href="#素数规律" class="headerlink" title="素数规律"></a>素数规律</h2><p>之前提及黎曼猜想中<strong>蕴含着海量的素数信息</strong>。并在开篇有说到，1900年希尔伯特的23大难题中，<a href="https://zh.wikipedia.org/wiki/%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">黎曼猜想</a>、<a href="https://zh.wikipedia.org/wiki/%E5%93%A5%E5%BE%B7%E5%B7%B4%E8%B5%AB%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">哥德巴赫猜想</a>和<a href="https://zh.wikipedia.org/wiki/%E5%AD%AA%E7%94%9F%E7%B4%A0%E6%95%B0%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">孪生素数猜想</a>同为第8题，寻找素数（分解质因数后只有1和他本身的数），素数分布的规律，质因数分解，还有复分析之间一定是有千丝万缕的联系的</p><p>建议大家可以观看李永乐老师的<a href="https://www.youtube.com/watch?v=4vbcC4TcMGc" target="_blank" rel="noopener">黎曼猜想第二期视频</a>，将素数规律讲的非常好，我这里就当好学生，做一些笔记</p><h3 id="素数个数"><a href="#素数个数" class="headerlink" title="素数个数"></a>素数个数</h3><p>素数到底有多少个呢？这个问题已经被确定回答了，答案是<strong>有无穷多个</strong>。那是谁证明的呢？由<a href="https://zh.wikipedia.org/wiki/%E6%AC%A7%E5%87%A0%E9%87%8C%E5%BE%97" target="_blank" rel="noopener">欧几里得</a>（他是公元前300年的人）证明，使用的是反证法，怎么说的呢？</p><p>设质数的个数是有限的，那么就有一个最大的自然数 $p$，可以写成一个素数序列： $2,3,5,\cdots,p$，令<br>$$<br>q = 2×3×5×\cdots × p + 1 \tag 1<br>$$<br>① 假设 $q$ 是质数 ➜ $q\gt p$ 这和 $p$ 是最大的质数这个假设矛盾</p><p>② 假设 $q$ 是合数（不是质数的数） ➜ $q$ 是有约数的，<strong>不是1</strong>也不是<strong>它本身</strong> ➜ 那就一定是(1)式中 $2×3×5×\cdots × p$ 中的某一个，但是由（1）式可得，$q$ 除以$2×3×5×\cdots × p$ 中任何一个数<strong>都余1</strong> ➜ 所以<strong>肯定不能整除</strong>，<strong>与假设 $q$ 是合数矛盾</strong> </p><p>证毕。这个证明简洁而优雅，数学之美牛皮</p><h3 id="欧拉乘积公式"><a href="#欧拉乘积公式" class="headerlink" title="欧拉乘积公式"></a>欧拉乘积公式</h3><p>神人<a href="https://zh.wikipedia.org/wiki/%E8%90%8A%E6%98%82%E5%93%88%E5%BE%B7%C2%B7%E6%AD%90%E6%8B%89" target="_blank" rel="noopener">欧拉</a>（1707-1783）出现，推导出了<a href="https://zh.wikipedia.org/wiki/%E6%AC%A7%E6%8B%89%E4%B9%98%E7%A7%AF" target="_blank" rel="noopener">欧拉乘积公式</a>，怎么个说法呢？ </p><p>假设 $p$ 表示<strong>全体素数</strong>，有下面一个公式成立<br>$$<br>\prod\limits_{p} (1-p^{-s})^{-1} = \frac{1}{1-\cfrac{1}{2^s}}×\frac{1}{1-\cfrac{1}{3^s}}×\frac{1}{1-\cfrac{1}{5^s}}×\cdots = \cfrac{1}{1^s}+\cfrac{1}{2^s}+\cfrac{1}{3^s}+\cdots<br>$$</p><p>那这个公式有什么用呢？它告诉我们，<strong>黎曼函数和质数之间有隐含的关系</strong>。左边是和所有质数有关的项的乘积，右边是黎曼$\zeta$函数</p><h3 id="素数定理"><a href="#素数定理" class="headerlink" title="素数定理"></a>素数定理</h3><p>假设有这么一个表达式 <strong>$\pi(x)$ 表示小于 $x$ 素数的个数</strong>，有这么一个规律，参见下图</p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/Prime_number_theorem_ratio_convergence.svg" alt="" width="500"></div><p>啥意思呢，横坐标就是自变量 $x$ 的取值，蓝色的线是 $\cfrac{\pi(x)}{\frac{x}{\ln(x)}}$ ，红色的线是  $\cfrac{\pi(x)}{\int_{2}^{x}\frac{1}{\ln t} dt}$ ，分母的 $\int_{2}^{x}\cfrac{1}{\ln t} dt$ 又被称成 $Li(x)$ </p><p>可以看到，当 $x \to +\infty $ ，这个 $\pi(x)$ 函数是可以写出表达式的</p><p>二号神人<a href="https://zh.wikipedia.org/zh-hans/%E5%8D%A1%E7%88%BE%C2%B7%E5%BC%97%E9%87%8C%E5%BE%B7%E9%87%8C%E5%B8%8C%C2%B7%E9%AB%98%E6%96%AF" target="_blank" rel="noopener">高斯</a>（1777-1855）研究了一下关于素数密度 $\rho$ 的问题，也就是<strong>1000个数里面，有多少个素数</strong>。对的，上面蓝线的规律是高斯<strong>最早发现</strong>，但当时高斯觉得这个发现貌似并不重要，就没有展开来研究。后来1798年<a href="https://zh.wikipedia.org/zh-hans/%E9%98%BF%E5%BE%B7%E9%87%8C%E5%AE%89-%E9%A9%AC%E9%87%8C%C2%B7%E5%8B%92%E8%AE%A9%E5%BE%B7" target="_blank" rel="noopener">勒让德</a>（1752-1833）发现了下面那个红色曲线的表达式，在学界有个涟漪，高斯在1849年就告诉勒让德，你这不行，是我先发现的啊，所以这公式被称为<code>高斯-勒让德公式</code><br>$$<br>\pi(x) \sim \frac{x}{\ln x} \iff \pi(x) = \int_{0}^{x} \frac{dt}{\ln t} + C<br>$$<br>$\sim$ 符号表示趋近于，也就是当 $x \to +\infty $ 的意思。 $C$ 是一个常数，这个常数随着 $x$ 的<strong>变大而越来越小</strong></p><p>再观察上面的图，明显发现<strong>红色的线收敛到1的速度更快</strong>，所以后面<a href="https://zh.wikipedia.org/wiki/%E6%B5%B7%E9%87%8C%E6%A0%BC%C2%B7%E9%A6%AE%C2%B7%E7%A7%91%E8%B5%AB" target="_blank" rel="noopener">科勒</a>（1870-1924）做了改进和提高。他说，<font color="red"><strong>如果黎曼猜想成立</strong></font>（写到这句话可是真不容易），那么这个关系误差式可更加精确，可<strong>大大改善素数定理误差的估计</strong><br>$$<br>\pi(x) = Li（x）+ O(\sqrt{x}\ln x)<br>$$<br>$O()$ 被称为<strong>渐进符号</strong>，一般用来描述<strong>无穷级数的余项</strong>。在<strong>计算和表示算法复杂度</strong>方面也很用，比如$O(n^2)$ 其实就是忽略 $n$ 一次项和常数项的意思。因为在 $n$ 非常大时， $n$ 一次项对数值的贡献在量级上远小于 $n^2$ 二次项。这个余项的常数项的具体数值还<strong>没有算出来</strong></p><p>之后50年，这个<strong>素数猜想</strong>被证明了出来，变成了<strong>素数定理</strong>。有趣的是，这份证明只是数学家<strong>研究黎曼猜想的边角料</strong></p><p>素数，自然底数，虚数单位 $i$ 之间一定是存在的<strong>一些难以名状的关联</strong>，现在看来，有没有可能是量子力学叠加态在数理逻辑推理中的一种巧合的具象模式呢？静待未来，让数学家们给我们一个答案吧。胡适先生说过：<font color="blue"><strong>哪管它真理无穷，进一寸有一寸的欢喜</strong></font>，切实能感同身受，可能就是这辈子最大的幸事之一了吧？</p><h1 id="后记和思考"><a href="#后记和思考" class="headerlink" title="后记和思考"></a>后记和思考</h1><p>就在写作这篇博文的过程中，<strong>爵士阿蒂亚的证明过程的手稿已经公布（有点存疑是草稿，原文里面竟然有错别字weakly ➜ weekly）</strong>，公开大会也已经结束，一张PPT证明黎曼猜想，有点诡异</p><p>但其中<strong>提及黎曼猜想和量子力学的关联</strong>给了我一些启发：<strong>素数和微观世界的规律一定有某种关联</strong>（在级数和等于 $\cfrac{\pi^2}{6}$ 部分的可视化解说里面就有很奇妙的规律关联）</p><p>无极生太极，<strong>其小无内，其大无外</strong>也，两面都是宇宙本源的运行规律，中华民族老祖宗《易经》已经有这种思维方法了，一面是<strong>精细结构常数</strong>，一面是<strong>引力常数</strong></p><p>参照弦理论，<strong>高维度空间坍缩在很小的尺度内</strong>。那能不能猜想，正因为微观世界和高维度<strong>尺度更接近</strong>，导致被影响的程度也不一样，<strong>引力才一直没有统一</strong>（而其他三个力的规律已经统一）。相对应的，大尺度上的规律因<strong>时间尺度的限制</strong>（宇宙的寿命），我们作为人类从观测角度上来说，尺度太小。如果等<strong>葛立恒数年后</strong>，引力部分也会有一个类似微观世界的规律被发现呢？</p><p>这篇文章提到引力常数 $g$ <strong>更加令人疑惑</strong>，是不是可能这个常数本身就是由两个量构成？大的那个符合微观规律，细调的那个因为观测受限（尺度太小）我们无法找到<strong>佐证的依据</strong>？现在人类追求佐证和实验，有没有可能这条路本身就是障碍？</p><p>最后还是希望<strong>直观详解这个系列</strong>能激起更多人的好奇心就心满意足了，附上一份目录</p><p><a href="https://mubu.com/doc/3nIWmLzEPl" target="_blank" rel="noopener">博客目录汇总（更新中）</a></p><p>【参考和来源】</p><p>所有动图来自：3B1B的视频<a href="https://www.bilibili.com/video/av8726217" target="_blank" rel="noopener">【官方双语】黎曼ζ函数与解析延拓的可视化</a><br><a href="https://www.youtube.com/watch?v=T93SayXhw2w" target="_blank" rel="noopener">李永乐老师1+2+3+4+…=-1/12？李永乐老师讲黎曼猜想（1）Youtube</a><br><a href="https://www.youtube.com/watch?v=4vbcC4TcMGc" target="_blank" rel="noopener">质数有多重要？数学家欧拉和高斯是如何研究质数的 ？李永乐老师讲黎曼猜想（2）</a><br><a href="https://zh.wikipedia.org/zh/%E9%BB%8E%E6%9B%BC%E7%8C%9C%E6%83%B3" target="_blank" rel="noopener">wiki百科黎曼猜想</a></p><p>最后，和3B1B视频一样，来个看完彩蛋：<strong>黎曼$\zeta$函数的导数的可视化动图</strong></p><div align="center"><img src="//charlesliuyx.github.io/2018/09/20/【直观详解】通俗易懂了解什么是黎曼猜想/21-deri.gif" alt="" width="700"></div>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】15min - 20min | 9000+字 | 23张动图 | 11张图片&lt;br&gt;【阅读内容】一文搞懂什么是&lt;strong&gt;黎曼猜想&lt;/strong&gt;。在复数域直观可视化黎曼$\zeta$函数（读作&lt;code&gt;/zita/&lt;/code&gt;），解释什么是&lt;strong&gt;解析延拓&lt;/strong&gt;（analytic continuation），探究黎曼猜想和素数的关系&lt;/p&gt;
    
    </summary>
    
      <category term="Math" scheme="https://charlesliuyx.github.io/categories/Math/"/>
    
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="Visualization" scheme="https://charlesliuyx.github.io/tags/Visualization/"/>
    
  </entry>
  
  <entry>
    <title>支持币与去中心化商业模式</title>
    <link href="https://charlesliuyx.github.io/2018/08/11/%E6%94%AF%E6%8C%81%E5%B8%81%E4%B8%8E%E5%8E%BB%E4%B8%AD%E5%BF%83%E5%8C%96%E5%95%86%E4%B8%9A%E6%A8%A1%E5%BC%8F/"/>
    <id>https://charlesliuyx.github.io/2018/08/11/支持币与去中心化商业模式/</id>
    <published>2018-08-11T05:23:07.000Z</published>
    <updated>2018-08-14T02:45:48.903Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】<br>【阅读内容】本文阐述了一种全新的支持币区中心话商业模式，以人为本，从人与人的关联出发，辅以各类动态平衡算法，构造一个基于互联网工具的知识经济系统</p><a id="more"></a><h1 id="结构化笔记软件：幕布"><a href="#结构化笔记软件：幕布" class="headerlink" title="结构化笔记软件：幕布"></a>结构化笔记软件：幕布</h1><div align="center"><img src="//charlesliuyx.github.io/2018/08/11/支持币与去中心化商业模式/mubu.png" alt="幕布Logo" width="400"></div><h2 id="介绍"><a href="#介绍" class="headerlink" title="介绍"></a>介绍</h2><h2 id="愿景"><a href="#愿景" class="headerlink" title="愿景"></a>愿景</h2><p><strong>提升信息承载物的表意维度，掀起结构化记录的清单革命</strong></p><h3 id="表意维度"><a href="#表意维度" class="headerlink" title="表意维度"></a>表意维度</h3><p>语言，文字，图片，音频，视频都是<strong>信息的载体</strong>。但语言和文字有一定局限性，具有<strong>认知方言特性</strong></p><p><code>【认知方言】有着不同认知的人在看待同一个表意词汇，句子，段落时可能理解出来的重点，含义是不同的</code></p><ul><li>苏格拉底一生未留下文字，他的著作都是由学生柏拉图等进行转述和记录。他认为写作是不可信的</li><li>孔子的学生子贡也说：“夫子之言性与天道，不可得而不闻也”。一些思维，一旦写成文字或多或少会产生一些误解和歧义</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】&lt;br&gt;【阅读内容】本文阐述了一种全新的支持币区中心话商业模式，以人为本，从人与人的关联出发，辅以各类动态平衡算法，构造一个基于互联网工具的知识经济系统&lt;/p&gt;
    
    </summary>
    
      <category term="MuBu" scheme="https://charlesliuyx.github.io/categories/MuBu/"/>
    
    
      <category term="MuBu" scheme="https://charlesliuyx.github.io/tags/MuBu/"/>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/tags/BlockChain/"/>
    
  </entry>
  
  <entry>
    <title>那些值得一看的TED演讲附全文文稿笔记</title>
    <link href="https://charlesliuyx.github.io/2018/06/20/%E9%82%A3%E4%BA%9B%E5%80%BC%E5%BE%97%E4%B8%80%E7%9C%8B%E7%9A%84TED%E6%BC%94%E8%AE%B2%E9%99%84%E5%85%A8%E6%96%87%E6%96%87%E7%A8%BF%E7%AC%94%E8%AE%B0/"/>
    <id>https://charlesliuyx.github.io/2018/06/20/那些值得一看的TED演讲附全文文稿笔记/</id>
    <published>2018-06-20T09:26:25.000Z</published>
    <updated>2018-06-21T01:35:17.764Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】现有12个TED演讲 | 持续更新 - 06/20<br>【阅读内容】这可能是<strong>有史以来干货最多的TED分享笔记安利文章</strong>，个人林林总总花费时间超过100小时。都是TED的干货笔记，并且有内容精炼，帮你筛选TED优质的演讲</p><a id="more"></a><h1 id="核心思路和愿景"><a href="#核心思路和愿景" class="headerlink" title="核心思路和愿景"></a>核心思路和愿景</h1><p>我为什么要做这个总结，并且分享？</p><h2 id="内容精炼"><a href="#内容精炼" class="headerlink" title="内容精炼"></a>内容精炼</h2><p>TED内容<strong>精炼推荐</strong>，给你<strong>有价值的内容</strong>，帮你<strong>省下选择的时间</strong>，我虽然并不能收钱，但是总结过程本身就是我学习的过程，何乐而不为，独乐乐不如众乐乐。</p><p>同时这也是对自己<strong>知识架构的健壮和拷问</strong>，在不断的学习和重复中，能把这些技巧和内容慢慢变成自己的洞见。不断的生产内容，是一种难得的锻炼</p><p>分享者才是最大的收获者！我一直笃信这一点</p><h2 id="知识数据库"><a href="#知识数据库" class="headerlink" title="知识数据库"></a>知识数据库</h2><p>TED内容再整理，方便查阅，方便检索，方便重复，最终能变成你知识体系的一部分</p><p>这个时代最重要的就是数据，这一些内容也是我个人生产的数据源头，我把它称之为【知识数据库】，只有不断的重复，才能接近智慧</p><h2 id="演讲才是精髓"><a href="#演讲才是精髓" class="headerlink" title="演讲才是精髓"></a>演讲才是精髓</h2><p>TED演讲，还是在演讲上，只有听，才能感受到它的价值：声音的艺术，交流的艺术，表达的艺术，新颖的观点和出色的内容都在演讲这个核心之后</p><h2 id="幕布是内容的良好承载物"><a href="#幕布是内容的良好承载物" class="headerlink" title="幕布是内容的良好承载物"></a>幕布是内容的良好承载物</h2><p>本篇文章非常适合用幕布的形式进行呈现，这里<a href="https://mubu.com/doc/2HQGx41A9l" target="_blank" rel="noopener">给出链接</a>，欢迎大家分享这个链接，并且最重要的也是这个链接，我强烈建议从这个链接去观看整篇文章（这篇博客更多的文案是为了我自己关于TED演讲推荐知乎回答做的准备）</p><p>作为幕布的开发者，布道幕布这种层次化梳理的表现知识承载形式，好的内容是有层次的，应该有更统一的，更直观的，更多维度的<strong>内容承载形式</strong>。也就是设计<a href="https://mubu.com/doc/1StIlju-zl" target="_blank" rel="noopener">幕布七哲学</a>的核心意义</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2018/06/20/那些值得一看的TED演讲附全文文稿笔记/7Ph.png" alt="幕布七哲学" title="">                </div>                <div class="image-caption">幕布七哲学</div>            </figure><h1 id="TED演讲推荐"><a href="#TED演讲推荐" class="headerlink" title="TED演讲推荐"></a>TED演讲推荐</h1><h2 id="【01】下一个科学界大突破是什么"><a href="#【01】下一个科学界大突破是什么" class="headerlink" title="【01】下一个科学界大突破是什么"></a>【01】下一个科学界大突破是什么</h2><ul><li>【体量】<ul><li>68主题 | 1440字 | 视频时长 10:51</li><li><a href="https://v.youku.com/v_show/id_XMTgyODQwMDM2NA==.html?spm=a2h0j.11185381.listitem_page1.5!51~A&amp;&amp;s=403e2d26137811e2b52a" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>以三个生物学界的发明和不断进步的故事为主线</li><li>围绕生命科学的技术突破给出了自己的观点</li><li><a href="https://mubu.com/doc/2LGkymz_vl" target="_blank" rel="noopener">文稿精华总结笔记</a></li></ul></li><li>【推荐点】<ul><li>演讲风格有魅力，用词精准漂亮</li><li>内容上三个故事都有趣味性，但观点上见仁见智</li></ul></li></ul><h2 id="【02】游戏奖励大脑的七种方式"><a href="#【02】游戏奖励大脑的七种方式" class="headerlink" title="【02】游戏奖励大脑的七种方式"></a>【02】游戏奖励大脑的七种方式</h2><ul><li>【体量】<ul><li>66 主题 | 1137 字 | 视频时长 16:02</li><li><a href="https://www.ted.com/talks/tom_chatfield_7_ways_games_reward_the_brain/transcript" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>总结游戏设计哲学，提到十分精练的7个原则：用进度条度量进程 | 长期与短期目标 | 奖励成就 | 清晰反馈 | 不确定因素 | 提升注意力窗口 | 好胜心</li><li><a href="https://mubu.com/doc/2yq58u45Kl" target="_blank" rel="noopener">文稿精华总结笔记</a></li></ul></li><li>【推荐点】<ul><li>用词十分漂亮，值得学习</li><li>观点很有借鉴意义，从游戏角度来看事物本来就是对人性的一种挖掘</li></ul></li></ul><h2 id="【03】未来这台电脑会帮你种菜"><a href="#【03】未来这台电脑会帮你种菜" class="headerlink" title="【03】未来这台电脑会帮你种菜"></a>【03】未来这台电脑会帮你种菜</h2><ul><li>【体量】<ul><li>67 主题 | 1322字 | 视频时长 15:56</li><li><a href="https://www.ted.com/talks/caleb_harper_this_computer_will_grow_your_food_in_the_future" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>全新的农业模式，建造数字农场来连接全世界的粮食产业，可以结合大数据互联网等，提高农业的种植效率，强烈推荐！</li><li><a href="https://mubu.com/doc/-gqF7_sOl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>非常有创造力的想法，不得不感叹，这世界有太多人在尝试去做一些伟大的任务，远远超出了我们想象</li><li>可以帮助你去了解未来世界的可能面貌</li></ul></li></ul><h2 id="【04】下一次工业革命就在眼前"><a href="#【04】下一次工业革命就在眼前" class="headerlink" title="【04】下一次工业革命就在眼前"></a>【04】下一次工业革命就在眼前</h2><ul><li>【体量】<ul><li>51主题 | 812字 | 视频时长 12:27</li><li><a href="https://www.ted.com/talks/olivier_scalabre_the_next_manufacturing_revolution_is_here" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>下一次工业革命的基本特征进行的阐述，观点角度简练新颖</li><li><a href="https://mubu.com/doc/39L6KUi7Al" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>对整体工业化未来高科技领域有兴趣的读者可以关注</li><li>观点简介明了，有启发意义</li></ul></li></ul><h2 id="【05】人工智能将如何推动第二次工业革命"><a href="#【05】人工智能将如何推动第二次工业革命" class="headerlink" title="【05】人工智能将如何推动第二次工业革命"></a>【05】人工智能将如何推动第二次工业革命</h2><ul><li>【体量】<ul><li>142主题 | 4412字 | 视频时长13:44</li><li><a href="https://www.ted.com/talks/kevin_kelly_how_ai_can_bring_on_a_second_industrial_revolution" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>凯文凯利就《失控》《必然》几本书种的几个主要观点进行了阐释</li><li>主要说明这是一个变革的时代，我们有三点认知需要认清：到底什么是智能 | AI会推动第二次工业革命 | 我们要和AI协作，不是对抗</li><li><a href="https://mubu.com/doc/2KUxHG9PXo" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>无论是演讲技术，还是文案，都十分引人深思</li><li>从头到尾到泛着大道至简的简约美感，<strong>强烈推荐</strong>！</li></ul></li></ul><h2 id="【06】区块链将如何改变金钱与贸易"><a href="#【06】区块链将如何改变金钱与贸易" class="headerlink" title="【06】区块链将如何改变金钱与贸易"></a>【06】区块链将如何改变金钱与贸易</h2><p>因为整理者是区块链行业者所以只有简单的笔记</p><ul><li>【体量】<ul><li>23主题 | 241字 | 视频时长 18:49</li><li><a href="https://www.ted.com/talks/don_tapscott_how_the_blockchain_is_changing_money_and_business?language=zh-CN" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>什么是区块链，区块链有什么应用，区块链的价值在何处</li><li><a href="https://mubu.com/doc/2xGmBnzZOl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>关于区块链的内容非常丰富，适合不太了解区块链并想要被布道的人</li><li>例子通俗易懂，能让人对区块链有一个自己的主观认识</li></ul></li></ul><h2 id="【07】怎样说话人们才会听"><a href="#【07】怎样说话人们才会听" class="headerlink" title="【07】怎样说话人们才会听"></a>【07】怎样说话人们才会听</h2><ul><li>【体量】<ul><li>79主题 | 1603字 | 视频时长 9:55</li><li><a href="https://www.ted.com/talks/julian_treasure_how_to_speak_so_that_people_want_to_listen" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>有关如何说话，总结说话七宗罪：流言蜚语 | 评判 | 消极 | 抱怨 | 借口 | 说谎 | 固执己见</li><li>四个说话的正面HAIL：诚实 | 真实 | 正气 | 爱</li><li>还有6个用来增强说话力量的工具，音域 | 音色 | 韵律 | 语速 | 音调 | 音量</li><li><a href="https://mubu.com/doc/2BpajgesWl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>演讲教科书，声音运用自如，语言精炼，用词精彩，<strong>强烈推荐！</strong></li><li>TED观看排名第六（2800万+）</li></ul></li></ul><h2 id="【08】如何成为一个更好的交谈者"><a href="#【08】如何成为一个更好的交谈者" class="headerlink" title="【08】如何成为一个更好的交谈者"></a>【08】如何成为一个更好的交谈者</h2><ul><li>【体量】<ul><li>136主题 | 5664字 | 视频时长 11:44</li><li><a href="https://www.ted.com/talks/celeste_headlee_10_ways_to_have_a_better_conversation/transcript#t-11346" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>总结了十条成为更好交谈者的要点：不要三心二意 | 不要好为人师 | 使用开放式问题 | 顺其自然 | 不知道就是不知道 | 不要以己度人 | 尽量别重复 | 少说废话 | 认真倾听 | 简明扼要</li><li><a href="https://mubu.com/doc/3Iayl8KUIl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>演讲技巧和文稿结构同样值得推荐，整个论证过程严丝合缝，举例子 + PPT整合，是一场教学式演讲</li><li>TED观看人数排名靠前的演讲，<strong>强烈推荐！</strong></li></ul></li></ul><h2 id="【09】学校扼杀创造力"><a href="#【09】学校扼杀创造力" class="headerlink" title="【09】学校扼杀创造力"></a>【09】学校扼杀创造力</h2><ul><li>【体量】<ul><li>151主题 | 8656字 | 视频时长 19:22</li><li><a href="https://www.ted.com/talks/ken_robinson_says_schools_kill_creativity/transcript?language=zh-cn" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>对学校教育进行了深刻的思考，培养人才需要：多样化 | 充满活力 | 个性化，对现有的体系进行了深刻的批判</li><li><a href="https://mubu.com/doc/1-YWnPPL5l" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>TED观看人数排名第一的演讲（5000万+），<strong>强烈推荐！</strong></li><li>整个演讲过程十分风趣幽默，充满了西方式幽默哲学</li></ul></li></ul><h2 id="【10】为什么好的领导者会让你感到安全"><a href="#【10】为什么好的领导者会让你感到安全" class="headerlink" title="【10】为什么好的领导者会让你感到安全"></a>【10】为什么好的领导者会让你感到安全</h2><ul><li>【体量】<ul><li>139主题 | 5408字 | 视频时长 11:56</li><li><a href="https://www.ted.com/talks/simon_sinek_why_good_leaders_make_you_feel_safe" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>内容也充实，例子有力量，主要提及了如何才能提升领导力</li><li>归纳来说，还是同理心和自身强大的毅力和美好品，承担困难的超强能力</li><li><a href="https://mubu.com/doc/1dmNEGX3wl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>展现了精湛的语言发声艺术和演讲技巧，煽动性相当强</li><li>举例子虽然不新颖，但是整体表达的方式值得学习</li></ul></li></ul><h2 id="【11】姿势决定你是谁-Amy-Cuddy"><a href="#【11】姿势决定你是谁-Amy-Cuddy" class="headerlink" title="【11】姿势决定你是谁 - Amy Cuddy"></a>【11】姿势决定你是谁 - Amy Cuddy</h2><ul><li>【体量】<ul><li>134主题 | 7205字 | 视频时长 21:56</li><li><a href="https://www.ted.com/talks/amy_cuddy_your_body_language_shapes_who_you_are" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li><a href="https://mubu.com/doc/1uadnM_vhl" target="_blank" rel="noopener">文稿内容总结笔记</a></li><li>演讲中提到了姿势了力量，个人实践表示，是100%有效果的</li><li>更高层次的说也就是转念的力量，是一种心理学暗示。只是通过了姿势这种对激素分泌有影响的具象形式表示出来，相信其实更加重要</li></ul></li><li>【推荐点】<ul><li>TED排名第二观看的演讲（4700万+），<strong>强烈推荐！</strong></li><li>虽然在中段稍显结构松散，但是这个演讲最厉害的是<strong>真诚和打动人的能力</strong>，让您感受到被震撼的力量，内容本身放佛已经不再那么重要，一次演讲能做到<strong>让人心潮澎湃</strong>，当真厉害！</li></ul></li></ul><h2 id="【12】伟大的领袖如何激励行动"><a href="#【12】伟大的领袖如何激励行动" class="headerlink" title="【12】伟大的领袖如何激励行动"></a>【12】伟大的领袖如何激励行动</h2><ul><li>【体量】<ul><li>207主题 | 8909字 | 视频时长 17:58</li><li><a href="https://www.ted.com/talks/simon_sinek_how_great_leaders_inspire_action/transcript#t-39168" target="_blank" rel="noopener">视频链接</a></li></ul></li><li>【内容】<ul><li>黄金圈法则的出处（Why How What 思考模式），虽然视频古老，但是内容实沉</li><li><a href="https://mubu.com/doc/1HINxSerCl" target="_blank" rel="noopener">文稿内容总结笔记</a></li></ul></li><li>【推荐点】<ul><li>TED观看数量第三的演讲（3900万+），强烈推荐！</li><li>演讲技巧也十分有煽动性，节奏清晰</li><li>观点上有超强的启发意义和智慧系统贯通的满足感，因为道法自然，说道深处，很多方法论都是相同的，无论是西方还是东方的，都是如此</li></ul></li></ul>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】现有12个TED演讲 | 持续更新 - 06/20&lt;br&gt;【阅读内容】这可能是&lt;strong&gt;有史以来干货最多的TED分享笔记安利文章&lt;/strong&gt;，个人林林总总花费时间超过100小时。都是TED的干货笔记，并且有内容精炼，帮你筛选TED优质的演讲&lt;/p&gt;
    
    </summary>
    
      <category term="Article" scheme="https://charlesliuyx.github.io/categories/Article/"/>
    
    
      <category term="Note" scheme="https://charlesliuyx.github.io/tags/Note/"/>
    
      <category term="TEDTalk" scheme="https://charlesliuyx.github.io/tags/TEDTalk/"/>
    
  </entry>
  
  <entry>
    <title>【区块链】共识算法与如何解决拜占庭将军问题</title>
    <link href="https://charlesliuyx.github.io/2018/03/03/%E3%80%90%E5%8C%BA%E5%9D%97%E9%93%BE%E3%80%91%E5%A6%82%E4%BD%95%E8%A7%A3%E5%86%B3%E6%8B%9C%E5%8D%A0%E5%BA%AD%E5%B0%86%E5%86%9B%E9%97%AE%E9%A2%98/"/>
    <id>https://charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/</id>
    <published>2018-03-03T06:17:06.000Z</published>
    <updated>2018-06-17T22:17:20.514Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】10min 3183 words<br>【阅读内容】什么是拜占庭问题，以及它和区块链的关系，现代区块链技术中<strong>常见的共识算法</strong>总结</p><a id="more"></a><p>首先，这个问题属于<strong>计算机科学领域</strong>。解决这个问题才是区块链最大的价值所在，因为这个问题一直是<strong>分布式系统</strong>的重要难题之一</p><h1 id="什么是拜占庭将军问题"><a href="#什么是拜占庭将军问题" class="headerlink" title="什么是拜占庭将军问题"></a>什么是拜占庭将军问题</h1><p>这个问题的定义者是<strong>图灵奖</strong>获得者，Lamport大神，分布式系统的关键性奠基人之一。有面包店算法，拜占庭将军问题，Paxos算法等著名成果</p><h2 id="问题描述"><a href="#问题描述" class="headerlink" title="问题描述"></a>问题描述</h2><div align="center"><img src="//charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/BG1.png" alt="" width="400"></div><p><code>9个将军</code>带领<code>9支军队</code>，打一场攻城战役。假设每个将军都能<strong>独立</strong>根据眼前战况做出两种判断：<strong>进攻</strong>或<strong>撤退</strong>，要求（或者最终目的是）如何让这9个将军的<strong>命令</strong>是<strong>一致的</strong>（一致性，即共识）？要么一起进攻，要么一起撤退（每个将军之间也是互不信任的，也有消灭对方的动机）</p><p>最简单的策略即：<strong>投票</strong>（上图中的红色箭头和绿色箭头为每个将军做出的判断），<strong>超过半数支持</strong>某个决定，那么<strong>所有9个将军</strong>一定执行<strong>这个决定</strong>。如上图，5个将军决定进攻，4个将军决定撤退，那么所有将军都会下令：进攻！</p><p>这种策略需要每个将军把<strong>自己的判断</strong>通过一种途径（途中灰色箭头）传递到所有其他将军处。相对的，每个将军只有在收到了所有投票结果后，才会下令。如上面的例子，所有将军得到投票：<strong>4进攻5撤退</strong>，才下令<strong>撤退</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/BGP.png" alt="" width="400"></div></p><p>这个<strong>投票策略</strong>的最大问题：假设出现了<strong>叛徒</strong>，如上图所示，会出现两种情况</p><ul><li>【1】对自己位置的战场情况进行错误广播（比如他这个地方优势很大，但是投票给撤退）</li><li>【2】可以选择靠给不同的将军送去不同的消息<strong>破坏整体决定的一致性</strong>（导致左边四个将军选择撤退，右边四个将军选择进攻）</li></ul><h2 id="问题总结"><a href="#问题总结" class="headerlink" title="问题总结"></a>问题总结</h2><p>此时总结一下，拜占庭问题的问题<strong>到底是什么</strong>：</p><ul><li>所有将军<strong>如何</strong>才能<strong>达成共识</strong>去攻打（或撤退）城堡</li></ul><p>根据相关的研究，得出一个【一般性的结论】：<strong>如果叛徒的数量大于或等于三分之一 ，那么拜占庭问题不可解</strong>，这个三分之一也被称为<strong>拜占庭容错</strong>，三模冗余是完全无法容错的（也就是说无解，不可能保持一致性）</p><p>解释方法使用<strong>副官模型</strong>即可</p><p>推广到计算机系统内，【将军】类比为【计算机】，而计算机因为物理或被感染等其他原因造成的【运行异常】就是【叛徒】，其实整个问题也是为了保证分布式系统的<strong>一致性</strong>和<strong>可用性</strong></p><h1 id="传统解决方案"><a href="#传统解决方案" class="headerlink" title="传统解决方案"></a>传统解决方案</h1><p>在区块链之前，有两种解决方案：<strong>口头协议</strong>（又称为拜占庭容错算法）和<strong>书面协议</strong></p><p>通常来说，大多数分布式系统使用的是书面协议确保一致性，中心机构背书。其中有实用拜占庭容错算法（PBFT）最为有名</p><h2 id="PBFT概述"><a href="#PBFT概述" class="headerlink" title="PBFT概述"></a>PBFT概述</h2><p>这个算法说起来也不难理解，他的核心思想是：<strong>对于每一个收到命令的将军，都要去询问其他人，他们收到的命令是什么</strong>。也就是说利用不断的信息交换<strong>让可行的节点确认哪一个记录选择是正确的，即发现其中的背叛者</strong></p><p>采用PBFT方法，本质上就是<strong>利用通信次数换取信用</strong>。每个命令的执行都需要节点间两两交互去核验消息，通信代价是非常高的。通常采用PBFT算法，节点间的通信复杂度是节点数的平方级的</p><h2 id="白话PBFT"><a href="#白话PBFT" class="headerlink" title="白话PBFT"></a>白话PBFT</h2><p>还是用上面的将军的例子来举例，但为了方便我们把问题的定义稍作修改</p><p>【问题定义】总共4个将军，有1个是叛徒，每个将军需要在自己的战斗计划中添加一行内容 <code>&lt;什么时间&gt;进攻</code></p><p>【目标】只需要3个将军达成一致在<strong>同一时间</strong>进攻，就可以<strong>攻占城市</strong>，否则<strong>进攻者全军覆没</strong>。最终目标还是<strong>统一一个一致的战斗计划，并按照计划同时实施</strong>（在去中心化系统中，即【记录】的一致性）</p><p>【方法】对于每一个收到命令的将军，都要去询问其他人，他们收到的命令是什么。在判断不出判断者的情况，执行更多的那个命令</p><p>【可视化直观】</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/PBFT.png" alt="" width="1000"></div></p><p>其中每个将军投降下方的数字就是收到的攻击事件列表，在该规则下，可以看到能保证，当叛徒数量小于1/3维护系统的一致性，即无论是什么情况，都可以<strong>防止不一致的决定被执行</strong>（至少也是按兵不动，并且很容易定位叛徒是谁）</p><p>注意，在这种仅有4个节点的情况下看似复用信道和传递消息的数量不多。但随着结点的增加，时间复杂度和信道使用量级是<strong>节点数的平方</strong>。大规模网络基本瘫痪，效率太低</p><h1 id="区块链解决方案"><a href="#区块链解决方案" class="headerlink" title="区块链解决方案"></a>区块链解决方案</h1><p>我们知道，区块链最强的地方就在于它的一致性（了解区块链原理，可移步另一篇博客 <a href="https://charlesliuyx.github.io/2017/09/24/%E4%B8%80%E6%96%87%E5%BC%84%E6%87%82%E5%8C%BA%E5%9D%97%E9%93%BE-%E4%BB%A5%E6%AF%94%E7%89%B9%E5%B8%81%E4%B8%BA%E4%BE%8B/">一文看懂区块链：一步一步发明比特币</a>），同时这正是拜占庭问题的核心</p><h2 id="案例拆解"><a href="#案例拆解" class="headerlink" title="案例拆解"></a>案例拆解</h2><p>我们先假设你已经完全了解了比特币区块链的运行原理，那么我们一步一步<strong>建立一个场景</strong>看一看区块链是如何解决拜占庭将军问题？</p><p>我们先假设信道一定是可靠的，传令兵死亡之类的事情我们不考虑，毕竟在一个非常复杂的网络中，还可以通过多条的方式连接任意两个节点，可靠性还是值得相信。<strong>主要破坏一致性的还是心怀不轨的【间谍】</strong>，或者总结为：如何防止【间谍】对整体决策（进攻还是撤退）进行破坏？</p><p>我们按照区块链模型构造一个下图所示的系统</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/BlockChain.png" alt="" width="400"></div></p><p>每个将军本地都存储一份【记录】：记录所有将军的决定，比如“1：1”代表1号将军决定进攻</p><p>然后构造以下协议内容：</p><ul><li>使用数字签名保证身份可可信</li><li>所有将军<strong>参与挖矿</strong>，国王以保证战役胜利为缘由，出资，奖励每一个挖到新区块俩的将军</li><li>每一个将军当本地维护的<strong>最新确认【记录】</strong>中包含了所有1-9号将军的决定后，<strong>正式做出自己的决定</strong></li></ul><p>在这个案例中，抛弃了代币的设定，因为不存在交易行为，而是由国王出资（保证战争不被间谍影响，我认为国王应该愿意出这笔钱）。在拜占庭时期，因为没有网络，构造上述这样的系统，是完全不可能的。而现在网络链路速度，效率越来越高，让区块链解决一致性问题得以解决</p><p>这里就引出了现在区块链的核心问题：应用场景与代价博弈。你要解决的痛点，到底值不值得这样的花费呢？无论是算力消耗，还是资源消耗，亦或是类似于上述案例中的国王出资（区块链代币价值为负数？），都是一种【代价】。完全的信任是不存在的，只有当造假（走捷径获得利润）的成本远远高于得到的利润，才能取得信任（一致性）</p><p>必须强调，在传统的拜占庭问题构造的情景中，只能是一个例子，这个<strong>应用情景是完全没有没有必要使用区块链来解决的！</strong></p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>互联网技术的存在，让传输过程中，基本没有延迟（或说延迟很小可以基本忽略），<strong>解决了通讯延迟的问题</strong></p><p>区块链使用<strong>链型数据结构</strong> + <strong>算力互相制约</strong>使得<strong>作假的成本</strong>随着时间的加长<strong>呈指数上升</strong>，<strong>解决了一致性问题</strong>。当然非对称秘钥部分的密码学，解决了<strong>身份确认问题</strong></p><p>至少这个系统解决的问题不仅仅是金融领域，去中心化银行系统的问题所在，交易，其实只是其中很小的一部分</p><h1 id="区块链共识算法"><a href="#区块链共识算法" class="headerlink" title="区块链共识算法"></a>区块链共识算法</h1><p>因为技术还在不断发展，可能有其他的算法被建立，但是只要谈到共识这个问题，<strong>核心一定是【中心化】和【去中心化】的权衡（Trade-off）</strong>，而对应的就是效率，可以这么说，一致（信任）是需要成本的，这是本源法则，和线性向量空间的定义处在同一个层级</p><p>中本聪很厉害的地方就在于，之前的分布式一致性算法（PBFT）对大体谅节点系统的支持非常差，效率上来说，基本和无法实现是等等同的</p><p>下面的思维导图展示了现在基本的区块链共识算法总结</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/03/03/【区块链】如何解决拜占庭将军问题/CA.png" alt="" width="400"></div></p><h2 id="分布式一致性算法"><a href="#分布式一致性算法" class="headerlink" title="分布式一致性算法"></a>分布式一致性算法</h2><p>即这篇文章前面提到的<strong>拜占庭容错</strong>。在此基础上，发展出的Paxos是理论上的高效算法，很难实现。而Raft是由Google牵头开发一个Paxos理论实现版本</p><p>【去中心化】【大规模节点无法支持】【效率低】</p><h2 id="投票机制"><a href="#投票机制" class="headerlink" title="投票机制"></a>投票机制</h2><p>其中有两个比较有名的【RPCA Ripple共识】【DPOS 股权代理人共识】，在规则和协议上稍有不同，但是核心的Idea还是使用类似人大代表选举的制度来保证<strong>新区块的产生不会由同一个人控制</strong>，即代表轮流挖矿</p><p>NEO使用的是【DBFT】，投票的拜占庭容错算法，算是结合了几个算法的优势和思路，也很有想法！容错能力和PBFT一样，但是效率更高，信道使用冗余更低</p><p>【半中心化】【大规模节点支持】【效率高】</p><h2 id="PoW-工作量证明"><a href="#PoW-工作量证明" class="headerlink" title="PoW 工作量证明"></a>PoW 工作量证明</h2><p>最早的共识算法，使用算力来资源消耗来实现共识，详细方法见<a href="https://charlesliuyx.github.io/2017/09/24/%E4%B8%80%E6%96%87%E5%BC%84%E6%87%82%E5%8C%BA%E5%9D%97%E9%93%BE-%E4%BB%A5%E6%AF%94%E7%89%B9%E5%B8%81%E4%B8%BA%E4%BE%8B/#%E5%A6%82%E4%BD%95%E5%AE%9E%E7%8E%B0%E5%88%86%E5%B8%83%E8%AE%B0%E8%B4%A6%EF%BC%88%E5%8E%BB%E4%B8%AD%E5%BF%83%E5%8C%96%EF%BC%89">一步一步发明比特币</a></p><p>为了对抗ASIC矿机等专业化HASH算力硬件，也有一些PoW引入了内存HASH等禁止ASIC算力的方法。但是万变不离其中，最终还是归一化到一个【每Hash Rate/法币花费】博弈和平衡中</p><p>【PoC Proof of Capacity】容量证明，挖到区块和你的硬盘空间正相关</p><p>【去中心化】【大规模检点支持】【效率低】【资源消耗高】</p><h2 id="PoS-权益证明"><a href="#PoS-权益证明" class="headerlink" title="PoS 权益证明"></a>PoS 权益证明</h2><p>新建区块和你拥有的币的数量呈正相关，类似于利息的激励方式，可以参看<a href="https://charlesliuyx.github.io/2017/09/25/%E7%8E%B0%E4%BB%A3%E5%8C%BA%E5%9D%97%E9%93%BE%E4%B8%8E%E6%96%B0%E6%8A%80%E6%9C%AF/#%E6%9D%83%E7%9B%8A%E8%AF%81%E6%98%8E">权益证明</a></p><p>更多的【PoA Proof of Activity】活动证明，是一种Pow+PoS混合共识方式，基本被证明不靠谱了，提及一下</p><p>【去中心化】【大规模节点支持】【效率中】</p><h2 id="其他"><a href="#其他" class="headerlink" title="其他"></a>其他</h2><p>【PoET Proof of Elapsed Time】消逝时间证明：Intel使用HyperLedger建立的锯齿（Sawtooth）项目使用。<strong>在一种收信任的执行环境下保证随机的选择用户来生产区块，间隔时间提前约定</strong>。很奇怪的Idea，只适合于联盟链</p><h2 id="总结-1"><a href="#总结-1" class="headerlink" title="总结"></a>总结</h2><p>欢迎各位读者留言提示更多的不同共识算法，讨论交流，共同进步！</p><p>【完】</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】10min 3183 words&lt;br&gt;【阅读内容】什么是拜占庭问题，以及它和区块链的关系，现代区块链技术中&lt;strong&gt;常见的共识算法&lt;/strong&gt;总结&lt;/p&gt;
    
    </summary>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/categories/BlockChain/"/>
    
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/tags/BlockChain/"/>
    
      <category term="BGP" scheme="https://charlesliuyx.github.io/tags/BGP/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】让你永远忘不了的傅里叶变换解析</title>
    <link href="https://charlesliuyx.github.io/2018/02/18/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E8%AE%A9%E4%BD%A0%E6%B0%B8%E8%BF%9C%E5%BF%98%E4%B8%8D%E4%BA%86%E7%9A%84%E5%82%85%E9%87%8C%E5%8F%B6%E5%8F%98%E6%8D%A2%E8%A7%A3%E6%9E%90/"/>
    <id>https://charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/</id>
    <published>2018-02-18T15:06:25.000Z</published>
    <updated>2021-05-13T08:41:02.102Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】15-20min 7930 words<br>【阅读内容】使用联想链条和几何直观，辅以从实际需求衍生概念的思考模式，详解<strong>什么是傅立叶变换</strong>，<strong>为什么要做傅立叶变换</strong>等，帮助记忆和理解，目的当然是标题所说：让你永远忘不了傅里叶变换这个公式。另，这篇博客还从侧面一定程度上回答了另一个问题：<strong>为什么要研究复数</strong><br><a id="more"></a></p><p>本篇博客为<a href="https://www.bilibili.com/video/av19141078/" target="_blank" rel="noopener">形象展示傅里叶变换</a>和<a href="https://www.bilibili.com/video/av11339177/" target="_blank" rel="noopener">欧拉公式与初等群论</a>两个视频的笔记结合，希望通过此篇让所有读者对傅立叶变换有一个全新的认知，并且宣传一波 3b1b 良心视频系列！<strong>重塑对未知和知识的渴求</strong></p><p><a href="https://www.zhihu.com/question/19714540/answer/325895339" target="_blank" rel="noopener">知乎相关问题链接</a>，小伙伴们求点赞！没有功劳也有苦劳啊！</p><h1 id="欧拉公式与旋转"><a href="#欧拉公式与旋转" class="headerlink" title="欧拉公式与旋转"></a>欧拉公式与旋转</h1><p>在开始一步一步接近【傅立叶变换】前，先说一下群论</p><p>提前说明，此部分有地方会提到【群论】这个概念，但博主并不是要试图把什么环、域、向量空间、代数结构、线性代数群、李群等等一大堆很抽象的概念灌输给大家，我们只是为了利用群论的概念，<strong>加深</strong>或者说<strong>建立</strong>一个对【理解傅立叶变换】<strong>极度有帮助</strong>的直观概念：</p><blockquote><p><strong>指数函数</strong>（逆操作对数函数同理）<strong>是加法和乘法运算的桥梁</strong>，在自变量<strong>包含复数</strong>时表示<strong>旋转</strong></p></blockquote><p>以具体的一个例子来说：</p><blockquote><p>$e^{\pi i}$ 表示的是<strong>在单位圆</strong>上<strong>逆时针在旋转180°</strong>这个<strong>变换</strong></p></blockquote><p>等等，这不是排行<a href="http://www.sohu.com/a/125297876_465915" target="_blank" rel="noopener">世界上最伟大的十个公式</a>第二名的欧拉公式（上帝公式）嘛？（BTW，我们今天的主角【傅立叶变换】排行第七，这阵容着实强大）<br>$$<br>e^{\pi i} + 1 = 0<br>$$<br>是的，这第一部分，捎带，会带你更进一步的重新认识这个<strong>公式的伟大</strong></p><h2 id="对称性-symmetry"><a href="#对称性-symmetry" class="headerlink" title="对称性 symmetry"></a>对称性 symmetry</h2><p>首先，假设我们有以下陈述：</p><blockquote><p><strong>正方形</strong>是<strong>对称</strong>图形</p></blockquote><p>那么从<strong>数学（定义 or 公式）角度</strong>上来说，怎么描述【对称】这个概念呢？我们作为【人】，肯定会想，不就是看着左右一样嘛？不够严谨，不够优雅，继续深入，可以这么考虑：</p><blockquote><p>你能对正方形<strong>做些什么</strong>，并且在<strong>这个操作</strong>后，保持<strong>正方形的形态</strong>和操作前<strong>相同</strong></p></blockquote><p>我们把具有上述性质的<strong>操作</strong>都列出来，放在一起，如下面动图所示（左右旋转90°，旋转180°，四个轴对称，不变，这<strong>八个操作</strong>），就构成了一个有限群【对称群】，更专业的叫法是【八阶二面体群 Dihedral group of order 8】</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/Dihedral.gif" alt="" width="550"></div><br>有了上面的直观理解，还需要了解【旋转群】，表示的是<strong>所有旋转操作</strong>。因为角度可以无限细分，这个<strong>操作</strong>是无限的，比如：顺时针旋转 $\theta$° ，所以【旋转群】也是一个【无限群】</p><p>此时，能观察和总结出一个现象：按照顺序应对一个正方面进行8个操作的<strong>某两个</strong>，恰好等同于8个操作中的<strong>其他的某一个</strong>（旋转群同理）。如下面的动图所示，把这些<strong>组合</strong>放到一起，才真正的表达了【群】这个概念</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/groupAdd.gif" alt="" width="550"></div><br>很多不同的概念都能从对称性和对称性的符合构建得到。如下图所示，其中，数字本身有两种表达方式（操作），<strong>加法</strong>和<strong>乘法</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/Group.png" alt="" width="240"></div><br>对于<strong>【数】</strong>这个集合来说，<strong>加法</strong>对应数轴的<strong>平移变换</strong>（一个操作），<strong>乘法</strong>对应着数轴的<strong>伸缩变换</strong>（一个操作）</p><p>把这个数轴的概念拓展到<strong>平面坐标系</strong>，1D ➜ 2D。如果我们要把一个点，比如（1,0）<strong>移动到另一个点</strong>，应该如何操作？简单的说，只需要先在<strong>横轴方向</strong>上平移，再在<strong>纵轴方向</strong>上平移即可（核心思想类比于正方形的几个<strong>操作</strong>）</p><p>同理，除了<strong>平移</strong>外，使用<strong>伸缩</strong>加<strong>旋转</strong>也可以完成<strong>同样的事情</strong>（将任意一点移动到另一个位置），<strong>伸缩</strong>是乘法显而易见，但是<strong>旋转</strong>怎么表示呢？（当然直接改变<strong>坐标轴的定义</strong>也是能做到的，例子就是<strong>极坐标系</strong>，但我们并不想这么做），考虑构造以下<strong>思考链条</strong>：</p><ol><li><p>想做到把<strong>一个点变到另一个点</strong>：即从（1,0）通过<strong>伸缩</strong>和<strong>旋转</strong>到（-1,0），长度不变，只旋转就能实现</p></li><li><p>此时，注意到了一个形式很有<strong>特点的定义</strong>： $-1 = i \times i$ ，-1 就是我们需要的目标位置，那如何从（1,0）出发进行<strong>两次同样的操作</strong>可以得到（-1,0）呢？（这个操作即 $i$ 这个虚数单位定义的操作）答案即：一个<strong>单位 $i$</strong> 表示<strong>旋转90°</strong>即可</p></li><li><p><strong>更意外的发现</strong>，进行一次 $i$ 操作，如果是<strong>逆时针旋转90°</strong>，正好会落在二维平面y轴的（0,1）与<strong>单位长度</strong>不谋而合</p></li><li><p>更大胆的假设，如果y轴自带<strong>虚数单位</strong>，如 $i,2i,3i……$ ，就有旋转操作了，是不是就就能通过<strong>乘法</strong>来描述处在这个平面上的所有变换了？</p></li></ol><p>以上都是假设和推理，剥丝抽茧后，最关键的部分：如何使用<strong>单位 $i$</strong> 表示<strong>逆时针旋转90°</strong> ，并且给出了一种可能的<strong>映射规则</strong>，<strong>x轴平移表示伸缩</strong>，<strong>y轴平移表示旋转</strong>，这样就可以保证群的特性？（<strong>几种操作</strong>一定可以组合成其他<strong>某个操作</strong>，有一个学名：<strong>保持群结构</strong>）</p><p>$i$ 怎么可能表示旋转呢？怎么看都不像啊，陷入僵局。那么不妨换个角度来思考，<strong>旋转到底是什么？</strong></p><p><strong>旋转</strong>，是沿着一个<strong>圆弧</strong>（有圆心，转过的角度）运动的过程</p><p>如果你对<a href="https://charlesliuyx.github.io/2018/02/16/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E6%B3%B0%E5%8B%92%E7%BA%A7%E6%95%B0/">泰勒公式</a>非常熟悉（不熟悉没关系，点开连接看看呗？），就可通过一系列公式推导（下面就是）得到一个<strong>完美桥梁</strong>：<strong>【指数函数】</strong>，形如 $f(x) = a^x$ </p><p>如果底数 $a = e$ ，通过<strong>泰勒展开式</strong>，可完成一个<strong>十分优美的变形</strong>，如下：</p>$$e^x = 1 + x + \frac{1}{2!} x^2 + \frac{1}{3!} x^3 + \cdots \tag{1} \\ sin(x) = x - \frac{1}{3!}x^3 + \frac{1}{5!}x^5 + \cdots  \\ cos(x) = 1 - \frac{1}{2!}x^2 + \frac{1}{4!}x^4 + \cdots$$<p>将 $x = i\theta $ 带入（1）式（这里的 $\theta$ 是一个<strong>未知数</strong>，即<strong>自变量</strong>），整理项，移动，结合 $cos(x)$ 和 $sin(x)$ 的泰勒展开式，还有虚数单位的定义 $i \times i = -1$ ， 有下列推导：</p>$$\begin{align}e^{i\theta} & = 1 + {i\theta} + \frac{1}{2!}({i\theta})^2 + \frac{1}{3!} ({i\theta})^3 + \frac{1}{4!} ({i\theta})^4 + \frac{1}{5!} ({i\theta})^5 + \cdots \\ &= (1 - \frac{\theta^2}{2!} + \frac{\theta^4}{4!} + \cdots) + i(\theta -\frac{\theta^3}{3!} + \frac{\theta^5}{5!} + \cdots) \\&= cos(\theta) + isin(\theta)\end{align}\tag{4}$$<p>这个公式有什么用呢？<strong>可视化后</strong>，如下图所示</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/ei.svg" alt="" width="500"></div></p><blockquote><p>假设纵坐标自带虚数单位 $i$ （复平面），那么，$sin(\theta)$ 为纵坐标（自带虚数单位 $i$ ），$cos(\theta)$ 为横坐标，则可以发现： $e^{i\theta}$ 表示一个圆心在原点，半径为1的<strong>单位圆</strong>（图中是 $\alpha$ ，因为作图软件的限制，换不成 $\theta$ ，但不影响）</p></blockquote><p>$e^{i\theta}$ 这个公式<strong>等价于</strong>一种<strong>旋转</strong>，$\theta$ 为旋转角的度数（统一单位，弧度制，即把°转换成实数）$\theta = 2\pi$ 即为360°，是<strong>单位圆</strong></p><p>我们已经优雅的找到了这个桥梁（链接平移和旋转），接下来仔细研究一下它意味着什么</p><h2 id="指数函数-Exponentiation"><a href="#指数函数-Exponentiation" class="headerlink" title="指数函数 Exponentiation"></a>指数函数 Exponentiation</h2><p>指数函数有一个非常重要的特性：<strong>加法变乘法</strong>，即 $a^{x+y} = a^x \times a^y$</p><p>也就是说通过指数函数，可以做到使用<strong>平移变换</strong>来描述<strong>伸缩变换</strong>，这具体是什么意思呢？参考下面的动图</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/A2T.gif" alt="" width="550"></div><br><strong>上方的数轴</strong>，表示的是<strong>平移变换</strong> -1（左移一个单位） 和 2（右移两个单位）（加法），<strong>下方的数轴</strong>将两个数作为输入，代入到一个指数函数 $f(x) = 2^x$ 中，<strong>对于函数来说</strong>，这个<strong>输出值</strong>，就是两次<strong>伸缩变换</strong> （乘法），一次是<strong>收缩</strong>为原来的 $2^{-1}=\frac{1}{2}$ ，另一次是<strong>拉伸</strong>成原来的 $2^2 = 4$ 倍</p><p>注意，所谓<strong>可以变</strong>的意思是说，加法运算可以成立，意味着<strong>先往左平移1单位，再往右平移一单位，组合起来的左右就是往右平移一到位</strong>（$-1+2 =1$，群论的保持结构特性），而乘法运算成立也要满足这个特性</p><h2 id="复平面-Complex-Plane"><a href="#复平面-Complex-Plane" class="headerlink" title="复平面 Complex Plane"></a>复平面 Complex Plane</h2><p>至此，<strong>构造</strong>复平面，把虚数单位 $i$ 加到纵轴上。我们就同时拥有了<strong>伸缩和旋转</strong>，最关键的是，有了这两个操作，我们同时也可以维持群的特性（使用乘法）</p><p>如下面动图所示，在复平面内，以<strong>指数函数为桥梁</strong>，<strong>实轴横向平移</strong>对应<strong>伸缩</strong>，<strong>虚轴纵向平移</strong>对应<strong>旋转</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/A2Tall.gif" alt="" width="550"></div></p><blockquote><p>横坐标红线，横向平移映射到<strong>伸缩</strong>操作的可视化</p><p>纵坐标虚数单位，纵向平移映射到<strong>旋转</strong>操作的可视化，正为逆时针旋转</p></blockquote><p>现在使用的桥梁是底数为2的指数函数 $f(x) = 2^x$ ，我们知道 $e^{i\pi}$  代表的半个圆周，<strong>我们希望把底数变成</strong> $e$ ，这样更加方便表达圆的概念</p><p>每走<strong>一个单位</strong>的纵向位移，在圆周上<strong>旋转的圆弧</strong>长度就是1，参照下面的动图，$e^{\pi i}$ 恰好代表<strong>逆时针旋转180°</strong>，并且落在的位置为（-1,0），这就是<strong>欧拉公式</strong>，或者说是欧拉公式的几何直观可视化</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/e.gif" alt="" width="550"></div></p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>这第一部分到底干了啥？其实就是想建立一个观念（或者说常识）</p><p>$e^{x}$ <strong>在复平面，或者说 $x = ai$ （a为某个常数，就是弧度制的圆周长度）代表的变换是：旋转</strong> </p><p>如果你之前学过傅立叶变换，那么会明白为什么需要花费这么大篇幅来讲这个，因为公式中， $e^{i\pi}$ 那是可是相当重要的一部分啊</p><h1 id="傅立叶变换"><a href="#傅立叶变换" class="headerlink" title="傅立叶变换"></a>傅立叶变换</h1><p>正式进入傅立叶变换的部分，老规矩，先做一下基本信息整理</p><h2 id="什么是傅立叶变换"><a href="#什么是傅立叶变换" class="headerlink" title="什么是傅立叶变换"></a>什么是傅立叶变换</h2><p>首先，还是先弄清楚我们理解的目标是什么</p><blockquote><p>傅立叶变换（如果不加限定，这个词对应的是<strong>连续傅立叶变换</strong>）<br>傅立叶级数</p></blockquote><p>傅立叶变换还有很多其他的内容：<strong>离散时间傅立叶变换</strong>，<strong>离散傅立叶变换</strong>，<strong>傅立叶逆变换</strong>，快速傅立叶变换等，进一步的拉普拉斯变换，小波变换，z变换等</p><h3 id="公式表示"><a href="#公式表示" class="headerlink" title="公式表示"></a>公式表示</h3><p>傅立叶变换，变换作用是<strong>时域映射到频域</strong>，公式是长这样的：</p>$$\hat f (\xi) = \int_{-\infty}^{\infty} f(x) e^{-2\pi i x \xi} dx \quad \xi \;为任意实数$$<p>很多时候，这里的 $\hat f(\xi)$ 会写成 $F(w)$ 或 $F(f)$ 表示角速度或者频率，当然后面的公式的量纲也需要对应的修改；后面的自变量 $x$ 大多数时候都是写成 $t$ 表示时间。当然，他们表示的都是同一个东西</p><h3 id="联想链条"><a href="#联想链条" class="headerlink" title="联想链条"></a>联想链条</h3><p>既然是为了【理解】和【记忆】，那么我们还是需要定义一个<strong>联想链条</strong>：</p><blockquote><p>傅立叶变换 ➜ 分解声音的过程</p></blockquote><p>这么抽象实在是因为<strong>拆字法</strong>真的很难联想出什么东西来（傅里叶？变换？嗯，很难的样子），只能这样了。</p><p>接下来就是<strong>精华部分</strong>：3b1b的傅立叶变换讲解内的核心内容！在笔记完成后，会给出结合直观理解的完整<strong>联想链条</strong>，目的当然是【让你永远忘不了】喽，点题！</p><h2 id="【看到】傅立叶变换"><a href="#【看到】傅立叶变换" class="headerlink" title="【看到】傅立叶变换"></a>【看到】傅立叶变换</h2><h3 id="声音的表示"><a href="#声音的表示" class="headerlink" title="声音的表示"></a>声音的表示</h3><p>我们是如何记录声音的呢？如果你测量的是扬声器旁的<strong>气压</strong>，那么它会是一个<strong>随时间</strong>以正弦函数形态不断震荡的图像，一个标准音 A（下图黄色），它的频率是440Hz，表示<strong>每秒钟振动440次</strong>，比它低一些的D（下图紫红），是294Hz，振动的慢一些。如果这两个音同时发出，产生的<strong>气压随时间曲线</strong>怎么决定呢？如下动图，其实就是<strong>把所有时间点的振幅加起来</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/soundAdd.gif" alt="" width="550"></div><br>那么如果给你随意一段<strong>随时间变化的气压曲线</strong>，你如何找到这些原有的<strong>组成音符</strong>呢？这就是我们的目的，参考下面的动图，感觉有点像是把一盘混好的原料分成组成它的单独的颜色，感觉不那么容易吧？</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/soundD.gif" alt="" width="550"></div><br>下面就需要一步一步把这件事情做出来</p><h3 id="可视化方法"><a href="#可视化方法" class="headerlink" title="可视化方法"></a>可视化方法</h3><p>首先，假设我们有一个<strong>每秒钟3拍子</strong>的声音信号（440Hz实在太快了），它的图像如下（Intensity为强度，可以同理成气压），并且，<strong>我们只关注前面的4.5秒</strong>（即图像中画出来的部分）</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/sound.png" alt="" width="550"></div></p><h4 id="绕圈记录法：同一事物的不同角度"><a href="#绕圈记录法：同一事物的不同角度" class="headerlink" title="绕圈记录法：同一事物的不同角度"></a>绕圈记录法：同一事物的不同角度</h4><p>千万不要眨眼！下面是最关键的一步，是【看到】傅立叶变换的核心部分，如下面动图所示</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/keyIdea.gif" alt="" width="550"></div></p><ul><li>首先把黄色曲线缠绕到一个圆上，大小就是原本信号的振幅</li><li>圆周围的图像由<strong>白色的箭头</strong>绘制而成，速度可变，上图中的白色箭头移动速度是<strong>每秒钟转过半圈</strong>（这个速度是对于下面的圆形图像来说，每秒钟在<strong>圆形图像中</strong>转半圈），对应上面的则是<strong>虚线表示一圈</strong>走到的位置，0.5拍子/秒</li><li>此时，有两个频率在起作用，一个是<strong>信号的频率</strong>：3次震荡/秒，另一个是图像缠绕中心圆的频率，为0.5圈/秒，第二个频率可以自由改变，相当于一个<strong>变量</strong>，下面的动图直观的展现了<strong>缠绕速度变化时的可视化表现</strong></li></ul><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/change.gif" alt="" width="550"></div><br>从最开始的 0.79圈/秒（注意这里的速度是指<strong>绕单位圆的白色箭头的滑动速度</strong>）一直变化到1.55圈/秒，再到最后的恰好是3圈/秒，和原来的信号3拍/秒相同，此时会出现一个非常稳定的图像，我们可以理解成，<strong>同步</strong>，这个绕圈图像<strong>记录</strong>了原信号的<strong>幅值变化</strong>并且<strong>每一圈都相同</strong>（周期性）</p><p>其实，我们只是把一个水平的轴缠绕到一个单位圆上，并用另一个速度的<strong>记录标尺</strong>（白色箭头）来画图，从另一个角度（维度）来看我们的信号</p><h4 id="质心记录法：新维度的特征提取"><a href="#质心记录法：新维度的特征提取" class="headerlink" title="质心记录法：新维度的特征提取"></a>质心记录法：新维度的特征提取</h4><p>虽然新图像挺好看的，但是现在感觉并没法从中看出什么。也不尽然，我们直观的发现，当白色箭头记录的速度在某些特定的值时，画出来的图形非常稳定，形态清晰。那如何表现这个特征呢？</p><p>从两个角度来思考</p><p>（1）自变量是什么？（输入特征）</p><p>输入是一个<strong>可变化</strong>的转圈速度，既然可变，不妨把它看作<strong>自变量</strong>，即 $f(x)$ 中的 $x$ </p><p>（2）输出（新的圆圈图）有什么特征？（输出特征）</p><p>观察到，当图像很混沌（没有规律，混乱的）时候，图像基本关于原点对称；稳定时，其实是“头重脚轻”的。描述“头重脚轻”最好的方法当然是用【质心】（它描述了物体的空间分布特征） ，下面的动图直观展现了质心特征对图像特征的描述能力（<strong>红色点为质心</strong>）</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/mass.gif" alt="" width="550"></div><br>考虑到质心其实是一个二维坐标，这里为了简洁和直观，取<strong>质心的横坐标</strong>来表示质心的特征</p><p>【输入（横坐标）】➜【进行采样的（白色箭头）的绕圈速度】</p><p>【输出（纵坐标）】➜【圆圈图的质心位置的横坐标】</p><p>按照上面的说明来记录绘出图像，记录每个缠绕频率（速度）对应的质心位置，参看下列动图，随着图像的绘制到3圈/秒这个位置的时候，是不是<strong>感到似曾相识</strong>呢？</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/masspic.gif" alt="" width="550"></div><br>补充一点，在横坐标等于<strong>零点处</strong>有一个很大的值，只是因为原来的图像没有关于横轴对称，有一个偏移量，直观参看下面动图</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/mass0.gif" alt="" width="550"></div><br>我们可以看到，新图像的横坐标写的是【频率 Frequency】，即缠绕圆圈的记录速度，所以强烈建议看到<strong>频率，想起速度</strong>，并且抽象为<strong>围着圆圈跑的速度</strong>（个人感受，对理解【频率】的概念有助益）</p><p>好！有了这个工具，先把它应用到两个声音的组合图像中看看效果：（这是我最喜欢的一张动图）</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/2mix.gif" alt="" width="550"></div><br>什么？还是没看清上面的振动图像如何变成圆圈图的？看下面的动图，缠绕圆圈速度为2圈/秒的白色箭头将时间信息映射到圆圈图中的的可视化。再次重复，白色箭头以<strong>一定的速度</strong>（频率，一秒几圈）在上图中<strong>向右横移</strong>，同时，在下面的单位圆内被转换成类似钟表指针移动的圆圈运动，并<strong>记录振幅</strong>，画出图像</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/2mix2.gif" alt="" width="550"></div><br>BTW，图形的一部分有点像动画EVA中某个使徒的脸，带给人一种诡异的仪式感。数学之令人敬畏，可能在这一刻熠熠生辉，刺的人睁不开眼</p><h3 id="公式表示-1"><a href="#公式表示-1" class="headerlink" title="公式表示"></a>公式表示</h3><p>大家也发现了，我们已经通过这样一个<strong>缠绕机器</strong>完成了<strong>时域到频域的转换</strong>，总得来说，参看下面的动图</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/summary.gif" alt="" width="550"></div><br>这是一种【近傅立叶变换】，为什么是【近】，后面会提到。先考虑，那如何<strong>数学语言</strong>表达这个【转圈记录机制（工具 or 机器）】呢？</p><h4 id="第一步：旋转的表示"><a href="#第一步：旋转的表示" class="headerlink" title="第一步：旋转的表示"></a>第一步：旋转的表示</h4><p>如下面的动图所示，在这个工具中，非常关键的就是转圈，即表达旋转这种运动，根据第一大部分，这个桥梁，就是<strong>复平面</strong>，其背后的原理是<strong>指数函数</strong>结合<strong>泰勒公式</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/mix2D.gif" alt="" width="550"></div><br>更进一步，指数函数中，以 $e$ 为底的函数有着特殊的性质，如下面动图所示，$\pi$ 单位的 $e^{6.28i}$ 就表示一个单位圆的360°旋转，则 $e^{2\pi it}$ 表示的就是<strong>一秒钟一圈</strong>的旋转方程，感觉速度有点太快了，所以加一个 $f$ 频率，控制<strong>旋转的速度</strong> ，图中为 $\frac{1}{10}$ ，合起来表示<strong>一秒钟十分之一圈</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/fe.gif" alt="" width="500"></div></p><h4 id="第二步：缠绕的表示"><a href="#第二步：缠绕的表示" class="headerlink" title="第二步：缠绕的表示"></a>第二步：缠绕的表示</h4><p>首先，依据下面的动图所示，在傅立叶变换中，我们<strong>规定</strong>旋转是顺时针的（规定只是为了统一标准，并且有时候也会考虑<strong>书写简洁</strong>和<strong>方便计算</strong>），所以先加一个负号。假设原来的函数是 $g(t)$ ，将两者的<strong>幅值相乘</strong>就能得到缠绕图像，  $g(t) e^{-2 \pi ift}$ ，可以说是相当机智了！</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/circle.gif" alt="" width="550"></div></p><h4 id="第三步：质心的表示"><a href="#第三步：质心的表示" class="headerlink" title="第三步：质心的表示"></a>第三步：质心的表示</h4><p>那如何表示质心这一概念呢？粗略想一下感觉挺难的，但是看起来很难的问题，有一种解决问题的途径是【演绎推理】，先从<strong>简单的特例出发</strong>，推广到<strong>一般</strong>，最后<strong>证明正确性</strong>即可</p><p>考虑如何求一个正方形的质心位置，我们只需在边框上取n个等<strong>距离分布的点</strong>，并且算这几个点的位置的平均值。那么推广到一般情况，也使用类似的采样点的方式解决，如下面动图所示（紫红色的点即采样点），得到  $\frac{1}{N} \sum\limits _{k=1}^N g(t_k) e^{-2 \pi ift_k} $ </p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/sample1.gif" alt="" width="550"></div><br>随着采样点的增加，需要使用<strong>积分</strong>来求解这个问题，如下面动图所示，得到 $\frac{1}{t_2 - t_1} \int_{t_1}^{t_2} g(t) e^{-2 \pi i f t}dt$ </p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/sample2.gif" alt="" width="550"></div></p><h4 id="最终步：整理积分限和系数"><a href="#最终步：整理积分限和系数" class="headerlink" title="最终步：整理积分限和系数"></a>最终步：整理积分限和系数</h4><p>看到常数项系数  $\frac{1}{t_2 - t_1}$ ，如果忽略表达倍数关系的系数，对应的含义也会发生变化，不再是质心，而是<strong>信号存在的时间越久</strong>，位置是质心位置乘以一个倍数，它的值<strong>就越大</strong>。参看下面的动图，持续时长为3秒，那么新的位置就是原来质心位置的三倍；为6秒，就是原来的6倍</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/noeffi.gif" alt="" width="550"></div><br>而去掉系数的几何直观动图变为（<strong>红色箭头</strong>为去掉系数后的长度表示），最本质的区别是：可以使得最后绘制的图像<strong>更集中在</strong>对应的频率的附近，或者说在对应的频率位置的值更大</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/newpic.gif" alt="" width="550"></div><br>继续考虑上下限。我们知道，一般傅立叶变换公式的上下限是正负无穷，那它的几何直观是什么呢？参看下面动图，其实就是看看<strong>信号持续时间无穷大</strong>是什么样子的</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/limit.gif" alt="" width="550"></div><br>说实话，这个动图解答了我大学时代的一个疑惑，音乐文件不都是有时间长度的嘛，我就一直不懂，凭什么对负无穷到正无穷做傅立叶变换？原来真实情况是，负无穷到0，音乐结尾到正无穷，就像上面的动图，其实都没有<strong>振动幅值（电信号幅值）与之对应</strong>，再结合缠绕圆圈的思想：原来，从音乐开始到结束傅立叶变换和从负无穷到正无穷做傅立叶变换，是特么的一回事啊！（吐槽完毕）</p><h2 id="补充"><a href="#补充" class="headerlink" title="补充"></a>补充</h2><h3 id="相位"><a href="#相位" class="headerlink" title="相位"></a>相位</h3><p>在表示质心的时候，我们只取用了x轴坐标，下面的图中的<strong>蓝色曲线</strong>就是纵坐标（y轴 or 虚部）的可视化,红色曲线是横坐标（x轴 or 实部）</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/virtualpart.png" alt="" width="400"></div><br>那么相位是如何表示的呢？如下面动图所示，其中红色的部分为质心，长度为振幅大小，<strong>对应的角度就是相位</strong></p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/Phase.gif" alt="" width="350"></div></p><h3 id="原信号的长度"><a href="#原信号的长度" class="headerlink" title="原信号的长度"></a>原信号的长度</h3><p>再追根究底一些，因为之前已经提到过，假设我们的信号有4.5s。</p><p>那么考虑<strong>原信号的长度的变化</strong>呢？首先，假设<strong>信号的长度很长</strong>，那么缠绕圆上的线就会更多，每次接近稳定图像质心的变化速度更快（即频域图像更加密集），参看下面动图</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/relation.gif" alt="" width="450"></div><br>那么对应的，如果<strong>原信号的长度缩短</strong>呢？如下面动图所示，频域图像会更加稀疏。原因同理，当<strong>缠绕的内容少的时候，重心变化的速度也相应的变慢了</strong></p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/relation2.gif" alt="" width="450"></div><br>总得来说，基本就上述内容就详细解释了下面的现象：</p><p><div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/relationAll.gif" alt="" width="450"></div><br>时域的信号周期越长，那么频域就越集中，越不容易发生混叠，越容易抽象出时间信号的<strong>周期性重复信息</strong>，此时自然而然的，周期性这个词就出现了。</p><p>另外，可以自己思索一下，比如无穷时间的周期时域信号呢？又比如一个恒定振幅（一个电平）的时域信号呢？其实这里就给出了一个提示有关为什么傅立叶变换有那么多需要考虑的变形了，因为在缠绕这件事情发生的过程中，有<strong>几种情况是特别的</strong>（这部分3B1B视频并没有讲解，可能需要未来再更新了）</p><h1 id="总结-1"><a href="#总结-1" class="headerlink" title="总结"></a>总结</h1><p>讲了这么长，至此全部结束。估计读者都已经晕了，那么，在这里为【看到】傅立叶变换做一个总结，就来总得说说我们从头到尾都干了些啥？参看下面动图</p><p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/18/【直观详解】让你永远忘不了的傅里叶变换解析/seeF.gif" alt="" width="550"></div></p><ul><li><p>$e^{2\pi i}$ 表示单位圆，添加自变量即可表示<strong>旋转</strong></p></li><li><p>与原函数相乘<strong>缠绕到单位圆</strong>上</p></li><li><p>为求<strong>质心</strong>的特征，进行<strong>积分</strong>计算</p></li></ul><p>一步一步写出傅立叶变换公式的<strong>联想链条</strong></p><ul><li><p>一个逆时针旋转360°画成的圆 ➜ $e^{2\pi i}$ </p></li><li><p>表示运动，需要原函数的自变量，时间 $t$ ➜ $e^{2 \pi i t}$</p></li><li><p>表示<strong>旋转速度</strong>，需要自变量，频率 $f$ ➜ $e^{2 \pi i f t}$</p></li><li><p>规定变换的采样方向为顺时针，加负号 ➜ $e^{-2 \pi ift}$</p></li><li><p><strong>乘以原函数</strong>缠绕到单位圆并记录 ➜ $g(t) e^{-2 \pi ift}$ （此处使用 $g$ 符号标识原函数是为了和频率符号 $f$ 做区分）</p></li><li><p>为了计算<strong>质心</strong>特征，<strong>积分</strong> ➜  $\int_{-\infty}^{+\infty} g(t)e^{-2\pi it \color{red}{f}}dt$    </p></li><li><p>自变量为频率 $f$，写出函数表达式 ➜  $\hat g(\color{red}{f} \color{black}{) = \int_{-\infty}^{+\infty} g(t)e^{-2\pi it \color{red}{f}}dt}$ </p></li></ul>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】15-20min 7930 words&lt;br&gt;【阅读内容】使用联想链条和几何直观，辅以从实际需求衍生概念的思考模式，详解&lt;strong&gt;什么是傅立叶变换&lt;/strong&gt;，&lt;strong&gt;为什么要做傅立叶变换&lt;/strong&gt;等，帮助记忆和理解，目的当然是标题所说：让你永远忘不了傅里叶变换这个公式。另，这篇博客还从侧面一定程度上回答了另一个问题：&lt;strong&gt;为什么要研究复数&lt;/strong&gt;&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Math" scheme="https://charlesliuyx.github.io/categories/Math/"/>
    
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="Fourier Transform" scheme="https://charlesliuyx.github.io/tags/Fourier-Transform/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】泰勒级数</title>
    <link href="https://charlesliuyx.github.io/2018/02/16/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E6%B3%B0%E5%8B%92%E7%BA%A7%E6%95%B0/"/>
    <id>https://charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/</id>
    <published>2018-02-16T14:29:33.000Z</published>
    <updated>2018-09-24T07:33:06.199Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】10min 3326words<br>【阅读内容】通过<strong>构造知识联想链条</strong>和<strong>直观例子</strong>回答什么是泰勒级数，为什么需要泰勒级数，泰勒级数干了什么，如何记忆这个公式<br><a id="more"></a></p><p>本篇博客回答知乎问题<a href="https://www.zhihu.com/question/25627482/answer/321719657" target="_blank" rel="noopener">怎样更好的理解，并且记忆泰勒展开式？</a> （求点赞^_^）</p><blockquote><p>For me, mathematics is a collection of <strong>examples</strong>; a theorem is a statement about a collection of <strong>examples</strong> and the purpose of proving theorems is to classify and explain the <strong>examples</strong></p><p>John B. Conway</p><p>对于我而言，数学就是<strong>范例</strong>的集合——定理是为了描述<strong>范例</strong>，证明定理是为了分类并解释<strong>范例</strong>                                                                   </p><p>约翰·B·康威</p></blockquote><p><a href="https://www.bilibili.com/video/av11251323/?from=search&amp;seid=10355824295490802414" target="_blank" rel="noopener">微积分的本质 - 10 - 泰勒级数</a></p><p>在遇到一个生僻的概念或者公式时，确认它的几种不同的<strong>表述</strong>形式（马甲）是很重要，也就是定义问题：我们到底要了解的东西是什么 ＆ 怎么称呼：</p><blockquote><p>泰勒公式（也叫 泰勒展开式、泰勒多项式）<br>泰勒级数</p></blockquote><p>它是<strong>微积分学</strong>下的一个重要概念，与之有关联的有：如<strong>泰勒定理</strong>，<strong>多元泰勒公式</strong>，以<strong>拉格朗日型余项</strong>为代表的各类<strong>余项</strong>，<strong>审敛法</strong>，<strong>牛顿差值公式</strong>（牛顿级数）（列出为了进行树状知识整合和梳理）</p><h1 id="什么是泰勒公式"><a href="#什么是泰勒公式" class="headerlink" title="什么是泰勒公式"></a>什么是泰勒公式</h1><h2 id="基本定义"><a href="#基本定义" class="headerlink" title="基本定义"></a>基本定义</h2><p>数学定义，公式各个部分代表什么含义先说清楚</p>$$\begin{align} f(x)_{Taylor}  &= \sum_{n=0}^{\infty} \frac{f^{(n)}(a)}{n!} \times (x - a)^n \\ &= f(a) + \frac{f'(a)}{1!}(x-a) + \frac{f^{(2)}(a)}{2!}(x-a)^2+ \cdots + \frac{f^{(n)}(a)}{n!}(x-a)^n + R_n(x) \end{align}$$<blockquote><p>$f^{(n)}(a)$ 表示 $f(x)$ 在第 $n$ 阶导数的<strong>表达式</strong>，带入一个值 $a$ 计算后<strong>得到的结果</strong>（注意，它是个值）<br>$\frac{1}{n!}$ 是一个系数（一个值），每一项都不同，第一项 $\frac{1}{1}$，第二项 $\frac{1}{2!}$ …… 依此类推<br>$(x-a)^n$ 是一个以 $x$ 为自变量的<strong>表达式</strong></p><p>求和符号去掉展开写即第二行<br>$R_n(x)$ 是泰勒公式的<strong>余项</strong>，是 $(x-a)^n$ 的高阶无穷小（此处先不解释，听起来很牛逼，但是跟随例子看完就发现并没有什么玄乎的）</p></blockquote><p>个人粗浅总结，初学者产生记不住的感觉大多数情况下是没有沉下心来想想<strong>公式的各部分表示的是什么东西</strong>，梳理一下会清晰很多</p><h2 id="联想链条"><a href="#联想链条" class="headerlink" title="联想链条"></a>联想链条</h2><blockquote><p>所有的 ＜内容＞➜ 符号都表达【由＜内容＞联想到】（一种牢固记忆的技巧）</p><p>联想链条是为了给你一把一个长期记忆的钥匙，很久不用之后，估计只能记住【泰勒公式】四个字了，如何利用这仅有的信息回忆起具体的理解和内容，除了理解透彻，直观，利用图像外，弄一个联想链条也是不错的方法</p></blockquote><p>首先拆字</p><p>【公式】 ＜什么公式？＞➜ 【多项式】（Polynomials），把多项式的一般形式写出来，这应该是非常容易理解的概念，即指数不仅仅为2的抛物线的组合</p>$$P_{n}(x) = \sum_{i = 0}^{n} c_ix^i = c_0 + c_1x + c_2x^2 + \cdots + c_nx^n$$<p>【泰勒】＜谐音“太乐” ≈ 如果所有小数都能<strong>近似</strong>成整数那不是太快乐了？＞ ➜ <strong>近似</strong>，获得一个直观理解</p><ul><li>泰勒公式<strong>通过把【任意函数表达式】转换（重写）为【多项式】形式</strong>，是一种极其强大的函数<strong>近似工具</strong></li></ul><p>为什么说它强大呢？</p><ul><li>多项式非常【友好】，三易，易计算，易求导，易积分</li><li>几何感觉和计算感觉都很直观，如抛物线和几次方就是底数自己乘自己乘几次</li></ul><p>泰勒公式干的事情就是：<font color="red"><strong>使用多项式表达式估计（近似） $f(x)$ 在 $x = a$ 附近的值</strong> </font></p><p>那么如何<strong>近似</strong>呢？<strong>使用一个例子</strong>来加深理解</p><h1 id="怎样理解泰勒公式"><a href="#怎样理解泰勒公式" class="headerlink" title="怎样理解泰勒公式"></a>怎样理解泰勒公式</h1><p>我们要干的事情，就是<strong>改变</strong>多项式函数 $P(x) = c_0 + c_1x + c_2x^2$ 中 $c_0, c_1, c_2$ 的值 </p><p>（只有三项是为图个方便）去<strong>近似</strong>余弦函数 $f(x) = cos(x)$ ，【近似过程】参考下面的动图</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2Poly.gif" alt="近似过程" width="500"></div><p>我们需要做的事情（目的）即<strong>寻找一条绿色的曲线</strong>（多项式的系数 $c_0, c_1, c_2$），在 $x = 0$ 附近（0为上面提到的 $a$）尽可能的与 $f(x) = cos(x)$ 的图像<strong>相似</strong>（重合）</p><h2 id="函数式角度"><a href="#函数式角度" class="headerlink" title="函数式角度"></a>函数式角度</h2><p><u>那如何才能找到这三个参数呢？</u>最为显而易见的做法就是希望在 $x=0$ 的位置，两个表达式的切线尽量相等，切线即斜率，也就是<strong>求导</strong>，比较抽象，一步一步来可视化一下</p><h3 id="近似过程"><a href="#近似过程" class="headerlink" title="近似过程"></a>近似过程</h3><ul><li>【确定 $c_0$】$x=0$ 带入公式，令 $cos(x) = 1$ ，同理对 $P(x)$ 可以得到 $c_0=1$ </li></ul><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2Poly0.gif" alt="近似过程0" width="500"></div><ul><li><p>【确定 $c_1$】容易观察到，如果对 $P(x)$ 求导就可以把 $c_1$ 前的自变量去掉。并且，$x=0$ 处 $P(x)$ 已经固定为1，为了更进一步的相似，如果我们让 $x=0$ 处的 $f(x)$ 和 $P(x)$ 的切线斜率也相同不就更<strong>近似</strong>了？（两种思考模式我觉得都可以） 求导之后可以的到 $c_1 = 0$</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2Poly1.gif" alt="近似过程1" width="500"></div></li><li><p>【确定 $c_2$】现在我们<strong>已经</strong>确定两个值，那么绿色曲线就只能如下图一样移动（固定了 $x=0$ 的函数值和 $x=0$ 处的斜率 ），为了更接近<strong>相似</strong>的目标，我们希望<strong>斜率在变化的过程中</strong>，<strong>速度</strong>也是<strong>近似</strong>的（滑动的白色和黄色直线）。求二次导数，斜率的变化率相等，确定 $c_2 = -\frac{1}{2}$</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2Poly2.gif" alt="近似过程1" width="500"></div></li></ul><p>此时得到表达式 $P(x) = 1 - \frac{1}{2}x^2$ ，检测一下近似度如何？$cos(0.1) \approx 1 - \frac{1}{2}(0.1)^2 = 0.995$ 同时计算器 $cos(0.1) = 0.9950042$ ，其实只取前几项的多项式已经在 <strong>$x=a$ 附近的近似</strong>这一要求上有很好的效果了</p><p>为什么这个【近似过程】写的这么详细，是为了在过程中体会两个关键点</p><h3 id="为什么使用多项式来近似"><a href="#为什么使用多项式来近似" class="headerlink" title="为什么使用多项式来近似"></a>为什么使用多项式来近似</h3><p>因为多项式的求导法则可以控制变量，消去<strong>低次项</strong>，使得 $x=a$ 未知的 $c_n$ 容易确定，在之前的例子里，如下图所示</p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2PolyAll.gif" alt="近似过程all" width="500"></div><p>$c_0$ 确保了 $x=0$ 时相等，$c_1$ 确保了 $x=0$ 时的斜率相等，$c_2$ 确保了 $x=0$ 时斜率的变化率相等，或者说，<strong>随着多项式幂次变高，这种近似就越精确</strong></p><h3 id="为什么有个系数-frac-1-n"><a href="#为什么有个系数-frac-1-n" class="headerlink" title="为什么有个系数 $\frac{1}{n!}$"></a>为什么有个系数 $\frac{1}{n!}$</h3><p>阶层系数是由一次一次的求导产生的。我们再把项数加两个，参看下图，直观的感受一个 $n!$ 的诞生</p> <div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Cos2PolyMore.gif" alt="近似过程More" width="500"></div><p>首先，低次项会变为0，这样可以很方便的通过计算 $f(x)$ 的 $n$ 次求导的表达式，带入 $x=a$ 即可得到 $c_n$ 的值，<strong>阶层其实是多次求导的系数</strong></p><h3 id="函数角度总结"><a href="#函数角度总结" class="headerlink" title="函数角度总结"></a>函数角度总结</h3><p>其实，<strong>某一点处的导数值信息 $\iff$ 那一点附近的函数值信息</strong> 这个直观感觉，是很重要的</p><ul><li><p>首先，对于 $cos(x)$ 这个<strong>具体例子</strong>，把 $x=0$ 位置的多阶导数求出，再使用多项式进行近似，使用的项越多，得到的近似就越准确，参看下面动图</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Summary1.gif" alt="近似过程More" width="500"></div></li><li><p>推广到一般函数 $f(x)$ ,下列动图描述了随着项的增加，$x=0$ 附近的越来越准确</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Summary2.gif" alt="近似过程More" width="500"></div></li><li><p>最后，推广到 $x=a$ 的情形，完全推导出泰勒展开式的一般形式，如下列动图所示</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Summary3.gif" alt="近似过程More" width="500"></div></li></ul><h2 id="几何角度"><a href="#几何角度" class="headerlink" title="几何角度"></a>几何角度</h2><p>首先定义一个函数表示<strong>求下列图像中函数图像中填满部分的面积</strong>，函数为 $f(x)$ ，面积函数为 $f_{area}(x)$ ，而围成面积区域的曲线即为面积函数的导数 $\frac{df_{area}}{dx}(x)$ （至于为什么是这样，有一个牛逼的名字叫做，微积分基本定理： $\int_{a}^{b}f(t)dt = F(b)-F(a)$ ，没那么玄乎，在3B1B的另一个视频内讲解的相当直观。博主也可以写那一期的博客，如果要求的读者多的话），如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Farea.png" alt="几何解释" width="500"></div><p>定义一个这样的场景是为了计算这样一件事（如下图所示）：假设我们知道了 $f(a)$ 点的面积，往右扩展很小的距离 $dx$ 要算出<strong>新部分的面积</strong>（左边绿色已知 + 黄色矩形 + 红色三角形），<font color="blue">公式会是什么样的呢？</font></p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/FareaQ.png" alt="几何解释问题" width="500"></div><p>设 $dx$ 开始点为 $a$，终点为 $x$ ，则可以得到</p><ul><li>【黄色矩形】底边为 $x-a$ ；高为 $\frac{df_{area}}{dx}(a)$ ；</li><li>【红色三角形】底边为 $x-a$；高的计算稍微麻烦，首先，斜边的斜率是 $\frac{df_{area}}{dx}(x)$ <strong>函数的导数</strong>在 $x=a$ 时的函数值（算斜率，求导数即可），而斜率 $k = \frac{y}{x}$ ，所以得到高为 $\frac{d^2f_{area}}{dx^2}(a) \times (x-a)$ （前部分是斜率，后半部分是 $x$ ，需要求的是 $y$ 也是高）</li><li>【计算总面积】如下图和公式所示</li></ul>$$f_{area}(x) \approx f(a) + \frac{df_{area}}{dx}(a)(x-a) + \frac{1}{2} \frac{d^2f_{area}}{dx^2}(a)(x-a)^2$$<div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/FareaC.png" alt="几何解释问题" width="750"></div><p>这个公式为啥这么眼熟呢？其实明显就是泰勒展开式的前3项，如果你还要打破沙锅问到底，第4项呢？你可以放大红色三角形，把函数曲线和面积之间的空白部分再次用多个更小的三角形填补，在积分工具的帮助下，可以得到三次项</p><p>从几何角度来看，再一次验证了，泰勒公式是近似的 $x=a$ 附近的函数值这一直观理解</p><h2 id="余项"><a href="#余项" class="headerlink" title="余项"></a>余项</h2><p>我们知道，对<strong>泰勒公式</strong>来说，并没有办法完全逼近待求函数，所以无论如何到最后都会留一点东西，这剩下的东西不好表达，就<strong>全都丢到余项中</strong></p><p>可以暂时如此理解，不在此迷惑，如果是专业学生，需要深究，建议参看专业教材深入理解其中玄妙</p><h1 id="泰勒级数"><a href="#泰勒级数" class="headerlink" title="泰勒级数"></a>泰勒级数</h1><p>完成对【泰勒公式】的理解后，需要对【级数 Series】这个概念进行一个推广，<u>什么是【级数】呢？</u></p><p>在数学中，<font color="red">【级数】就是<strong>无限多项的和</strong></font></p><p>在把泰勒展开式，扩展到无限项之后，就会出现【收敛 Converge】和【发散 diverge】的概念</p><h2 id="收敛"><a href="#收敛" class="headerlink" title="收敛"></a>收敛</h2><p>收敛，即在泰勒展开式被推广到无限项之后，整体式子的值会越来越趋近于一个定值，比如下图的 $\frac{1}{2}$ 和 $e$ </p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Converge.gif" alt="几何解释问题" width="500"></div><h2 id="发散"><a href="#发散" class="headerlink" title="发散"></a>发散</h2><p>与收敛相对应的，即发散，式子无法趋近于一个定值，比如 $ln(x)$ 在 $x=1$ 附近，如下图所示，虚线即为能够让多项式的和收敛的最大取之范围，称为【泰勒级数的<strong>收敛半径</strong>】</p><div align="center"><img src="//charlesliuyx.github.io/2018/02/16/【直观详解】泰勒级数/Diverge.gif" alt="几何解释问题" width="500"></div><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><ul><li>泰勒公式干了一件什么事？</li></ul><p><strong>使用多项式表达式估计（近似） $f(x)$ 在 $x = a$ 附近的值</strong> </p><ul><li>泰勒公式的导数项如何推倒出来的？</li></ul><p><strong>某一点处的导数值信息 $\iff$ 那一点附近的函数值信息</strong></p><ul><li>泰勒公式如何记永远不会忘？</li></ul><p>参照第一条总结，是 $x=a$ 附近，公式 ➜ <strong>多项式</strong>，很多项，要用<strong>求和</strong>写在一起；参照第二条总结，近似信息用的<strong>求导</strong>；系数就是<strong>对 $x=a$ 处求导</strong>一次一次放下来；OK，开始写！</p>$$f(x) = \sum_{n=0}^\infty \frac{f^{(n)}(a)}{n!} (x-a)^n$$<p>并不知道写的对不对，翻到上面Check。OK，很完美，收工！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】10min 3326words&lt;br&gt;【阅读内容】通过&lt;strong&gt;构造知识联想链条&lt;/strong&gt;和&lt;strong&gt;直观例子&lt;/strong&gt;回答什么是泰勒级数，为什么需要泰勒级数，泰勒级数干了什么，如何记忆这个公式&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Math" scheme="https://charlesliuyx.github.io/categories/Math/"/>
    
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="Taylor series" scheme="https://charlesliuyx.github.io/tags/Taylor-series/"/>
    
  </entry>
  
  <entry>
    <title>微信跳一跳解题报告</title>
    <link href="https://charlesliuyx.github.io/2018/01/19/%E5%BE%AE%E4%BF%A1%E8%B7%B3%E4%B8%80%E8%B7%B3%E8%A7%A3%E9%A2%98%E6%8A%A5%E5%91%8A/"/>
    <id>https://charlesliuyx.github.io/2018/01/19/微信跳一跳解题报告/</id>
    <published>2018-01-19T04:00:21.000Z</published>
    <updated>2018-01-21T19:32:08.651Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】5min - 7min 2810 words<br>【内容简介】本文<strong>总结了</strong>解决问题{如何在跳一跳上快速取得高分的问题}，分为人类解决方案，机器解决方案两部分</p><a id="more"></a><h1 id="问题描述"><a href="#问题描述" class="headerlink" title="问题描述"></a>问题描述</h1><p>对于微信跳一跳来说，问题描述很直观</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2018/01/19/微信跳一跳解题报告/Prob.png" alt="问题描述" title="">                </div>                <div class="image-caption">问题描述</div>            </figure><ul><li>【玩游戏的心态】游戏本身有没有什么小技巧？<ul><li>特殊的加分技巧有哪些？</li><li>如何才能不紧张？</li></ul></li><li>【解题目的心态】每一次【跳跃】如何不掉下去？<ul><li>每一跳，看到目标墩后，需要按多久？</li><li>目标墩和小人的距离是多少？</li></ul></li></ul><h1 id="游戏机制"><a href="#游戏机制" class="headerlink" title="游戏机制"></a>游戏机制</h1><p>考虑到这是一个【按得时间越久，跳的距离越远的游戏】，也就是说：<strong>不摔死才是王道！</strong><a href="#问题描述">问题描述</a>已经如此明了，依次解决就好</p><h2 id="加分机制"><a href="#加分机制" class="headerlink" title="加分机制"></a>加分机制</h2><p>【1】特殊墩。停留2s，可加对应分数</p><table><thead><tr><th style="text-align:center">墩类型</th><th style="text-align:center">加分</th></tr></thead><tbody><tr><td style="text-align:center">井盖</td><td style="text-align:center">+5</td></tr><tr><td style="text-align:center">魔方</td><td style="text-align:center">+10</td></tr><tr><td style="text-align:center">便利店</td><td style="text-align:center">+15</td></tr><tr><td style="text-align:center">音乐盒（注意，有一层透明玻璃的才是）</td><td style="text-align:center">+30</td></tr></tbody></table><p>【2】连击跳。连续中心点，+2 +4 …… （是个人都知道）</p><p>【3】快速跳。落地之后马上起跳，可以在下一次落地即使也从+1变为+2</p><h2 id="按压时间与跳跃距离"><a href="#按压时间与跳跃距离" class="headerlink" title="按压时间与跳跃距离"></a>按压时间与跳跃距离</h2><p>直说结论，<strong>微信跳一跳的按压时间和跳跃距离是大约线性关系</strong>（根据其他大神的验证和精确测试，并不是完美线性关系）</p><p>打开声音，在蓄力的过程会有嘟嘟声，两次声音之间0.105秒左右，而每次跳跃的距离可以用尺子量出来。拟合（找一条直线看看是否能正好通过所有的点）后是个直线</p><p>写成公式的话为<br>$$<br>按压时间 = k \times 目标墩中心和小人的距离<br>$$<br>其实只要针对你的手机把这个k拟合出来就好（iOS，非Plus系列，k = 2.045）</p><h2 id="设计原则"><a href="#设计原则" class="headerlink" title="设计原则"></a>设计原则</h2><p>对于游戏设计来说，一款优秀的【休闲游戏】一定要满足三点</p><ul><li><strong>核心规则简单</strong></li><li><strong>容易失误</strong></li><li><strong>回报和难度成正比 + 随机奖励</strong></li></ul><p>所以，跳一跳能火爆，除了好友圈（这里包含微信强大的整合推广能力）之中的攀比心理，更是<strong>在这三点都做的相当出色</strong></p><h1 id="解决方案"><a href="#解决方案" class="headerlink" title="解决方案"></a>解决方案</h1><p>不是每个人都闲着没事做去搞得那么复杂来玩这个游戏，只有两种人会这么做，一种好胜心装逼心爆炸的，另一种就是吃饱了撑着（估计我是两者兼而有之），所以根据现根据前一种人来说，给出的解决方案就是【技巧上】</p><h2 id="技巧"><a href="#技巧" class="headerlink" title="技巧"></a>技巧</h2><p>游戏技巧当然是利用【比较容易达成】的手段来减少失误的方法，这款游戏考验的核心<strong>节奏感</strong>，<strong>控制力</strong></p><p>【节奏感】</p><p>大家都知道默数一分钟这个游戏吧</p><p>能完美默数60s，并且每一秒差距都不大的同学，在这部分就有很高的天赋了。当然还有学乐器，长时间锻炼的同学也是</p><p>【控制力】</p><p>也叫手残部分。你的APM（每分钟操作次数）速度，控制自己手的能力都考虑其中。</p><p>有个游戏是掉尺子抓住，看谁抓的位置更靠上，控制力包含对手的掌控力+反应速度，在这个游戏能取得很棒成绩的同学，你的得分肯定不会低</p><p>当然，所有这两点，都是可以通过<strong>不断的锻炼（花时间疯狂跳）</strong>来提高（这和花时间练琴才能弹的越来越好是一个道理）。只是有些人提高的快，有些同学可能提高的慢，而且很不幸，这种提升是一个Logistic曲线（有天花板）</p><p>天赋这东西就是这样，你在这里不擅长，太正常不过。每个人天赋都在不同的领域，所以放宽心才是王道，别太较真（跳一跳跳出一场轰轰烈烈的人生，我的天）</p><p>以下就是一些小技巧</p><h3 id="用纸贴住分数"><a href="#用纸贴住分数" class="headerlink" title="用纸贴住分数"></a>用纸贴住分数</h3><p>紧张和手不稳是【失误】的最大元凶，所以<strong>贴住分数有奇效</strong></p><h3 id="建立自己的模型"><a href="#建立自己的模型" class="headerlink" title="建立自己的模型"></a>建立自己的模型</h3><p>个人建议自己把距离分为4类</p><ul><li>很近（人和墩基本贴起来，一看就觉得好近）</li><li>很远（看起来就远的那种）</li><li>介于两者之间但是靠很近</li><li>介于两者之间但是靠很远</li></ul><p>在新墩出现的时候，先用0.5秒分一个类</p><p>【4类】原则，宁愿多按一点不少按</p><p>【1类】原则，蜻蜓点水千万不多</p><p>【2 3类】是最容易出问题的类别，如果失误，根据【第二设计原则】，太正常，如果太容易高分，成就感也会被压缩到很小，所以这是必须的，大侠从头来过就好</p><h3 id="小墩"><a href="#小墩" class="headerlink" title="小墩"></a>小墩</h3><p>对于遇到看起来非常小的墩（小药瓶，天崩地裂）</p><p>首先，不要虚，个人虽然没有验证，但是小的目标，感觉能跳上去的阈值也会大一些（或说磁铁or吸附效应），只要按照4分类模型来跳，上垒的可能性还是挺高的</p><h3 id="多跳"><a href="#多跳" class="headerlink" title="多跳"></a>多跳</h3><p>用时间积累，就和练钢琴是一个套路，身体的肌肉根据你看的图像产生反应，如果已经成为一种自然反应，分数肯定不会低</p><h2 id="正常方案"><a href="#正常方案" class="headerlink" title="正常方案"></a>正常方案</h2><p>解决这个问题，就是计算目标墩中心和小人的距离，那么目标墩的位置（目标位置），和小人的位置（起跳点位置）就是待求量</p><p>但是这些<strong>正常方案</strong>都需要在每一跳花费一定时间，非大毅力者不可为</p><h3 id="听音法"><a href="#听音法" class="headerlink" title="听音法"></a>听音法</h3><table><thead><tr><th style="text-align:center">听到嘟的次数</th><th style="text-align:center">跳跃的距离范围 cm</th></tr></thead><tbody><tr><td style="text-align:center">1</td><td style="text-align:center">0 - 1.02</td></tr><tr><td style="text-align:center">2</td><td style="text-align:center">1.02 - 1.54</td></tr><tr><td style="text-align:center">3</td><td style="text-align:center">1.54 - 2.05</td></tr><tr><td style="text-align:center">4</td><td style="text-align:center">2.05 - 2.58</td></tr><tr><td style="text-align:center">5</td><td style="text-align:center">2.58 - 3.09</td></tr><tr><td style="text-align:center">6</td><td style="text-align:center">3.09 - 3.61</td></tr><tr><td style="text-align:center">7</td><td style="text-align:center">3.61 - 4.12</td></tr><tr><td style="text-align:center">8</td><td style="text-align:center">4.12 - 4.64</td></tr><tr><td style="text-align:center">9</td><td style="text-align:center">大于 4.64</td></tr></tbody></table><p>量距离 ➜ 查表 ➜ 专心听 ➜ 数嘟嘟声 ➜ 到次数放</p><p>（不做评价，累）优势是如果每次都很准，+32 +64 可能都不是梦想吧？</p><h3 id="滑动屏幕法"><a href="#滑动屏幕法" class="headerlink" title="滑动屏幕法"></a>滑动屏幕法</h3><p><img src="//charlesliuyx.github.io/2018/01/19/微信跳一跳解题报告/Method.jpg" alt="滑动屏幕法" width="400"></p><p>然后，匀速的速度是 5.1 cm/s</p><p>（这个方法，感觉比靠感觉更容易失误）这个方法并没有每次都可以跳到中心的特点，个人感觉这个网站找到的方法有点做负功</p><h2 id="程序方案"><a href="#程序方案" class="headerlink" title="程序方案"></a>程序方案</h2><p>市面上很多的【外挂】或者说【脚本】基本都是这个方案，还有一些直接截包的可能更加暴力一些</p><h3 id="手机和电脑交互方法"><a href="#手机和电脑交互方法" class="headerlink" title="手机和电脑交互方法"></a>手机和电脑交互方法</h3><p>电脑手机连接起来，并且手机可以和电脑交换数据（API），比如电脑可以控制按压时间，电脑可以控制手机截图之类的基本交互操作</p><p>Android有adb工具，iOS有<a href="https://testerhome.com/topics/7220" target="_blank" rel="noopener">WebDriverAgent</a></p><h3 id="算法流程图"><a href="#算法流程图" class="headerlink" title="算法流程图"></a>算法流程图</h3><p>截图 ➜ 算出小人位置 ➜ 算出目标墩位置 ➜ 计算按压时间 ➜ 利用API操控手机按压 ➜ 跳</p><p>其实流程图非常简单，直接单线程就搞定了（没有循环结构和分支结构，都不用用其他软件画了）</p><p>主要如何计算小人位置，和计算目标墩位置两部分是关键</p><h3 id="多尺度搜索"><a href="#多尺度搜索" class="headerlink" title="多尺度搜索"></a>多尺度搜索</h3><p>利用OpenCV，图像处理，可以把所有小人抠图出来和图像进行匹配，最后选取置信度最高的，找出小人位置。代码如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">multi_scale_search</span><span class="params">(pivot, screen, range=<span class="number">0.3</span>, num=<span class="number">10</span>)</span>:</span></span><br><span class="line">    H, W = screen.shape[:<span class="number">2</span>]</span><br><span class="line">    h, w = pivot.shape[:<span class="number">2</span>]</span><br><span class="line"></span><br><span class="line">    found = <span class="keyword">None</span></span><br><span class="line">    <span class="keyword">for</span> scale <span class="keyword">in</span> np.linspace(<span class="number">1</span>-range, <span class="number">1</span>+range, num)[::<span class="number">-1</span>]:</span><br><span class="line">        resized = cv2.resize(screen, (int(W * scale), int(H * scale)))</span><br><span class="line">        r = W / float(resized.shape[<span class="number">1</span>])</span><br><span class="line">        <span class="keyword">if</span> resized.shape[<span class="number">0</span>] &lt; h <span class="keyword">or</span> resized.shape[<span class="number">1</span>] &lt; w:</span><br><span class="line">            <span class="keyword">break</span></span><br><span class="line">        res = cv2.matchTemplate(resized, pivot, cv2.TM_CCOEFF_NORMED)</span><br><span class="line"></span><br><span class="line">        loc = np.where(res &gt;= res.max())</span><br><span class="line">        pos_h, pos_w = list(zip(*loc))[<span class="number">0</span>]</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> found <span class="keyword">is</span> <span class="keyword">None</span> <span class="keyword">or</span> res.max() &gt; found[<span class="number">-1</span>]:</span><br><span class="line">            found = (pos_h, pos_w, r, res.max())</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> found <span class="keyword">is</span> <span class="keyword">None</span>: <span class="keyword">return</span> (<span class="number">0</span>,<span class="number">0</span>,<span class="number">0</span>,<span class="number">0</span>,<span class="number">0</span>)</span><br><span class="line">    pos_h, pos_w, r, score = found</span><br><span class="line">    start_h, start_w = int(pos_h * r), int(pos_w * r)</span><br><span class="line">    end_h, end_w = int((pos_h + h) * r), int((pos_w + w) * r)</span><br><span class="line">    <span class="keyword">return</span> [start_h, start_w, end_h, end_w, score]</span><br></pre></td></tr></table></figure><p>目标墩也可以使用类似的方法。只是要想办法减小搜索空间，加速。因为目标墩的数量还是比较多的。还可以搜索那个中心的小白点，速度越快越准（主需要等那个白点出现就好）</p><h2 id="机器学习方案"><a href="#机器学习方案" class="headerlink" title="机器学习方案"></a>机器学习方案</h2><p>为什么题都已经解了，还需要深究呢？这里主要目的是【提高用户体验感】，考虑到繁多的手机种类和尺寸，特别是iOS中截图的图像压缩问题，需要一套更加稳定的算法，机器学习算法就应运而生了</p><h3 id="输入"><a href="#输入" class="headerlink" title="输入"></a>输入</h3><p>经过裁剪的<strong>截图</strong>，只保留小人和目标墩（包含关键信息即可，做法使用OpenCV颜色为界，和小人位置为界即可），最终图像大小为 640*720 像素点</p><h3 id="输出"><a href="#输出" class="headerlink" title="输出"></a>输出</h3><p>两个值，<strong>目标墩的位置【x，y】</strong>（小人位置使用多尺度匹配搜索效率足够高了）</p><h3 id="模型结构"><a href="#模型结构" class="headerlink" title="模型结构"></a>模型结构</h3><p>考虑是图像处理。选择卷积网 - CNN，5层，基本规模，训练完成模型体积约700M</p><h3 id="训练数据"><a href="#训练数据" class="headerlink" title="训练数据"></a>训练数据</h3><p>根据跳一跳截图大约3000章，保证包含所有目标墩的形态，并且使用多尺度算法进行标注（所谓标注就是算出目标墩【x，y】值，并记录，和这幅图匹配起来）</p><h3 id="模型增强"><a href="#模型增强" class="headerlink" title="模型增强"></a>模型增强</h3><p>第一层网络经过数据训练后误差在10像素以内。为了进一步提升精度，之后，以此点中心，根据原训练图，再截图320*320大小的图片，同时加入像素偏移（噪声，防止过拟合），再次利用另一个CNN来训练计算坐标</p><h3 id="Pipeline示意图"><a href="#Pipeline示意图" class="headerlink" title="Pipeline示意图"></a>Pipeline示意图</h3><p><img src="//charlesliuyx.github.io/2018/01/19/微信跳一跳解题报告/JumpToJump.png" alt="" width="700"></p><h3 id="最终结果"><a href="#最终结果" class="headerlink" title="最终结果"></a>最终结果</h3><p>小于1像素，Inference时间0.5秒左右</p><h3 id="Trick"><a href="#Trick" class="headerlink" title="Trick"></a>Trick</h3><p>由于微信的反作弊系统，需要添加一些人为随机因素绕过反作弊系统，基本思路</p><ul><li>Target_pos + 正态分布随机数，保证连跳次数最多5-6次</li><li>间隔时间为&gt;2s的随机数</li><li>按压位置随机</li></ul><p>至此，微信跳一跳算是通关了。<strong>倒腾不息，生命不止</strong>。游戏中学习，兴趣中学习是我辈福气！</p><p>游戏是放松的一种方式，这种休闲游戏的好处就是，上瘾不易，每个人都有自己的天花板，每周刷新后跳跳看看可能会变成常态，总之孔子说的好，<strong>过犹不及</strong></p><p>【参考文献】</p><p>思路借鉴于<a href="https://www.zhihu.com/question/264773435" target="_blank" rel="noopener">知乎相关问题下的回答</a></p><p>代码借鉴<a href="">Prinsplield大神的AI跳一跳项目</a>，只添加绕过反作弊系统的代码</p><p>感谢大神们提供的学习资料！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】5min - 7min 2810 words&lt;br&gt;【内容简介】本文&lt;strong&gt;总结了&lt;/strong&gt;解决问题{如何在跳一跳上快速取得高分的问题}，分为人类解决方案，机器解决方案两部分&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Web" scheme="https://charlesliuyx.github.io/tags/Web/"/>
    
      <category term="CNN" scheme="https://charlesliuyx.github.io/tags/CNN/"/>
    
  </entry>
  
  <entry>
    <title>Dota2-A帐效果</title>
    <link href="https://charlesliuyx.github.io/2017/11/05/Dota2-A%E5%B8%90%E6%95%88%E6%9E%9C/"/>
    <id>https://charlesliuyx.github.io/2017/11/05/Dota2-A帐效果/</id>
    <published>2017-11-05T09:53:21.000Z</published>
    <updated>2017-11-06T22:00:01.719Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】百科类型文章<br>【内容简介】这是一份对Dota2 所有A帐效果的总结表，以供方便查阅</p><p>版本信息：更新到7.07b</p><a id="more"></a><h1 id="升级效果"><a href="#升级效果" class="headerlink" title="升级效果"></a>升级效果</h1><table><thead><tr><th style="text-align:center">英雄</th><th style="text-align:center">技能</th><th style="text-align:center">升级效果</th></tr></thead><tbody><tr><td style="text-align:center">亚巴顿</td><td style="text-align:center">回光返照</td><td style="text-align:center">（1）持续时间+1s【4/5/6 ➜ 5/6/7】<br>（2）900范围将队友承受伤害的50%转移到亚巴顿身上</td></tr><tr><td style="text-align:center">炼金术士</td><td style="text-align:center">无</td><td style="text-align:center">可以将A帐使用，附加一个A帐状态，获得属性和技能升级效果</td></tr><tr><td style="text-align:center">远古冰魄</td><td style="text-align:center">冰晶爆轰</td><td style="text-align:center">持续时间【8/9/10 ➜ 17】<br>持续魔法伤害【256/288/320 ➜ 544 】<br>450（及时伤害）16%即死】</td></tr><tr><td style="text-align:center">敌法师</td><td style="text-align:center">法术护盾</td><td style="text-align:center">反弹一次指向性施法 CD【12s】</td></tr><tr><td style="text-align:center">斧王</td><td style="text-align:center">战斗饥渴<br>淘汰之刃</td><td style="text-align:center">战斗饥渴减少目标输出30%<br>在一次成功的斩杀后给【700范围】的敌人英雄施加战斗饥渴（减速加速12% 与伤害 ）</td></tr><tr><td style="text-align:center">祸乱之源</td><td style="text-align:center">蚀脑</td><td style="text-align:center">蚀脑CD 1.5s 并可以<strong>穿透魔法免疫</strong></td></tr><tr><td style="text-align:center">蝙蝠骑士</td><td style="text-align:center">燃烧枷锁</td><td style="text-align:center">再抓住一个在目标附近400码范围内的目标，造成每秒100点的魔法伤害</td></tr><tr><td style="text-align:center">兽王</td><td style="text-align:center">野性咆哮</td><td style="text-align:center">增加施法距离【600 ➜ 950】<br>减少冷却CD【85/75/70 ➜ 45】</td></tr><tr><td style="text-align:center">嗜血狂魔</td><td style="text-align:center">割裂</td><td style="text-align:center">2充能点数 40sCD</td></tr><tr><td style="text-align:center">赏金猎人</td><td style="text-align:center">投掷飞镖</td><td style="text-align:center">2次反弹并短暂晕眩时间增长【0.1 ➜ 0.75】</td></tr><tr><td style="text-align:center">酒仙</td><td style="text-align:center">元素分离</td><td style="text-align:center">土熊猫踩，火熊猫醉拳，风熊猫酒雾，CD独立</td></tr><tr><td style="text-align:center">钢背兽</td><td style="text-align:center">粘稠鼻涕</td><td style="text-align:center">技能以自身为中心750范围施法</td></tr><tr><td style="text-align:center">半人马战行者</td><td style="text-align:center">野蛮冲撞</td><td style="text-align:center">减伤40%并可穿越地形</td></tr><tr><td style="text-align:center">混沌骑士</td><td style="text-align:center">混沌之军</td><td style="text-align:center">CD【130s ➜ 110s】 且可以对1200码内的友军释放</td></tr><tr><td style="text-align:center">陈</td><td style="text-align:center">神圣劝化<br>上帝之手</td><td style="text-align:center">（1）允许招远古<br>（2）增加控制远古单位的数量 1/2/3</td></tr><tr><td style="text-align:center">发条技师</td><td style="text-align:center">发射狗爪</td><td style="text-align:center">减少CD【70/55/40s ➜ 12s】</td></tr><tr><td style="text-align:center">水晶室女</td><td style="text-align:center">极寒领域</td><td style="text-align:center">处在大中2.5的单位受到冰封禁制的作用</td></tr><tr><td style="text-align:center">黑暗贤者</td><td style="text-align:center">复制之墙</td><td style="text-align:center">增加幻想伤害【60%/75%/90% ➜ 100%/120%/140%】</td></tr><tr><td style="text-align:center">戴泽</td><td style="text-align:center">薄葬</td><td style="text-align:center">450范围施法</td></tr><tr><td style="text-align:center">干扰者</td><td style="text-align:center">静态风暴</td><td style="text-align:center">增加持续时间【5s ➜ 7s】且施加锁闭（封物品）</td></tr><tr><td style="text-align:center">末日使者</td><td style="text-align:center">末日</td><td style="text-align:center">增加持续时间【15s ➜ 16s】<br>并在目标与Doom在900码内，持续时间不缩短</td></tr><tr><td style="text-align:center">卓尔游侠</td><td style="text-align:center">精准光环</td><td style="text-align:center">增加随机375码范围内的两个攻击目标<br>造成50%伤害，带攻击特效</td></tr><tr><td style="text-align:center">大地之灵</td><td style="text-align:center">残岩魔咒</td><td style="text-align:center">把目标变成岩石，持续3s</td></tr><tr><td style="text-align:center">撼地者</td><td style="text-align:center">强化图腾</td><td style="text-align:center">900码跳动释放，落地生效</td></tr><tr><td style="text-align:center">上古巨神</td><td style="text-align:center">裂地沟壑</td><td style="text-align:center">造成缴械，减速/缴械时间增长【3/4/5s ➜ 4/5/6】</td></tr><tr><td style="text-align:center">魅惑魔女</td><td style="text-align:center">推进</td><td style="text-align:center">攻击距离增加【550 ➜ 740】</td></tr><tr><td style="text-align:center">谜团</td><td style="text-align:center">黑洞</td><td style="text-align:center">大招时同时释放一个同等级午夜凋零</td></tr><tr><td style="text-align:center">虚空假面</td><td style="text-align:center">时间结界</td><td style="text-align:center">减少冷却CD【120/110/100 ➜ 60】</td></tr><tr><td style="text-align:center">矮人直升机</td><td style="text-align:center">高射火炮</td><td style="text-align:center">增加技能，对600范围内目标每1.1s自动攻击一次</td></tr><tr><td style="text-align:center">哈斯卡</td><td style="text-align:center">牺牲</td><td style="text-align:center">增加伤害 【34%/38%/42/% ➜ 65%】<br>减少冷却CD【12s ➜ 4s】</td></tr><tr><td style="text-align:center">祈求者</td><td style="text-align:center">元素召唤</td><td style="text-align:center">3元素+1等级 减少大招冷却【6s ➜ 2s】<br> 魔法消耗减少【60 ➜ 0】</td></tr><tr><td style="text-align:center">杰奇洛</td><td style="text-align:center">烈焰焚身</td><td style="text-align:center">增加距离【1400 ➜ 1800】<br>增加伤害【100/140/180 ➜ 125/175/225】<br>增加持续时间【10s ➜ 30】</td></tr><tr><td style="text-align:center">主宰</td><td style="text-align:center">无敌斩</td><td style="text-align:center">增加斩击次数【3/6/9 ➜ 6/9/12】<br>减少冷却CD【130/120/110s ➜ 70s】</td></tr><tr><td style="text-align:center">光之守卫</td><td style="text-align:center">灵魂形态<br>冲击波</td><td style="text-align:center">（1）永久大招，白天飞行视野<br>（2）冲击波造成等量治疗</td></tr><tr><td style="text-align:center">昆卡</td><td style="text-align:center">幽灵船</td><td style="text-align:center">拖拽行进过程中200码范围的敌人<br>此时开船位置在昆卡身前，沉默位置相同</td></tr><tr><td style="text-align:center">军团指挥官</td><td style="text-align:center">决斗</td><td style="text-align:center">持续时间增长【4/4.75/5.5 ➜ 6/7/8】<br>决斗双方不能受到第三方攻击伤害</td></tr><tr><td style="text-align:center">拉席克</td><td style="text-align:center">脉冲新星</td><td style="text-align:center">每1.75s释放一个闪电风暴<br>（700码，英雄优先，不弹射，200伤害）</td></tr><tr><td style="text-align:center">巫妖</td><td style="text-align:center">连环霜冻</td><td style="text-align:center">增加伤害【280/370/460 ➜ 370/460/550】 <br>增加施法距离【750 ➜ 850】<br>弹射次数无限 减速/减攻速增加【30% 30 ➜ 50% 50】</td></tr><tr><td style="text-align:center">噬魂鬼</td><td style="text-align:center">感染</td><td style="text-align:center">获得吸收技能，被吸收的友方英雄可以获得和噬魂鬼一样的感染加血<br>并且可以选择释放造成300的魔法700码AOE伤害</td></tr><tr><td style="text-align:center">莉娜</td><td style="text-align:center">神灭斩</td><td style="text-align:center">魔法伤害变为纯粹伤害 无视魔法免疫</td></tr><tr><td style="text-align:center">莱恩</td><td style="text-align:center">死亡一指</td><td style="text-align:center">增加伤害【600/725/850 ➜ 725/875/1025】<br>减低魔法消耗【200/420/650 ➜ 200/420/625】<br>降低冷却时间【160/100/400 ➜ 100/60/20】<br>作用主目标325码AOE范围的其他目标</td></tr><tr><td style="text-align:center">德鲁伊</td><td style="text-align:center">熊灵</td><td style="text-align:center">熊灵没有距离限制可以随时攻击，本体死亡熊不死亡</td></tr><tr><td style="text-align:center">露娜</td><td style="text-align:center">月食</td><td style="text-align:center">增加月光数量【5/8/11 ➜ 6/12/18】<br>目标承受最大月光数量【5 ➜ 无上限】<br>减少月光间隔【0.6s ➜ 0.3s】减少持续时间【2.4/4.2/6 ➜ 1.8/3.6/5.4】<br>允许释放月食跟随队友或施法距离2500码释放释放<br>675码搜索范围并获得地面视野</td></tr><tr><td style="text-align:center">马格纳斯</td><td style="text-align:center">冲击波</td><td style="text-align:center">冲击波会收回，击中的敌人会有2s 60%减速<br>最远距离和速度增加50%<br>回归的冲击波对小兵造成减半伤害</td></tr><tr><td style="text-align:center">美杜莎</td><td style="text-align:center">秘术异蛇</td><td style="text-align:center">击中目标造成1s石化，每次弹射时间增加0.2s</td></tr><tr><td style="text-align:center">米波</td><td style="text-align:center">分则能成</td><td style="text-align:center">增加一个实体</td></tr><tr><td style="text-align:center">米拉娜</td><td style="text-align:center">星落</td><td style="text-align:center">每9s自动师释放一次星落</td></tr><tr><td style="text-align:center">变体精灵</td><td style="text-align:center">混源</td><td style="text-align:center">获得一个友军的幻象，继承变体精灵的属性<br>并且可以释放非大招A帐技能</td></tr><tr><td style="text-align:center">娜迦海妖</td><td style="text-align:center">海妖之歌</td><td style="text-align:center">每秒恢复10%最大生命，持续时间【7s】</td></tr><tr><td style="text-align:center">先知</td><td style="text-align:center">自然之怒</td><td style="text-align:center">增加伤害【110/140/170 ➜ 135/170/205】<br>杀死一个小兵召唤一个树人，一个英雄召唤一个大树人<br>（102攻击力，1650生命值）</td></tr><tr><td style="text-align:center">瘟疫法师</td><td style="text-align:center">死神镰刀</td><td style="text-align:center">减少冷却CD【100/85/70 ➜ 55/40/25】</td></tr><tr><td style="text-align:center">暗夜魔王</td><td style="text-align:center">黑夜降临</td><td style="text-align:center">夜晚获得飞行视野</td></tr><tr><td style="text-align:center">司夜刺客</td><td style="text-align:center">钻地</td><td style="text-align:center">钻地状态40%伤害减免 1.5%最大生命值/最大魔法值恢复，并加强技能<br>发力燃烧和穿刺施法距离增加75%<br>减少穿刺CD【13s ➜ 7s】<br>尖刺外壳及时晕眩300码范围内的敌人</td></tr><tr><td style="text-align:center">食人魔魔法师</td><td style="text-align:center">未精通的火焰爆轰</td><td style="text-align:center">使用60%当前魔法值释放一个火焰爆轰，6s CD</td></tr><tr><td style="text-align:center">全能骑士</td><td style="text-align:center">守护天使</td><td style="text-align:center">增加持续时间【6/7/8s ➜ 8/9/10】<br>全屏作用，影响建筑</td></tr><tr><td style="text-align:center">神谕者</td><td style="text-align:center">涤罪之焰</td><td style="text-align:center">减少CD【2.25s ➜ 1s】施法动作时间减少【0.3s ➜ 0.1s】</td></tr><tr><td style="text-align:center">殁境神蚀者</td><td style="text-align:center">星体禁锢</td><td style="text-align:center">2点充能点数 CD【12s】伤害区域叠加<br>增加施法距离300码</td></tr><tr><td style="text-align:center">幻影长矛手</td><td style="text-align:center">灵魂之矛</td><td style="text-align:center">在敌人目标间弹射，弹射范围400码，5次弹射</td></tr><tr><td style="text-align:center">凤凰</td><td style="text-align:center">超新星</td><td style="text-align:center">被破坏次数增加【5/8/11 ➜ 7/10/13】<br>可以带一个人复活，500码施法距离，死亡一起死亡</td></tr><tr><td style="text-align:center">帕克</td><td style="text-align:center">梦境缠绕</td><td style="text-align:center">增加伤害【100/150/200 ➜ 200/250/300】<br>增加断开晕眩时间【1.5/2.25/3 ➜ 1.5/3/4.5】<br>持续时间增加【6 ➜ 8】无视魔免</td></tr><tr><td style="text-align:center">帕吉</td><td style="text-align:center">肉勾</td><td style="text-align:center">减少CD【4s】增加伤害【90/180/270/360 ➜ 180/270/360/450】</td></tr><tr><td style="text-align:center">帕格纳</td><td style="text-align:center">生命汲取</td><td style="text-align:center">增加每秒汲取量【150/200/250 ➜ 180/240/300】无CD</td></tr><tr><td style="text-align:center">痛苦女王</td><td style="text-align:center">超震声波</td><td style="text-align:center">增加伤害【290/380/470 ➜ 325/440/555】<br>减少CD【135s ➜ 40s】</td></tr><tr><td style="text-align:center">剃刀</td><td style="text-align:center">风暴之眼</td><td style="text-align:center">减少打击间隔【0.7/0.6/0.5 ➜ 0.6/0.5/0.4】<br>可以攻击建筑</td></tr><tr><td style="text-align:center">力丸</td><td style="text-align:center">绝杀秘技</td><td style="text-align:center">大招可以跟随队友移动<br>1000码范围，增加大招持续时间【4/5/6s ➜ 7/8/9s】</td></tr><tr><td style="text-align:center">拉比克</td><td style="text-align:center">技能偷窃</td><td style="text-align:center">偷来的技能有A帐效果<br>减少CD【20/18/16 ➜ 2s】增加施法距离【1000 ➜ 1400】</td></tr><tr><td style="text-align:center">沙王</td><td style="text-align:center">掘地穿刺</td><td style="text-align:center">增加施法距离【350/450/550/650 ➜ 700/900/1100/1300】<br>在刺中的目标上附加腐蚀毒</td></tr><tr><td style="text-align:center">暗影恶魔</td><td style="text-align:center">邪恶净化</td><td style="text-align:center">3点能量点数，充能时间【40s】，持续时间5s<br>给目标附加<strong>破被动</strong>效果</td></tr><tr><td style="text-align:center">影魔</td><td style="text-align:center">收集灵魂<br>魂之挽歌</td><td style="text-align:center">增加灵魂的数量【15/22/29/36 ➜ 22/30/38/46】<br>大招会收回造成二次伤害，并且给予<strong>40%的伤害值的治疗</strong></td></tr><tr><td style="text-align:center">暗影萨满</td><td style="text-align:center">群蛇守卫</td><td style="text-align:center">守卫同时全伤害攻击2个目标<br>增加攻击距离【600 ➜ 825】</td></tr><tr><td style="text-align:center">沉默术士</td><td style="text-align:center">智慧之刃</td><td style="text-align:center">无视魔免，并对沉默的单位造成<strong>100%的额外伤害</strong></td></tr><tr><td style="text-align:center">天怒法师</td><td style="text-align:center">双风</td><td style="text-align:center">每次释放技能都和自动搜索<strong>以目标为中心</strong>700码内的单位再释放一次<br>（优先英雄单位）</td></tr><tr><td style="text-align:center">斯拉克</td><td style="text-align:center">暗影之舞</td><td style="text-align:center">减少CD【60s ➜ 30s】并且可以对325码范围内的友军生效</td></tr><tr><td style="text-align:center">狙击手</td><td style="text-align:center">暗杀</td><td style="text-align:center">变成以目标为中心400范围的范围技能<br>造成2.8倍物理伤害，并附加爆头（被动）效果</td></tr><tr><td style="text-align:center">裂魂人</td><td style="text-align:center">幽冥一击</td><td style="text-align:center">增加施法距离【700 ➜ 850】减少CD【60s ➜ 20s】<br>对以目标为中心250码范围内的目标触发巨力冲击（被动）</td></tr><tr><td style="text-align:center">风暴之灵</td><td style="text-align:center">电子涡流</td><td style="text-align:center">以蓝猫为中心475码范围施法，<strong>需要目标视野</strong>才能有效</td></tr><tr><td style="text-align:center">斯温</td><td style="text-align:center">神之力量</td><td style="text-align:center">900码光环效果，获得75%/100%/125%的额外伤害加成（给予Sven增加的攻击力）</td></tr><tr><td style="text-align:center">工程师</td><td style="text-align:center">遥控地雷<br>雷区标示</td><td style="text-align:center">增加伤害【300/450/600 ➜ 450/600/750】增加事施法距离【500 ➜ 700】<br>在标识附近125码放置3中地雷，并且免疫真实视野</td></tr><tr><td style="text-align:center">潮汐猎人</td><td style="text-align:center">巨浪</td><td style="text-align:center">变为长条形对地施法，1800码长度，240码宽度</td></tr><tr><td style="text-align:center">伐木机</td><td style="text-align:center">锯齿飞轮</td><td style="text-align:center">再获得一个独立额外的大招</td></tr><tr><td style="text-align:center">修补匠</td><td style="text-align:center">激光<br>导热飞弹</td><td style="text-align:center">激光可以在目标650码的敌方英雄身上反射 <br>增加导弹数量【2 ➜ 4】</td></tr><tr><td style="text-align:center">树精卫士</td><td style="text-align:center">森林之眼</td><td style="text-align:center">获得一个给树木附加的技能，800码飞行视野<br>并在范围内有大招效果并可以造成伤害（175/s）</td></tr><tr><td style="text-align:center">巨牙海民</td><td style="text-align:center">海象飞踢</td><td style="text-align:center">将一个单位踢飞1400码，造成40%减速，350吗，魔法伤害，持续4s</td></tr><tr><td style="text-align:center">孽主</td><td style="text-align:center">衰退光环</td><td style="text-align:center">增加被动持续时间【 30/40/50/60 ➜ 70/80/90/100】己方死亡英雄会获得一半加成</td></tr><tr><td style="text-align:center">不朽尸王</td><td style="text-align:center">腐朽</td><td style="text-align:center">增加力量偷取【4 ➜ 10】</td></tr><tr><td style="text-align:center">熊战士</td><td style="text-align:center">激怒</td><td style="text-align:center">在被控制时可以释放，减少CD【50/40/30 ➜ 30/24/18】</td></tr><tr><td style="text-align:center">复仇之魂</td><td style="text-align:center">移形换位</td><td style="text-align:center">允许对非英雄目标施法，减少CD【45s ➜ 10s】<br>死亡后有一个可以操控一个复仇幻象（不能使用物品，其他都都完全相同）</td></tr><tr><td style="text-align:center">剧毒术士</td><td style="text-align:center">剧毒新星</td><td style="text-align:center">增加每秒伤害【30/55/80 ➜ 60/85/110】<br>减少CD【140/120/100 ➜ 140/120/60】</td></tr><tr><td style="text-align:center">冥界亚龙</td><td style="text-align:center">蝮蛇突袭</td><td style="text-align:center">增加施法距离【500 ➜ 900】减少CD【80/50/30 ➜ 10】<br>减少魔法消耗【125/175/250 ➜ 125】</td></tr><tr><td style="text-align:center">维萨吉</td><td style="text-align:center">佣兽</td><td style="text-align:center">增加一头佣兽</td></tr><tr><td style="text-align:center">术士</td><td style="text-align:center">地狱火</td><td style="text-align:center">2个地狱火，每个地狱火的生命和伤害变为原来的75%<br>每个被击杀获得金钱变为原来的50%</td></tr><tr><td style="text-align:center">编织者</td><td style="text-align:center">回到过去</td><td style="text-align:center">减少CD【60/50/40 ➜ 16】<br>可以对友军释放，法法距离【1000码】</td></tr><tr><td style="text-align:center">风行者</td><td style="text-align:center">集中火力</td><td style="text-align:center">攻击减少变少【50%/40%/30% ➜ 30%/15%/0】<br>减少CD【60s ➜ 15s】</td></tr><tr><td style="text-align:center">寒冬飞龙</td><td style="text-align:center">严寒灼烧</td><td style="text-align:center">变成一个开关技能，开启每秒消耗40点魔法<br>不再有对某个目标的攻击次数上限</td></tr><tr><td style="text-align:center">巫医</td><td style="text-align:center">死亡守卫</td><td style="text-align:center">攻击可以弹射4次，具有真实视野</td></tr><tr><td style="text-align:center">冥魂大帝</td><td style="text-align:center">重生</td><td style="text-align:center">在1200码内的友方英雄死亡后还可以获得7s时间复活</td></tr><tr><td style="text-align:center">宙斯</td><td style="text-align:center">雷云</td><td style="text-align:center">全图可以放置一个雷云并对<strong>最近的敌人</strong>释放雷击<br>间隔时间2.25s，持续时间35s，摧毁需要次数（近战/远程/非英雄 4/8/16）<br>（间隔可以被减CD效果影响）</td></tr></tbody></table><h1 id="推荐出的英雄"><a href="#推荐出的英雄" class="headerlink" title="推荐出的英雄"></a>推荐出的英雄</h1><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/11/05/Dota2-A帐效果/Recommend.png" alt="推荐英雄" title="">                </div>                <div class="image-caption">推荐英雄</div>            </figure><p>其中，有<strong>质变效果</strong>的：</p><p><strong>远古冰魄</strong>，发条技师，干扰者，谜团，<strong>祈求者</strong>，<strong>光之守卫</strong>，莉娜，瘟疫法师，暗夜魔王，<strong>帕克</strong>，帕格纳，暗影恶魔，暗影萨满，工程师，<strong>伐木机</strong>，树精卫士，维萨吉，<strong>术士</strong>，巫医，嗜血狂魔，米拉娜，<strong>司夜刺客</strong>，不朽尸王</p><h1 id="看情况出的英雄"><a href="#看情况出的英雄" class="headerlink" title="看情况出的英雄"></a>看情况出的英雄</h1><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/11/05/Dota2-A帐效果/Situ.png" alt="看情况出" title="">                </div>                <div class="image-caption">看情况出</div>            </figure><h1 id="无A帐效果"><a href="#无A帐效果" class="headerlink" title="无A帐效果"></a>无A帐效果</h1><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/11/05/Dota2-A帐效果/No.png" alt="无A帐效果" title="">                </div>                <div class="image-caption">无A帐效果</div>            </figure><p>新版本中加上小小，石鳞剑士，邪影芳灵无A帐效果</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】百科类型文章&lt;br&gt;【内容简介】这是一份对Dota2 所有A帐效果的总结表，以供方便查阅&lt;/p&gt;
&lt;p&gt;版本信息：更新到7.07b&lt;/p&gt;
    
    </summary>
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/categories/Dota2/"/>
    
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/tags/Dota2/"/>
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
      <category term="Data Analysis" scheme="https://charlesliuyx.github.io/tags/Data-Analysis/"/>
    
  </entry>
  
  <entry>
    <title>深入浅出看懂AlphaGo元</title>
    <link href="https://charlesliuyx.github.io/2017/10/18/%E6%B7%B1%E5%85%A5%E6%B5%85%E5%87%BA%E7%9C%8B%E6%87%82AlphaGo%E5%85%83/"/>
    <id>https://charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/</id>
    <published>2017-10-18T12:54:32.000Z</published>
    <updated>2017-10-31T23:31:42.824Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】21min - 24min 10999字<br>【内容简介】<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/">AlphaGo1.0详解链接</a>，这篇AlphaGo Zero论文原文超详细翻译，并且总结了AlphaGo Zero的算法核心思路，附带收集了网上的相关评论<br><a id="more"></a></p><p>在之前的详解：<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/">深入浅出看懂AlphaGo</a>中，详细定义的DeepMind团队定义围棋问题的结构，并且深入解读了AlphaGo1.0每下一步都发生了什么事，就在最近，AlphaGo Zero横空出世。个人观点是，如果你看了之前的文章，你就会觉得这是一个水到渠成的事情</p><p>另，如果你只对这个事件感兴趣的，而不想了解论文和技术细节，链接奉上，欢迎跳过到<a href="#总结与随想">最后评论和总结部分</a>（但这部分网上的大牛太多了，知乎答案内最高票对结合围棋的分析很漂亮！建议阅读）</p><p><strong>上限置信区间算法（UCT），一种博弈树搜索算法</strong>，是AlphaGo中一个重要组成部分：<strong>MCTS搜索算法</strong>中的核心</p><p>法国南巴黎大学的数学家西尔万·热利(SylvainGelly)与巴黎技术学校的王毅早(YizaoWang，音译)将<strong>UCT</strong>集成到一个他们称之为<strong>MoGo</strong>的程序中。该程序的胜率竟然比先前最先进的蒙特卡罗扩展算法<strong>几乎高出了一倍</strong>。</p><p><strong>2007年春季</strong>，MoGo在大棋盘比赛中也击败了实力稍弱的业余棋手，充分展示了能力。<strong>科奇什（UCT算法发明者）预言，10年以后，计算机就能攻克最后的壁垒，终结人类职业棋手对围棋的统治</strong>。今年是2017年，AlphaGo系列横空出世。10年，总有着天才的人具有先知般的远见。<a href="https://baike.baidu.com/item/UCT%E7%AE%97%E6%B3%95/19451060" target="_blank" rel="noopener">详见UTC算法</a></p><p>【小发现】看完论文发现，这篇文章的<strong>接受时间是2017年4月7号</strong>，审核完成时间是2017年9月13号，而在<strong>乌镇对阵柯洁（2017年5月23号）</strong>用的可能是AlphaGo Master（这里没法证据来证明到底是AlphaGo Zero还是AlphaGo Master）。这个团队也是无情啊，人类再一次感觉被耍了，根据Elo得分，Deepmind团队可能在赛前就透露过吧，即使是Master也有4858分啊，对于一个棋手来说，我感受到的是<strong>风萧萧兮易水寒决绝的背影</strong>。<strong>为柯洁的勇气打Call，当真围棋第一人，天下无双</strong></p><h1 id="论文正文内容详细解析"><a href="#论文正文内容详细解析" class="headerlink" title="论文正文内容详细解析"></a>论文正文内容详细解析</h1><p>先上干货论文：<a href="https://deepmind.com/documents/119/agz_unformatted_nature.pdf" target="_blank" rel="noopener">Mastering the Game of Go without Human Knowledge</a> ，之后会主要<strong>以翻译论文</strong>为主，在语言上<strong>尽量易懂，避免翻译腔</strong></p><p>AlphaGo Zero，从本质上来说完全不同于打败樊麾和李世石的版本</p><ul><li>算法上，<strong>自对弈强化学习，完全从随机落子开始</strong>，不用人类棋谱。之前使用了大量棋谱学习人类的下棋风格）</li><li>数据结构上，只有<strong>黑子白子两种状态</strong>。之前包含这个点的气等相关棋盘信息</li><li>模型上，使用<strong>一个</strong>神经网络。之前使用了<strong>策略网络（基于深度卷积神经网）</strong>学习人类的下棋风格，<strong>局面网络</strong>（基于左右互搏生成的棋谱，为什么这里需要使用左右互搏是因为现有的数据集不够，没法判断落子胜率这一更难的问题）来计算在<strong>当前局面下每一个不同落子的胜率</strong></li><li>策略上，基于训练好的这个神经网，进行简单的<strong>树形搜索</strong>。之前会使用蒙特卡洛算法实时演算并且<strong>加权得出落子的位置</strong></li></ul><h2 id="AlphaGo-Zero-的强化学习"><a href="#AlphaGo-Zero-的强化学习" class="headerlink" title="AlphaGo Zero 的强化学习"></a>AlphaGo Zero 的强化学习</h2><h3 id="问题描述"><a href="#问题描述" class="headerlink" title="问题描述"></a>问题描述</h3><p>在开始之前，必须再过一遍如何符号化的定义一个围棋问题</p><p>围棋问题，棋盘 <code>19×19=361</code> 个交叉点可供落子，每个点三种状态，白（用<code>1</code>表示），黑（用<code>-1</code>表示），无子（用<code>0</code>表示），用 $\vec s$ <strong>描述</strong>此时<strong>棋盘的状态</strong>，即棋盘的<strong>状态向量</strong>记为 $ \vec s$ （state首字母）<br>$$<br>\vec s = (\underbrace{1,0,-1,\ldots}_{\text{361}})<br>$$<br>假设状态 $\vec s$ 下，暂不考虑不能落子的情况， 那么下一步可走的位置空间也是361个。将下一步的<strong>落子行动</strong>也用一个361维的向量来表示，记为 $\vec a$ （action首字母）<br>$$<br>\vec a = (0,\ldots,0,1,0,\ldots)<br>$$<br>公式1.2 假设其中<code>1</code>在向量中位置为<code>39</code>，则  $\vec a$ 表示在棋盘<code>3行1列</code>位置落<strong>白子</strong>，黑白交替进行</p><p>有以上定义，我们就把围棋问题转化为。</p><blockquote><p>任意给定一个状态  $\vec s$ ，寻找最优的应对策略  $\vec a$ ，最终可以获得棋盘上的最大地盘</p></blockquote><p>简而言之</p><blockquote><p>看到 $\vec s$ ，脑海中就是<strong>一个棋盘，上面有很多黑白子</strong></p><p>看到 $\vec a$ ，脑海中就想象一个人<strong>潇洒的落子</strong></p></blockquote><h3 id="网络结构"><a href="#网络结构" class="headerlink" title="网络结构"></a>网络结构</h3><p>新的网络中，使用了一个参数为 $\theta$ （需要通过训练来不断调整） 的<strong>深度神经网络</strong>$f_\theta$ </p><ul><li>【<strong>网络输入</strong>】<code>19×19×17</code>0/1值：现在棋盘状态的 $\vec s$ 以及<strong>7步历史落子记录</strong>。最后一个位置记录黑白，0白1黑，<a href="#网络结构">详见</a></li><li>【<strong>网络输出</strong>】两个输出：<strong>落子概率（<code>362</code>个输出值）</strong>和<strong>一个评估值（[-1,1]之间）</strong>记为  $f_{\theta}(\mathbf {\vec s}) = (\mathbf p,v)$ <ul><li>【落子概率 $\mathbf p$】 向量表示下一步在每一个可能位置<strong>落子的概率，又称先验概率</strong> （加上不下的选择），即  $p_a = Pr(\vec a|\mathbf {\vec s})$  （公式表示在当前输入条件下在每个可能点落子的概率）</li><li>【评估值 $v$】 表示现在准备下当前这步棋的选手<strong>在输入的这八步历史局面 $\vec s$ 下的胜率</strong>（我这里强调局面是因为网络的输入其实包含历史对战过程）</li></ul></li><li>【<strong>网络结构</strong>】基于<strong>Residual Network</strong>（大名鼎鼎ImageNet冠军ResNet）的卷积网络，包含20或40个Residual Block（残差模块），加入<strong>批量归一化</strong>Batch normalisation与<strong>非线性整流器</strong>rectifier non-linearities模块</li></ul><h3 id="改进的强化学习算法"><a href="#改进的强化学习算法" class="headerlink" title="改进的强化学习算法"></a>改进的强化学习算法</h3><p>自对弈强化学习算法（<a href="https://mubu.com/doc/WNKomuDNl" target="_blank" rel="noopener">什么是强化学习</a>，非常建议先看看强化学习的一些基本思想和步骤，有利于理解下面策略、价值的概念，推荐<a href="http://www.cnblogs.com/steven-yang/p/6481772.html" target="_blank" rel="noopener">系列笔记</a>）</p><p>在每一个状态  $\vec s$ ，利用<strong>深度神经网络 $f_\theta$ 预测作为参照</strong>执行MCTS搜索（<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/#MCTS-蒙特卡洛搜索树——走子演算（Rollout）">蒙特卡洛搜索树算法</a>），<strong>MCTS搜索的输出是每一个状态下在不同位置对应的概率 $\boldsymbol \pi$ （注意这里是一个向量，里面的值是MCTS搜索得出的概率值）</strong>，一种策略，从人类的眼光来看，就是看到现在局面，选择下在每个不同的落子的点的概率。如下面公式的例子，下在$(1,3)$位置的概率是<code>0.92</code>，有很高概率选这个点作为<strong>落子点</strong><br>$$\boldsymbol \pi_i = (\underbrace{0.01,0.02,0.92,\ldots}_{\text{361}})$$</p><p>MCTS搜索得出的<strong>落子概率</strong>比 $f_\theta$ 输出的<strong>仅使用神经网络输出的落子概率  $\mathbf p$ </strong>更强，因此，MCTS可以被视为一个强力的<strong>策略改善（policy improvement）过程</strong></p><p>使用基于MCTS提升后的策略（policy）来进行落子，然后用自对弈最终对局的胜者 $z$ 作为价值（Value），作为一个强力的<strong>策略评估（policy evaluation）过程</strong></p><p>并用上述的规则，完成一个<strong>通用策略迭代</strong>算法去更新神经网络的<strong>参数</strong> $\theta$ ，使得神经网络输出的<strong>落子概率和评估值</strong>，即  $f_{\theta}(\mathbf {\vec s}) = (\mathbf p,v)$  更加贴近<strong>能把这盘棋局赢下的落子方式（使用不断提升的MCST搜索落子策略$\boldsymbol \pi$ 和自对弈的胜者 $z$ 作为调整依据）</strong>。并且，在下轮迭代中使用<strong>新的参数</strong>来进行自对弈</p><p>在这里补充<strong>强化学习</strong>的<strong>通用策略迭代</strong>（Generalized Policy Iteration）方法</p><ul><li><p>从策略 $\pi_0$ 开始</p></li><li><p><strong>策略评估（Policy Evaluation）</strong>- 得到策略 $\pi_0$ 的价值 $v_{\pi_0}$ （对于围棋问题，即这一步棋是好棋还是臭棋）</p></li><li><p><strong>策略改善（Policy Improvement）</strong>- 根据价值 $v_{\pi_0}$，优化策略为 $\pi_{0+1}$ （即人类学习的过程，加强对棋局的判断能力，做出更好的判断）</p></li><li><p>迭代上面的步骤2和3，直到找到最优价值 $v_*$ ，可以得到最优策略 $\pi_*$ </p><p><a name="Figure1"></a></p></li></ul><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure1.png" alt="Figure 1" width="600px"></div><blockquote><p>【a图】表示自对弈过程 $s_1,\ldots,s_T$。在每一个位置 $s_t$ ，使用最新的神经网络 $f_\theta$ 执行一次MCTS搜索 $\alpha_\theta$ 。根据搜索得出的概率 $a_t \sim \boldsymbol \pi_i$ 进行落子。终局 $s_T$ 时根据围棋规则计算胜者 $z$<br>$\pi_i$ 是每一步时执行MCTS搜索得出的结果（柱状图表示概率的高低）</p></blockquote><blockquote><p>【b图】表示更新神经网络参数过程。使用原始落子状态 $\vec s_t$ 作为输入，得到此棋盘状态 $\vec s_t$ 下<strong>下一步所有可能落子位置的概率分布</strong> $\mathbf p_t$ 和<strong>当前状态  $\vec s_t$ 下选手的赢棋评估值</strong> $v_t$ </p><p><strong>以最大化 $\mathbf p_t$ 与 $\pi_t$ 相似度和最小化预测的胜者 $v_t$ 和局终胜者 $z$ 的误差来更新神经网络参数 $\theta$ （详见公式1）</strong> ，更新参数 $\theta$ ，下一轮迭代中使用新神经网络进行自我对弈</p></blockquote><p>我们知道，最初的蒙特卡洛树搜索算法是<strong>使用随机</strong>来进行模拟，在AlphaGo1.0中<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/#利用强化学习增强棋力">使用<strong>局面函数</strong>辅助<strong>策略函数</strong>作为落子的参考</a>进行模拟。在<strong>最新的模型中，蒙特卡洛搜索树使用神经网络 $f_\theta$ 的输出来作为落子的参考</strong>（详见下图Figure 2）</p><p>每一条边 $(\vec s,\vec a)$ （每个状态下的落子选择）保存的是三个值：先验概率 $P(\vec s,\vec a)$，访问次数 $N(\vec s,\vec a)$，行动价值 $Q(\vec s,\vec a)$。</p><p>每次<strong>模拟</strong>（模拟一盘棋，直到分出胜负）从根状态开始，每次落子最大化<a href="https://baike.baidu.com/item/UCT%E7%AE%97%E6%B3%95/19451060?fr=aladdin" target="_blank" rel="noopener">上限置信区间</a> $Q(\vec s,\vec a) + U(\vec s,\vec a)$ 其中 $U(\vec s,\vec a) \propto \frac{P(\vec s,\vec a)}{1 + N(\vec s,\vec a)}$ 直到遇到叶子节点 $s’$</p><p>叶子节点（终局）只会被产生一次用于产生<strong>先验概率和评估值</strong>，符号表示即 $f_\theta(s’) = (P(s’,\cdot), V(s’))$ </p><p>模拟过程中<strong>遍历每条边</strong> $(\vec s, \vec a)$ 时更新<strong>记录的统计数据</strong>。访问次数加一 $N(\vec s,\vec a) += 1$；更新行动价值为整个模拟过程的平均值，即  $Q(\vec s, \vec a) = \frac {1}{N(\vec s, \vec a)}\Sigma_{\vec s'|\vec s, \vec a \Rightarrow \vec s'}V(\vec s')$ ，$\vec s’|\vec s, \vec a \Rightarrow \vec s’$ 表示在模拟过程中从 $\vec s$ 走到 $\vec s’$的所有落子行动 $\vec a$<br><a name="Figure2"></a></p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure2.png" alt="Figure 2" width="800px"></div><blockquote><p>【a图】表示模拟过程中遍历时选 $Q+U$ 更大的作为落子点</p><p>【b图】叶子节点 $s_L$ 的扩展和评估。<strong>使用神经网络对状态 $s_L$ 进行评估</strong>，即 $f_\theta(s_L) = (P(s_L,\cdot), V(s_L))$ ，<strong>其中 $\mathbf P$ 的值存储在叶子节点扩展的边中</strong></p><p>【c图】更新<strong>行动价值</strong> $Q$ 等于此时根状态 $\vec s$ 所有子树评估值 $V$ 的平均值</p><p>【d图】当MCTS搜索完成后，<strong>返回这个状态 $\vec s$ 下每一个位置的落子概率</strong> $\boldsymbol \pi$，成比例于 $N^{1/\tau}$（$N$为访问次数，$\tau$ 为控温常数）</p><p>更加具体的详解见：<a href="#搜索算法">搜索算法</a></p></blockquote><p>MCTS搜索可以看成一个自对弈过程中决定每一步如何下的依据，根据神经网络的参数 $\theta$ 和根的状态 $\vec s$ 去计算<strong>每个状态下落子位置的先验概率</strong>，记为 $\boldsymbol \pi  = \alpha_\theta(\vec s)$ ，幂指数<strong>正比于</strong>访问次数 $\pi_{\vec a} \propto N(\vec s, \vec a)^{1/\tau}$，$\tau$ 是温度常数</p><h3 id="训练步骤总结"><a href="#训练步骤总结" class="headerlink" title="训练步骤总结"></a>训练步骤总结</h3><p>使用MCTS下每一步棋，进行自对弈，<strong>强化学习算法（必须了解通用策略迭代的基本方法）的迭代过程中</strong>训练神经网络</p><ul><li>神经网络参数<strong>随机初始化</strong> $\theta_0$</li><li>每<strong>一轮迭代</strong> $i \geqslant 1$ ，都<strong>自对弈一盘</strong>（见<a href="#Figure1">Figure-1a</a>）</li><li>第 $t$ 步：MCTS搜索 $\boldsymbol \pi_t = \alpha_{\theta_{i-1}}(s_t)$ 使用<strong>前一次迭代的神经网络</strong> $f_{\theta_{i-1}}$，根据MCTS结构计算出的<strong>落子策略 $\boldsymbol \pi_t$ 的联合分布进行【采样】再落子</strong></li><li>在 $T$ 步 ：双方都选择跳过；搜索时评估值低于投降线；棋盘无地落子。根据胜负得到<strong>奖励值</strong>Reward $r_T \in \{-1,+1\}$。</li><li>MCTS搜索下至中盘的过程的每一个第 $t$ 步的数据存储为  $\vec s_t,\mathbf \pi_t, z_t$  ，其中 $z_t = \pm r_T$ 表示在第 $t$ 步时的胜者</li><li>同时，从上一步 $\vec s$ 迭代时自对弈棋局过程中产生的数据 $(\vec s, \boldsymbol \pi, z)$ （<strong>$\vec s$ 为训练数据，$\boldsymbol \pi, z$ 为标签</strong>）中<strong>采样</strong>（这里的采样是指选Mini-Batch）来训练网络参数 $\theta_i$，</li><li>神经网络 $f_{\theta_i}(\vec s) = (\mathbf p, v)$以<strong>最大化 $\mathbf p_t$ 与 $\pi_t$ 相似度和最小化预测的胜者 $v_t$ 和局终胜者 $z$ 的误差来更新神经网络参数 $\theta$ </strong>，损失函数公式如下</li></ul>$$l = (z - v)^2 - \boldsymbol {\pi}^T \log(\mathbf p) + c \Vert \theta \Vert ^2 \tag 1$$<blockquote><p>其中 $c$ 是<code>L2</code>正则化的系数</p></blockquote><h2 id="AlphaGo-Zero训练过程中的经验"><a href="#AlphaGo-Zero训练过程中的经验" class="headerlink" title="AlphaGo Zero训练过程中的经验"></a>AlphaGo Zero训练过程中的经验</h2><p>最开始，使用完全的随机落子<strong>训练持续了大概3天</strong>。训练过程中，产生490万场自对弈，每次MCTS大约1600次模拟，每一步使用的时间0.4秒。使用了2048个位置的70万个Mini-Batches来进行训练。</p><p>训练结果如下，图3</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure3.png" alt="Figure 3" width="1200px"></div><blockquote><p>【a图】表示随时间AlphaGo Zero棋力的增长情况，<strong>显示了每一个不同的棋手 $\alpha_{\theta_i}$ 在每一次强化学习迭代时的表现</strong>，可以看到，它的增长曲线非常平滑，没有很明显的震荡，稳定性很好</p><p>【b图】表示的是<strong>预测准确率</strong>基于不同迭代第$i$轮的 $f_{\theta_i}$</p><p>【c图】表示的MSE（平方误差）</p></blockquote><p>在24小时的学习后，无人工因素的强化学习方案就打败了通过模仿人类棋谱的监督学习方法</p><p>为了分别评估结构和算法对结构的影响，得到了，下图4</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure4.png" alt="Figure 4" width="1200px"></div><blockquote><p>【dual-res】表示 AlphaGo Zero（20个模块），策略头和评估值头由一个网络产生<br>【sep-res】表示使用20个残差模块，策略头和评估值头被分成两个不同的网络<br>【dual-conv】表示不用ResNet，使用<strong>12层卷积网</strong>，同时包括策略头和评估值头<br>【sep-conv】表示 AlphaGo Lee（击败李世乭的）使用的网络结构，策略头和评估值头被分成两个不同的网络</p></blockquote><p><a href="#深度神经网结构">头的概念详见网络结构</a></p><h2 id="AlphaGo-Zero学到的知识"><a href="#AlphaGo-Zero学到的知识" class="headerlink" title="AlphaGo Zero学到的知识"></a>AlphaGo Zero学到的知识</h2><p>在训练过程中，AlphaGo Zero可以一步步的学习到一些<strong>特殊的围棋技巧（定式）</strong>，如图5</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure5.png" alt="Figure 5" width="800px"></div><blockquote><p>中间的黑色横轴表示的是学习时间</p><p>【a图】对应的5张棋谱展现的是不同阶段AlphaGo Zero在自对弈过过程中展现出来的<strong>围棋定式</strong>上的新发现</p><p>【b图】展示在右星位上的定式下法的进化。可以看到训练到50小时，<strong>点三三出现了</strong>，但再往后训练，b图中的<strong>第五种定式</strong>高频率出现，在AlphGa Zero看来，这一种形式似乎更加强大</p><p>【c图】展现了前80手自对弈的棋谱伴随时间，明显有很大的提升，在第三幅图中，已经展现出了比较明显的<strong>围</strong>的倾向性</p><p>具体频率图见：<a href="#图5更多细节">出现频率随训练时间分布图</a></p></blockquote><h2 id="AlphaGo-Zero的最终实力"><a href="#AlphaGo-Zero的最终实力" class="headerlink" title="AlphaGo Zero的最终实力"></a>AlphaGo Zero的最终实力</h2><p>之后，最终的AlphaGo Zero 使用40个残差模块，训练接近40天。在训练过程中，产生了2900万盘的自对弈棋谱，使用了310万个Mini-Batches来训练神经网络，每一个Mini-Batch包含了2048个不同的状态。（覆盖的状态数是63亿（$10^{10}$），但和围棋的解空间 $2^{361} \approx 10^{108}$ 相比真的很小，也从侧面反映出，<strong>围棋中大部分选择都是冗余的</strong>。在一个棋盘局面下，根据<strong>先验概率</strong>，估计只有15-20种下法是<strong>值得考虑</strong>的）</p><p>被评测不同版本使用计算力的情况，AlphaGo Zero和AlphaGo Master被部署到有<strong>4个TPUs</strong>的单机上运行（主要用于做<strong>模型的输出预测Inference和MCTS搜索</strong>），AlphaGo Fan（打败樊麾版本）和AlphaGo Lee（打败李世乭版本） <strong>分布式部署到机器群</strong>里，总计有176GPUs和48GPUs（Goolge真有钱）。还加入了<strong>raw network，它是每一步的仅仅使用训练好的深度学习神经网的输出 $\mathbf p_a$ 为依据选择最大概率点来落子，不使用MCTS搜索</strong>（Raw Network裸用深度神经网络的输出已经十分强大，甚至已经接近了AlphaGo Fan）</p><p>下图6展示不同种AlphaGo版本的棋力情况</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure6.png" alt="Figure 6" width="900px"></div><blockquote><p>【a图】随着训练时间棋力的增强曲线</p><p>【b图】裸神经网络得分3055，AlphaGo Zero得分5185，AlphaGo Master得分4858，AlphaGo Lee得分3738，AlphaGo Fan得分3144</p></blockquote><p>最终，AlphaGo Zero 与 AlphaGo Master的<strong>对战比分为89：11</strong>，对局中限制一场比赛在2小时之内（新闻中的零封是对下赢李世乭的AlphaGo Lee）</p><h1 id="论文附录内容"><a href="#论文附录内容" class="headerlink" title="论文附录内容"></a>论文附录内容</h1><p>我们知道，Nature上的文章一般都是很强的可读性和严谨性，每一篇文章的正文可能只有4-5页，但是附录一般会远长于正文。基本所有你的<strong>技术细节疑惑</strong>都可以在其中找到结果，这里值列举一些我自己比较感兴趣的点，如果你是专业人士，甚至想复现AlphaGo Zero，读原文更好更精确</p><h2 id="围棋领域先验知识"><a href="#围棋领域先验知识" class="headerlink" title="围棋领域先验知识"></a>围棋领域先验知识</h2><p>AlphaGo Zero最主要的贡献是<strong>证明了没有人类的先验知识机器也可以在性能上超越人类</strong>。为了阐释清楚这种贡献来自于何处，我们列举一些AlphaGo Zero使用到的<strong>知识</strong>，无论是训练过工程中的还是MCTS搜索中的。如果你想把AlphaGo Zero的思路<strong>应用的到解决其他游戏问题</strong>上，这些内容可能需要被替换</p><h3 id="围棋基本规则"><a href="#围棋基本规则" class="headerlink" title="围棋基本规则"></a>围棋基本规则</h3><p>无论实在MCTS搜索中的模拟还是自对弈的过程，都依赖游戏最终的胜负规则，并且在落子过程中，根据规则还可以<strong>排除一部分不可以落子的点</strong>（比如已经落子的点，无法确认在AlphaGo Zero还有气为零的点不能下这个规则，因为<strong>不记录气的信息</strong>了。但可以<strong>写一个函数来判断</strong>当前局面 $\vec s$ 下<strong>下一步所有可能的落子点</strong>，不一定非得计算这个信息，这个过程可以<strong>完全多线程</strong>）</p><h3 id="Tromp-Taylor规则"><a href="#Tromp-Taylor规则" class="headerlink" title="Tromp-Taylor规则"></a>Tromp-Taylor规则</h3><p>在AlphaGo Zero中使用的是PSK（Positional Superko）禁全同规则（中国，韩国及日本使用），只要这一手（不包括跳过）会导致再现之前的局面，就禁止。</p><h3 id="旋转与镜面"><a href="#旋转与镜面" class="headerlink" title="旋转与镜面"></a>旋转与镜面</h3><p>对于围棋来说，<strong>几个状态 $\vec s$ 在经过旋转或反射后是完全相同的</strong>，这种规律可以用来优化训练数据和MCTS搜索中的子树替换策略。并且因为<strong>贴目（黑棋先下优势贴目7目半）规则</strong>存在，不同状态 $\vec s$ <strong>换颜色也是相同的</strong>。这个规则可以用来使用当前下子的棋手的角度来表示棋盘</p><p>除了以上的三个规则，AlphaGo Zero <strong>没有使用其他任何先验知识</strong>，它仅仅使用深度神经网络对叶子节点进行评估并选择落子位置。它没有使用任何Rollout Policy(这里指的应该是AlphaGo之前版本的快速走子策略)或者树形规则，MCTS搜索也没有使用<strong>其他的标准启发式规则</strong>或者<strong>先验常识规则</strong>去进行增强</p><p>整个算法从随机初始化神经网络参数开始。<a href="">网络结构</a>和<a href="#优化参数">超参数选择</a> 见下一节。MCTS搜索的超参数 $c_{puct}$ 由<a href="http://ieeexplore.ieee.org/document/7352306/?reload=true" target="_blank" rel="noopener">高斯过程优化</a>决定，为了<strong>优化自对弈的性能</strong>，使用了一个神经网络进行<strong>预训练</strong>。对于一个大规模网络的训练过程（40个残差模块，40天），使用一个小规模网络（20个残差模块，3天）来<strong>反复优化MCTS搜索的超参数</strong> $c_{puct}$。整个<strong>训练过程没有任何人工干预</strong></p><h2 id="自对弈训练工作流"><a href="#自对弈训练工作流" class="headerlink" title="自对弈训练工作流"></a>自对弈训练工作流</h2><p>AlphaGo Zero的工作流由三个模块构成，可以异步多线程进行：</p><ul><li>深度神经网络<strong>参数</strong> $\theta_i$ 根据自对弈数据<strong>持续优化</strong></li><li>持续对棋手 $\alpha_{\theta_i}$ <strong>棋力值</strong>进行<strong>评估</strong></li><li>使用表现最好的 $\alpha_{\theta_*}$ 用来产生新的<strong>自对弈数据</strong></li></ul><h3 id="优化参数"><a href="#优化参数" class="headerlink" title="优化参数"></a>优化参数</h3><p>每一个神经网络 $f_{\theta_i}$ 在<strong>64个GPU工作节点</strong>和<strong>19个CPU参数服务器</strong>上进行优化。</p><p><strong>每个工作节点的批次（Batch）大小是32</strong>，每一个<strong>mini-batch大小为2048</strong>。每一个 <strong>mini-batch 的数据</strong>从最近<strong>50万盘</strong>的自对弈棋谱的状态中联合随机采样。</p><p><strong>神经网络权重</strong>更新使用带有<strong>动量（momentum）和学习率退火（learning rate annealing）的随机梯度下降法（SGD）</strong>，损失函数见公式1</p><p>学习率退火比率见下表</p><table><thead><tr><th style="text-align:center">步数（千）</th><th style="text-align:center">强化学习率</th><th style="text-align:center">监督学习率</th></tr></thead><tbody><tr><td style="text-align:center">0-200</td><td style="text-align:center">$10^{-2}$</td><td style="text-align:center">$10^{-1}$</td></tr><tr><td style="text-align:center">200-400</td><td style="text-align:center">$10^{-2}$</td><td style="text-align:center">$10^{-2}$</td></tr><tr><td style="text-align:center">400-600</td><td style="text-align:center">$10^{-3}$</td><td style="text-align:center">$10^{-3}$</td></tr><tr><td style="text-align:center">600-700</td><td style="text-align:center">$10^{-4}$</td><td style="text-align:center">$10^{-4}$</td></tr><tr><td style="text-align:center">700-800</td><td style="text-align:center">$10^{-4}$</td><td style="text-align:center">$10^{-5}$</td></tr><tr><td style="text-align:center">&gt;800</td><td style="text-align:center">$10^{-4}$</td><td style="text-align:center">-</td></tr></tbody></table><p>动量参数设置为<strong>0.9</strong></p><p>方差项和交叉项的权重相同，原因是奖励值被归一化到 $r \in [-1,+1]$</p><p>L2正则化系数设置为 $c = 10^{-4}$</p><p><strong>优化过程每1000个训练步数</strong>执行一次，并使用这个<strong>新模型</strong>来生成下一个Batch的<strong>自对弈棋谱</strong></p><h3 id="评估器"><a href="#评估器" class="headerlink" title="评估器"></a>评估器</h3><p>为了保证生成数据的质量（不至于棋力反而下降），在使用<strong>新的神经网络去生成自对弈棋谱前</strong>，用<strong>现有的最好网络</strong> $f_{\theta_*}$ 来对它进行评估</p><p>【评估神经网络 $f_{\theta_i}$ 的方法】使用  $f_{\theta_i}$ 进行MCTS搜索得出的 $\alpha_{\theta_i}$ 的<strong>性能</strong>（得到 $\alpha_{\theta_i}$ 的MCTS搜索过程中使用 $f_{\theta_i}$ 去估计<strong>叶子节点的位置</strong>和<strong>先验概率</strong>，<a href="#MCTS搜索算法">详见MCTS搜索这一节</a>）</p><p>每一个评估由<strong>400盘对局</strong>组成，MCTS搜索使用<strong>1600次模拟</strong>，将温度参数设为无穷小 $\tau \Rightarrow 0$（目的是为了使用<strong>最多访问次数</strong>的落子下法去下，追求最强的棋力），如果新的选手 $\alpha_{\theta_i}$ 在这400盘中胜率<strong>大于55%</strong>，将这个选手更新为最佳选手 $\alpha_{\theta_*}$ ，用来产生下一轮的自对弈棋谱，并且设为下一轮的比较对象</p><h3 id="自对弈"><a href="#自对弈" class="headerlink" title="自对弈"></a>自对弈</h3><p>通过评估器，现在已经有一个<strong>当前的最好棋手</strong> $\alpha_{\theta_*}$，使用它来<strong>产生数据</strong>。<strong>每次迭代</strong>中， $\alpha_{\theta_*}$ 自对弈<strong>25000盘</strong>，其中每一步MCTS搜索模拟1600次（模拟的每次落子大约<strong>0.4秒</strong>，这里的一次表示的就是MCTS搜索中走到叶子节点，得出胜负结果）</p><p><strong>前30步</strong>，温度 $\tau = 1$，与MCTS搜索中的访问次数成正比，目的是保证<strong>前30步下法的多样性</strong>。在之后的棋局中，温度设为无穷小。并在<strong>先验概率中加入狄利克雷噪声</strong>  $P(\vec s, \vec a) = (1 - \epsilon) p_{\vec a} + \epsilon \eta_{\vec a}$ ，其中 $\eta \sim Dir(0.03)$ 且 $\epsilon = 0.25$。这个噪声保证所有的落子可能都会被尝试，但也可能下出臭棋</p><p><strong>投降阈值</strong> $v_{rerign}$ 自动设为<strong>错误正类率（如果AlphaGo没有投降可以赢的比例）</strong>小于5%，为了测量错误正类(false positives)，在10%的自对弈中关闭投降机制，必须下完</p><h2 id="监督学习"><a href="#监督学习" class="headerlink" title="监督学习"></a>监督学习</h2><p>为了进行对比，我们还<strong>使用监督学习</strong>训练了一个参数为 $\theta_{SL}$ 神经网络。神经网络的结构和AlphaGo Zero相同。数据集 $(\vec s, \boldsymbol \pi, z)$ 随机采样自KGS数据集，人类的落子策略位置即设置 $\pi_a = 1$ 。使用同样的超参数和损失函数，但是平方误差的系数为0.01，学习率图参照上表的第二列。其他超参数和上一节相同</p><p>比AlphaGo1.0z中使用两种网络，使用这种结构的网络，可以有效的防止过拟合。并且实验也证明这个<strong>网络结构的</strong>的效果要<strong>好于之前的网络</strong></p><h2 id="MCTS搜索算法"><a href="#MCTS搜索算法" class="headerlink" title="MCTS搜索算法"></a>MCTS搜索算法</h2><p>这一部分详解的AlphaGo Zero的算法核心示意图<a href="#Figure2">Figure2</a></p><p>AlphaGo Zero使用的是<strong>比AlphaGo1.0中更简单</strong>的<strong>异步策略价值MCTS搜索算法</strong>（APV-MCTS）的变种</p><p>搜索树中的<strong>节点</strong> $\vec s$ 包含一条边 $(\vec s,\vec a)$ 对应所有<strong>可能的落子</strong> $\vec a \in \mathcal A(\vec s)$ ，每一条边中<strong>存储一个数据</strong>，包含下列公式的四个值<br>$$<br>{N(\vec s,\vec a), W(\vec s,\vec a), Q(\vec s,\vec a), P(\vec s,\vec a)}<br>$$</p><blockquote><p>$N(\vec s,\vec a)$ 表示<strong>MCST搜索模拟走到叶子节点的过程中的访问次数</strong><br>$W(\vec s,\vec a)$ 表示<strong>行动价值（由路径上所有的 $v$ 组成）的总和</strong><br>$Q(\vec s,\vec a)$ 表示<strong>行动价值的均值</strong><br>$P(\vec s,\vec a)$ 表示选择这条边的<strong>先验概率</strong>（一个单独的值）</p></blockquote><p><strong>多线程（并行）执行多次模拟</strong>，每一次迭代过程先重复执行1600次Figure 2中的前3个步骤，计算出一个 $\boldsymbol \pi$ ，根据这个向量下现在的这一步棋</p><h3 id="Selcet-Figure2a"><a href="#Selcet-Figure2a" class="headerlink" title="Selcet - Figure2a"></a>Selcet - Figure2a</h3><p>MCTS中的<strong>选择步骤</strong>和之前的版本相似，详见<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/#AlphaGo">AlphaGo之前的详解文章</a>，这篇博文<strong>详细通俗</strong>的解读了这个过程。概括来说，假设<code>L</code>步走到叶子节点，当走第 $t &lt; L$ 步时，根据<strong>搜索树的统计概率落子</strong><br>$$\vec a_t = \operatorname*{argmax}_{\vec a}(Q(\vec s_t, \vec a) + U (\vec s_t, \vec a))$$</p><p>其中计算 $U (\vec s_t, \vec a)$ 使用PUCT算法的变体</p>$$U(\vec s, \vec a) = c_{puct}P(\vec s, \vec a) \frac{\sqrt{\Sigma_{\vec b} N(\vec s, \vec b)}}{1 + N(\vec s, \vec a)}$$<p>其中 $c_{puct}$ 是一个常数。这种搜索策略落子选择<strong>最开始</strong>更趋向于<strong>高先验概率</strong>和<strong>低访问次数</strong>的，但逐渐的会更加趋向于选择有着<strong>更高行动价值</strong>的落子</p><p> $c_{puct}$ 使用<a href="http://ieeexplore.ieee.org/document/7352306/?reload=true" target="_blank" rel="noopener">贝叶斯高斯过程优化</a>来确定</p><h3 id="Expand-and-evaluate-Figure-2b"><a href="#Expand-and-evaluate-Figure-2b" class="headerlink" title="Expand and evaluate - Figure 2b"></a>Expand and evaluate - Figure 2b</h3><p>将叶子节点 $\vec s_L$ 加到<strong>队列</strong>中等待输入至神经网络<strong>进行评估</strong>， $f_\theta(d_i(\vec s_L)) = (d_i(p), v)$ ，其中 $d_i$ 表示一个<strong>1至8的随机数</strong>来表示<strong>双方向镜面</strong>和<strong>旋转</strong>（从8个不同的方向进行评估，如下图所示，围棋棋型在很多情况如果<strong>从视觉角度来提取特征</strong>来说是同一个节点，极大的缩小了搜索空间）</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/DG.svg" alt="Figure 6" width="200px"></div><p>队列中<strong>8个不同位置</strong>组成一个<strong>大小为8的mini-batch</strong>输入到神经网络中<strong>进行评估</strong>。整个<strong>MCTS搜索线程被锁死</strong>直到评估过程完成（这个锁死是保证并行运算间同步）。叶子节点被<strong>展开</strong>(Expand)，每一条边 $(\vec s_L,\vec a)$被初始化为 </p>$${N(\vec s_L,\vec a) = 0 ;\; W(\vec s_L,\vec a) = 0; \; Q(\vec s_L,\vec a) = 0\\P(\vec s_L,\vec a) = p_a}$$<p>这里的 $p_a$ 由将 $\vec s$ <strong>输入神经网络</strong>得出 $\mathbf p$ （包括所有落子可能的概率值 $p_a$），然后将<strong>神经网络的输出值 $v$ 传回（backed up）</strong></p><h3 id="Backup-Figure-2c"><a href="#Backup-Figure-2c" class="headerlink" title="Backup - Figure 2c"></a>Backup - Figure 2c</h3><p>沿着<strong>扩展到叶子节点的路线回溯</strong>将边的统计数据更新（如下列公式所示）</p>$$N(\vec s_t, \vec a_t) = N(\vec s_t, \vec a_t)  + 1 \\W(\vec s_t, \vec a_t)  = W(\vec s_t, \vec a_t)  + v \\Q(\vec s_t, \vec a_t)  = \frac{W(\vec s_t, \vec a_t) }{N(\vec s_t, \vec a_t) }$$<blockquote><p>注解：在 $W(\vec s_t, \vec a_t)$ 的更新中，使用了神经网络的输出 $v$，而最后的价值就是策略评估中的这一状态的价值 $Q(\vec s, \vec a)$</p></blockquote><p>使用虚拟损失（virtual loss）确保每一个线程评估不同的节点。实现方法概括为<strong>把其他节点减去一个很大的值</strong>，避免其他搜索进程走相同的路，<a href="https://link.springer.com/chapter/10.1007/978-3-642-17928-0_4" target="_blank" rel="noopener">详见</a></p><h3 id="Play-Figure-2d"><a href="#Play-Figure-2d" class="headerlink" title="Play - Figure 2d"></a>Play - Figure 2d</h3><p>完成MCTS搜索（并行重复1-3步1600次，花费0.4s）后，AlphaGo Zero才从 $\vec s_0$ 状态下走出第一步 $\vec a_0$，与访问次数成幂指数比例</p>$$\boldsymbol \pi(\vec a|\vec s_0) = \frac {N(\vec s_0,a)^{1/\tau}}{\Sigma_{\vec b} N(\vec s_0, \vec b)^{1/\tau}}$$<p>其中 $\tau$ 是一个温度常数用来控制探索等级（level of exploration）。它是热力学玻尔兹曼分布的一种变形。温度较高的时候，分布更加<strong>均匀（走子多样性强）</strong>；温度降低的时候，分布更加<strong>尖锐（多样性弱，追求最强棋力）</strong></p><p>搜索树会在接下来的<strong>自对弈走子</strong>中<strong>复用</strong>，如果孩子节点和落子的位置吻合，它就成为新的根节点，保留子树的所有统计数据，同时丢弃其他的树。<strong>如果根的评价值和它最好孩子的评价值都低于 $v_{resign}$ AlphaGo Zero就认输</strong></p><h3 id="MCTS搜索总结"><a href="#MCTS搜索总结" class="headerlink" title="MCTS搜索总结"></a>MCTS搜索总结</h3><p>与之前的版本的MCTS相比，<strong>AlphaGo Zero最大的不同是没有使用走子网络（Rollout），而是使用一个整合的深度神经网络</strong>；叶子节点总会被扩展，而不是动态扩展；每一次MCTS搜索线程需要<strong>等待</strong>神经网络的评估，之前的版本性能评估（evaluate）和返回（backup）是异步的；没有树形策略</p><p>至于很重要的一个关键点<strong>：每一次模拟的中的叶子节点<code>L</code>的深度</strong></p><p>【个人分析】是由时间来决定，根据论文提到的数据，<strong>0.4秒执行1600次模拟</strong>，<strong>多线程模拟</strong>，在<strong>时限内</strong>能走到的深度有多深就是这个<strong>叶子节点</strong>。可以类比为AlphaGo 1.0中的局面函数（用来判断某个局面下的胜率的），也就是说不用模拟到终盘，在<strong>叶子节点的状态</strong>下，使用深度神经网的输出 $v$ 来判断现在落子的棋手的胜率</p><h2 id="网络结构-1"><a href="#网络结构-1" class="headerlink" title="网络结构"></a>网络结构</h2><h3 id="网络输入数据"><a href="#网络输入数据" class="headerlink" title="网络输入数据"></a>网络输入数据</h3><p>输入数据的维度 <code>19×19×17</code>，其中存储的两个值0/1，$X_t^i = 1$表示这个交叉点有子，$0$ 表示这个交叉点没有子或是对手的子或 $t&lt;0$。使用 $Y_t$ 来记录对手的落子情况。</p><p>从状态 $\vec s$ 开始，记录了倒退回去的15步，双方棋手交替。最后一个<code>19×19</code>的存储了前面16步每一个状态对应的棋子的黑白颜色。1黑0白</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/structure.png" alt="Figure 6" width="300px"></div><p>【个人理解】为了<strong>更加直观的解释</strong>，如果是上面的局部棋盘状态 $\vec s$，接下里一步是黑棋落子，走了4步，那么<strong>输入数据</strong>是什么样的呢？</p>$$\mathbf X_2=  \begin{pmatrix}& \vdots & \vdots & \\ \cdots & 0 & 1 & \cdots \\\cdots & 1 & 0 & \cdots \\ & \vdots & \vdots &\end{pmatrix} \mathbf Y_2=  \begin{pmatrix}& \vdots & \vdots & \\ \cdots & 1 & 0 & \cdots \\\cdots & 0 & 1 & \cdots \\ & \vdots & \vdots &\end{pmatrix} \\\mathbf X_1=  \begin{pmatrix}& \vdots & \vdots & \\ \cdots & 0 & 0 & \cdots \\\cdots & 1 & 0 & \cdots \\ & \vdots & \vdots &\end{pmatrix}\mathbf Y_1=  \begin{pmatrix}& \vdots & \vdots & \\ \cdots & 0 & 0 & \cdots \\\cdots & 0 & 1 & \cdots \\ & \vdots & \vdots &\end{pmatrix} \\\mathbf C =  \begin{pmatrix}& \vdots & \vdots & \\ \cdots & 1 & 0 & \cdots \\\cdots & 0 & 1 & \cdots \\ & \vdots & \vdots &\end{pmatrix}$$<p>同理，如果有8步的话，也就是16个对应的 $X$ 和 $Y$ 加一个 $C$ 来表示现在的棋盘状态（注意，这里面包含的历史状态）。这里的数据类型是Boolean，非常高效，并且表达的信息也足够</p><p>至于使用<strong>八步</strong>的原因。个人理解，一方面是为了<strong>避免循环劫</strong>，另一方面，选择八步也可能是<strong>性能和效果权衡的结果</strong>（从感知上来说当然信息记录的越多神经网络越强，奥卡姆剃刀定理告诉我们，简单即有效，一味的追求复杂，并不是解决问题的最佳途径）</p><h3 id="深度神经网结构"><a href="#深度神经网结构" class="headerlink" title="深度神经网结构"></a>深度神经网结构</h3><p>整个残差塔使用单独的卷机模块组成，其中包含了19或39个残差模块，详细结构参数如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/ResNet.svg" alt="Figure 6" width="800px"></div><p>过了深度卷积神经网络后接<strong>策略输出</strong>与<strong>评估值输出</strong>，详细结构参数如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/VPoutput.svg" alt="Figure 6" width="800px"></div><h2 id="数据集"><a href="#数据集" class="headerlink" title="数据集"></a>数据集</h2><p><a href="http://gokifu.com/" target="_blank" rel="noopener">GoKifu数据集</a>，和<a href="https://u-go.net/gamerecords/" target="_blank" rel="noopener">KGS数据集</a></p><h2 id="图5更多细节"><a href="#图5更多细节" class="headerlink" title="图5更多细节"></a>图5更多细节</h2><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure5a.png" alt="Figure 5a中每种定式出现的频率图" title="">                </div>                <div class="image-caption">Figure 5a中每种定式出现的频率图</div>            </figure><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/Figure5b.png" alt="Figure 5b中每种定式出现的频率图" title="">                </div>                <div class="image-caption">Figure 5b中每种定式出现的频率图</div>            </figure><h1 id="总结与随想"><a href="#总结与随想" class="headerlink" title="总结与随想"></a>总结与随想</h1><p><strong>AlphaGo Zero = 启发式搜索 + 强化学习 + 深度神经网络</strong>，你中有我，我中有你，互相对抗，不断自我进化。使用<strong>深度神经网络的训练作为策略改善</strong>，<strong>蒙特卡洛搜索树作为策略评价</strong>的<strong>强化学习算法</strong></p><p>之后提出一些我在看论文时带着的问题，最后给出我仔细看完每一行论文后得出的回答，如有错误，请批评指正！</p><h2 id="问题与个人答案"><a href="#问题与个人答案" class="headerlink" title="问题与个人答案"></a>问题与个人答案</h2><h3 id="训练好的Alpha-Zero在真实对弈时，在面对一个局面时如何决定下在哪个位置？"><a href="#训练好的Alpha-Zero在真实对弈时，在面对一个局面时如何决定下在哪个位置？" class="headerlink" title="训练好的Alpha Zero在真实对弈时，在面对一个局面时如何决定下在哪个位置？"></a>训练好的Alpha Zero在真实对弈时，在面对一个局面时<strong>如何决定下在哪个位置</strong>？</h3><p><a href="#评估器">评估器</a>的落子过程即最终对弈时的落子过程（自对弈中的落子就是真实最终对局时的落子方式）：使用<strong>神经网络的输出</strong> $\mathbf p$ <strong>作为先验概率</strong>进行MCTS搜索，每步1600次（最后应用的版本可能和<strong>每一步的给的时间</strong>有关）模拟，前30步<strong>采样落子</strong>，剩下棋局使用最多访问次数来落子，得到 $\boldsymbol \pi$ ，然后选择落子策略中最大的一个位置落子</p><h3 id="AlphaGo-Zero的MCTS搜索算法和和上个版本的有些什么区别？"><a href="#AlphaGo-Zero的MCTS搜索算法和和上个版本的有些什么区别？" class="headerlink" title="AlphaGo Zero的MCTS搜索算法和和上个版本的有些什么区别？"></a>AlphaGo Zero的<strong>MCTS搜索算法</strong>和和上个版本的<strong>有些什么区别</strong>？</h3><p><a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/#MCTS-蒙特卡洛搜索树——走子演算（Rollout）">最原始MCTS解析</a>，<a href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/#AlphaGo">AlphaGo Lee加上策略函数和局面函数改进后的MCTS解析</a></p><p>对于AlphaGo Zero来说</p><ul><li>最大的区别在于，<strong>模拟过程</strong>中依据神经网络的输出 $\mathbf p$ 的概率分布<strong>采样</strong>落子。<strong>采样是关键词</strong>，首先采样保证一定的随机特性，不至于下的步数过于集中，其次，如果模拟的盘数足够多，那这一步就会越来越强</li><li>其次，在<a href="https://charlesliuyx.github.io/2017/10/18/深入浅出看懂AlphaGo元/#Backup-Figure-2c">返回（Bakcup）部分</a>每一个点的价值（得分），使用了神经网络的输出 $v$。这个值也是<strong>策略评估</strong>的重要依据</li></ul><h3 id="AlphaGo-Zero-中的策略迭代法是如何工作的？"><a href="#AlphaGo-Zero-中的策略迭代法是如何工作的？" class="headerlink" title="AlphaGo Zero 中的策略迭代法是如何工作的？"></a>AlphaGo Zero 中的策略迭代法是如何工作的？</h3><p>策略迭代法（Policy Iteration）是强化学习中的一种算法，简单来说：以某种<strong>策略</strong>（ $\pi_0$ ）开始，计算当前策略下的<strong>价值函数</strong>（ $v_{\pi_0}$ ）；然后<strong>利用这个价值函数，找到更好的策略</strong>（<strong>E</strong>valuate和<strong>I</strong>mprove）；接下来再用这个<strong>更好的策略</strong>继续前行，更新价值函数……这样经过若干轮的计算，如果一切顺利，我们的策略会收敛到<strong>最优的策略</strong>（ $\pi_*$ ），问题也就得到了解答。</p>$$\pi_0 \xrightarrow{E} v_{\pi_0} \xrightarrow{I} \pi_1 \xrightarrow{E} v_{\pi_1} \xrightarrow{I} \pi_2 \xrightarrow{E} \cdots \xrightarrow{I} \pi_* \xrightarrow{E} v_*$$<p>对于AlphaGo Zero来说，<a href="#改进的强化学习算法">详细可见论文</a>，简单总结如下</p><ul><li>策略评估过程，即使用MCTS搜索<strong>每一次模拟</strong>的<strong>对局胜者</strong>，胜者的<strong>所有落子</strong>（$\vec s$）都获得<strong>更好的评估值</strong></li><li>策略提升过程，即使用MCTS搜索返回的<strong>更好策略</strong> $\boldsymbol \pi$</li><li>迭代过程，即神经网络输出 $\mathbf p$ 和 $v$ 与策略评估和策略提升返回值的对抗（即神经网络的训练过程）</li></ul><p>总的来说，有点像一个嵌套过程，MCST算法可以用来解决围棋问题，这个深度神经网络也可以用来解决围棋问题，而AlphaGo Zero将两者<strong>融合</strong>，你中有我，我中有你，不断对抗，不对自我进化</p><h3 id="AlphaGo-Zero-最精彩的部分哪部分？"><a href="#AlphaGo-Zero-最精彩的部分哪部分？" class="headerlink" title="AlphaGo Zero 最精彩的部分哪部分？"></a>AlphaGo Zero 最精彩的部分哪部分？</h3>$$l = (z - v)^2 - \boldsymbol {\pi}^T \log(\mathbf p) + c \Vert \theta \Vert ^2$$<p>毫无悬念的，我会选择这个漂亮的公式，看懂公式<strong>每一项的来历，即产生的过程</strong>，就读懂了AlphaGo Zero。这个公式<strong>你中有我，我中有你</strong>，这是一个完美的对抗，完美的自我进化</p><p>第二我觉得很精彩的点子是将<strong>深度神经网络作为一个模块</strong>嵌入到了<strong>强化学习的策略迭代法中</strong>。最关键的是，<strong>收敛速度快，效果好，解决各种复杂的局面</strong>（比如一个关于围棋棋盘的观看角度可以从八个方向来看的细节处理的很好，又如神经网络的输入状态选择了使用<strong>历史八步</strong>）</p><h2 id="随想和评论"><a href="#随想和评论" class="headerlink" title="随想和评论"></a>随想和评论</h2><p><a href="https://zhuanlan.zhihu.com/p/30325845?group_id=905063580597968896" target="_blank" rel="noopener">量子位汇集各家评论</a></p><ul><li>不是<strong>无监督学习</strong>，带有明显胜负规则的强化学习是<strong>强监督</strong>的范畴</li><li>无需<strong>担心快速的攻克其他领域</strong>，核心还是<strong>启发式搜索</strong></li><li><strong>模型简约漂亮，充满整合哲学的优雅</strong>，可怕的是效果和效率也同样极高</li><li>AlphaGo项目在经历了<strong>把书读厚</strong>的过程后，已经取得了瞩目的成就依旧不满足现状，现通过AlphaGo Zero<strong>把书读薄</strong>，简约而不简单，大道至简，九九归一，已然位列仙班了</li></ul><p>随着AlphaGo Zero的归隐，DeepMind已经正式转移精力到其他的任务上了。期待这个天才的团队还能搞出什么大新闻！</p><p>对于围棋这项运动的影响可能是：以后的学围棋手段会发生变化，毕竟世界上能复现AlphaGo Zero的绝对很多，那么AlphaGo Zero的实力那就是棋神的感觉，向AlphaGo Zero直接学习不是更加高效嘛？另，围棋受到的关注也应该涨了一波，是利好</p><p>感觉强化学习会越来越热，对于和环境交互这个领域，强化学习更加贴近于人类做决策的学习方式。个人预测，强化学习会在未来会有更多进展！AlphaGo Zero 可能仅仅是一个开头</p><p>以上！鞠躬！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】21min - 24min 10999字&lt;br&gt;【内容简介】&lt;a href=&quot;https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/&quot;&gt;AlphaGo1.0详解链接&lt;/a&gt;，这篇AlphaGo Zero论文原文超详细翻译，并且总结了AlphaGo Zero的算法核心思路，附带收集了网上的相关评论&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="AlphaGo" scheme="https://charlesliuyx.github.io/tags/AlphaGo/"/>
    
      <category term="Deep Learning" scheme="https://charlesliuyx.github.io/tags/Deep-Learning/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】线性代数中的转置正交正规正定</title>
    <link href="https://charlesliuyx.github.io/2017/10/17/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E4%B8%AD%E7%9A%84%E6%AD%A3%E4%BA%A4%E6%AD%A3%E8%A7%84%E6%AD%A3%E5%AE%9A%E8%BD%AC%E7%BD%AE/"/>
    <id>https://charlesliuyx.github.io/2017/10/17/【直观详解】线性代数中的正交正规正定转置/</id>
    <published>2017-10-17T03:01:27.000Z</published>
    <updated>2019-09-30T06:55:00.686Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】20min 4589 words<br>【内容简介】从<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">【直观理解】线性代数的本质</a>笔记出发，继续讨论几个线性代数中的概念，正交，正规，正定及转置的直观解释。旨在能帮助读者在看完后不会忘记什么是正交矩阵，什么是正规矩阵，转置部分进行了深入挖掘，希望找出一些几何直观的解释<br><a id="more"></a></p><p>在之前的<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">【直观理解】线性代数的本质</a>的笔记中，详细讨论了<strong>特征值与特征向量的几何直观意义</strong></p><p>起初，研究线性代数，也是因为深入了解矩阵（变换）对机器学习中的很多<strong>优美公式的推导和理解</strong>有帮助。上篇笔记中，3B1B团队的讲解内容中没有涉及几个线性代数中的概念，且这些概念在做矩阵分解时会被用到。以<strong>上一篇笔记中的直观理解为基础</strong>（矩阵 = 变换）在这里做一个整理和记录</p><h1 id="正交矩阵"><a href="#正交矩阵" class="headerlink" title="正交矩阵"></a>正交矩阵</h1><p>可能很多人已经有一个概念：正交（Orthogonal） = 垂直。但我们知道，正交的一定垂直，垂直的不一定正交（比如空间中两个<strong>不相交直线垂直</strong>）。提及垂直，首先出现你脑海中的特点是什么呢？我想是勾股数 $a^2 + b^2 = c^2$ ， 还有 $\cos (\frac {\pi}{2}) = 1$  </p><p>那什么是正交矩阵呢？在讲这个概念之前，变换中有一种特殊变换：<strong>旋转变换</strong>。这种变换除了原点外没有特征向量，特征值恒为1，不对网格进行伸缩。或者说，这个变换<strong>保证了新列空间内和原列空间内所有对应向量的长度不变</strong></p><p>三维情况下，单位矩阵（对角线为1，其他为0，即基向量构成的矩阵）$\mathbf E = \left [ \begin{smallmatrix} 1 &amp; 0 &amp; 0 \\ 0 &amp; 1 &amp; 0 \\ 0&amp;0&amp;1 \end{smallmatrix} \right ]$   如下图所示</p><p><div align="center"><img src="//charlesliuyx.github.io/2017/10/17/【直观详解】线性代数中的正交正规正定转置/Rotate.png" alt="" width="400px"><img src="//charlesliuyx.github.io/2017/10/17/【直观详解】线性代数中的正交正规正定转置/Rotate.gif" alt="" width="400px"></div><br>$\mathbf E$ 中的三个基向量分别记为 $\mathbf {X_a}= \left [ \begin{smallmatrix} 1 \\ 0 \\ 0 \end{smallmatrix} \right ] $ ，$\mathbf {Y_a} = \left [ \begin{smallmatrix} 0 \\ 1 \\ 0 \end{smallmatrix} \right ] $，$\mathbf {Z_a} = \left [ \begin{smallmatrix} 0 \\ 0 \\ 1 \end{smallmatrix} \right ] $ ，用下标<code>a</code>来表示。之后对这个矩阵 $\mathbf E$ 应用一个旋转变换，以 $(0,-0.6,0.8)$ 为旋转轴，转90°。得到三个新的向量，用下标<code>b</code>来表示，记为 $\mathbf {X_b}= \left [ \begin{smallmatrix} 0 \\ 0.8 \\ 0.6 \end{smallmatrix} \right ] $ ，$\mathbf {Y_b} = \left [ \begin{smallmatrix} -0.8 \\ -0.36 \\ 0.48 \end{smallmatrix} \right ] $，$\mathbf {Z_b} = \left [ \begin{smallmatrix} -0.6 \\ 0.48 \\ -0.64 \end{smallmatrix} \right ] $ </p><p>根据基变换原理，易得<strong>旋转变换的矩阵表达式</strong> $\mathbf R = \left [ \begin{smallmatrix} 0&amp;-0.8 &amp;-0.6 \\ 0.8&amp;-0.36&amp;0.48 \\ 0.6&amp;0.48&amp;-0.64 \end{smallmatrix} \right ]$  计算得特征向量为 $(0,-0.75,1)$，发现这条向量即旋转轴！</p><p>此时我们考虑从 $\mathbf R$矩阵下变到 $\mathbf E$的变换矩阵是多少，即求 $\mathbf R$ 矩阵的逆</p>$$\mathbf R^{-1} = \left [ \begin{matrix} 0 & 0.8 & 0.6 \\-0.8 & -0.36 & 0.48 \\-0.6 & 0.48 & -0.64 \end{matrix}\right]$$<p>观察形式大家就可以发现一个有趣的特点 $\mathbf R^{-1} = \mathbf R^T$</p><p><strong>正交矩阵有一个几何直观的特点，表示一个旋转变换，并且矩阵的逆和矩阵的转置相等</strong></p><h1 id="正定与半正定矩阵"><a href="#正定与半正定矩阵" class="headerlink" title="正定与半正定矩阵"></a>正定与半正定矩阵</h1><p>根据<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/#特征向量与特征值">特征值和特征向量</a>这篇笔记中的内容，我们知道特征值是对一个变换（矩阵）特性的<strong>有力表征</strong>，公式  $\mathbf A \mathbf{\vec v} = \lambda \mathbf{\vec v}$  表示了<strong>变换中被留在张成空间内的向量就是特征向量</strong>的符号表达，其中 $\vec v$ 是特征向量，$\lambda$ 即特征值</p><p>我们对上式进行一些数学恒等变换，左乘 $\vec v^T$，得到</p>$$\vec v^T \mathbf A \vec v = \vec v^T \lambda \vec v = \lambda \vec v^T \vec v \tag{2-1}$$<p>此时我们会发现一些巧合，先来看看正定矩阵的正规定义：若一个 <code>n×n</code>的矩阵 $\mathbf M$ 是<strong>正定的</strong>，当且仅当队友所有的非零实系数的向量 $\vec v$，都有 $\vec v^T \mathbf M \vec v &gt; 0$</p><p>我们暂时不考虑复数情况（在机器学习预见复数域的内容较少），结合上面的二公式，发现保证 $\vec v^T \mathbf M \vec v &gt; 0$ 即使得 $\lambda \vec v^T \vec v&gt;0$，其中 $\vec v^T \vec v$一定大于等于0（由于 $\vec v$ 是一个<code>1×n</code>的向量，转置进行矩阵相乘实际效果<strong>计算元素的平方和</strong>），所以可以推出即<strong>正定矩阵就是使得特征值大于0</strong></p><p>再回到正定矩阵的定义公式 $\vec x^T \mathbf M \vec x &gt; 0$，我们已经有深刻的理解 $\mathbf M \vec x$ 表示对向量 $\vec x$ 进行<strong>变换</strong>，记变换后的向量为 $\vec y = \mathbf M \vec x$  ，则我们可以把正定矩阵的公式写成</p>$$\vec x^T \vec y > 0 \tag{2-2}$$<p>这个公式是不是很熟悉呢？它是<strong>两个向量的内积</strong>，对于内积，有公式：</p>$$\cos(\theta) = \frac{\vec x^T \vec y}{\Vert \vec x \Vert * \Vert \vec y \Vert} \hat {\jmath}$$<p>$\Vert \vec x \Vert \; \Vert \vec y \Vert$ 表示 $\vec x$ 和 $\vec y$的长度，$\theta$ 是它们之间的夹角。根据2-2式，可以得到 $\cos(\theta) &gt; 0$，即它们之间的夹角<strong>小于90度</strong> </p><p>总结：如果说一个矩阵正定，则表示，一个向量<strong>经过此矩阵变换后的向量</strong>与原向量<strong>夹角小于90度</strong></p><p>当然，加一个【半】字，是指这个小于变成<strong>小于等于</strong></p><h1 id="正规矩阵"><a href="#正规矩阵" class="headerlink" title="正规矩阵"></a>正规矩阵</h1><p>矩阵中还有一张<strong>形状特殊</strong>的矩阵，被称为<strong>正规矩阵</strong>，定义为：如果矩阵 $\mathbf A$ 满足 $\mathbf A^T \mathbf A = \mathbf A \mathbf A^T$</p><p>更多的，如果矩阵 $\mathbf U$ 满足 $\mathbf U^T \mathbf U = \mathbf U \mathbf U^T = \mathbf I$，其中 $\mathbf I$ 是单位矩阵，则称矩阵 $\mathbf U$ 为<strong>酉矩阵</strong></p><p>从变换的角度来看<strong>正规矩阵</strong>，先做一个变换 $\mathbf A$ 再做一个变换 $\mathbf A^T$。并且交换两个矩阵的位置，最终结果相同</p><h1 id="矩阵的转置"><a href="#矩阵的转置" class="headerlink" title="矩阵的转置"></a>矩阵的转置</h1><h2 id="什么是转置"><a href="#什么是转置" class="headerlink" title="什么是转置"></a>什么是转置</h2><p>在前面的三个描绘矩阵不同矩阵的概念中，多次使用了<strong>转置</strong>的概念。从<strong>矩阵形态</strong>的角度看，转置是将 $\mathbf A$ 的所有元素关于一条从第1行第1列元素出发的<strong>向右下方45度的射线</strong>作<strong>镜面翻转</strong>（下面的动图更加直观）</p><p><img src="//charlesliuyx.github.io/2017/10/17/【直观详解】线性代数中的正交正规正定转置/Matrix_transpose.gif" alt="" width="150"></p><p>那么，从<strong>矩阵是表示变换的集合</strong>角度如何理解转置呢？</p><h2 id="为什么转置"><a href="#为什么转置" class="headerlink" title="为什么转置"></a>为什么转置</h2><p>试图从另一个角度来理解其实也是为了回答另一个问题：<strong>为什么要定义转置这种操作呢</strong>？你可能会说，这就是一个【<strong>对角线镜像对称交换的操作</strong>】，从形式上来理解对一般人<strong>已完全足够</strong>。</p><p>这里要深究的原因也只是为了<strong>克服</strong>在学习机器学习的过程中，公式里若出现<strong>转置符号</strong>，无法完全理解带来的生涩感（俗称强迫症），对博主来说，一个直接动机源于SVD算法</p><p>首先，考虑矩阵的列向量有具体的<strong>列空间</strong>的含义（对应 $\hat {\imath}$ 和 $\hat {\jmath}$ 的变换位置），若进行转置操作，列空间的性质会被<strong>完全破坏</strong>，或者说，<strong>转换成了一个新的列空间</strong></p><h3 id="非方阵"><a href="#非方阵" class="headerlink" title="非方阵"></a>非方阵</h3><p>考虑矩阵转置的几何含义是无意义的，或者说，对出现过矩阵转置的公式的<strong>进一步理解</strong>是没有帮助的</p><p>特别的，如果是向量形式（1×n的矩阵），转置很多时候出现，是为了<strong>进行二次型运算</strong>（即平方运算），设  $\mathbf x = \{x_1, x_2,\ldots, x_n\}$  是一个1×n的矩阵</p><blockquote><p>很多机器学习的教材中这里会是<strong>列矩阵</strong>，因为要切合列空间的概念。对于机器学习来说，这里的 $x_1$ 代表的数据的特征维度 </p></blockquote><p>计算二次型：  $\mathbf x \mathbf x^T = x_1^2 + x_2^2 + \ldots + x_n^2$ ，记过为<strong>一个数</strong>，表示的是<strong>距离</strong></p><h3 id="方阵"><a href="#方阵" class="headerlink" title="方阵"></a>方阵</h3><p>从<strong>列空间</strong>的概念，转置是<strong>一种非常特殊的旋转</strong>。这种旋转结合了横向镜面等特性，详细可以参看下图</p><p>从这幅图可以看出，如果想从几何变换的角度（类似<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">3b1b的方法</a>）来理解转置相当困难。此时，需要考虑换一种思考角度，<strong>性质</strong>和<strong>数学计算</strong>（这可能也是解决一个数学问题最常用的两种手段，性质寻找共性，并推广演绎，数学计算导出同样问题的不同表现形式，并总结规律）</p><h4 id="性质找规律"><a href="#性质找规律" class="headerlink" title="性质找规律"></a>性质找规律</h4><p>首先先用一个简单的例子，二维可视化，并寻找规律，得到下面图像</p><p><img src="//charlesliuyx.github.io/2017/10/17/【直观详解】线性代数中的正交正规正定转置/Transpose.jpg" alt="" width="600"></p><p>观察得到，和旋转有一定的关系的，但是其实这个几何意义已经十分抽象了，为了追根之底，从数学的角度进行一些更有意思的探究</p><h4 id="数学计算"><a href="#数学计算" class="headerlink" title="数学计算"></a>数学计算</h4><p>为了发掘 $\mathbf A$ 和 $\mathbf A^T$ 之间的关系，我们可以设有<strong>转换矩阵</strong> $\mathbf T$，其描述了从 $\mathbf A$ 到 $\mathbf A^T$ 的<strong>变换</strong>，写成公式为：<br>$$<br>\mathbf T \mathbf A = \mathbf A^{T} \tag 1<br>$$<br>同时我们假设 $\mathbf A$ 是一个2×2的矩阵，如下所示所示（<strong>列的不同</strong>为字母的不同a和b，<strong>行的不同</strong>为小标的1和2）</p>$$\mathbf A=        \begin{bmatrix}        a_{1} & b_{1} \\        a_{2} & b_{2} \\        \end{bmatrix}         \quad        \mathbf A^T=        \begin{bmatrix}        a_{1} & a_{2} \\        b_{1} & b_{2} \\        \end{bmatrix}         \tag{2}$$<p>保证变换不会压缩维度，即 $det(\mathbf A) \neq 0$，利用（1）式，未知数，消元计算后，可以算出 $\mathbf T$，其中  $det(\mathbf A) = a_1b_2 - b_1a_2$ </p>$$\mathbf T = \frac{1}{det(\mathbf A)}        \begin{bmatrix}        a_{1} b_{2} - a_{2}^2 & a_{1} (a_{2} - b_{1})  \\        b_{2} (b_{1} - a_{2}) & a_{1} b_{2} - b_{1}^2 \\        \end{bmatrix} \tag{3}$$<p>前面的 $\frac{1}{det(\mathbf A)}$ 作为一个常数，保证了 $det(\mathbf A^{T})=det(\mathbf A)$，将后面关键的变换矩阵写成</p>$$\mathbf T' =         \begin{bmatrix}        a_{1} b_{2} - a_{2}^2 & a_{1} (a_{2} - b_{1})  \\        b_{2} (b_{1} - a_{2}) & a_{1} b_{2} - b_{1}^2 \\        \end{bmatrix} \tag {4}$$<p>把 （4）式进行整理，也写成矩阵相乘的形式，得到下式</p>$$\mathbf T'=\begin{bmatrix}\begin{bmatrix}a_{1} & a_{2} \\\end{bmatrix}  \begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & \begin{bmatrix}a_{1} & a_{2} \\\end{bmatrix}  \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix} \\\begin{bmatrix}b_{1} & b_{2} \\\end{bmatrix}  \begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & \begin{bmatrix}b_{1} & b_{2} \\\end{bmatrix}  \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix}\\\end{bmatrix} \tag{5}$$<p>对于 $\mathbf A$ 的列空间来说，有  $\mathbf a =   \left [ \begin{smallmatrix} a_1 \\ a_2  \end{smallmatrix} \right ]$  和  $\mathbf b =   \left [ \begin{smallmatrix} b_1 \\ b_2  \end{smallmatrix} \right ]$  观察到 $\mathbf T$ 中包含列空间的两个项，把 $\mathbf T’$ 整理得</p>$$B'=\begin{bmatrix}{\mathbf a}^{T}\begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & {\mathbf a}^{T} \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix} \\{\mathbf b}^{T}  \begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & {\mathbf b}^{T}   \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix}\\\end{bmatrix}=\begin{bmatrix}{\mathbf a}\cdot\begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & {\mathbf a}\cdot \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix} \\{\mathbf b}\cdot \begin{bmatrix}b_{2} \\ -a_{2} \\\end{bmatrix} & {\mathbf b}\cdot  \begin{bmatrix}-b_{1} \\ a_{1} \\\end{bmatrix}\\\end{bmatrix} \tag{6}$$<p>令  $\mathbf c = \begin{bmatrix}b_{2} \\ -a_{2} \\ \end{bmatrix} $   $\mathbf d = \begin{bmatrix}-b_{1} \\ a_{1} \\ \end{bmatrix} $ ，观察后发现规律：</p><ul><li>$\mathbf c$ 变换到 $\mathbf A^T_{\hat {\jmath}}$ 为<strong>逆时针旋转90°</strong></li><li>$\mathbf d$ 变换到 $\mathbf A^T_{\hat {\imath}}$ 为<strong>顺时针旋转90°</strong></li></ul><p>$\mathbf c$ 和 $\mathbf d$ 组成的列空间设为 $\mathbf C$，写成公式为</p>$$\mathbf C = \begin{bmatrix}\mathbf c & \mathbf d\end{bmatrix} = \begin{bmatrix} b_2 & -b_1 \\ -a_2 & a_1\end{bmatrix} \tag{7}$$<p>将（7）式左乘 $\mathbf A$ 得到下式</p>$$\mathbf A\mathbf C= \begin{bmatrix}a_{1}  & b_{1}  \\a_{2} & b_{2} \\\end{bmatrix}\cdot\begin{bmatrix}b_{2}  & -b_{1}  \\-a_{2} & a_{1} \\\end{bmatrix}=\begin{bmatrix}det(\mathbf A)  & 0  \\0 & det(\mathbf A) \\\end{bmatrix} =det(\mathbf A) \mathbf I \tag{8}$$<p>再将（8）式所有乘以 $\mathbf A$ 的逆矩阵 $\mathbf A^{-1}$ 得到<br>$$<br>\mathbf C = \mathbf A^{-1} det(\mathbf A) \tag{9}<br>$$<br><strong>所以，构造的这个 $\mathbf C$ 矩阵和 $\mathbf A$ 矩阵的逆矩阵有关</strong></p><p>另外，（4）式，即 $\mathbf T’$ 矩阵还可以被写成</p>$$\mathbf T'=\begin{bmatrix}\begin{bmatrix}\begin{bmatrix}a_{1}  & b_{1}  \\a_{2} & b_{2} \\\end{bmatrix}& \begin{bmatrix}b_{2} \\-a_{2} \\\end{bmatrix}\end{bmatrix}\\\begin{bmatrix}\begin{bmatrix}a_{1}  & b_{1}  \\a_{2} & b_{2} \\\end{bmatrix}& \begin{bmatrix}-b_{1} \\a_{1} \\\end{bmatrix}\end{bmatrix}\end{bmatrix}=\begin{bmatrix}\begin{bmatrix}\begin{bmatrix}a_{1}  & b_{1}  \\a_{2} & b_{2} \\\end{bmatrix}& \mathbf c\end{bmatrix}\\\begin{bmatrix}\begin{bmatrix}a_{1}  & b_{1}  \\a_{2} & b_{2} \\\end{bmatrix}& \mathbf d\end{bmatrix}\end{bmatrix} \tag{10}$$<p>或者可以写成</p>$$\begin{align}\mathbf T' & = \begin{bmatrix}\begin{bmatrix}a_{1}  & a_{2}  \\\end{bmatrix}  &\begin{bmatrix}b_{2}  & -b_{1}  \\-a_{2} & a_{1} \\\end{bmatrix} \\\begin{bmatrix}a_{2}  & b_{2}  \\\end{bmatrix}&\begin{bmatrix}b_{2}  & -b_{1}  \\-a_{2} & a_{1} \\\end{bmatrix}\\\end{bmatrix} = \begin{bmatrix}\mathbf a^{T}&\begin{bmatrix}\mathbf c  & \mathbf d \\\end{bmatrix} \\\mathbf b^{T}&\begin{bmatrix}\mathbf c  & \mathbf d \\\end{bmatrix}\\\end{bmatrix}\\ & = \begin{bmatrix}\mathbf c^{T}\mathbf C \\\mathbf d^{T}\mathbf C\\\end{bmatrix}=det(\mathbf A) \begin{bmatrix}\mathbf a^{T}\mathbf A^{-1}\\\mathbf b^{T}\mathbf A^{-1}\\\end{bmatrix} \end{align} \tag{11}$$<p>由 $\mathbf T \mathbf A = \mathbf A^T$ 可得</p>$$\mathbf T= \begin{bmatrix} \mathbf a^T \mathbf A^{-1} \\ \mathbf b^T \mathbf A^{-1} \end{bmatrix} \tag{12}$$<p>这时候，可以得出一个结论，<strong>矩阵的转置的过程和矩阵的逆是有关系的，是矩阵逆的一个更加复杂的表现形式</strong></p><p>有了这个作为基础，考虑一下具有对称性，构造 $\mathbf A \mathbf A^T$，这个复合变换有着很好的对称性和分解性（接下来为了方便，默认非粗体表示的矩阵变换），因为</p>$$AA^T = \begin{bmatrix} a_1 & b_1 \\ a_2 & b_2\end{bmatrix}\begin{bmatrix} a_1 & a_2 \\ b_1 & b_2\end{bmatrix} = \begin{bmatrix} a_1^2 + b_1^2 & a_1a_2+b_1b_2 \\ a_1a_2+b_1b_2 & a_2^2 + b_2^2\end{bmatrix} \tag{13}$$<p>考虑任何不进行压缩维度变换的矩阵都可以进行<strong><a href="https://zh.wikipedia.org/wiki/%E7%89%B9%E5%BE%81%E5%88%86%E8%A7%A3" target="_blank" rel="noopener">特征分解</a></strong>，则有</p>$$AA^{T} = R_{AA^{T}} \Lambda_{AA^{T}} (R^{-1})_{AA^{T}} \tag{14}$$<p>之后左乘（这里补充一下，所有的左乘操作在几何意义上来说，就是附加了一个新的变换）$A^{-1}$，得到</p>$$A^{T} = A^{-1} R_{AA^{T}} \Lambda_{AA^{T}} (R^{-1})_{AA^{T}} \tag{15}$$<p>根据之前（1）式的例子进行计算，发现 $R_{AA^{T}} = (R^{-1})_{AA^{T}}$，并且 $R_{AA^T}$ 首先将空间关于 y 轴对称，之后旋转 $\alpha$ 角度，所以假设定义</p>$$R_{AA^{T}}^{'} = \begin{bmatrix}cos \alpha & -sin \alpha \\sin \alpha & cos \alpha \\\end{bmatrix} \tag{16}$$<p>利用上面的推导，带入（15）式，得到：</p>$$A^{T}=A^{-1} R_{AA^{T}}^{'} \begin{bmatrix}-1 & 0 \\0 & 1 \\\end{bmatrix}\Lambda_{AA^{T}} R_{AA^{T}}^{'}\begin{bmatrix}-1 & 0 \\0 & 1 \\\end{bmatrix} \tag{17}$$<p>用更加清晰的符号改写（17）式得到</p>$$A^{T}=A^{-1} R_{\alpha} M_y \Lambda R_{\alpha} M_y \tag{18}$$<blockquote><p>$M_y$ 表示的是关于y轴对称<br>$R_\alpha$ 表示逆时针旋转 $\alpha$ 度<br>$\Lambda$ 表示一种伸缩变换</p></blockquote><p>这里的（18式）结论和<a href="#性质找规律">上面的作图规律</a>，还有（12）式从某种程度上来说有相似的地方</p><p>其实应该从矩阵分解的部分来再次思索矩阵转置的意义，可详见<a href="https://charlesliuyx.github.io/2017/10/05/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AFPCA%E3%80%81SVD/#What-amp-Why-SVD%EF%BC%88%E5%A5%87%E5%BC%82%E5%80%BC%E5%88%86%E8%A7%A3%EF%BC%89">什么是PCA,SVD</a></p><p>最终感觉关于转置还是研究的不够透彻，可能需要拔高到另一个层面去理解会更加直观，但是限于水平，只能至此（并不是数学专业的学生）</p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><ul><li>$\mathbf A \mathbf A^T$ 的对称特性非常有用</li><li>正交 = 旋转 = 垂直，并且<strong>逆等于转置</strong></li><li>正规矩阵的定义和转置息息相关，但是从形式上来看，约束条件是逐步变弱的，其实这些特征都是描述了空间一个变换的一些变化模式，比如旋转，伸缩的特殊模式，只需要有一个基本的直观理解，在机器学习领域就已经足够用了</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】20min 4589 words&lt;br&gt;【内容简介】从&lt;a href=&quot;https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/&quot;&gt;【直观理解】线性代数的本质&lt;/a&gt;笔记出发，继续讨论几个线性代数中的概念，正交，正规，正定及转置的直观解释。旨在能帮助读者在看完后不会忘记什么是正交矩阵，什么是正规矩阵，转置部分进行了深入挖掘，希望找出一些几何直观的解释&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="Linear Algebra" scheme="https://charlesliuyx.github.io/tags/Linear-Algebra/"/>
    
  </entry>
  
  <entry>
    <title>程序员技能图谱</title>
    <link href="https://charlesliuyx.github.io/2017/10/13/%E7%A8%8B%E5%BA%8F%E5%91%98%E6%8A%80%E8%83%BD%E5%9B%BE%E8%B0%B1/"/>
    <id>https://charlesliuyx.github.io/2017/10/13/程序员技能图谱/</id>
    <published>2017-10-13T11:08:30.000Z</published>
    <updated>2017-10-14T04:11:17.563Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】百科类<br>【内容简介】原文来自StuQ的<a href="https://github.com/CharlesLiuyx/skill-map" target="_blank" rel="noopener">开源项目</a>。核心目的是提纲挈领不同领域的技术栈。高层次来说，技术无止境，终身学习会越来越重要，一份由行内的资深人士总结的技术，工具和概念图谱有很强的指导作用，帮你节省时间。低层次来说，一份知识图谱也同领域聊天中装逼的神器，名词概念是有专业隔离的</p><a id="more"></a><p>记录工具使用幕布，方便<strong>一键生成思维导图</strong>，并且<strong>快速搜索查找</strong></p><h1 id="人工智能AI"><a href="#人工智能AI" class="headerlink" title="人工智能AI"></a>人工智能AI</h1><p><a href="https://mubu.com/doc/3wVIpfpgDl" target="_blank" rel="noopener">机器学习</a></p><h1 id="大数据"><a href="#大数据" class="headerlink" title="大数据"></a>大数据</h1><p><a href="https://mubu.com/doc/Sq1-UW_kl" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/1pXN8Egyll" target="_blank" rel="noopener">Hadoop</a></p><h1 id="Web-前端"><a href="#Web-前端" class="headerlink" title="Web 前端"></a>Web 前端</h1><p><a href="https://mubu.com/doc/1Ztwio0Oll" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/2pUvC-peMl" target="_blank" rel="noopener">移动性能优化</a></p><p><a href="https://mubu.com/doc/34w-BTEWDl" target="_blank" rel="noopener">HTML5开发</a></p><p><a href="https://mubu.com/doc/3HC5GcaODl" target="_blank" rel="noopener">Angular 2</a></p><h1 id="Server-后端"><a href="#Server-后端" class="headerlink" title="Server 后端"></a>Server 后端</h1><p><a href="https://mubu.com/doc/V_HqHKAll" target="_blank" rel="noopener">架构师</a></p><p><a href="https://mubu.com/doc/1p-2FT0h2l" target="_blank" rel="noopener">OpenResty</a></p><p><a href="https://mubu.com/doc/24CxEM0Ill" target="_blank" rel="noopener">直播技术</a></p><p><a href="https://mubu.com/doc/2E8gOvYoMl" target="_blank" rel="noopener">CDN技术</a></p><p><a href="https://mubu.com/doc/3fdnSQy4Vl" target="_blank" rel="noopener">DNS排查</a></p><h1 id="云计算"><a href="#云计算" class="headerlink" title="云计算"></a>云计算</h1><p><a href="https://mubu.com/doc/3LbL5_LZtl" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/118IN3Kull" target="_blank" rel="noopener">容器 Container</a></p><p><a href="https://mubu.com/doc/1x740eMWul" target="_blank" rel="noopener">微服务 MicroService</a></p><p><a href="https://mubu.com/doc/1Zy3kQZWul" target="_blank" rel="noopener">微服务架构和实践</a></p><h1 id="智能运维"><a href="#智能运维" class="headerlink" title="智能运维"></a>智能运维</h1><p><a href="https://mubu.com/doc/2twqA0nftl" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/3129JLY32l" target="_blank" rel="noopener">DBA</a></p><p><a href="https://mubu.com/doc/3Le0DdRKDl" target="_blank" rel="noopener">DevOps</a></p><p><a href="https://mubu.com/doc/W4et8A4cl" target="_blank" rel="noopener">Kubernetes</a></p><h1 id="安全"><a href="#安全" class="headerlink" title="安全"></a>安全</h1><p><a href="https://mubu.com/doc/1AIJs2et2l" target="_blank" rel="noopener">总</a></p><h1 id="测试"><a href="#测试" class="headerlink" title="测试"></a>测试</h1><p><a href="https://mubu.com/doc/217IMEnEVl" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/2OSXAHtFtl" target="_blank" rel="noopener">移动无线测试</a></p><h1 id="移动开发"><a href="#移动开发" class="headerlink" title="移动开发"></a>移动开发</h1><p><a href="https://mubu.com/doc/3pY2E_AQul" target="_blank" rel="noopener">iOS开发</a></p><p><a href="https://mubu.com/doc/ElEpvcqll" target="_blank" rel="noopener">Android App 开发</a></p><p><a href="https://mubu.com/doc/18j_EGmuMl" target="_blank" rel="noopener">Android ROM 开发</a></p><p><a href="https://mubu.com/doc/1HRKOql_kl" target="_blank" rel="noopener">Android 架构师</a></p><h1 id="智能硬件"><a href="#智能硬件" class="headerlink" title="智能硬件"></a>智能硬件</h1><p><a href="https://mubu.com/doc/2fntYa2rbl" target="_blank" rel="noopener">嵌入式开发</a></p><h1 id="开发语言"><a href="#开发语言" class="headerlink" title="开发语言"></a>开发语言</h1><p><a href="https://mubu.com/doc/2SsB0ul2Dl" target="_blank" rel="noopener">总</a></p><p><a href="https://mubu.com/doc/3txI4O-yVl" target="_blank" rel="noopener">Golang</a></p><p><a href="https://mubu.com/doc/HXhRiFYVl" target="_blank" rel="noopener">Clojure</a></p><p><a href="https://mubu.com/doc/14OVfjS4ll" target="_blank" rel="noopener">Python</a></p><p><a href="https://mubu.com/doc/1EkEp411kl" target="_blank" rel="noopener">Haskell</a></p><p><a href="https://mubu.com/doc/3LkRaVjkVl" target="_blank" rel="noopener">Node.js</a></p><p><a href="https://mubu.com/doc/ZKqXp6nbl" target="_blank" rel="noopener">Ruby</a></p><p><a href="https://mubu.com/doc/1tIOaA4_bl" target="_blank" rel="noopener">Java</a></p><h1 id="开发工具"><a href="#开发工具" class="headerlink" title="开发工具"></a>开发工具</h1><p><a href="https://mubu.com/doc/1ZH9pL3Dbl" target="_blank" rel="noopener">Git</a></p><h1 id="技能清单"><a href="#技能清单" class="headerlink" title="技能清单"></a>技能清单</h1><p><a href="https://mubu.com/doc/2q68KkZyul" target="_blank" rel="noopener">CTO技能</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】百科类&lt;br&gt;【内容简介】原文来自StuQ的&lt;a href=&quot;https://github.com/CharlesLiuyx/skill-map&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;开源项目&lt;/a&gt;。核心目的是提纲挈领不同领域的技术栈。高层次来说，技术无止境，终身学习会越来越重要，一份由行内的资深人士总结的技术，工具和概念图谱有很强的指导作用，帮你节省时间。低层次来说，一份知识图谱也同领域聊天中装逼的神器，名词概念是有专业隔离的&lt;/p&gt;
    
    </summary>
    
      <category term="Tech" scheme="https://charlesliuyx.github.io/categories/Tech/"/>
    
    
      <category term="Acknowledge Graph" scheme="https://charlesliuyx.github.io/tags/Acknowledge-Graph/"/>
    
      <category term="Program" scheme="https://charlesliuyx.github.io/tags/Program/"/>
    
      <category term="IT" scheme="https://charlesliuyx.github.io/tags/IT/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】线性代数的本质</title>
    <link href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/"/>
    <id>https://charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/</id>
    <published>2017-10-06T14:56:56.000Z</published>
    <updated>2018-03-14T02:56:23.191Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】1小时左右 words 14069words<br>【内容简介】<strong>将只停留在数值运算和公式的线性代数推进到可视化几何直观（Visual Geometric Intuition）的领悟上</strong>，致敬<a href="http://www.bilibili.com/video/av6731067/" target="_blank" rel="noopener">3B1B的系列视频</a>的笔记，动图也都来自于视频。内容涉及到基变换，叉积，逆矩阵，点积，特征向量与特征值。每一章节都有一句经典的名言，非常有启发性<br><a id="more"></a></p><p>在笔记开始之前，想象<strong>学习一个事物（概念）</strong>的场景：我们需要学习<strong>正弦函数</strong>，$\sin (x)$，非常不幸的是，你遇到了一本相当装逼的教材，它告诉你，正弦函数是这样的：<br>$$\sin (x) = x - \frac{x^3}{3!} + \frac{x^5}{5!} + \cdots + (-1)^n\frac{x^{2n+1}}{(2n+1)!} + \cdots$$<br>的确很厉害的样子，并且，计算器就是这样算 $\sin (x)$，知道了这个的确“挺酷的”。对你来说，你的作业可能就是回家把 $x= \frac{\pi}{6}$ 带到公式里面，发现，好神奇！竟然越算越接近<code>0.5</code>。此时你对$\sin (x)$与三角形之间的<strong>几何直观</strong>只有一些模糊的概念。这样的学习过程就十分<strong>悲催</strong>了。为什么呢？</p><p>再假设一个场景，接下来，物理课，正弦函数随处可见，下图场景中，其他人能快速的大概估计出这个值是<code>0.7</code>。而刚“学过”正弦函数的你，内心戏可能是这样的：这些人忒diao了吧？你莫不是在玩我？</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/0-Sin.png" alt="" width="600px"></div><p>你可能会觉得这些做物理的人脑子也太强了，我弱爆了。其实，你需要<strong>只是一个几何直观的灌输而已</strong>，这也从侧面佐证了一个<strong>好的老师（这里的好老师真的不是他本身的学术能力有多强，而在于他擅不擅长站在学习者的角度不断的修正教学方法。甚至，模拟学生的学习过程提前预知所需要的基础概念）</strong>是有多么重要。</p><p>教学不同层次的人：初学，入门，掌握，理解，都是不同的。解释的角度，方式都完全不同。更加不幸的是，<strong>为了能更加通用的用理论来描述现实生活中的规律，人类已经做了很多工作，我们常说：越通用，越抽象（越难以理解）</strong>。这对于初学者来说堪称一段噩梦</p><p>这个例子比较极端，但只为强调一件事：<strong>直观理解很重要，或者说，学习方法很重要</strong>。好的学习方法即<strong>你如何直观的去理解（可能是几何的，或是现实中的具体例子）一个抽象的事物，并层次化的建立知识与知识间的联系，构建并健壮属于自己的知识图谱</strong>。个人观点是，这种【学习方法】是<strong>最高效</strong>的。它唯一的<strong>难度</strong>在于，需要一定的基础知识打底，一定的<strong>量变结合方法论</strong>（点拨或领悟）就是<strong>质变</strong>。换句话说，想躺着学习？不存在的</p><p>根据生物学家我们知道，人对<strong>具体的事物</strong>（动画＞图形＞数字＞未建立直观理解的文字）更敏感，记忆速度更快。<strong>这篇笔记的对象3B1B团队生产的内容</strong>目的就是从<strong>为了帮助人们建立直观概念</strong>的角度来教学，在如今中国应试教育风行的大背景下，它会<strong>超越你的认知：学习如追番般期待</strong>，真不是一个调侃！</p><p>我是<strong>极度反对现代大学的线性代数课程中（甚至数学类课程）的教学方法的</strong>，在计算上（做题）花费了大量时间。而工程中，有计算机，绝不会有任何一个人去笔算矩阵的逆或特征值。如果现在的老师反驳：做计算的目的是为了让你通过大量的联系（重复）去记牢概念，我也一直坚信：<strong>学习知识的最快捷径是带有思考的重复</strong>，但那是<strong>带思考的重复</strong>，有一些<strong>直观的方法</strong>在帮助你理解和记忆上比<strong>做题</strong>有效率的多</p><blockquote><p>注解，因为这是一篇个人笔记，我个人已经深刻理解的内容，或者我觉得是很基本的内容我会略过或默认。好消息是，我自己也是一个理解力非常捉急的人，所以还是会比较详细的</p></blockquote><p>什么是矩阵？<strong>矩阵 = 变换的数字表达</strong> </p><h1 id="向量究竟是什么"><a href="#向量究竟是什么" class="headerlink" title="向量究竟是什么"></a>向量究竟是什么</h1><blockquote><p>引入一些数作为<strong>坐标</strong>是一种鲁莽的行为 ——赫尔曼·外尔</p><p>The introduction of numbers as coordinates is an act of violence - Hermann Weyl</p></blockquote><p>这部分，讲向量，扎实的读者完全可以跳过</p><h2 id="向量的定义-What"><a href="#向量的定义-What" class="headerlink" title="向量的定义 What"></a>向量的定义 What</h2><p>对于向量的这个概念，大家一定并不陌生，但是这次让我们从数学，物理，计算机三个角度来看待如何定义这个【向量】这个概念</p><h3 id="物理专业角度"><a href="#物理专业角度" class="headerlink" title="物理专业角度"></a>物理专业角度</h3><ul><li>向量是<strong>空间中的箭头</strong></li><li>决定一个向量的是：<strong>它的长度和它所指的方向</strong></li></ul><h3 id="计算机专业角度"><a href="#计算机专业角度" class="headerlink" title="计算机专业角度"></a>计算机专业角度</h3><ul><li>向量是<strong>有序的数字列表</strong></li><li>向量不过是“列表”一个花哨的说法</li><li>向量的维度等于“列表”的长度</li></ul><h3 id="数学专业角度"><a href="#数学专业角度" class="headerlink" title="数学专业角度"></a>数学专业角度</h3><p>从数学来说，它的本质就是通用和抽象，所以，数学家希望概括这两种观点</p><ul><li>向量可以是任何东西，只需要保证：<strong>两个向量相加及数字与向量相乘是有意义的即可</strong></li><li><font color="red"><strong>向量加法</strong>和<strong>向量乘法</strong>贯穿线性代数始终，十分重要</font></li></ul><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/1-MathVector.png" alt="" width="600px"></div><p>可以通过上图直观的感受到数学家（这个很牛逼的灰色的$\pi$）在想什么，有种【大道】的逼格。左边是物理角度，右边是计算机角度，但是很抱歉，<strong>我能用一些抽象的定义和约束让你们变成一个东西</strong></p><h2 id="坐标系"><a href="#坐标系" class="headerlink" title="坐标系"></a>坐标系</h2><p>把向量至于坐标系中，<strong>坐标正负表示方向</strong>，<strong>原点为起点</strong>，可完美把两个不同的角度融合</p><ul><li>向量加法<ul><li>物理：首尾相连 Motion</li><li>计算机：坐标相加</li></ul></li><li>向量乘法<ul><li>物理：缩放 Scaling</li><li>计算机：坐标和比例相乘</li></ul></li></ul><h1 id="线性组合、张成的空间与基"><a href="#线性组合、张成的空间与基" class="headerlink" title="线性组合、张成的空间与基"></a>线性组合、张成的空间与基</h1><blockquote><p>数学需要的不是天赋，而是少量的自由想象，但想象太过自由又会陷入疯狂 ——安古斯·罗杰斯</p><p>Mathematics requires a small dose, not of genius, but of an imaginative freedom which, in a larger dose, would be insanity - Angus K. Rodgers</p></blockquote><p>本部分继续加深一个概念，为何<strong>向量加法与向量乘法是那么重要，并从始至终贯穿整个线性代数</strong></p><h2 id="线性组合"><a href="#线性组合" class="headerlink" title="线性组合"></a>线性组合</h2><p>这个概念再好理解不过，空间中不共线的两个不为零向量都可以<strong>表示空间中的任意一个向量</strong>，写成符号语言就是：$a \mathbf{\vec v} + b \mathbf{\vec w}$  </p><p>至于为什么被称为“线性”，有一种几何直观：如果你固定其中一个标量，让另一个标量自由变化，所产生的向量终点会描出一条直线</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/2-Linear.gif" alt="" width="350px"></div><h2 id="空间的基-Basis"><a href="#空间的基-Basis" class="headerlink" title="空间的基 Basis"></a>空间的基 Basis</h2><p>对于我们常见的笛卡尔坐标系，有一个最直观一组基：$\{{\hat {\imath}} ,{\hat {\jmath}} \}$  ，即单位向量：${\hat {\imath}}=(1,0)$ 和$\hat {\jmath} =(0,1)$   ，通过 ${\hat {\imath}}$ 和 ${\hat {\jmath}}$的<strong>拉伸与相加</strong>可以组成笛卡尔坐标系中的任意一个向量</p><h3 id="张成的空间-Span"><a href="#张成的空间-Span" class="headerlink" title="张成的空间 Span"></a>张成的空间 Span</h3><p>同理，举一反三的来说，我们可以选择不同的<strong>基向量</strong>，并且这些<strong>基向量</strong>构成的空间称为：<strong>张成的空间</strong>。张成二字比较拗口，可以类比为延展或扩展。直观来看，就是所有动图中的<strong>网格</strong>。笛卡尔坐标系就是一个由单位坐标$\{{\hat {\imath}} ,{\hat {\jmath}} \}$ <strong>张成的空间</strong> </p><p>所有可以表示为<strong>给定向量（基）</strong>线性组合（刚刚讲了这个概念）的向量的集合，被称为<strong>给定向量（基）</strong>张成的空间</p><p>如果你继续思考一下，会发现一个特点：<strong>并不是每一组给定向量都可以张成一个空间</strong>，若这两个向量共线（2D），共面（3D），它们就只能被限制在一个直线或面中，类似于“降维打击”。通过这个直观的思考可以引出一个概念：<strong>线性相关</strong></p><h3 id="线性相关"><a href="#线性相关" class="headerlink" title="线性相关"></a>线性相关</h3><p>关于什么是线性相关，有两种表达</p><ul><li>【表达一】你有多个向量，并且可以<strong>移除其中一个而不减小张成的空间</strong>（即2D共线或3D共面），我们称<strong>它们（这些向量）线性相关</strong></li><li>【表达二】其中一个向量，可以<strong>表示为其他向量的线性组合</strong>，因为这个向量已经落在其他向量张成的空间之中</li></ul><p>如果从统计学角度来说，这些向量之中有<strong>冗余</strong>。这一堆向量中，我们只需要其中几个（取决于维度）就可以表示其他所有的向量。</p><h3 id="向量空间一组基的严格定义"><a href="#向量空间一组基的严格定义" class="headerlink" title="向量空间一组基的严格定义"></a>向量空间一组基的严格定义</h3><p>有了这些对名次（概念）的直观理解，来看看数学家们是如何严谨的定义<strong>向量空间的一组基</strong>：</p><blockquote><p> <strong>向量空间的一组基是张成该空间的一个线性无关向量集</strong></p></blockquote><p>用这样的步骤来慢慢导出这个定义，个人感觉，远比在课堂的第一分钟就将这句让你迷惑的话丢给你好的多，<strong>抽象的东西只有在慢慢推倒中你才能发现它的精巧之处，非常优雅且迷人</strong></p><h1 id="矩阵与线性变换"><a href="#矩阵与线性变换" class="headerlink" title="矩阵与线性变换"></a>矩阵与线性变换</h1><blockquote><p>很遗憾，Matrix（矩阵）是什么是说不清的。你必须得自己亲眼看看 ——墨菲斯</p><p>Unfortunately, no one can be told what the Matrix is. You have to see it yourself -Morpheus</p></blockquote><p>矩阵，最直观的理解当然是一个<strong>写成方阵的数字</strong> $\left[\begin{smallmatrix} 1&2 \\ 3&4 \end{smallmatrix}\right]$，这几节的核心是为了说明：<strong>矩阵其实就是一种向量变换（至于什么是变换下面会讲）</strong>，并附带一种不用死记硬背的考虑矩阵向量乘法的方法</p><h2 id="变换"><a href="#变换" class="headerlink" title="变换"></a>变换</h2><p>【变换】本质上是【函数】（左）的一种花哨的说法，它接受输入内容，并输出对应结果，矩阵变换（右），同理，如下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/31-Fun1.gif" alt="" width="300px"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/32-Fun2.gif" alt="" width="300px"></div><p>那既然两者意思相同，为何还要新发明一个词语装逼呢？其实不然，搞学术，不严谨就会出现纰漏。常说编程出现Bug，其实就是<strong>不严谨</strong>的一种体现，在写Code前，没有考虑到可能性的全集（虽然在一些大型程序中，考虑全集的做法有时候是没必要的，这是一对关于<strong>编程困难程度</strong>和<strong>不出的bug</strong>的<strong>博弈Trade-off</strong>），但是【变换】这个名词和不严谨其实没什么关系……</p><p>【变换】的表达方法暗示了我们可以用<strong>运动</strong>的方法来理解【向量的函数】这一概念，可以用可视化的方法来展现这组【变换】即输入-输出关系</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/33-InputOutput.gif" alt="" width="500px"></div><p>这世界上有非常多优美的变换，如果你将他们编程，并可视化，就能得到下图</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/35-TransformAll.gif" alt="" title="">                </div>                <div class="image-caption"></div>            </figure><h2 id="线性变换"><a href="#线性变换" class="headerlink" title="线性变换"></a>线性变换</h2><p>我们说具有以下两个性质的就是线性变换（直观可视化如下图）：</p><ul><li>直线在变换后<strong>仍然保持为直线</strong>，不能有所弯曲</li><li><strong>原点必须保持固定</strong></li></ul><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/34-Transform.gif" alt="" width="500px"></div><p>一点扩展，如果保持保持直线但原点改变就称为：仿射变换（Affine Transformation）</p><p>一句话总结来说是：<strong>线性变换是“保持网格线平行且等距分布”的变换</strong></p><h2 id="如何用数值描述线性变换"><a href="#如何用数值描述线性变换" class="headerlink" title="如何用数值描述线性变换"></a>如何用数值描述线性变换</h2><p>这里需要使用上一节提到的工具，<strong>空间的基</strong>，也就是单位向量（基向量）：${\hat {\imath}}=(1,0)$ 和$\hat {\jmath} =(0,1)$ </p><p>你只需要关注两个基向量 $\hat {\imath}$ 和 $\hat {\jmath}$ <strong>变换后的位置即可</strong>。例如， $\hat {\imath}$ 变换到 $(3,1)$ 的位置， $\hat {\jmath}$ 变换到$(1,2)$ 的位置，并把 $\hat {\imath}$ <strong>变换后坐标</strong>立起来作为方阵的第一列（绿色表示）， $\hat {\jmath}$ <strong>变换后的坐标</strong>立起来作为方阵的第二列（红色表示）。</p><p>构成了一个<strong>矩阵</strong>：$\begin{bmatrix} \color{green}3&\color{red}1 \\ \color{green}1&\color{red}2 \end{bmatrix}$，假设我们想要知道目标向量$(-1,2)$进行变换后的位置，<strong>那么这个矩阵就是对变换过程最好的描述</strong>，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/36-Matrix1.gif" alt="" width="700px"></div><blockquote><p>Step1：绿色 $\hat {\imath}$ （x轴）进行移动（变换）<br>Step2：红色 $\hat {\jmath}$ （y轴）进行移动（变换）<br>Step3：目标向量x轴<strong>坐标值</strong>与 $\hat {\imath}$ <strong>变换后向量</strong>进行<strong>向量乘法</strong><br>Step4：目标向量y轴<strong>坐标值</strong>与 $\hat {\jmath}$ <strong>变换后向量</strong>进行<strong>向量乘法</strong><br>Step5：两者进行向量加法，得到<strong>线性变换结果</strong></p></blockquote><p>更加一般的情况，我们用变量来代替其中的具体值：绿色代表 $\hat {\imath}$ 变换后的向量，红色代表 $\hat {\jmath}$ 变换后的向量 </p>$$\begin{bmatrix} \color{green}{a}&\color{red}b \\ \color{green}c&\color{red}d \end{bmatrix} \begin{bmatrix}x\\y\end{bmatrix} = \underbrace{x \begin{bmatrix}\color{green}a\\\color{green}c \end{bmatrix} + y \begin{bmatrix} \color{red}b\\\color{red}d\end{bmatrix}}_{\text{直观的部分这里}} = \begin{bmatrix} \color{green}{a}\color{black}{x}+\color{red}{b}\color{black}{y}\\\color{green}{c}\color{black}{x}+\color{red}{d}\color{black}{y}\end{bmatrix}$$<p>上面的公式就是我们常说的矩阵乘法公式，现在，不要强行背诵，结合可视化的直观动图，你一辈子都不会忘记的</p><h3 id="【线性】的严格定义"><a href="#【线性】的严格定义" class="headerlink" title="【线性】的严格定义"></a>【线性】的严格定义</h3><p>在给出一个数学化抽象的解释前，先做一下总结：</p><ul><li>【线性变换】是操纵空间的一种手段，它<strong>保持网格线平行且等距分布</strong>，并<strong>保持原点不动</strong></li><li>【矩阵】是<strong>描述这种变换的一组数字</strong>，或者说<strong>一种描述线性变换的语言</strong></li></ul><p>在数学上，【线性】的严格定义如下述公式，这些性质，会在之后进行讨论，也可以在这里就进行一些思考，<strong>为什么说向量加法和向量乘法贯穿线性代数始终，毕竟是线性代数，很重要的名次就是线性二字</strong></p>$$L(\mathbf {\vec v} + \mathbf {\vec w}) = L(\mathbf{\vec v}) +L(\mathbf{\vec w}) \qquad “可加性” \\L(c \mathbf{\vec v}) = c L(\mathbf{\vec v}) \qquad “成比例”$$<h1 id="矩阵乘法与线性变换复合"><a href="#矩阵乘法与线性变换复合" class="headerlink" title="矩阵乘法与线性变换复合"></a>矩阵乘法与线性变换复合</h1><blockquote><p>据我的经验，如果丢掉矩阵的话，那些涉及矩阵的证明可以缩短一半 ——埃米尔·阿廷</p><p>It is my experience that proofs involving matrices can be shortened by 50% if one throws the matrices out -Emil Artin</p></blockquote><h2 id="复合变换"><a href="#复合变换" class="headerlink" title="复合变换"></a>复合变换</h2><p>如果对一个向量先进行一次旋转变换，再进行一次剪切变换（ $\hat {\imath}$ 保持不变第一列为（1,0）， $\hat {\jmath}$ 移动到坐标（1,1）） ，如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/41-Composition.png" alt="" width="600px"></div><p>那么如果通过旋转矩阵和剪切矩阵来求得这个符合矩阵呢？为了解决这个问题，我们定义这个过程叫做<strong>矩阵的乘法</strong></p><h2 id="矩阵乘法"><a href="#矩阵乘法" class="headerlink" title="矩阵乘法"></a>矩阵乘法</h2><p>在这里我们发现，矩阵乘法的变换顺序是<strong>从右往左读的（这一个常识很重要，你得明白这一点，有基本概念）</strong>，进一步联系和思考发现，和复合函数的形式，如 $f(g(x))$ ，是一致的</p><p>那么如何求解矩阵乘法呢？对线性代数有印象的同学你们现在能马上记起来那个稍显复杂的公式吗？如果有些忘记了，那么，现在，就有一个一辈子也忘不了的直观解释方法：</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/42-Cal.gif" alt="" width="700px"></div><p><code>M1</code>矩阵的第一列表示的是 $\hat {\imath}$ 变换的位置，先把它拿出来，<code>M2</code>矩阵看成对这个变换过的 $\hat {\imath}$ 进行一次变换（按照同样的规则），就如上图所示。同理，针对 $\hat {\jmath}$ 一样的操作过程，就可以得出这个表达式。这里我也不把它写出来了，按照这种思路，并且把上面的动图多看几遍，如果还能忘记，那就要去补一补<strong>基本的对几何图形的反应能</strong>力了（这也是一种能力，包括<strong>三维想象力，心算能力，都和记忆或肌肉一样，不锻炼，是不可能躺着被提高的</strong>）</p><h2 id="计算规则证明"><a href="#计算规则证明" class="headerlink" title="计算规则证明"></a>计算规则证明</h2><p>有了上面的想法，可以自己尝试证明一下，矩阵乘法的交换律是否成立？矩阵乘法的结合律呢？你会发现，原来这么直观，根本不需要动笔算</p><h2 id="三维空间"><a href="#三维空间" class="headerlink" title="三维空间"></a>三维空间</h2><p>对三维空间内扩展的话，你会发现，显示生活中的每一种形态改变都能用一个<code>3*3</code>的矩阵来表示这个变换，这在机器人，自动化操作领域是非常重要的，因为你可以把<strong>现实生活很难描述的动作通过一个矩阵来表示</strong>，是一个连接数字和现实的重要桥梁和工具</p><h1 id="行列式"><a href="#行列式" class="headerlink" title="行列式"></a>行列式</h1><blockquote><p>计算的目的不在于数字本身，而在于洞察其背后的意义 ——理查德·汉明（没错，是发明汉明码的那个人）</p><p>The purpose of computation is insight, not numbers - Richard Hamming</p></blockquote><h2 id="行列式定义的由来"><a href="#行列式定义的由来" class="headerlink" title="行列式定义的由来"></a>行列式定义的由来</h2><p>我们注意到，有一些变换在结果上<strong>拉伸</strong>了整个网格，有一些则是<strong>压缩</strong>了，那<strong>如何度量这种压缩和拉伸</strong>呢？或者换一种更容易思考的表达，<strong>某一块面积的缩放比例</strong>是多少？</p><p>其实，根据我们之前讲的基向量，我们只需要知道 $\hat {\imath}$ 和 $\hat {\jmath}$ 组成的面积为1的正方形面积缩放了多少就代表所有的情况。因为线性变换有一个性质：<strong>网格线保持平行且等距分布</strong></p><p>所以，<strong>这个特殊的缩放比例，即线性变换对面积产生改变的比例</strong>，就是<strong>行列式</strong></p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/51-Deter.gif" alt="" width="400px"></div><p>特别的，我们可以发现，如果一个矩阵的<strong>行列式为0</strong>，意味着它把这个<strong>空间降维</strong>了，并且矩阵的<strong>列线性相关</strong></p><p>其中，<strong>正负表达的是方向</strong>，类似于纸的翻面。从数学来说，$\hat {\jmath}$ 起始状态在 $\hat {\imath}$ 的<strong>左侧</strong>，如果经过变换，变为<strong>在右侧</strong>，就添加负号。三维情况下，<strong>右手定位</strong>为正</p><h2 id="计算行列式"><a href="#计算行列式" class="headerlink" title="计算行列式"></a>计算行列式</h2><p>为了连接行列式的计算公式和几何直观，我们现考虑 $\begin{bmatrix} \color{green}a&\color{red}b \\ \color{green}c&\color{red}d \end{bmatrix}$ 其中的<code>b</code> <code>c</code> 为0，那么，a表示 $\hat {\imath}$ 在<code>x轴</code>缩放比例，d表示 $\hat {\jmath}$ 在<code>y轴</code>缩放比例，<code>ad</code>表示<strong>拉伸倍数</strong>，同理来说，<code>bc</code>表示的就是<strong>压缩倍数</strong>，两者的和就是<strong>缩放比例</strong>。如果你还是对公式念念不忘，那么下面这张图可能可以帮到你</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/52-Cal.png" alt="" width="600px"></div><h2 id="行列式直观理解的好处"><a href="#行列式直观理解的好处" class="headerlink" title="行列式直观理解的好处"></a>行列式直观理解的好处</h2><p>在这里，可以思考一下如何证明 $det(M_1M_2) = det(M_1)det(M_2)$ ，你会发现太简单不过了</p><h1 id="逆矩阵、列空间与零空间"><a href="#逆矩阵、列空间与零空间" class="headerlink" title="逆矩阵、列空间与零空间"></a>逆矩阵、列空间与零空间</h1><blockquote><p>提出正确的问题比回答它更难 ——格奥尔格·康托尔</p><p>To ask the right question is harder than to answer it - Georg Cantor</p></blockquote><p>首先，这一节并不涉及计算的方法，相关名次有：高斯消元法 Gaussian elimination、行阶梯形 Row echelon form。这里着眼的是对抽象的概念建立一个几何直观的理解，<strong>计算的任务就交给计算机去做</strong></p><h2 id="矩阵的用途"><a href="#矩阵的用途" class="headerlink" title="矩阵的用途"></a>矩阵的用途</h2><ul><li>描述对空间的操作，<code>3*3</code>矩阵描述的三维变换</li><li>可以帮助我们<strong>解线性方程组</strong>（Linear System of equation）</li></ul><h2 id="线性方程组"><a href="#线性方程组" class="headerlink" title="线性方程组"></a>线性方程组</h2><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/61-LSoE.png" alt="" width="800px"></div><p>上图就是一个整理好的线性方程组，一般形式 $\mathbf A \mathbf{\vec x} = \mathbf{\vec v}$ ，其中 $\mathbf{\vec x}$ 是<strong>待求向量</strong>。使用之前的几何直观来翻译个公式即，$\mathbf{\vec x}$ <strong>经过 $\mathbf A$ 矩阵变换后，恰好落在 $\mathbf{\vec v}$ 上</strong>，如下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/62-xv.gif" alt="" width="500px"></div><p>既然使用了 $\mathbf A$ 这个矩阵变换，那么之前讲解的概念：<strong>行列式</strong>应用在这里就很有意思了。根据之前提到的，<strong>行列式</strong>直观来说就是矩阵变换操作<strong>面积的缩放比例</strong>。我们可以思考，$det(\mathbf A) = 0$ 意味着缩放比例为0，即<strong>降维了</strong>。<strong>很大可能找不到解</strong>，唯一的可能性，比如平面压缩成直线，这个直线恰好落在 $\mathbf{\vec v}$ 上才有解。这也是<strong>为什么计算行列式的值可以判断方程是否有解的几何直观</strong></p><p>接下来思考如何求 $\mathbf{\vec x}$ 。逆向思考，从 $\mathbf{\vec v}$ 出发，进行某一个矩阵变换，恰好得到 $\mathbf{\vec x}$ 。而这个反过来的矩阵变换，就称为 $\mathbf A$ 矩阵的逆矩阵，写成公式是：<br>$$<br>\mathbf A^{-1}\mathbf A\mathbf{\vec x} =\mathbf A^{-1} \mathbf{\vec v} \implies \mathbf{\vec x} =\mathbf A^{-1} \mathbf{\vec v}<br>$$</p><h2 id="逆矩阵"><a href="#逆矩阵" class="headerlink" title="逆矩阵"></a>逆矩阵</h2><p>所谓逆，就是反过来的意思。根据基向量代表整个空间，已经变换过的 $\hat {\imath}’$ 和 $\hat {\jmath}’$ 如何通过一个矩阵变换，变回 $\hat {\imath}$ 和 $\hat {\jmath}$ ，这个矩阵就是<strong>逆矩阵</strong> ，写作 $\mathbf A^{-1}$，直观理解如下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/65-ReverseMatrix.gif" alt="" width="500px"></div><p>逆矩阵乘原矩阵等于恒等变换，写作 $\mathbf A \mathbf A^{-1} = \mathbf I$ 。$\mathbf I$ 矩阵表示基向量，对角线元素为1，其余为0（矩阵说对角线，默认为左上方到右下方） </p><h2 id="列空间"><a href="#列空间" class="headerlink" title="列空间"></a>列空间</h2><p>其实这只是之前一直在提到过的概念，在线性方程组中，这么描述：所有可能得<strong>输出向量</strong> $\mathbf A \mathbf{\vec v}$ 构成的集合被称为A的<strong>列空间</strong>。这么说不太好理解，可以从名称“列空间”入手，矩阵的列是什么呢？我们之前已经多次强调了，就是 $\hat {\imath}$ 和 $\hat {\jmath}$ <strong>变换后的坐标</strong>。即<strong>矩阵的列</strong>表示基向量变换后的坐标（位置），变换后的向量张成的空间就是<strong>所有可能得输出向量</strong></p><p>简单说即：<strong>列张成的空间 = 列空间，即矩阵的列所张成的空间</strong>，如下图。</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/63-ColumnSpace.png" alt="" width="400px"></div><p>检查一下自己是否完全理解，就思考下面句话为什么这么说：<strong>零向量</strong>一定在列空间中（列空间很好理解）</p><h2 id="秩-Rank"><a href="#秩-Rank" class="headerlink" title="秩 Rank"></a>秩 Rank</h2><p>秩这个概念相信很多学习线性代数的同学，因为中文字，秩，本身就不熟（和<a href="https://charlesliuyx.github.io/2017/10/03/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AF%E6%AD%A3%E5%88%99%E5%8C%96/">正则化</a>有点类似），所以秩也就非常难以理解了。<strong>秩是秩序，联想为秩序的程度</strong>。但是，因为你已经看了这个教程，<strong>矩阵的秩在现在你拥有的几何直观下</strong>，理解起来，当真的小菜一碟</p><p>我们已经建立了一种深刻的认知：矩阵 = 变换，那么<strong>变换后空间的维度</strong>，就是这个矩阵的秩。更加精确的定义是：<strong>列空间的维数</strong>（如果你可以焕然大：原来这两句话是一个意思，那么我觉得你对矩阵的理解已经有了质的提高）</p><h2 id="零空间"><a href="#零空间" class="headerlink" title="零空间"></a>零空间</h2><p>变换后<strong>落在原点的向量</strong>的集合，称为<strong>这个矩阵</strong>（再次强调矩阵 = 变换的数字表达）的<strong>零空间或核</strong>，如果感觉没理解，可以看看下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/64-NullSpace.gif" alt="" width="800px"></div><blockquote><p>【图1】二维压缩到一个直线（一维），有一条直线（一维）的点被压缩到原点<br>【图2】三维压缩到一个面（二维），有一条直线（一维）的点被压缩到原点<br>【图3】三维压缩到一条线（一维），有一条直线（二维）的点被压缩到原点</p><p>【注意】压缩就是变换，变换就是矩阵，其实说的就是矩阵</p></blockquote><p>满秩 = 列空间 + 零空间</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><ul><li>从<strong>几何角度理解线性方程组</strong>的一个高水平概述</li><li><strong>每个方程组</strong>都有一个线性变换与之联系，当<strong>逆变换存在</strong>时，你就能用这个<strong>逆变换求解方程组</strong></li><li>不存在逆变换时，<strong>列空间的概念</strong>让我们清楚什么时候存在解</li><li><strong>零空间的概念</strong>有助于我们理解<strong>所有可能得解的集合</strong>是什么样的</li></ul><h1 id="非方阵"><a href="#非方阵" class="headerlink" title="非方阵"></a>非方阵</h1><blockquote><p>在这个小测试里，我让你们求一个2*3矩阵的行列式。让我感到非常可笑的是，你们当中竟然有人尝试去做 ——佚名</p><p>On this quiz, I asked you to find the determinant of a 2*3 matrix. Some of you, to my great amusement, actually tried to do this - no name listed</p></blockquote><h2 id="几何意义"><a href="#几何意义" class="headerlink" title="几何意义"></a>几何意义</h2><p>首先从一个特例出发，考虑<code>3×2</code>（3行2列）矩阵的几何意义，从列空间我们得知，第一列表示的是 $\hat {\imath}$ 变换后的位置（现在是一个有三个坐标的值，即三维），第二列同理是 $\hat {\jmath}$ 。总结来说，<code>3×2</code>矩阵的几何意义是将<strong>二维空间映射到三维空间</strong>上</p><p>此时从特例到一般化推倒，我们可以得到一个结论：<code>n*m</code> 的几何意义是将<strong>m维空间（输入空间）映射到n维空间（输出空间）</strong>上</p><p>注意这里的输入空间，输出空间的概念，阅读方向同样也是<strong>从右向左的（靠右的是输入，靠左的是输出）</strong></p><h2 id="非方阵乘法"><a href="#非方阵乘法" class="headerlink" title="非方阵乘法"></a>非方阵乘法</h2><p>如果你已经学过线性代数的大学课程，你可能有一些影响，并不是任意两个非方阵都可以进行矩阵乘法，必须满足一些条件，例如，$\mathbf M_1 \mathbf M_2$（非方阵）计算中，假设 $\mathbf M_2$ 为<code>2×3</code>的矩阵，那么 $\mathbf M_1$的列必须等于 $\mathbf M_2$ 的行，否则这个乘法是没法计算的。</p><p>当我们有了变换的几何直观后，这个概念只要自己思考推倒一次，也是一辈子都忘不了的</p><p>直观解释是：<strong>矩阵的行</strong>是这个变换的<strong>输出空间维数</strong>，而<strong>列</strong>是变换的<strong>输入空间维数</strong>。矩阵乘法从右向左读，第一个变换的 $\mathbf M_2$ 的输出向量的维度（ $\mathbf M_2$ 的行）必须和第二个变换 $\mathbf M_1$ 的输入向量（ $\mathbf M_1$ 的列）<strong>维度相等</strong>，才可以计算。也就是说，类似于插头和插座的关系，我只有三头插座，你来一个双头插头肯定没法用的</p><h2 id="非方阵行列式"><a href="#非方阵行列式" class="headerlink" title="非方阵行列式"></a>非方阵行列式</h2><p>这里有一个很好玩的概念，非方阵的行列式呢？都<strong>不是一个维度的变换</strong>，如同归零者和咱们谈判一样，你和我谈<strong>缩放比例</strong>？不存在的</p><h1 id="点积与对偶性"><a href="#点积与对偶性" class="headerlink" title="点积与对偶性"></a>点积与对偶性</h1><blockquote><p>卡尔文：你知道吗，我觉数学不是一门科学，而是一种宗教<br>霍布斯：一种宗教？<br>卡尔文：是啊。这些公式就像奇迹一般。你取出两个数，把它们相加时，它们神奇地成为了一个全新的数！没人能说清这到底是怎么发生的。你要么完全相信，要么完全不信</p></blockquote><h2 id="什么是点积"><a href="#什么是点积" class="headerlink" title="什么是点积"></a>什么是点积</h2><p>个相同维数的向量，或是两个相同长度的数组。求它们的点积，<strong>就是将相应坐标配对，求出每一对坐标的乘积，然后将结果相加</strong>，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/71-Dot.gif" alt="" width="300px"></div><p>几何直观来说，$\mathbf{\vec v} \cdot \mathbf{\vec w}$ 可以想象成向量 $\mathbf{\vec w}$ 朝着过原点和向量 $\mathbf{\vec v}$ 的直线上的<strong>正交（垂直）投影</strong>，然后把投影的长度和向量 $\mathbf{\vec v}$ 的长度乘起来就是点击的值。其中<strong>正负号代表方向</strong>，两个向量成锐角，大于0；钝角，小于0</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/71-DotVisual.png" alt="" width="600px"></div><h2 id="点积的顺序"><a href="#点积的顺序" class="headerlink" title="点积的顺序"></a>点积的顺序</h2><p>你可能会发现，顺序在线性代数其实是很重要的，而对于 $\mathbf{\vec v} \cdot \mathbf{\vec w}$ 和 $\mathbf{\vec w} \cdot \mathbf{\vec v}$ 它们的结果是相同，为什么呢？</p><p>解释的方法为：首先假设 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 长度相同，利用对称轴，两个向量互相的投影相等；接下来如果你<strong>缩放其中一个到原来的两倍</strong>，对称性被破坏，但是<strong>缩放比例没变</strong>，最终<strong>乘法的结果</strong>也没变，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/72-DotOrder.gif" alt="" width="300px"></div><h2 id="点积与投影"><a href="#点积与投影" class="headerlink" title="点积与投影"></a>点积与投影</h2><p>这个时候问题就来了，这种直观的乘法与加法的组合运算：点积为何和投影长度的乘积有关？这个问题非常有意思，因为回答这个问题的过程用到了十分精彩的直觉和思维方式</p><p>首先，需要建立<strong>多维空间到一维空间的线性变换（描述为<code>1×n</code>的矩阵，列代表对应的基向量压缩到一维空间的位置）</strong>，即<strong>函数</strong>（自变量对应多维空间，$f(x)$ 最后的输出为一维空间，也就是<strong>数轴上的点</strong>，一个确定的数）的概念。一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/73-nD21D.gif" alt="" width="600px"></div><p>你会发现，<code>n×1</code> 表示的是坐标和<code>1×n</code>表示的多维到一维的变换（矩阵）之间有某种联系，即<strong>将向量转化为数的线性变换</strong>和这个<strong>向量本身</strong>有着<strong>某种关系</strong></p><p>接下来，我们想象一个情景，这个<strong>被压缩成的一条线</strong>（数轴）放置在一个<strong>坐标系</strong>（二维空间）中，且空间所有向量都经过<strong>一个变换被压缩到</strong>这个数轴上。记这个数轴的单位向量为 $\mathbf{\vec u}$，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/74-Duality1.gif" alt="" width="600px"></div><p>再然后，我们需要考虑的问题变为，坐标系中的 $\hat {\imath}$ 与 $\hat {\jmath}$ 是如何被压缩到这条直线上的呢（基向量表征整个空间的变换）？即求一个<code>1×2</code>的矩阵内的值，第一列表示 $\hat {\imath}$ 变换后的位置（在这条数轴上），第二列表示 $\hat {\jmath}$ 变换后的位置。可以直接给出结论，<strong>这个变换</strong>的数值恰好就是 $\mathbf{\vec u}$ 在这个坐标系中的坐标 $(u_x,u_y)$ ，推倒方法使用<strong>到了对称性</strong>，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/74-Duality2.gif" alt="" width="600px"></div><p>动图中的白色虚线就是对称轴，目的就是确定变换后 $\hat {\imath}$ 与 $\hat {\jmath}$ 的位置，即<strong>描述变换的矩阵（再次重复，列表示坐标，行表示变换）</strong>。</p><p>推倒完毕，把这个过程总结成一个动图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/74-DualityAll.gif" alt="" width="600px"></div><p>矩阵的向量乘积和点积的计算公式一样，且恰好由<strong>压缩这一变换理念</strong>，与投影正好联系了起来。关键点，在于<strong>压缩变换 = 投影</strong></p><h2 id="对偶性"><a href="#对偶性" class="headerlink" title="对偶性"></a>对偶性</h2><p>在证明的过程中，有一个很关键的点就是<strong>使用了对称轴（对称理念）</strong>。在数学中，对偶性定义为：两种数学事物之间<strong>自然而又出乎意料</strong>的<strong>对应关系</strong>。刚刚推倒的内容是数学上“对偶性”的一个实例，即无论何时你看到一个<strong>二维到一维的变换</strong>，空间中会存在为一个向量 $\mathbf{\vec v}$ 与之相关</p><h2 id="总结-1"><a href="#总结-1" class="headerlink" title="总结"></a>总结</h2><ul><li><strong>点积是理解投影的有力几何工具</strong></li><li>方便<strong>检验两个向量的指向是否相同</strong></li><li>更进一步，两个<strong>向量点乘</strong>，就是将<strong>其中一个向量转化为线性变换</strong></li><li>向量放佛是一个<strong>特定变换的概念性记号</strong>。对一般人类来说，想象空间中的向量比想象这个空间移动到数轴上更加容易</li></ul><h1 id="叉积"><a href="#叉积" class="headerlink" title="叉积"></a>叉积</h1><blockquote><p>每一个维度都很特别 ——杰弗里·拉加里亚斯</p><p>从他（格罗滕迪克）和他的作为中，我还学到了一点：不以高难度的证明为傲，因为难度高意味着我们还不理解。理想的情况是能够绘出一幅美景，而其中的证明显而易见</p></blockquote><h2 id="二维情况下的叉积类比"><a href="#二维情况下的叉积类比" class="headerlink" title="二维情况下的叉积类比"></a>二维情况下的叉积类比</h2><p>$\mathbf{\vec v}$ 与 $\mathbf{\vec w}$ 张成的<strong>平行四边形的面积</strong>，即 $\mathbf{\vec v} \times \mathbf{\vec w}$ ，结果方向的确定考虑 $\hat {\imath}$ 和 $\hat {\jmath}$ 的相对位置关系，与其相同，为正；否则，为负</p><p>通过这个定义，结合几何直观，我们可以发现几个有趣的结论</p><ul><li>越接近垂直的 $\mathbf{\vec v}$ 与 $\mathbf{\vec w}$ 构成的面积越大</li><li>并且叉积的分配律成立</li></ul><h2 id="真正的叉积定义"><a href="#真正的叉积定义" class="headerlink" title="真正的叉积定义"></a>真正的叉积定义</h2><p><strong>真正的叉积</strong>是在三维情况下被定义出来的：通过两个三维向量（$\mathbf{\vec v}$ 与 $\mathbf{\vec w}$ ）产生一个新的三维向量 $\mathbf{\vec p}$ ，向量 $\mathbf{\vec p}$ 的长度就是 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ <strong>组成平行四边形的面积</strong>  ，向量的方向与平行四边形（所在平面）垂直，并用右手定则确定方向，食指为 $\mathbf{\vec v}$ ，中指为 $\mathbf{\vec w}$ ，大拇指即 $\mathbf{\vec p}$</p><h2 id="叉积计算公式"><a href="#叉积计算公式" class="headerlink" title="叉积计算公式"></a>叉积计算公式</h2> <div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/81-Cal.png" alt="" width="500px"></div><p>其中 $\hat {\imath}$ $\hat {\jmath}$ $\hat k$ 三个基向量后的数字就是对应向量 $\mathbf{\vec p}$ 的坐标值</p><p>第一次学这个计算方法的时候，估计没几个人能想清楚它为什么是这样的形式，甚至老师也说不清，只是告诉学生，我们这么记下来，定义是这样的定义的。但是，既然是直观讲解，必须把这里的来由探明清楚</p><h2 id="叉积计算的几何直观"><a href="#叉积计算的几何直观" class="headerlink" title="叉积计算的几何直观"></a>叉积计算的几何直观</h2><p>在开始前，先再次加深一次<strong>对偶性</strong>的概念：每当你看到一个<strong>（多维）空间到数轴的线性变换</strong>时，它都与那个空间中的<strong>唯一一个向量对应</strong>。即<strong>应用线性变换到某个向量</strong>和<strong>与这个向量点乘</strong>等价</p><p>恰好，叉积的运算过程给出了对偶性的一个绝佳的实例：根据 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 定义一个从三维空间到数轴的<strong>特定线性变换</strong>，找到这个变换的<strong>对偶向量</strong>，这个<strong>对偶向量</strong>就是 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 的<strong>叉积</strong> </p><p>首先，我们知道三维情况的，求一个<code>3×3</code>矩阵的行列式，就是求这三个向量张成的<strong>平行六面体的体积</strong>，然后，把第一列（向量）换成一个自变量，后两列（两向量）记为 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ ，那么我们就有</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/82-f.png" alt="" width="600px"></div><p>这样形式的函数 $f()$ ，如右图所示，即<strong>平行六面体随白色向量 $(x,y,z)$ 的随机游走而不断改变</strong>。然后，问题就变成了，<strong>我们需要根据 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 找到一个变换（一个矩阵，或者说函数），使得上述等式成立</strong>。</p><p>并且因为 $f()$ 是线性的，可以利用<strong>对偶性</strong>，一动图胜千言</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/83-Duality.gif" alt="" width="600px"></div><p>对偶性：即<strong>应用线性变换到某个向量</strong>和<strong>与这个向量点乘</strong>等价，即我们可以把<code>1×3</code>的变换（矩阵用来描述变换），立起来（转置），并写成点乘的形式。并把这个向量记为 $\mathbf{\vec p}$ </p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/83-findp.png" alt="" width="600px"></div><p>其中向量的颜色左右对应，并且行列式的值就是右图中平行四面体的体积，然后，我们就把问题进一步变成了：<strong>寻找向量 $\mathbf{\vec p}$ 使得上述等式成立</strong></p><p>根据点积的性质得知，当你把一个向量与其他向量点积的几何解释是，<strong>把其他向量投影到 $\mathbf{\vec p}$ 上，然后将投影长度与 $\mathbf{\vec p}$ 的长度相乘</strong>。而我们知道，对于一个平行六面体来说，<strong>体积等于底面积乘以高</strong>，高于底面积垂直，所以，作为背投影对象的 $\mathbf{\vec p}$ 必须和 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 构成的平面垂直，方面已经找到</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/84-Volum.gif" alt="" width="600px"></div><p>至于长度，可以看到，一个向量与其他向量点积的几何解释是，<strong>把其他向量投影到 $\mathbf{\vec p}$ 上，然后将投影长度与 $\mathbf{\vec p}$ 的长度相乘</strong>，其中投影长度就是 $(x,y,z)$ 向量的长度，根据公式的形式，可以观察得，向量 $\mathbf{\vec p}$ 的长度作为第二项，只有当长度等于平行四面体面积时，上述公式（图片中的点积=行列式值的公式）才能成立。</p><p>至此，又一次利用<strong>对偶性</strong>发现了一些事物之间<strong>自然而又出乎意料</strong>的<strong>对应关系</strong>。通过几何直观来了解计算公式的由来，也是一种加深印象，深刻理解的有效途径</p><h2 id="总结-2"><a href="#总结-2" class="headerlink" title="总结"></a>总结</h2><p>在这里总结一下涉及到的过程，也可以通过阅读看看是否直观的理解每句话来判断<strong>掌握程度</strong></p><ul><li>首先定义了一个三维空间到数轴的<strong>线性变换（函数 $f()$ ）</strong>，它是根据向量 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 来定义的</li><li>接着通过两种不同的方式来<strong>考虑这个变换的对偶向量</strong><ul><li>这种计算方法引导你在第一列中插入 $\hat {\imath}$ $\hat {\jmath}$ $\hat k$ ，然后计算<strong>行列式</strong></li><li>在几何直观上，这个<strong>对偶向量</strong>一定与 $\mathbf{\vec v}$ 和 $\mathbf{\vec w}$ 垂直，并且<strong>其长度与这两个向量张成的平行四边形的面积相同</strong></li></ul></li></ul><h1 id="基变换"><a href="#基变换" class="headerlink" title="基变换"></a>基变换</h1><blockquote><p>数学是一门赋予不同事物相同名称的艺术 ——昂利·庞加莱</p><p>Mathematics is the art of givinh the same name to different things -Henri Poincare</p></blockquote><h2 id="坐标系与基向量"><a href="#坐标系与基向量" class="headerlink" title="坐标系与基向量"></a>坐标系与基向量</h2><p>坐标系指：发生在向量与一组数之间的任意转化，如果假设有一个向量，使用 $\hat {\imath}$ 和 $\hat {\jmath}$ 来描述是 $[\begin{smallmatrix} 3 \\ 2 \end{smallmatrix}]$ ，我们把这种描述称为：<strong>我们的语言</strong>。如果有另一组基向量，$\hat {\imath}’ = [\begin{smallmatrix} 2 \\ 1 \end{smallmatrix}]  $ 和 $\hat {\jmath}’ = [\begin{smallmatrix} -1 \\ 1 \end{smallmatrix}]$ （写成<strong>列向量的形式</strong>是为了形式上的统一）来描述同样一个向量变成 $[\begin{smallmatrix} \frac{5}{3} \\ \frac{1}{3} \end{smallmatrix}]$ ，我们把这种语言记为：<strong>詹妮弗的语言</strong></p><h2 id="基变换-1"><a href="#基变换-1" class="headerlink" title="基变换"></a>基变换</h2><p>我们在之前的解释中已经说明了，在不同的【语言】之间的转化使用<strong>矩阵向量乘法</strong>，在上面的例子中，转移矩阵是 $\mathbf T = [\begin{smallmatrix} 2 &amp; -1 \\ 1 &amp; 1 \end{smallmatrix}]$ ，矩阵的列表示用<strong>我们的语言</strong>表达<strong>詹妮弗的基向量</strong>，称为<strong>基变换</strong>。</p><p>反过来，就是求转移矩阵的逆 $\mathbf T^{-1}$ ，称为<strong>基变换矩阵的逆</strong>，作用是可以表示从詹妮弗的基向量转换回我们的语言需要做的变换。 </p><h2 id="如何转化一个矩阵"><a href="#如何转化一个矩阵" class="headerlink" title="如何转化一个矩阵"></a>如何转化一个矩阵</h2><p>接下来使用一个具体的例子：<strong>变换左旋转90°</strong>，在我们的语言中，和詹妮弗的语言分别是如何互相转换的来加深印象</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/91-Trans.gif" alt="" width="600px"></div><ul><li>左乘<strong>基变换矩阵（矩阵的列代表的是用我们的语言描述詹妮弗语言的基向量）</strong>：需要被转换的詹妮弗的语言：$[\begin{smallmatrix} -1 \\ 2 \end{smallmatrix}]$ ➜ 使用<strong>我们的语言描述</strong>来描述同一个向量</li><li>左乘<strong>线性变换矩阵（表示的变化为：左旋转90°）</strong>：➜变换的后的向量（还是以我们的语言来描述）</li><li>左乘<strong>基变换矩阵的逆</strong>：➜变换后的向量（用<strong>詹妮弗的语言</strong>来描述）</li></ul><p>这三个矩阵合起来就是<strong>用詹妮弗语言描述的一个线性变换</strong></p><h2 id="总结-3"><a href="#总结-3" class="headerlink" title="总结"></a>总结</h2><p>表达式 $\mathbf A^{-1} \mathbf M \mathbf A$ 暗示着一种<strong>数学上的转移作用</strong></p><ul><li>中间的 $\mathbf M$ 代表一种你所见的转换（例子中的90°旋转变换）</li><li>两侧的矩阵 $\mathbf A$ 代表着转移作用（不同坐标系间的<strong>基向量转换</strong>），即就是<strong>视角上的转换</strong></li><li><strong>矩阵乘积仍然表示着同一个变换</strong>，只不过从其他人的角度来看</li></ul><p>这给了很多域变换的应用一个直观的理解，把这简单的几行记录清晰，</p><h1 id="特征向量与特征值"><a href="#特征向量与特征值" class="headerlink" title="特征向量与特征值"></a>特征向量与特征值</h1><p>在这一部分中，你会发现，前面提到的所有几何直观：线性变换，行列式，线性方程组，基变换会穿插其中。不仅给了你一个机会检验之前的理解是否深刻（在这一节，会添加一些超链接，方便你进行复习和定位），更多的，现在，<strong>是拼装起来感受成就感的时刻了！</strong></p><h2 id="What"><a href="#What" class="headerlink" title="What"></a>What</h2><p>首先，我们假设坐标系的一个基变换（对  $\hat {\imath}$ 和 $\hat {\jmath}$ <a href="#张成的空间 Span">张成的空间</a>做一个<a href="#矩阵与线性变换">线性变换</a> ），即 $\hat {\imath}’ = [\begin{smallmatrix}  3\\ 0 \end{smallmatrix}]  $ 和 $\hat {\jmath}’ = [\begin{smallmatrix} 1 \\ 2 \end{smallmatrix}]$ 。在变换的过程中，空间内大部分的向量都离开了它所张成的空间（即这个向量原点到终点构成的直线） ，还有一部分向量留在了它所张成的空间，<strong>矩阵对它仅仅是拉伸或者压缩而已</strong>，如同一个<strong>标量</strong>。</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/101-LeaveStay.gif" alt="" width="600px"></div><p>如上图，是给出例子中，<strong>x轴</strong>所有向量被伸长为原来的<strong>3倍</strong>，一个明显留在张成空间内的例子。另一个比较隐藏的，是$(-1,1)$这个向量，其中的任意一个向量被伸长为原来的<strong>2倍</strong></p><ul><li>变换中被留在张成空间内的向量，就是特征向量（上例x轴和$(-1,1)$）</li><li>其中每个向量被<strong>拉伸或抽缩的比例因子</strong>，就是特征值（上例<strong>3和2</strong>）</li><li>正负表示变换的过程中是否切翻转了方向</li></ul><h2 id="Why"><a href="#Why" class="headerlink" title="Why"></a>Why</h2><p>三维情况，如果能找到这个<strong>不变的向量</strong>，即旋转轴（<strong>特征值必须为1</strong>）</p><p>理解线性变换的作用的<strong>关键</strong>（或者说更好的描述一个变换），更好的方法是<strong>求出它的特征向量和特征值</strong></p><h2 id="How"><a href="#How" class="headerlink" title="How"></a>How</h2><p>从计算角度来看特征值和特征向量，里面包含了很多对以前只是回顾和整合</p><p>根据特征向量和特征值的定义，使用数学的方法来表示即<br>$$<br>\mathbf A \mathbf{\vec v} = \lambda \mathbf{\vec v}<br>$$</p><blockquote><p> $\mathbf A$ 是求特征值和特征向量的变换矩阵；$\mathbf{\vec v}$ 是特征向量；$\lambda$ 是特征值；目标是找 $\mathbf{\vec v}$ 和 $\lambda$ </p></blockquote><p>至于为何会用这个式子来定义特征向量和特征值呢，我们继续观察这个式子中的 $\lambda \mathbf{\vec v}$ ，考虑到右边是一个矩阵乘法，我们希望左右都是一个矩阵乘法，这样方便等价和计算。观察发现，$\lambda \mathbf{\vec v}$ 就是<strong>给 $\mathbf{\vec v}$ 中每一个元素都乘以 $\lambda$</strong> 。对角矩阵 $\mathbf I$ 且对角线元素为 $\lambda$ 的矩阵也能有同样的变换结果，得到下列表达式<br>$$<br>\mathbf A \mathbf{\vec v} = (\lambda \mathbf I ) \mathbf{\vec v} \implies (\mathbf A - \lambda \mathbf I ) \mathbf{\vec v} = 0<br>$$<br>观察这个等式你会发现：<strong>可以把 $\mathbf A - \lambda \mathbf I$ 矩阵看成一个对 $\mathbf{\vec v}$ 矩阵的<a href="#变换">变换</a>，目的是把 $\mathbf{\vec v}$ 压缩到更低的维度。而空间压缩对应的恰好就是变换矩阵的<a href="#行列式">行列式</a>为0</strong>（期待你在品读这句话的时候感受到满满的成就感，实在有难度，再结合下图）</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/102-Lambda.gif" alt="" width="600px"></div><p>上图显示随 $\lambda$ 可视化的变化情况，从这幅图中，使用的例子是 $[\begin{smallmatrix} 2 &amp; 2 \\ 1 &amp; 3 \end{smallmatrix}]$ ，特征值恰好是1</p><h2 id="特征向量的特殊情况"><a href="#特征向量的特殊情况" class="headerlink" title="特征向量的特殊情况"></a>特征向量的特殊情况</h2><h3 id="旋转变换"><a href="#旋转变换" class="headerlink" title="旋转变换"></a>旋转变换</h3><p>解出特征值能发现答案是 $\pm i$ ，<strong>没有特征向量存在</strong>，即特征值出现复数的情况一般对应于变换中的某种旋转</p><h3 id="剪切变换"><a href="#剪切变换" class="headerlink" title="剪切变换"></a>剪切变换</h3><p>Shear变换。x轴不变，只有一个特征值，为1（$(\lambda-1)^2=0$）</p><h3 id="伸缩变换"><a href="#伸缩变换" class="headerlink" title="伸缩变换"></a>伸缩变换</h3><p>特征值只有一个，但是是<strong>空间中所有的向量都是特征向量</strong></p><h2 id="特征基"><a href="#特征基" class="headerlink" title="特征基"></a>特征基</h2><p>对角矩阵：只有对角线非零的矩阵。解读它的方法是：<strong>所有的基向量都是特征向量</strong>。因为之前提到过，矩阵的第一列是 $\hat {\imath}$ ，第二列是 $\hat {\jmath}$ ，往后同理。这样就能发现，如果一列只有对应的位置非零，那么这个坐标轴本身就就是<strong>特征向量</strong></p><p>一组基向量（同样是特征向量）构成的集合被称为一组：<strong>特征基</strong></p><p>对角矩阵有一个好处是计算方便，多次矩阵乘法非常容易</p><p>这时我们就希望利用对角矩阵（基向量为特征向量）的便于计算的特性，利用上一节提到的<strong>基向量变换的方法</strong>，把特征向量作为基，对每一个矩阵进行变换后再进行计算，最后再<strong>左乘变换矩阵的逆</strong>求回原矩阵得到结果，如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/103-EigenBasis.gif" alt="" width="600px"></div><p>但需要说明的是，并不是所有的矩阵都能对角化，比如<strong>Shear变换</strong>，它的特征向量不够多，不足以张成一个空间</p><h1 id="抽象向量空间"><a href="#抽象向量空间" class="headerlink" title="抽象向量空间"></a>抽象向量空间</h1><p>线性代数的一切概念，如行列式和特征向量，它们并<strong>不受所选坐标系</strong>的影响，但是这两者是暗含于<strong>空间</strong>中的性质</p><p>这里所说的空间是什么意思呢？</p><h2 id="函数与向量"><a href="#函数与向量" class="headerlink" title="函数与向量"></a>函数与向量</h2><p>从某种意义上来说，<strong>函数实际上也只是另一种向量</strong>，对于函数来说，也有可加性，可比性</p>$$(f+g)(x) = f(x)+g(x)\\(2f)(x) = 2f(x)$$<p>你能发现，这两个性质和向量加法与向量乘法是息息相关的。所以我们对于矩阵中所有定义的概念和方法，都可以相对应的应用到函数中。如<strong>函数的线性变换</strong>：函数接受一个函数，并把它变成另一个函数。如微积分中可以找到一个形象的例子——<strong>导数</strong>。关于这一点，你听到的可能是【算子】，而不是【变换】，但他们所要表达的思想是一样的</p><p>以导数为例，既然两者是一个东西，那么我们<strong>可不可以使用矩阵来描述多项式空间呢</strong>？</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/111-Polynomial.png" alt="" width="600px"></div><p>如上图，以取 $x$ 的不同幂次方作为<strong>基函数</strong>，然后既可以写出<strong>求导变换</strong>的矩阵。这更进一步佐证了开篇提到的关键句子，<strong>矩阵 = 变换的数字表达</strong></p><table><thead><tr><th style="text-align:center">线性代数</th><th style="text-align:center">函数</th></tr></thead><tbody><tr><td style="text-align:center">线性变换</td><td style="text-align:center">线性算子</td></tr><tr><td style="text-align:center">点积</td><td style="text-align:center">内积</td></tr><tr><td style="text-align:center">特征向量</td><td style="text-align:center">特征函数</td></tr></tbody></table><p>如上表一样，相同的概念只是在不同的领域有着不同的名称罢了。</p><p>有很多<strong>类似向量的不同事物</strong>，只要你处理的对象具有<strong>合理的数乘和相加</strong>的概念，线性代数中所有关于向量，线性变换和其他的概念都应该使用与它。作为数学家，你可能希望你发现的规律不只对一个特殊情况适用，对其他<strong>类似向量的事物</strong>都有<strong>普适性</strong></p><h2 id="向量空间"><a href="#向量空间" class="headerlink" title="向量空间"></a>向量空间</h2><p>这些<strong>类似向量的事物</strong>，比如箭头、一组数、函数等，他们构成的集合被称为：<strong>向量空间</strong></p><p>向量加法和向量数乘的规则 - 被称为<strong>公理</strong>，如下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/06/【直观详解】线性代数的本质/112-Rules.png" alt="" width="800px"></div><p>它仅仅是一个待查列表，以保证向量加法和数乘的概念确实是你所希望的那样。这些公理是一种媒介，<strong>用来连接数学家和所有想要把这些结论应用于新的向量空间的人</strong></p><p><strong>仅仅根据这些公理描述一个空间</strong>，而不是集中于某一个特定的向量上。简而言之，这就是为什么你阅读的每一本教科书都会根据可加性和成比例来定义线性变换</p><h2 id="总结-4"><a href="#总结-4" class="headerlink" title="总结"></a>总结</h2><p>对于【向量是什么】这个问题，<strong>数学家会直接忽略不作答</strong>。向量的形式并不重要，<strong>只要相加和数乘的概念遵守八条公理即可</strong>。就和问“3”究竟是什么一样。在数学中，他被看作是所有三个东西的集合的抽象概念，从而让你用一个概念就能推导出所有三个东西的集合。向量也是如此，它有很多种体现，但是数学把它抽象成【向量空间】这样一个无形（抽象）的概念</p><p><strong>普适的代价是抽象（abstractness is the price of generality）</strong>。学习的过程只能<strong>来源于解决问题，来源于带有思考的不断重复</strong>，但如果你<strong>具备了正确的直观</strong>，你会再以后的学习中<strong>更加高效</strong></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】1小时左右 words 14069words&lt;br&gt;【内容简介】&lt;strong&gt;将只停留在数值运算和公式的线性代数推进到可视化几何直观（Visual Geometric Intuition）的领悟上&lt;/strong&gt;，致敬&lt;a href=&quot;http://www.bilibili.com/video/av6731067/&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;3B1B的系列视频&lt;/a&gt;的笔记，动图也都来自于视频。内容涉及到基变换，叉积，逆矩阵，点积，特征向量与特征值。每一章节都有一句经典的名言，非常有启发性&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
      <category term="Linear Algebra" scheme="https://charlesliuyx.github.io/tags/Linear-Algebra/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】什么是PCA、SVD</title>
    <link href="https://charlesliuyx.github.io/2017/10/05/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AFPCA%E3%80%81SVD/"/>
    <id>https://charlesliuyx.github.io/2017/10/05/【直观详解】什么是PCA、SVD/</id>
    <published>2017-10-05T10:31:12.000Z</published>
    <updated>2017-10-17T17:43:59.682Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】<br>【内容简介】</p><a id="more"></a><p>在说明一个解释型内容的过程中，我一直坚信，<strong>带有思考的重复的是获取的知识的唯一捷径</strong>，所以会加入很多括号的内容，即<strong>另一种说法（从不同角度或其他称呼等）</strong>，这样有助于理解。加粗的地方我也认为是比较重要的关键字或者逻辑推导，学习有一个途径就是划重点，做笔记。</p><h1 id="What-amp-Why-PCA（主成分分析）"><a href="#What-amp-Why-PCA（主成分分析）" class="headerlink" title="What &amp; Why PCA（主成分分析）"></a>What &amp; Why PCA（主成分分析）</h1><p>PCA，Principal components analyses，主成分分析。广泛应用于降维，有损数据压缩，特征提取和数据可视化。也被称为<strong>Karhunen-Loeve变换</strong></p><p>从<strong>降维的方法</strong>角度来看，有<strong>两种PCA的定义方式</strong>，这里需要有一个直观的理解：什么是变换（线性代数基础），想整理一下自己线性代数的可以移步我的另一篇文章：<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">【直观详解】线性代数的本质</a></p><p>但是总的来说，PCA的核心目的是<strong>寻找一个方向（找到这个方向意味着二维中的点可以被压缩到一条直线上，即降维）</strong>，这个方向可以：</p><ul><li><strong>最大化</strong>正交投影后数据的方差（让数据在经过变换后<strong>更加分散</strong>）</li></ul><div align="center"><img src="//charlesliuyx.github.io/2017/10/05/【直观详解】什么是PCA、SVD/PCA.png" alt="往低维度的投影直观表示图" width="500px"></div><blockquote><p>紫色的直线 $u_1$ 即是关于 ${x_1,x_2}$ 二维的正交投影的对应一维表示<br>PCA定义为使<strong>绿色点集的方差最小</strong>（方差是尽量让绿色所有点都<strong>聚在一坨</strong>）<br>其中的蓝线是原始数据集（红点）到<strong>低纬度的距离</strong>，这可以引出第二种定义方式</p></blockquote><ul><li><strong>最小化</strong>投影造成的损失（下图中<strong>所有红线（投影造成的损失）</strong>加起来最小）</li></ul><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/10/05/【直观详解】什么是PCA、SVD/PCAani.gif" alt="投影造成的损失" title="">                </div>                <div class="image-caption">投影造成的损失</div>            </figure><p>PCA 主成分分析主要目的是为了<strong>减少数据维数</strong>，其中Auto-encoder也是一种精巧的降维手段</p><h1 id="What-amp-Why-SVD（奇异值分解）"><a href="#What-amp-Why-SVD（奇异值分解）" class="headerlink" title="What &amp; Why SVD（奇异值分解）"></a>What &amp; Why SVD（奇异值分解）</h1><p>SVD，Singular Value Decomposition，奇异值分解。最直观的解释如下图所示</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/05/【直观详解】什么是PCA、SVD/SVD.svg" alt="往低维度的投影直观表示图" width="500px"></div><p>我们知道，<strong>矩阵描述的是一种变换</strong>（如果对这个概念有疑惑的，欢迎移步我的博客笔记：<a href="https://charlesliuyx.github.io/2017/10/06/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E7%BA%BF%E6%80%A7%E4%BB%A3%E6%95%B0%E7%9A%84%E6%9C%AC%E8%B4%A8/">线性代数的本质</a>）奇异值分解是矩阵分解的其中一种。换句话说，从上图的圆<strong>变换</strong>为右边的椭圆，通过一个 $\mathbf M$ 矩阵就可以做到，但是，我们知道，非方阵是很不好处理的，<strong>我们希望，可以把 $\mathbf M$ 矩阵表示的变换，分解为其他几种变换的组合（注意，分解之后，被分解的分量包含 $\mathbf M$ 的信息，我们可以使用这些分量来进行操作），这几个变换我们希望是方阵，或者有特殊的性质。</strong></p>$$\mathbf M = \mathbf U \cdot \mathbf \Sigma \cdot \mathbf V^*$$<blockquote><p>$\mathbf M$ 是一个<code>m×n</code>阶矩阵（输入为<code>n</code>维向量，输出为<code>m</code>维向量</p><p>$\mathbf U$ 的列组成一套基向量，<code>m×m</code>阶矩阵，为$\mathbf M \mathbf M^*$ 的<strong>特征向量</strong></p><p>$\mathbf \Sigma$ 对角矩阵，对角线上的值称为奇异值，可视为在输入与输出之间进行的标量的“伸缩尺度控制”。为 $\mathbf M \mathbf M^*$ 或 $\mathbf M^* \mathbf M$ 的非零<strong>特征值</strong>的平方根</p><p>$\mathbf V^*$ 是 $\mathbf V$ 的共轭转置（实数域即 $\mathbf V^T$），<code>n×n</code>阶矩阵，$\mathbf V$ 的列组成一套基向量，为 $\mathbf M^* \mathbf M$ 的<strong>特征向量</strong></p></blockquote><p>这里我们发现这个 $\mathbf U$ 还有 $\mathbf V$ 都是<strong>方阵</strong>，恰好满足之前的需求</p><p>且有 $\mathbf U \mathbf U^T = \mathbf I_n$ 同时 $\mathbf V \mathbf V^T = \mathbf I_m$ ，所以 $\mathbf U$ 和 $\mathbf V$ 是<strong>正交矩阵</strong>，而我们知道，正交矩阵对应的变换，就是<strong>旋转变换</strong></p><p>对于 $\mathbf \Sigma$ 来说，我们知道特征值就是表示的度量伸缩程度的因子，即上图中的<strong>伸缩压缩程度</strong>（图中很直观的体现了这一点）</p><p>总结，SVD就是把一个非方阵（压缩变换）分解为一个旋转➜伸缩压缩➜旋转三个变换（矩阵），如上图所示</p><h1 id="How-PCA"><a href="#How-PCA" class="headerlink" title="How PCA"></a>How PCA</h1>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】&lt;br&gt;【内容简介】&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】什么是正则化</title>
    <link href="https://charlesliuyx.github.io/2017/10/03/%E3%80%90%E7%9B%B4%E8%A7%82%E8%AF%A6%E8%A7%A3%E3%80%91%E4%BB%80%E4%B9%88%E6%98%AF%E6%AD%A3%E5%88%99%E5%8C%96/"/>
    <id>https://charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/</id>
    <published>2017-10-03T10:10:12.000Z</published>
    <updated>2018-03-06T22:14:44.327Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】7min - 9min<br>【内容简介】主要解决<strong>什么是正则化，为什么使用正则化，如何实现正则化</strong>，外加一些对<strong>范数</strong>的直观理解并进行知识整理以供查阅</p><a id="more"></a><h1 id="Why-amp-What-正则化"><a href="#Why-amp-What-正则化" class="headerlink" title="Why &amp; What 正则化"></a>Why &amp; What 正则化</h1><p>我们总会在各种地方遇到<strong>正则化</strong>这个看起来很难理解的名词，其实它并没有那么高冷，是很好理解的</p><p>首先，从<strong>使用正则化解决了一个什么问题</strong>的角度来看：<strong>正则化是为了防止过拟合， 进而增强泛化能力</strong>。用白话文转义，<strong>泛化误差</strong>（generalization error）= 测试误差（test error），其实就是使用训练数据训练的模型在测试集上的表现（或说性能 performance）好不好</p><p><img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/Overfitting.png" alt="过拟合" width="500"></p><p>如上图，红色这条“想象力”过于丰富上下横跳的曲线就是过拟合情形。结合上图和正则化的英文 Regularizaiton-Regular-Regularize，<strong>直译应该是：规则化</strong>（加个“化”字变动词，自豪一下中文还是强）。什么是规则？你妈喊你6点前回家吃饭，这就是规则，一个<strong>限制</strong>。同理，在这里，<strong>规则化就是说给需要训练的目标函数加上一些规则（限制），让他们不要自我膨胀</strong>。正则化，看起来，挺不好理解的，追其根源，还是“正则”这两字在中文中实在没有一个直观的对应，如果能翻译成<strong>规则化</strong>，更好理解。但我们一定要明白，搞<strong>学术，概念名词的准确是十分重要</strong>，对于一个<strong>重要唯一确定的概念</strong>，为它安上一个不会产生歧义的名词是必须的，正则化的名称没毛病，只是从如何理解的角度，要灵活和类比。</p><p>我的思考模式的中心有一个理念：<strong>每一个概念</strong>，<strong>被定义</strong>就是为了去<strong>解决一个实际问题（问Why&amp;What），接着寻找解决问题的方法（问How）</strong>，这个“方法”在计算机领域被称为“算法”（非常多的人在研究）。我们无法真正衡量到底是提出问题重要，还是解决问题重要，但我们可以从不同的<strong>解决问题的角度</strong>来思考问题。一方面，<strong>重复</strong>以加深印象。另一方面，具有<strong>多角度的视野</strong>，能让我们获得更多的灵感，真正做到<strong>链接并健壮自己的知识图谱</strong></p><h1 id="How-线性模型角度"><a href="#How-线性模型角度" class="headerlink" title="How 线性模型角度"></a>How 线性模型角度</h1><p><strong>对于线性模型来说，无论是Logistic Regression、SVM或是简单的线性模型，都有一个基函数 $\phi()$，其中有很多 $\mathbf w$ （参数）需要通过对损失函数 $E()$ 求极小值（或最大似然估计）来确定，求的过程，也就是使用训练集的训练过程：梯度下降到最小值点。最终，找到最合适的 $\mathbf w$ 确定模型。</strong>从这个角度来看，正则化是怎么做的呢？</p><h2 id="二次正则项"><a href="#二次正则项" class="headerlink" title="二次正则项"></a>二次正则项</h2><p>我们看一个线性的<strong>损失函数（真实值和预测值的误差）</strong><br>$$E(\mathbf w) =\frac{1}{2} \sum_{n=1}^{N}\{t_n-\mathbf w^T \phi (\mathbf x_n)\}^2 \tag{1}$$</p><blockquote><p>$E(\mathbf w)$ 是<strong>损失函数（又称误差函数）</strong>，<code>E</code>即Evaluate，有时候写成<code>L</code>即Loss<br>$t_n$ 是测试集的真实输出，又称目标变量【对应第一幅图中的蓝色点】<br>$\mathbf w$ 是权重（需要训练的部分，未知数）<br>$\phi()$ 是<strong>基函数</strong>，例如多项式函数，核函数<br>测试样本有<code>n</code>个数据<br>整个函数直观解释就是<strong>误差方差和</strong>，$\frac{1}{2}$ 只是为了<strong>求导后消去方便计算</strong></p></blockquote><p>加<strong>正则化项</strong>，得到最终的<strong>误差函数（Error function）</strong><br>$$\frac{1}{2} \sum_{n=1}^{N}\{t_n-\mathbf w^T \phi (\mathbf x_n)\}^2 + \frac{\lambda}{2} \mathbf w^T \mathbf w \tag{2}$$</p><blockquote><p>(2)式被称为目标函数（评价函数）= 误差函数（损失函数） + 正则化项<br>$\lambda$ 被称为正则化系数，<strong>越大，这个限制越强</strong></p></blockquote><p>2式对 $\mathbf w$ 求导，并令为0（<strong>使误差最小</strong>），可以解得</p>$$\mathbf w = (\lambda \mathbf I + \Phi^T \Phi)^{-1}\Phi^T\mathbf t$$<p>这是<strong>最小二乘法的解形式</strong>，所以在题目中写的是从“最小二乘角度”。至于为何正则化项是 $\frac{\lambda}{2} \mathbf w^T \mathbf w$ 在之后马上解释</p><h2 id="一般正则项"><a href="#一般正则项" class="headerlink" title="一般正则项"></a>一般正则项</h2><p>直观的详解为什么要选择二次正则项。首先，需要从一般推特例，然后分析特例情况的互相优劣条件，可洞若观火。<strong>一般正则项</strong>是以下公式的形式</p>$$\frac{1}{2} \sum_{n=1}^{N}\{t_n-\mathbf w^T \phi (\mathbf x_n)\}^2 + \frac{\lambda}{2} \sum_{j=1}^{M} {\vert w_j \vert}^q \tag{3}$$<blockquote><p><code>M</code>是模型的阶次（表现形式是数据的维度），比如<code>M=2</code>，就是一个平面（二维）内的点</p></blockquote><p>若<code>q=2</code>就是二次正则项。高维度没有图像表征非常难以理解，那就使用二维作为特例来理解。这里令<code>M=2</code>，即 $\mathbf x =\{x_1,x_2\} \;\mathbf w=\{w_1,w_2\}$  ，令<code>q=0.5</code> <code>q=1</code> <code>q=2</code> <code>q=4</code> 有</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/Dq.png" alt="正则项的边缘直观表示"></div><blockquote><p>横坐标是$w_1$<br>纵坐标是$w_2$<br>绿线是<strong>等高线的其中一条</strong>，换言之是一个<strong>俯视图</strong>，而<strong>z轴代表</strong>的是 $ \frac{\lambda}{2} \sum_{j=1}^{M} {\vert w_j \vert}^q$ 的值</p></blockquote><p>空间想象力不足无法理解的读者希望下方的三维图像能给你一个直观的领悟（与绿线图一一对应）</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/qAll.png" alt="正则项的边缘直观表示"></div><p><code>q=2</code>是一个圆非常好理解，考虑  $z = w_1^2 + w_2^2 $  就是抛物面，俯视图是一个圆。其他几项同理（必须强调<strong>俯视图和等高线的概念</strong>，z轴表示的是正则项项的值）</p><p><img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/Dq2.png" alt="正则项的边缘直观表示"></p><blockquote><p>蓝色的圆圈表示没有经过限制的<strong>损失函数在寻找最小值过程</strong>中，$\mathbf w$的不断迭代（随最小二乘法，最终目的还是使损失函数最小）变化情况，<strong>表示的方法是等高线，z轴的值就是</strong> $E(\mathbf w)$<br>$w^*$ 最小值取到的点</p></blockquote><p>可以直观的理解为（帮助理解正则化），我们的目标函数（误差函数）就是<strong>求蓝圈+红圈的和的最小值</strong>（回想等高线的概念并参照3式），而这个值通在很多情况下是<strong>两个曲面相交的地方</strong></p><p>可以看到<strong>二次正则项</strong>的优势，处处可导，方便计算，<strong>限制模型的复杂度，即 $\mathbf w$ 中<code>M</code>的大小，<code>M</code>是模型的阶次</strong>，<code>M</code>越大意味着需要决定的权重越多，所以模型越复杂。在多项式模型多，直观理解是每一个不同幂次的 $x$ 前的系数，0（或很小的值）越多，模型越简单。这就<strong>从数学角度解释了，为什么正则化（规则化）可以限制模型的复杂度，进而避免过拟合</strong></p><p>不知道有没有人发现<strong>一次正则项</strong>的优势，$w^*$ 的位置恰好是 $w_1=0$ 的位置，意味着从另一种角度来说，使用一次正则项可以<strong>降低维度（降低模型复杂度，防止过拟合）二次正则项也做到了这一点，但是一次正则项做的更加彻底</strong>，更稀疏。不幸的是，<strong>一次正则项有拐点</strong>，不是处处可微，给计算带来了难度，很多厉害的论文都是巧妙的使用了一次正则项写出来的，效果十分强大</p><h1 id="How-神经网络模型角度"><a href="#How-神经网络模型角度" class="headerlink" title="How 神经网络模型角度"></a>How 神经网络模型角度</h1><p>我们已经知道，最简单的单层神经网，可以实现简单的线性模型。而多隐含层的神经网络模型如何来<strong>实现正则化</strong>？（毕竟神经网络模型没有目标函数）</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/NNhiden.png" alt="" title="">                </div>                <div class="image-caption"></div>            </figure><blockquote><p><code>M</code>表示单层神经网中隐含层中的神经元的数量</p></blockquote><p>上图展示了神经网络模型过拟合的直观表示</p><p>我们可以通过一系列的推导得知，未来保持神经网络的一致性（即输出的值不能被尺缩变换，或平移变换），在线性模型中的<strong>加入正则项</strong>无法奏效</p><p><strong>所以我们只能通过建立验证集（Validation Set），拉网搜索来确定<code>M</code>的取值（迭代停止的时间），又称为【提前停止】</strong></p><p>这里有一个尾巴，即<strong>神经网络的不变量（invariance）</strong>，我们并不希望加入正则项后出现不在掌控范围内的变化（即所谓图像还是那个图像，不能乱变）。而<strong>机器学习的其中一个核心目的也是去寻找不同事物（对象）的中包含信息的这个不变量（特征）</strong>。卷积神经网络从结构上恰恰实现了这种<strong>不变性</strong>，这也是它强大的一个原因</p><h1 id="范数"><a href="#范数" class="headerlink" title="范数"></a>范数</h1><p>我并不是数学专业的学生，但是我发现在讲完线性模型角度后，有几个概念可以很轻松的解答，就在这里献丑把它们串联起来，并做一些总结以供查阅和对照。</p><p>我们知道，<strong>范数（norm）</strong>的概念来源于<strong>泛函分析与测度理论</strong>，wiki中的定义相当简单明了：<strong>范数是具有“长度”概念的函数</strong>，用于衡量一个<strong>矢量的大小</strong>（测量矢量的测度）</p><p>我们常说测度测度，测量长度，也就是为了表征这个长度。而如何表达“长度”这个概念也是不同的，也就对应了不同的<strong>范数</strong>，本质上说，还是<strong>观察问题的方式和角度不同</strong>，比如那个经典问题，<strong>为什么矩形的面积是长乘以宽？</strong>这背后的关键是欧式空间的<strong>平移不变性</strong>，换句话说，就是面积和长成正比，所以才有这个</p><p>没有<strong>测度论就没有（现代）概率论</strong>。而概率论也是整个机器学习学科的基石之一。测度<strong>就像尺子</strong>，由于测量对象不同，我们需要直尺量布匹、皮尺量身披、卷尺量房间、游标卡尺量工件等等。<strong>注意，“尺子”与刻度（寸、米等）是两回事，不能混淆。</strong></p><p>范数分为<strong>向量范数</strong>（二维坐标系）和<strong>矩阵范数</strong>（多维空间，一般化表达），如果不希望太数学化的解释，那么可以直观的理解为：<strong>0-范数：向量中非零元素的数量；1-范数：向量的元素的绝对值；2-范数：是通常意义上的模（距离）</strong></p><h2 id="向量范数"><a href="#向量范数" class="headerlink" title="向量范数"></a>向量范数</h2><p>关于向量范数，先再把这个图放着，让大家体会到构建知识图谱并串联知识间的本质（根）联系的好处</p><div align="center"><img src="//charlesliuyx.github.io/2017/10/03/【直观详解】什么是正则化/Dq.png" alt="正则项的边缘直观表示"></div><h3 id="p-范数"><a href="#p-范数" class="headerlink" title="p-范数"></a>p-范数</h3> $$\Vert\mathbf x \Vert_p =(\sum\limits_{i=1}^{N}\vert x_i \vert^p)^{\frac{1}{p}}$$<p>向量元素绝对值的p次方和的 $\frac{1}{p}$ 次幂。可以敏捷的发现，这个<code>p</code>和之前的<code>q</code>从是一个东西，<strong>随着<code>p</code>越大，等高线图越接近正方形（正无穷范数）；越小，曲线弯曲越接近原点（负无穷范数）</strong></p><p>而之前已经说明，<code>q</code>的含义是<strong>一般化正则项的幂指数</strong>，也就是我们常说的2范数，两者在形式上是完全等同的。结合范数的定义，我们可以解释<strong>一般化正则项为一种对待求参数 $\mathbf w$ 的测度</strong>，可以用来限制模型不至于过于复杂</p><h3 id="infty-范数"><a href="#infty-范数" class="headerlink" title="$-\infty$-范数"></a>$-\infty$-范数</h3> $$\Vert \mathbf x \Vert_{-\infty} = arg \operatorname*{min}_{i}{\vert x_i \vert}$$ <p>所有<strong>向量元素中绝对值的最小值</strong></p><h3 id="1-范数"><a href="#1-范数" class="headerlink" title="1-范数"></a>1-范数</h3> $$\Vert \mathbf x \Vert_1 = \sum\limits_{i=1}^{N}\vert x_i \vert$$ <p>向量元素<strong>绝对值之和</strong>，也称街区距离（city-block）</p>$$\begin{matrix}4 & 3 & 2 & 3 & 4 \\3 & 2 & 1 & 2 &  3\\2 & 1 & 0 & 1 & 2 \\3 & 2 & 1 & 2 &3  \\4&3 & 2 &3 &4  \\\end{matrix}$$<h3 id="2-范数"><a href="#2-范数" class="headerlink" title="2-范数"></a>2-范数</h3> $\Vert\mathbf x \Vert_2 = \sqrt{\sum\limits_{i=1}^{N} x_i^2}$  ：向量元素的<strong>平方和再开方</strong>。<strong>Euclid范数</strong>，也称<strong>欧几里得范数，欧氏距离</strong><br><br>$$\begin{matrix}2.8&2.2&2&2.2&2.8 \\2.2&1.4&1&1.4&2.2 \\2&1&0&1&2 \\2.2&1.4&1&1.4&2.2 \\2.8&2.2&2&2.2&2.8 \\\end{matrix}$$<h3 id="infty-范数-1"><a href="#infty-范数-1" class="headerlink" title="$\infty$-范数"></a>$\infty$-范数</h3> $\Vert \mathbf x \Vert_{\infty} = arg \operatorname*{max}_{i}{\vert x_i \vert}$  ：所有<strong>向量元素中绝对值的最大值</strong>，也称<strong>棋盘距离（chessboard），切比雪夫距离</strong><br><br>$$\begin{matrix}2 & 3 & 2 & 2 & 2 \\2 & 1 & 1 & 1 &  2\\2 & 1 & 0 & 1 & 2 \\2 & 1 & 1 & 1 &2  \\2&2 & 2 &2 &2 \\\end{matrix}$$<h2 id="矩阵范数"><a href="#矩阵范数" class="headerlink" title="矩阵范数"></a>矩阵范数</h2><h3 id="1-范数-1"><a href="#1-范数-1" class="headerlink" title="1-范数"></a>1-范数</h3> $$\Vert \mathbf A \Vert_{1} = arg \operatorname*{max}_{1 \leqslant j \leqslant n}\sum\limits_{i=1}^m{\vert a_{i,j} \vert}$$<p><strong>列和范数</strong>，即所有<strong>矩阵列向量</strong>绝对值之和的最大值</p><h3 id="infty-范数-2"><a href="#infty-范数-2" class="headerlink" title="$\infty$-范数"></a>$\infty$-范数</h3> $$\Vert \mathbf A \Vert_{\infty} = arg \operatorname*{max}_{1 \leqslant i \leqslant n}\sum\limits_{j=1}^m{\vert a_{i,j} \vert}$$<p><strong>行和范数</strong>，即所有<strong>矩阵行向量</strong>绝对值之和的最大值</p><h3 id="2-范数-1"><a href="#2-范数-1" class="headerlink" title="2-范数"></a>2-范数</h3> $\Vert \mathbf A \Vert_{2} = \sqrt{\lambda_{max}(\mathbf A^* \mathbf A) }$ <p><code>p=2</code><strong>且<code>m=n</code>方阵</strong>时，称为谱范数。矩阵 $\mathbf A$ 的<strong>谱范数</strong>是 $\mathbf A$ 最大的<strong>奇异值</strong>或半正定矩阵 $\mathbf A^T \mathbf A$ 的<strong>最大特征值的平方根</strong></p><blockquote><p>$\mathbf A^*$ 为 $\mathbf A$ 的共轭转置，实数域等同于 $\mathbf A^T$</p></blockquote><h3 id="F-范数"><a href="#F-范数" class="headerlink" title="F-范数"></a>F-范数</h3> $\Vert \mathbf A \Vert_{F} = \sqrt{ \sum\limits_{i=1}^m \sum\limits_{j=1}^n \vert a_{i,j}\vert^2 }$ <p>Frobenius范数（希尔伯特-施密特范数，这个称呼只在希尔伯特空间），即<strong>矩阵元素绝对值的平方和再开平方</strong></p><h3 id="核范数"><a href="#核范数" class="headerlink" title="核范数"></a>核范数</h3><p> $\Vert \mathbf A \Vert_{*} =  \sum\limits_{i=1}^n \lambda_i$ ：$\lambda_i$ 若 $\mathbf A$ <strong>矩阵是方阵，称为本征值</strong>。若<strong>不是方阵，称为奇异值</strong>，即<strong>奇异值/本征值之和</strong></p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>相信每个人在学习过程中都有过看书时，遇到0-范数正则化，或者1-范数正则化，2-范数正则化的表达时很迷惑。写到这里，希望大家能对这些看起来无法理解的晦涩名词有一个融会贯通的理解和感知！</p><p>Learning with intuitive and get Insight</p><p>以上！鞠躬！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】7min - 9min&lt;br&gt;【内容简介】主要解决&lt;strong&gt;什么是正则化，为什么使用正则化，如何实现正则化&lt;/strong&gt;，外加一些对&lt;strong&gt;范数&lt;/strong&gt;的直观理解并进行知识整理以供查阅&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>Pandas-Wiki</title>
    <link href="https://charlesliuyx.github.io/2017/09/30/Pandas-Wiki/"/>
    <id>https://charlesliuyx.github.io/2017/09/30/Pandas-Wiki/</id>
    <published>2017-09-30T02:44:25.000Z</published>
    <updated>2017-10-06T01:32:52.649Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】百科类<br>【内容简介】pandas函数库相关操作手册，供查阅使用。笔记对象来自<a href="https://jizhi.im/blog/post/10min2pandas01" target="_blank" rel="noopener">集智</a><br><a id="more"></a></p><p>必备库的导入</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> pandas <span class="keyword">as</span> pd</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="keyword">import</span> matplotlib.pyplot <span class="keyword">as</span> plt</span><br></pre></td></tr></table></figure><h1 id="创建对象"><a href="#创建对象" class="headerlink" title="创建对象"></a>创建对象</h1><p>创建一个<code>Series</code>对象：传递一个<strong>数值列表</strong>作为参数，令Pandas使用默认索引。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">s = pd.Series([<span class="number">1</span>,<span class="number">3</span>,<span class="number">5</span>,np.nan,<span class="number">6</span>,<span class="number">8</span>])</span><br><span class="line">print(s)</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">0</span>    <span class="number">1.0</span></span><br><span class="line"><span class="number">1</span>    <span class="number">3.0</span></span><br><span class="line"><span class="number">2</span>    <span class="number">5.0</span></span><br><span class="line"><span class="number">3</span>    NaN</span><br><span class="line"><span class="number">4</span>    <span class="number">6.0</span></span><br><span class="line"><span class="number">5</span>    <span class="number">8.0</span></span><br><span class="line">dtype: float64</span><br></pre></td></tr></table></figure><p>创建一个<code>DataFrame</code>对象：传递待datetime索引和列标签的Numpy数组作为参数。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 首先创建一个时间序列</span></span><br><span class="line">dates = pd.date_range(<span class="string">'20130101'</span>, periods=<span class="number">6</span>)</span><br><span class="line">print(dates)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 创建DataFrame对象，指定index和columns标签</span></span><br><span class="line">df = pd.DataFrame(np.random.randn(<span class="number">6</span>,<span class="number">4</span>), index=dates, columns=list(<span class="string">'ABCD'</span>))</span><br><span class="line">print(df)</span><br><span class="line">&gt; </span><br><span class="line">DatetimeIndex([<span class="string">'2013-01-01'</span>, <span class="string">'2013-01-02'</span>, <span class="string">'2013-01-03'</span>, <span class="string">'2013-01-04'</span>,</span><br><span class="line">               <span class="string">'2013-01-05'</span>, <span class="string">'2013-01-06'</span>],</span><br><span class="line">              dtype=<span class="string">'datetime64[ns]'</span>, freq=<span class="string">'D'</span>)</span><br><span class="line">                   A         B         C         D</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.194508</span> <span class="number">-0.897507</span>  <span class="number">0.224745</span>  <span class="number">0.090260</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span>  <span class="number">0.190971</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span>  <span class="number">2.058357</span> <span class="number">-0.882345</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span> <span class="number">-0.680309</span> <span class="number">-0.519155</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>  <span class="number">2.223284</span> <span class="number">-0.305247</span> <span class="number">-0.559043</span>  <span class="number">1.017710</span></span><br></pre></td></tr></table></figure><p>也可以传递词典来构建<code>DataFrame</code>，该词典的元素是形如<code>Series</code>的对象。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line">df2 = pd.DataFrame(&#123; <span class="string">'A'</span> : <span class="number">1.</span>, <span class="string">'B'</span> : pd.Timestamp(<span class="string">'20130102'</span>), <span class="string">'C'</span> : pd.Series(<span class="number">1</span>,index=list(range(<span class="number">4</span>)),dtype=<span class="string">'float32'</span>), <span class="string">'D'</span> : np.array([<span class="number">3</span>] * <span class="number">4</span>,dtype=<span class="string">'int32'</span>), <span class="string">'E'</span> : pd.Categorical([<span class="string">"test"</span>,<span class="string">"train"</span>,<span class="string">"test"</span>,<span class="string">"train"</span>]), <span class="string">'F'</span> : <span class="string">'foo'</span> &#125;)</span><br><span class="line"></span><br><span class="line">print(df2)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 查看df2对象各列的数据类型</span></span><br><span class="line">print(df2.dtypes)</span><br><span class="line">&gt;</span><br><span class="line">     A          B    C  D      E    F</span><br><span class="line"><span class="number">0</span>  <span class="number">1.0</span> <span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">1.0</span>  <span class="number">3</span>   test  foo</span><br><span class="line"><span class="number">1</span>  <span class="number">1.0</span> <span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">1.0</span>  <span class="number">3</span>  train  foo</span><br><span class="line"><span class="number">2</span>  <span class="number">1.0</span> <span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">1.0</span>  <span class="number">3</span>   test  foo</span><br><span class="line"><span class="number">3</span>  <span class="number">1.0</span> <span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">1.0</span>  <span class="number">3</span>  train  foo</span><br><span class="line">A           float64</span><br><span class="line">B    datetime64[ns]</span><br><span class="line">C           float32</span><br><span class="line">D             int32</span><br><span class="line">E          category</span><br><span class="line">F            object</span><br><span class="line">dtype: object</span><br></pre></td></tr></table></figure><h1 id="观察数据"><a href="#观察数据" class="headerlink" title="观察数据"></a>观察数据</h1><p>查看一个<code>DataFrame</code>对象的<strong>前几行和最后几行</strong>。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line">print(df.head())</span><br><span class="line">print(df.tail(<span class="number">3</span>))</span><br><span class="line"><span class="comment"># 默认情况下，.head()和.tail()输出首尾的前5行，也可以手动指定输出行数。</span></span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C         D</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.194508</span> <span class="number">-0.897507</span>  <span class="number">0.224745</span>  <span class="number">0.090260</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span>  <span class="number">0.190971</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span>  <span class="number">2.058357</span> <span class="number">-0.882345</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span> <span class="number">-0.680309</span> <span class="number">-0.519155</span></span><br><span class="line">                   A         B         C         D</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span>  <span class="number">2.058357</span> <span class="number">-0.882345</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span> <span class="number">-0.680309</span> <span class="number">-0.519155</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>  <span class="number">2.223284</span> <span class="number">-0.305247</span> <span class="number">-0.559043</span>  <span class="number">1.017710</span></span><br></pre></td></tr></table></figure><p>查看索引(index)，列标签(columns)和Numpy数组形式的内容。 <code>.describe()</code>返回<strong>简约的统计信息，</strong>在工程中非常实用。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 索引</span></span><br><span class="line">print(df.index)</span><br><span class="line">&gt;</span><br><span class="line">DatetimeIndex([<span class="string">'2013-01-01'</span>, <span class="string">'2013-01-02'</span>, <span class="string">'2013-01-03'</span>, <span class="string">'2013-01-04'</span>,<span class="string">'2013-01-05'</span>, <span class="string">'2013-01-06'</span>],dtype=<span class="string">'datetime64[ns]'</span>, freq=<span class="string">'D'</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 列标签</span></span><br><span class="line">print(df.columns)</span><br><span class="line">&gt;</span><br><span class="line">Index([<span class="string">'A'</span>, <span class="string">'B'</span>, <span class="string">'C'</span>, <span class="string">'D'</span>], dtype=<span class="string">'object'</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 数值</span></span><br><span class="line">print(df.values)</span><br><span class="line">&gt;</span><br><span class="line">[[ <span class="number">0.19450849</span> <span class="number">-0.89750748</span>  <span class="number">0.22474509</span>  <span class="number">0.09025968</span>]</span><br><span class="line"> [ <span class="number">2.41214612</span> <span class="number">-1.19185153</span> <span class="number">-1.64473716</span>  <span class="number">0.19097097</span>]</span><br><span class="line"> [<span class="number">-0.67464536</span>  <span class="number">0.39595956</span>  <span class="number">1.42582221</span> <span class="number">-0.71823105</span>]</span><br><span class="line"> [ <span class="number">0.3490457</span>   <span class="number">0.31502599</span>  <span class="number">2.05835699</span> <span class="number">-0.88234524</span>]</span><br><span class="line"> [ <span class="number">1.46709286</span>  <span class="number">0.14693219</span> <span class="number">-0.68030862</span> <span class="number">-0.51915519</span>]</span><br><span class="line"> [ <span class="number">2.2232837</span>  <span class="number">-0.30524727</span> <span class="number">-0.55904285</span>  <span class="number">1.01771006</span>]]</span><br><span class="line"></span><br><span class="line"><span class="comment"># 统计</span></span><br><span class="line">print(df.describe())</span><br><span class="line">&gt;</span><br><span class="line">              A         B         C         D</span><br><span class="line">count  <span class="number">6.000000</span>  <span class="number">6.000000</span>  <span class="number">6.000000</span>  <span class="number">6.000000</span></span><br><span class="line">mean   <span class="number">0.995239</span> <span class="number">-0.256115</span>  <span class="number">0.137473</span> <span class="number">-0.136798</span></span><br><span class="line">std    <span class="number">1.231715</span>  <span class="number">0.663815</span>  <span class="number">1.391936</span>  <span class="number">0.711615</span></span><br><span class="line">min   <span class="number">-0.674645</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span> <span class="number">-0.882345</span></span><br><span class="line"><span class="number">25</span>%    <span class="number">0.233143</span> <span class="number">-0.749442</span> <span class="number">-0.649992</span> <span class="number">-0.668462</span></span><br><span class="line"><span class="number">50</span>%    <span class="number">0.908069</span> <span class="number">-0.079158</span> <span class="number">-0.167149</span> <span class="number">-0.214448</span></span><br><span class="line"><span class="number">75</span>%    <span class="number">2.034236</span>  <span class="number">0.273003</span>  <span class="number">1.125553</span>  <span class="number">0.165793</span></span><br><span class="line">max    <span class="number">2.412146</span>  <span class="number">0.395960</span>  <span class="number">2.058357</span>  <span class="number">1.017710</span></span><br></pre></td></tr></table></figure><p>灵活调教你的DataFrame：转置与排序</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 转置</span></span><br><span class="line">print(df.T)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 按轴排序，逐列递减</span></span><br><span class="line">print(df.sort_index(axis=<span class="number">1</span>, ascending=<span class="keyword">False</span>))</span><br><span class="line"></span><br><span class="line"><span class="comment"># 按值排序，'B'列逐行递增</span></span><br><span class="line">print(df.sort_values(by=<span class="string">'B'</span>))</span><br></pre></td></tr></table></figure><h1 id="选中"><a href="#选中" class="headerlink" title="选中"></a>选中</h1><p>尽管标准Python/Numpy的选中表达式很直观也很适合互动，但在生产代码中还是推荐使用Pandas里的方法如<code>.at</code>,<code>.iat</code>,<code>.loc</code>,<code>.iloc</code>,<code>.ix</code>等。</p><h2 id="获取"><a href="#获取" class="headerlink" title="获取"></a>获取</h2><p><code>DataFrame</code>里选中的一列与<code>Series</code>等效。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line">print(df[<span class="string">"A"</span>]) <span class="comment"># 与df.A相同</span></span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>    <span class="number">0.194508</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>    <span class="number">2.412146</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span>   <span class="number">-0.674645</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>    <span class="number">0.349046</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>    <span class="number">1.467093</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>    <span class="number">2.223284</span></span><br><span class="line">Freq: D, Name: A, dtype: float64</span><br><span class="line"></span><br><span class="line"><span class="comment"># 用[]分割DataFrame</span></span><br><span class="line">print(df[<span class="number">0</span>:<span class="number">3</span>])</span><br><span class="line">print(df[<span class="string">'20130102'</span>:<span class="string">'20130104'</span>])</span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C         D</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.194508</span> <span class="number">-0.897507</span>  <span class="number">0.224745</span>  <span class="number">0.090260</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span>  <span class="number">0.190971</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span></span><br><span class="line">                   A         B         C         D</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span>  <span class="number">0.190971</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span>  <span class="number">2.058357</span> <span class="number">-0.882345</span></span><br></pre></td></tr></table></figure><h2 id="按标签选择"><a href="#按标签选择" class="headerlink" title="按标签选择"></a>按标签选择</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 选中一整行</span></span><br><span class="line">print(df.loc[dates[<span class="number">0</span>]])</span><br><span class="line">&gt;</span><br><span class="line">A    <span class="number">0.194508</span></span><br><span class="line">B   <span class="number">-0.897507</span></span><br><span class="line">C    <span class="number">0.224745</span></span><br><span class="line">D    <span class="number">0.090260</span></span><br><span class="line">Name: <span class="number">2013</span><span class="number">-01</span><span class="number">-01</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>, dtype: float64</span><br><span class="line">        </span><br><span class="line"><span class="comment"># 按标签选中复数列（所有行，输出只显示前5行）</span></span><br><span class="line">print(df.loc[:,[<span class="string">'A'</span>,<span class="string">'B'</span>]])</span><br><span class="line">&gt;</span><br><span class="line">                  A         B</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.194508</span> <span class="number">-0.897507</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>  <span class="number">2.223284</span> <span class="number">-0.305247</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 行/列同时划分（包括起止点）</span></span><br><span class="line">print(df.loc[<span class="string">'20130102'</span>:<span class="string">'20130104'</span>,[<span class="string">'A'</span>,<span class="string">'B'</span>]])</span><br><span class="line">&gt;</span><br><span class="line">                   A         B</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 返回一个元素（两个方法等效）</span></span><br><span class="line">print(df.loc[dates[<span class="number">0</span>],<span class="string">'A'</span>])</span><br><span class="line">print(df.at[dates[<span class="number">0</span>],<span class="string">'A'</span>])</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">0.194508494402</span></span><br><span class="line"><span class="number">0.194508494402</span></span><br></pre></td></tr></table></figure><h2 id="按位置选择"><a href="#按位置选择" class="headerlink" title="按位置选择"></a>按位置选择</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 位置索引为3的行（从0开始，所以其实是第4行）</span></span><br><span class="line">print(df.iloc[<span class="number">3</span>])</span><br><span class="line">&gt;</span><br><span class="line">A    <span class="number">0.349046</span></span><br><span class="line">B    <span class="number">0.315026</span></span><br><span class="line">C    <span class="number">2.058357</span></span><br><span class="line">D   <span class="number">-0.882345</span></span><br><span class="line">Name: <span class="number">2013</span><span class="number">-01</span><span class="number">-04</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>, dtype: float64</span><br><span class="line">        </span><br><span class="line"><span class="comment"># 按位置索引分割DataFrame</span></span><br><span class="line">print(df.iloc[<span class="number">3</span>:<span class="number">5</span>,<span class="number">0</span>:<span class="number">2</span>])</span><br><span class="line">print(df.iloc[[<span class="number">1</span>,<span class="number">2</span>,<span class="number">4</span>],[<span class="number">0</span>,<span class="number">2</span>]])</span><br><span class="line">&gt;</span><br><span class="line">                   A         B</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 直接定位一个特定元素</span></span><br><span class="line">df.iloc[<span class="number">1</span>,<span class="number">1</span>]</span><br><span class="line">df.iat[<span class="number">1</span>,<span class="number">1</span>]</span><br><span class="line">&gt;</span><br><span class="line">                   A         C</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.644737</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">1.425822</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span> <span class="number">-0.680309</span></span><br></pre></td></tr></table></figure><h2 id="布尔值索引"><a href="#布尔值索引" class="headerlink" title="布尔值索引"></a>布尔值索引</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 用一列的值来选择数据</span></span><br><span class="line">print(df.A &gt; <span class="number">0</span>)</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>     <span class="keyword">True</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>     <span class="keyword">True</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span>    <span class="keyword">False</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>     <span class="keyword">True</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>     <span class="keyword">True</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>     <span class="keyword">True</span></span><br><span class="line">Freq: D, Name: A, dtype: bool</span><br><span class="line">      </span><br><span class="line"><span class="comment"># 使用.isin()函数过滤数据</span></span><br><span class="line">df2 = df.copy()</span><br><span class="line">df2[<span class="string">'E'</span>] = [<span class="string">'one'</span>, <span class="string">'one'</span>,<span class="string">'two'</span>,<span class="string">'three'</span>,<span class="string">'four'</span>,<span class="string">'three'</span>]</span><br><span class="line"></span><br><span class="line"><span class="comment"># 提取df2中'E'值属于['two', 'four']的行</span></span><br><span class="line">print(df2[df2[<span class="string">'E'</span>].isin([<span class="string">'two'</span>,<span class="string">'four'</span>])])</span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C         D     E</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span>   two</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>  <span class="number">1.467093</span>  <span class="number">0.146932</span> <span class="number">-0.680309</span> <span class="number">-0.519155</span>  four</span><br></pre></td></tr></table></figure><h2 id="设置"><a href="#设置" class="headerlink" title="设置"></a>设置</h2><p>赋值</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 为DataFrame创建一个新的列，其值为时间顺序（与df相同）的索引值</span></span><br><span class="line">s1 = pd.Series([<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>,<span class="number">6</span>], index=pd.date_range(<span class="string">'20130102'</span>, periods=<span class="number">6</span>))</span><br><span class="line">print(s1)</span><br><span class="line"></span><br><span class="line">df[<span class="string">'F'</span>] = s1</span><br><span class="line"></span><br><span class="line"><span class="comment"># 按标签赋值</span></span><br><span class="line">df.at[dates[<span class="number">0</span>],<span class="string">'A'</span>] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 按索引赋值</span></span><br><span class="line">df.iat[<span class="number">0</span>,<span class="number">1</span>] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 用Numpy数组赋值</span></span><br><span class="line">df.loc[:,<span class="string">'D'</span>] = np.array([<span class="number">5</span>] * len(df))</span><br><span class="line"></span><br><span class="line"><span class="comment"># 最终结果</span></span><br><span class="line">print(df)</span><br></pre></td></tr></table></figure><h1 id="缺失数据"><a href="#缺失数据" class="headerlink" title="缺失数据"></a>缺失数据</h1><p>Pandas默认使用<code>np.nan</code>来代表缺失数据。<code>Reindexing</code>允许用户对某一轴上的索引改/增/删，并返回数据的副本。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 创建DataFrame对象df1，以dates[0:4]为索引，在df的基础上再加一个新的列'E'（初始均为NaN）</span></span><br><span class="line">df1 = df.reindex(index=dates[<span class="number">0</span>:<span class="number">4</span>], columns=list(df.columns) + [<span class="string">'E'</span>])</span><br><span class="line"></span><br><span class="line"><span class="comment"># 将'E'列的前两个行设为1</span></span><br><span class="line">df1.loc[dates[<span class="number">0</span>]:dates[<span class="number">1</span>],<span class="string">'E'</span>] = <span class="number">1</span></span><br><span class="line"></span><br><span class="line">print(df1)</span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C         D    E</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.194508</span> <span class="number">-0.897507</span>  <span class="number">0.224745</span>  <span class="number">0.090260</span>  <span class="number">1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">2.412146</span> <span class="number">-1.191852</span> <span class="number">-1.644737</span>  <span class="number">0.190971</span>  <span class="number">1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.674645</span>  <span class="number">0.395960</span>  <span class="number">1.425822</span> <span class="number">-0.718231</span>  NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>  <span class="number">0.349046</span>  <span class="number">0.315026</span>  <span class="number">2.058357</span> <span class="number">-0.882345</span>  NaN</span><br></pre></td></tr></table></figure><h2 id="处理缺失数据"><a href="#处理缺失数据" class="headerlink" title="处理缺失数据"></a>处理缺失数据</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 剔除df1中含NaN的行（只要任一一列为NaN就算）</span></span><br><span class="line">df1.dropna(how=<span class="string">'any'</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 用5填充df1里的缺失值</span></span><br><span class="line">df1.fillna(value=<span class="number">5</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 判断df1中的值是否为缺失数据，返回True/False</span></span><br><span class="line">pd.isnull(df1)</span><br></pre></td></tr></table></figure><h1 id="操作"><a href="#操作" class="headerlink" title="操作"></a>操作</h1><h2 id="统计"><a href="#统计" class="headerlink" title="统计"></a>统计</h2><p>此类操作<strong>默认排除缺失数据</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 求平均值</span></span><br><span class="line">print(df.mean())</span><br><span class="line">&gt;</span><br><span class="line">A   <span class="number">-0.190821</span></span><br><span class="line">B   <span class="number">-0.050040</span></span><br><span class="line">C   <span class="number">-0.203207</span></span><br><span class="line">D    <span class="number">5.000000</span></span><br><span class="line">F    <span class="number">3.000000</span></span><br><span class="line">dtype: float64</span><br><span class="line">  </span><br><span class="line"><span class="comment"># 指定求平均值的轴</span></span><br><span class="line">print(df.mean(<span class="number">1</span>))</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>    <span class="number">1.264749</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>    <span class="number">1.049748</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span>    <span class="number">1.578067</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>    <span class="number">1.035639</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>    <span class="number">1.855754</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>    <span class="number">1.936110</span></span><br><span class="line">Freq: D, dtype: float64</span><br><span class="line">    </span><br><span class="line"><span class="comment"># 创建Series对象s，以dates为索引并平移2个位置</span></span><br><span class="line">s = pd.Series([<span class="number">1</span>,<span class="number">3</span>,<span class="number">5</span>,np.nan,<span class="number">6</span>,<span class="number">8</span>], index=dates).shift(<span class="number">2</span>)</span><br><span class="line">print(s)</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>    NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>    NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span>    <span class="number">1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span>    <span class="number">3.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span>    <span class="number">5.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>    NaN</span><br><span class="line">Freq: D, dtype: float64</span><br><span class="line"></span><br><span class="line"><span class="comment"># 从df中逐列减去s（若有NaN则得NaN）</span></span><br><span class="line">print(df.sub(s, axis=<span class="string">'index'</span>))</span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C    D    F</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>       NaN       NaN       NaN  NaN  NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>       NaN       NaN       NaN  NaN  NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-1.572312</span>  <span class="number">0.570952</span> <span class="number">-1.108305</span>  <span class="number">4.0</span>  <span class="number">1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span> <span class="number">-3.401496</span> <span class="number">-4.304842</span> <span class="number">-4.115467</span>  <span class="number">2.0</span>  <span class="number">0.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span> <span class="number">-4.955735</span> <span class="number">-5.576715</span> <span class="number">-4.188780</span>  <span class="number">0.0</span> <span class="number">-1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span>       NaN       NaN       NaN  NaN  NaN</span><br></pre></td></tr></table></figure><h2 id="应用"><a href="#应用" class="headerlink" title="应用"></a>应用</h2><p>对<code>DataFrame</code>中的数据<strong>应用函数</strong>。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 逐行累加</span></span><br><span class="line">print(df.apply(np.cumsum))</span><br><span class="line">&gt;</span><br><span class="line">                   A         B         C   D     F</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-01</span>  <span class="number">0.000000</span>  <span class="number">0.000000</span>  <span class="number">0.058997</span>   <span class="number">5</span>   NaN</span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-02</span>  <span class="number">0.277465</span> <span class="number">-0.161767</span> <span class="number">-0.807960</span>  <span class="number">10</span>   <span class="number">1.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-03</span> <span class="number">-0.294847</span>  <span class="number">1.409186</span> <span class="number">-0.916265</span>  <span class="number">15</span>   <span class="number">3.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-04</span> <span class="number">-0.696343</span>  <span class="number">0.104344</span> <span class="number">-2.031732</span>  <span class="number">20</span>   <span class="number">6.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-05</span> <span class="number">-0.652078</span> <span class="number">-0.472372</span> <span class="number">-1.220512</span>  <span class="number">25</span>  <span class="number">10.0</span></span><br><span class="line"><span class="number">2013</span><span class="number">-01</span><span class="number">-06</span> <span class="number">-1.144929</span> <span class="number">-0.300242</span> <span class="number">-1.219241</span>  <span class="number">30</span>  <span class="number">15.0</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 每列的最大值减最小值</span></span><br><span class="line">print(df.apply(<span class="keyword">lambda</span> x: x.max() - x.min()))</span><br><span class="line">&gt;</span><br><span class="line">A    <span class="number">0.849776</span></span><br><span class="line">B    <span class="number">2.875794</span></span><br><span class="line">C    <span class="number">1.926687</span></span><br><span class="line">D    <span class="number">0.000000</span></span><br><span class="line">F    <span class="number">4.000000</span></span><br><span class="line">dtype: float64</span><br></pre></td></tr></table></figure><h2 id="字符"><a href="#字符" class="headerlink" title="字符"></a>字符</h2><p><code>Series</code>对象的<code>str</code>属性具有一系列字符处理方法，<strong>可以很轻松地操作数组的每个元素</strong>。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 字符串变为小写</span></span><br><span class="line">s = pd.Series([<span class="string">'A'</span>, <span class="string">'B'</span>, <span class="string">'C'</span>, <span class="string">'Aaba'</span>, <span class="string">'Baca'</span>, np.nan, <span class="string">'CABA'</span>, <span class="string">'dog'</span>, <span class="string">'cat'</span>])</span><br><span class="line">print(s.str.lower())</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">0</span>       a</span><br><span class="line"><span class="number">1</span>       b</span><br><span class="line"><span class="number">2</span>       c</span><br><span class="line"><span class="number">3</span>    aaba</span><br><span class="line"><span class="number">4</span>    baca</span><br><span class="line"><span class="number">5</span>     NaN</span><br><span class="line"><span class="number">6</span>    caba</span><br><span class="line"><span class="number">7</span>     dog</span><br><span class="line"><span class="number">8</span>     cat</span><br><span class="line">dtype: object</span><br></pre></td></tr></table></figure><h1 id="合并"><a href="#合并" class="headerlink" title="合并"></a>合并</h1><h2 id="连接"><a href="#连接" class="headerlink" title="连接"></a>连接</h2><p>Pandas在join/merge两中情境下提供了支持多种方式，基于逻辑/集合运算和代数运算来连接Series，DataFrame和Panel对象。</p><p>concat()方法连接数组</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">df = pd.DataFrame(np.random.randn(<span class="number">10</span>, <span class="number">4</span>))</span><br><span class="line">print(df)</span><br><span class="line">print(<span class="string">"------"</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 拆分成块</span></span><br><span class="line">pieces = [df[:<span class="number">3</span>], df[<span class="number">3</span>:<span class="number">7</span>], df[<span class="number">7</span>:]]</span><br><span class="line"></span><br><span class="line"><span class="comment"># 重新连接，可得初始数组</span></span><br><span class="line">print(pd.concat(pieces))</span><br></pre></td></tr></table></figure><h2 id="增补"><a href="#增补" class="headerlink" title="增补"></a>增补</h2><p>给DataFrame增补行</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">df = pd.DataFrame(np.random.randn(<span class="number">8</span>, <span class="number">4</span>), columns=[<span class="string">'A'</span>,<span class="string">'B'</span>,<span class="string">'C'</span>,<span class="string">'D'</span>])</span><br><span class="line">print(df)</span><br><span class="line">print(<span class="string">"------"</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 将索引为3的行增补到整个DataFrame最后</span></span><br><span class="line">s = df.iloc[<span class="number">3</span>]</span><br><span class="line">print(df.append(s, ignore_index=<span class="keyword">True</span>))</span><br></pre></td></tr></table></figure><h1 id="组合"><a href="#组合" class="headerlink" title="组合"></a>组合</h1><p>“组合”包含以下步骤：</p><ul><li>基于一定标准将数据分组</li><li>对每个部分分别应用函数</li><li>把结果汇合到数据结构中</li></ul><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 新建DataFrame对象df</span></span><br><span class="line">df = pd.DataFrame(&#123;<span class="string">'A'</span> : [<span class="string">'foo'</span>, <span class="string">'bar'</span>, <span class="string">'foo'</span>, <span class="string">'bar'</span>, <span class="string">'foo'</span>, <span class="string">'bar'</span>, <span class="string">'foo'</span>, <span class="string">'foo'</span>], <span class="string">'B'</span> : [<span class="string">'one'</span>, <span class="string">'one'</span>, <span class="string">'two'</span>, <span class="string">'three'</span>, <span class="string">'two'</span>, <span class="string">'two'</span>, <span class="string">'one'</span>, <span class="string">'three'</span>], <span class="string">'C'</span> : np.random.randn(<span class="number">8</span>), <span class="string">'D'</span> : np.random.randn(<span class="number">8</span>)&#125;)</span><br><span class="line"></span><br><span class="line">print(df)</span><br><span class="line">&gt;</span><br><span class="line">     A      B         C         D</span><br><span class="line"><span class="number">0</span>  foo    one  <span class="number">0.298545</span> <span class="number">-0.101893</span></span><br><span class="line"><span class="number">1</span>  bar    one  <span class="number">1.080680</span> <span class="number">-0.717276</span></span><br><span class="line"><span class="number">2</span>  foo    two  <span class="number">1.365395</span>  <span class="number">0.939482</span></span><br><span class="line"><span class="number">3</span>  bar  three  <span class="number">0.783108</span> <span class="number">-0.575995</span></span><br><span class="line"><span class="number">4</span>  foo    two <span class="number">-1.089990</span> <span class="number">-0.033826</span></span><br><span class="line"><span class="number">5</span>  bar    two  <span class="number">0.442084</span>  <span class="number">1.533146</span></span><br><span class="line"><span class="number">6</span>  foo    one  <span class="number">0.041715</span>  <span class="number">0.190613</span></span><br><span class="line"><span class="number">7</span>  foo  three  <span class="number">0.529231</span>  <span class="number">0.380723</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 对'A'列进行合并并应用.sum()函数</span></span><br><span class="line">print(df.groupby(<span class="string">'A'</span>).sum())</span><br><span class="line">&gt;</span><br><span class="line">            C         D</span><br><span class="line">A                      </span><br><span class="line">bar  <span class="number">2.305871</span>  <span class="number">0.239875</span></span><br><span class="line">foo  <span class="number">1.144897</span>  <span class="number">1.375099</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 对'A', 'B'两列分别合并形成层级结构，再应用.sum()函数</span></span><br><span class="line">print(df.groupby([<span class="string">'A'</span>,<span class="string">'B'</span>]).sum())</span><br><span class="line">&gt;</span><br><span class="line">                  C         D</span><br><span class="line">A   B                        </span><br><span class="line">bar one    <span class="number">1.080680</span> <span class="number">-0.717276</span></span><br><span class="line">    three  <span class="number">0.783108</span> <span class="number">-0.575995</span></span><br><span class="line">    two    <span class="number">0.442084</span>  <span class="number">1.533146</span></span><br><span class="line">foo one    <span class="number">0.340260</span>  <span class="number">0.088720</span></span><br><span class="line">    three  <span class="number">0.529231</span>  <span class="number">0.380723</span></span><br><span class="line">    two    <span class="number">0.275406</span>  <span class="number">0.905656</span></span><br></pre></td></tr></table></figure><h1 id="重塑"><a href="#重塑" class="headerlink" title="重塑"></a>重塑</h1><h2 id="层次化"><a href="#层次化" class="headerlink" title="层次化"></a>层次化</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line">tuples = list(zip(*[[<span class="string">'bar'</span>, <span class="string">'bar'</span>, <span class="string">'baz'</span>, <span class="string">'baz'</span>, <span class="string">'foo'</span>, <span class="string">'foo'</span>, <span class="string">'qux'</span>, <span class="string">'qux'</span>], [<span class="string">'one'</span>, <span class="string">'two'</span>, <span class="string">'one'</span>, <span class="string">'two'</span>, <span class="string">'one'</span>, <span class="string">'two'</span>, <span class="string">'one'</span>, <span class="string">'two'</span>]]))</span><br><span class="line"></span><br><span class="line"><span class="comment"># 多重索引</span></span><br><span class="line">index = pd.MultiIndex.from_tuples(tuples, names=[<span class="string">'first'</span>, <span class="string">'second'</span>])</span><br><span class="line"></span><br><span class="line">df = pd.DataFrame(np.random.randn(<span class="number">8</span>, <span class="number">2</span>), index=index, columns=[<span class="string">'A'</span>, <span class="string">'B'</span>])</span><br><span class="line">df2 = df[:<span class="number">4</span>]</span><br><span class="line"></span><br><span class="line">print(df2)</span><br><span class="line">&gt;</span><br><span class="line">                     A         B</span><br><span class="line">first second                    </span><br><span class="line">bar   one    <span class="number">-1.144920</span> <span class="number">-0.823033</span></span><br><span class="line">      two     <span class="number">0.250615</span> <span class="number">-1.423107</span></span><br><span class="line">baz   one     <span class="number">0.291435</span> <span class="number">-1.580619</span></span><br><span class="line">      two    <span class="number">-0.574831</span> <span class="number">-0.742291</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># .stack()方法将DataFrame的列“压缩”了一级</span></span><br><span class="line">stacked = df2.stack()</span><br><span class="line">print(stacked)</span><br><span class="line">&gt;</span><br><span class="line">first  second   </span><br><span class="line">bar    one     A   <span class="number">-1.144920</span></span><br><span class="line">               B   <span class="number">-0.823033</span></span><br><span class="line">       two     A    <span class="number">0.250615</span></span><br><span class="line">               B   <span class="number">-1.423107</span></span><br><span class="line">baz    one     A    <span class="number">0.291435</span></span><br><span class="line">               B   <span class="number">-1.580619</span></span><br><span class="line">       two     A   <span class="number">-0.574831</span></span><br><span class="line">               B   <span class="number">-0.742291</span></span><br><span class="line">dtype: float64</span><br></pre></td></tr></table></figure><p>对于已经层次化的，具有多重索引的DataFrame或Series，<code>stack()</code>的逆操作是<code>unstack()</code>——默认将最后一级“去层次化”。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line">print(stacked.unstack())</span><br><span class="line">&gt;</span><br><span class="line">                     A         B</span><br><span class="line">first second                    </span><br><span class="line">bar   one    <span class="number">-1.144920</span> <span class="number">-0.823033</span></span><br><span class="line">      two     <span class="number">0.250615</span> <span class="number">-1.423107</span></span><br><span class="line">baz   one     <span class="number">0.291435</span> <span class="number">-1.580619</span></span><br><span class="line">      two    <span class="number">-0.574831</span> <span class="number">-0.742291</span></span><br><span class="line"></span><br><span class="line">print(stacked.unstack(<span class="number">1</span>))</span><br><span class="line">&gt;</span><br><span class="line">second        one       two</span><br><span class="line">first                      </span><br><span class="line">bar   A <span class="number">-1.144920</span>  <span class="number">0.250615</span></span><br><span class="line">      B <span class="number">-0.823033</span> <span class="number">-1.423107</span></span><br><span class="line">baz   A  <span class="number">0.291435</span> <span class="number">-0.574831</span></span><br><span class="line">      B <span class="number">-1.580619</span> <span class="number">-0.742291</span></span><br><span class="line">  </span><br><span class="line">print(stacked.unstack(<span class="number">0</span>))</span><br><span class="line">&gt;</span><br><span class="line">first          bar       baz</span><br><span class="line">second                      </span><br><span class="line">one    A <span class="number">-1.144920</span>  <span class="number">0.291435</span></span><br><span class="line">       B <span class="number">-0.823033</span> <span class="number">-1.580619</span></span><br><span class="line">two    A  <span class="number">0.250615</span> <span class="number">-0.574831</span></span><br><span class="line">       B <span class="number">-1.423107</span> <span class="number">-0.742291</span></span><br></pre></td></tr></table></figure><h2 id="数据透视表"><a href="#数据透视表" class="headerlink" title="数据透视表"></a>数据透视表</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line">df = pd.DataFrame(&#123;<span class="string">'A'</span> : [<span class="string">'one'</span>, <span class="string">'one'</span>, <span class="string">'two'</span>, <span class="string">'three'</span>] * <span class="number">3</span>, <span class="string">'B'</span> : [<span class="string">'A'</span>, <span class="string">'B'</span>, <span class="string">'C'</span>] * <span class="number">4</span>, <span class="string">'C'</span> : [<span class="string">'foo'</span>, <span class="string">'foo'</span>, <span class="string">'foo'</span>, <span class="string">'bar'</span>, <span class="string">'bar'</span>, <span class="string">'bar'</span>] * <span class="number">2</span>, <span class="string">'D'</span> : np.random.randn(<span class="number">12</span>), <span class="string">'E'</span> : np.random.randn(<span class="number">12</span>)&#125;)</span><br><span class="line"></span><br><span class="line">print(df)</span><br><span class="line">&gt;</span><br><span class="line">        A  B    C         D         E</span><br><span class="line"><span class="number">0</span>     one  A  foo <span class="number">-0.411674</span>  <span class="number">0.284523</span></span><br><span class="line"><span class="number">1</span>     one  B  foo <span class="number">-1.217944</span>  <span class="number">1.519293</span></span><br><span class="line"><span class="number">2</span>     two  C  foo  <span class="number">0.502824</span> <span class="number">-0.167898</span></span><br><span class="line"><span class="number">3</span>   three  A  bar  <span class="number">0.565186</span>  <span class="number">0.226860</span></span><br><span class="line"><span class="number">4</span>     one  B  bar  <span class="number">0.626023</span>  <span class="number">0.401529</span></span><br><span class="line"><span class="number">5</span>     one  C  bar <span class="number">-0.437217</span>  <span class="number">0.832881</span></span><br><span class="line"><span class="number">6</span>     two  A  foo <span class="number">-0.825128</span>  <span class="number">0.346303</span></span><br><span class="line"><span class="number">7</span>   three  B  foo  <span class="number">0.069236</span>  <span class="number">0.728729</span></span><br><span class="line"><span class="number">8</span>     one  C  foo  <span class="number">1.647690</span> <span class="number">-0.531091</span></span><br><span class="line"><span class="number">9</span>     one  A  bar <span class="number">-0.881553</span>  <span class="number">0.070718</span></span><br><span class="line"><span class="number">10</span>    two  B  bar  <span class="number">0.203672</span>  <span class="number">1.601761</span></span><br><span class="line"><span class="number">11</span>  three  C  bar  <span class="number">1.334214</span> <span class="number">-0.778639</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 生成数据透视表</span></span><br><span class="line">print(pd.pivot_table(df, values=<span class="string">'D'</span>, index=[<span class="string">'A'</span>, <span class="string">'B'</span>], columns=[<span class="string">'C'</span>]))</span><br><span class="line">&gt;</span><br><span class="line">C             bar       foo</span><br><span class="line">A     B                    </span><br><span class="line">one   A <span class="number">-0.881553</span> <span class="number">-0.411674</span></span><br><span class="line">      B  <span class="number">0.626023</span> <span class="number">-1.217944</span></span><br><span class="line">      C <span class="number">-0.437217</span>  <span class="number">1.647690</span></span><br><span class="line">three A  <span class="number">0.565186</span>       NaN</span><br><span class="line">      B       NaN  <span class="number">0.069236</span></span><br><span class="line">      C  <span class="number">1.334214</span>       NaN</span><br><span class="line">two   A       NaN <span class="number">-0.825128</span></span><br><span class="line">      B  <span class="number">0.203672</span>       NaN</span><br><span class="line">      C       NaN  <span class="number">0.502824</span></span><br></pre></td></tr></table></figure><h1 id="时间序列"><a href="#时间序列" class="headerlink" title="时间序列"></a>时间序列</h1><p>Pandas提供了简单、强力且有效的工具，可以在频率转换中进行重采样（比如从秒级数据中提取5分钟一更新的数据）。这在金融工程中应用甚广，当然也不仅限于金融领域。</p><p>时区表示</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line">rng = pd.date_range(<span class="string">'3/6/2012 00:00'</span>, periods=<span class="number">5</span>, freq=<span class="string">'D'</span>)</span><br><span class="line">ts = pd.Series(np.random.randn(len(rng)), rng)</span><br><span class="line">print(ts)</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-06</span>   <span class="number">-0.605179</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-07</span>    <span class="number">0.961252</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-08</span>    <span class="number">1.309406</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-09</span>    <span class="number">1.184313</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-10</span>    <span class="number">0.249745</span></span><br><span class="line">Freq: D, dtype: float64</span><br><span class="line"></span><br><span class="line"><span class="comment"># 设定国际时区标准</span></span><br><span class="line">ts_utc = ts.tz_localize(<span class="string">'UTC'</span>)</span><br><span class="line">print(ts_utc)</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-06</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>+<span class="number">00</span>:<span class="number">00</span>   <span class="number">-0.605179</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-07</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>+<span class="number">00</span>:<span class="number">00</span>    <span class="number">0.961252</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-08</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>+<span class="number">00</span>:<span class="number">00</span>    <span class="number">1.309406</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-09</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>+<span class="number">00</span>:<span class="number">00</span>    <span class="number">1.184313</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-10</span> <span class="number">00</span>:<span class="number">00</span>:<span class="number">00</span>+<span class="number">00</span>:<span class="number">00</span>    <span class="number">0.249745</span></span><br><span class="line">Freq: D, dtype: float64</span><br><span class="line"></span><br><span class="line"><span class="comment"># 切换时区</span></span><br><span class="line">print(ts_utc.tz_convert(<span class="string">'US/Eastern'</span>))</span><br><span class="line">&gt;</span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-05</span> <span class="number">19</span>:<span class="number">00</span>:<span class="number">00</span><span class="number">-05</span>:<span class="number">00</span>   <span class="number">-0.605179</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-06</span> <span class="number">19</span>:<span class="number">00</span>:<span class="number">00</span><span class="number">-05</span>:<span class="number">00</span>    <span class="number">0.961252</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-07</span> <span class="number">19</span>:<span class="number">00</span>:<span class="number">00</span><span class="number">-05</span>:<span class="number">00</span>    <span class="number">1.309406</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-08</span> <span class="number">19</span>:<span class="number">00</span>:<span class="number">00</span><span class="number">-05</span>:<span class="number">00</span>    <span class="number">1.184313</span></span><br><span class="line"><span class="number">2012</span><span class="number">-03</span><span class="number">-09</span> <span class="number">19</span>:<span class="number">00</span>:<span class="number">00</span><span class="number">-05</span>:<span class="number">00</span>    <span class="number">0.249745</span></span><br><span class="line">Freq: D, dtype: float64</span><br></pre></td></tr></table></figure><p>周期和时间戳之间的转换让我们可以方便的使用一些算术运算。比如下面的例子，我们把一个<strong>以季度为单位的时间序列转换为按日期表示</strong>。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">prng = pd.period_range(<span class="string">'1990Q1'</span>, <span class="string">'2000Q4'</span>, freq=<span class="string">'Q-NOV'</span>)</span><br><span class="line"></span><br><span class="line">ts = pd.Series(np.random.randn(len(prng)), prng)</span><br><span class="line">print(ts.head())</span><br><span class="line"></span><br><span class="line">ts.index = (prng.asfreq(<span class="string">'M'</span>, <span class="string">'e'</span>) + <span class="number">1</span>).asfreq(<span class="string">'H'</span>, <span class="string">'s'</span>) + <span class="number">9</span></span><br><span class="line">print(ts.head())</span><br></pre></td></tr></table></figure><h1 id="分类"><a href="#分类" class="headerlink" title="分类"></a>分类</h1><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">df = pd.DataFrame(&#123;<span class="string">"id"</span>:[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>,<span class="number">6</span>], <span class="string">"raw_grade"</span>:[<span class="string">'a'</span>, <span class="string">'b'</span>, <span class="string">'b'</span>, <span class="string">'a'</span>, <span class="string">'a'</span>, <span class="string">'e'</span>]&#125;)</span><br><span class="line"><span class="comment"># 将原始记录转换为分类类型</span></span><br><span class="line">df[<span class="string">"grade"</span>] = df[<span class="string">"raw_grade"</span>].astype(<span class="string">"category"</span>)</span><br><span class="line"></span><br><span class="line">print(df[<span class="string">"grade"</span>])</span><br></pre></td></tr></table></figure><p>将类别重命名为更有意义的字样</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">df[<span class="string">"grade"</span>].cat.categories = [<span class="string">"very good"</span>, <span class="string">"good"</span>, <span class="string">"very bad"</span>]</span><br><span class="line"></span><br><span class="line"><span class="comment"># 重排类别同时添加上缺失的类别名称</span></span><br><span class="line">df[<span class="string">"grade"</span>] = df[<span class="string">"grade"</span>].cat.set_categories([<span class="string">"very bad"</span>, <span class="string">"bad"</span>, <span class="string">"medium"</span>, <span class="string">"good"</span>, <span class="string">"very good"</span>])</span><br><span class="line"></span><br><span class="line">print(df[<span class="string">"grade"</span>])</span><br><span class="line"></span><br><span class="line"><span class="comment"># 排序在各分类中分别进行</span></span><br><span class="line">print(df.sort_values(by=<span class="string">"grade"</span>))</span><br><span class="line"></span><br><span class="line"><span class="comment"># 对类别列分组可以显示空类</span></span><br><span class="line">print(df.groupby(<span class="string">"grade"</span>).size())</span><br></pre></td></tr></table></figure><h1 id="绘图"><a href="#绘图" class="headerlink" title="绘图"></a>绘图</h1><p>随机累加序列</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 生成一串随机序列</span></span><br><span class="line">ts = pd.Series(np.random.randn(<span class="number">1000</span>), index=pd.date_range(<span class="string">'1/1/2000'</span>, periods=<span class="number">1000</span>))</span><br><span class="line"></span><br><span class="line"><span class="comment"># 求累加和</span></span><br><span class="line">ts = ts.cumsum()</span><br><span class="line"></span><br><span class="line"><span class="comment"># 输出图象</span></span><br><span class="line">ts.plot()</span><br></pre></td></tr></table></figure><p>绘制带标签的列</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 生成一个4列的DataFrame，每列1000行，并逐列累加</span></span><br><span class="line">df = pd.DataFrame(np.random.randn(<span class="number">1000</span>, <span class="number">4</span>), index=ts.index, columns=[<span class="string">'A'</span>, <span class="string">'B'</span>, <span class="string">'C'</span>, <span class="string">'D'</span>]) </span><br><span class="line">df = df.cumsum()</span><br><span class="line"></span><br><span class="line">df.plot(); plt.legend(loc=<span class="string">'best'</span>)</span><br></pre></td></tr></table></figure><h1 id="获取数据输入-输出"><a href="#获取数据输入-输出" class="headerlink" title="获取数据输入/输出"></a>获取数据输入/输出</h1><h2 id="CSV"><a href="#CSV" class="headerlink" title="CSV"></a>CSV</h2><p>df是一个DataFrame</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 输出至.csv文件</span></span><br><span class="line">df.to_csv(<span class="string">'haha.csv'</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 从.csv文件中读取数据</span></span><br><span class="line">pd.read_csv(<span class="string">'haha.csv'</span>)</span><br></pre></td></tr></table></figure><h2 id="Excel"><a href="#Excel" class="headerlink" title="Excel"></a>Excel</h2><p>df是一个DataFrame</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 输出至.xlsx文件</span></span><br><span class="line">df.to_excel(<span class="string">'haha.xlsx'</span>, sheet_name=<span class="string">'Sheet1'</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 从.xlsx文件中读取数据</span></span><br><span class="line">pd.read_excel(<span class="string">'foo.xlsx'</span>, <span class="string">'Sheet1'</span>, index_col=<span class="keyword">None</span>, na_values=[<span class="string">'NA'</span>])</span><br><span class="line">(<span class="string">'haha.csv'</span>)</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】百科类&lt;br&gt;【内容简介】pandas函数库相关操作手册，供查阅使用。笔记对象来自&lt;a href=&quot;https://jizhi.im/blog/post/10min2pandas01&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;集智&lt;/a&gt;&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/categories/Tools/"/>
    
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Library" scheme="https://charlesliuyx.github.io/tags/Library/"/>
    
  </entry>
  
  <entry>
    <title>【区块链】比特币与金融、ICO和监管</title>
    <link href="https://charlesliuyx.github.io/2017/09/25/%E5%8C%BA%E5%9D%97%E9%93%BE%EF%BC%88%E6%AF%94%E7%89%B9%E5%B8%81%EF%BC%89%E4%B8%8E%E9%87%91%E8%9E%8D/"/>
    <id>https://charlesliuyx.github.io/2017/09/25/区块链（比特币）与金融/</id>
    <published>2017-09-25T05:59:14.000Z</published>
    <updated>2018-03-04T06:00:05.418Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】13min - 17min - 4187 words<br>【内容简介】其中讨论了区块链技术（比特币）对金融体系的影响，并解读了最近很火的热点问题：什么是ICO，对一些大事件的时间表进行记录和总结</p><a id="more"></a><h1 id="三个关键问题"><a href="#三个关键问题" class="headerlink" title="三个关键问题"></a>三个关键问题</h1><p>英格兰银行副行长，布罗德本特提出了有关区块链金融的<strong>三个关键问题</strong>十分犀利，也为宋老师推崇，这里列出来大家共同思考</p><h2 id="第一个问题"><a href="#第一个问题" class="headerlink" title="第一个问题"></a>第一个问题</h2><blockquote><p>比特币它并不是创造了一种新的货币，而是创造了一种<strong>新的清算方式</strong></p></blockquote><h3 id="清算权"><a href="#清算权" class="headerlink" title="清算权"></a>清算权</h3><p>清算问题始终是<strong>中央银行诞生</strong>的最重要的动力，是金融体系中相当核心的问题，而<strong>货币发行权</strong>的基础在于<strong>清算权</strong></p><ul><li>17世纪，荷兰的阿姆斯特丹银行，进化成了中央银行，<strong>首创用金银币的账户来进行清算</strong></li><li>19世纪，上海汇丰银行。控制了大清国的货币清算功能。担当清算中心的职责，整个清朝内部的资金流动，都要通过汇丰银行</li><li>到现在，美国对某某国家采取金融制裁，因为美国掌握着<strong>美元的清算权</strong></li><li>支付宝和微信支付争的是<strong>网络交易的清算权</strong></li></ul><p>谁能控制清算权，就占据了战略的制高点，有俯瞰全局的作用，控制战局。<strong>清算权意味着游戏规则的制订权</strong>。</p><p>这种新的清算方式，<strong>成本低</strong>。英格兰银行希望<strong>主导这种潮流</strong>，也就是RSCoin的核心</p><ul><li>英国的数字货币，依赖大账本进行清算</li><li>但是它要<strong>控制这个大账本</strong></li></ul><h3 id="比特币清算的致命缺陷"><a href="#比特币清算的致命缺陷" class="headerlink" title="比特币清算的致命缺陷"></a>比特币清算的致命缺陷</h3><ul><li>互联人没有信用体系，用<strong>消耗运算力的方式</strong>来保持整个记账体系的安全</li><li><strong>浪费巨大的资源</strong>，导致记账效率低下</li><li>会出现记账效率的瓶颈。比如，比特币，每秒只能完成7笔交易，而全世界体系要求的记账效率非常高，比如，VISA卡，每秒2000 - 7000笔</li></ul><h3 id="RSCoin的解决办法"><a href="#RSCoin的解决办法" class="headerlink" title="RSCoin的解决办法"></a>RSCoin的解决办法</h3><p>记账效率低下，是由于竞争记账。既然银行控制大账本，没有必要搞竞争，指定少数几家银行，负责记账。双层记账体系，树形结构优化，RSCoin使用30个授权节点，一秒可以达到2000笔</p><h3 id="我的观点"><a href="#我的观点" class="headerlink" title="我的观点"></a>我的观点</h3><p>有关英国人弄得RSCoin来讲，个人认为已经脱离的了区块链技术的核心Idea：贪婪=信任。既然还是有中心化的控制，那么就等同于只使用了区块链的数据结构，本质来说，也就不是<strong>加密货币</strong>。</p><p>但是，有一些博弈和妥协的想法是非常值得借鉴的，比如，流水账本身就有透明的好处，其实是从另一方面利用区块链密码学加密技术实现了一种<strong>变种的信息透明</strong></p><h2 id="第二个问题"><a href="#第二个问题" class="headerlink" title="第二个问题"></a>第二个问题</h2><blockquote><p>如果数字货币是一个独立的货币，未来它将会<strong>跟传统的银行，争夺储蓄</strong></p></blockquote><p>举个例子来说，共享单车想当于数字货币。出现之前，单车控制权都是银行。骑车，只能从一家银行停车场到另一家银行的停车场。自行车的控制权，由银行转向了最终客户。只要能解开密码锁，你就可以随便骑，随意停。久而久之，共享单车数量越来越大，传统的自行车就会越来越小</p><p>银行的商业模式是：<strong>吸纳储蓄➜放贷➜吃存款和贷款之间的利差</strong>。数字货币的量越大，银行体系中的储蓄减少，金融体系面临挤兑的风险，数字货币很可能成为传统银行这种商业模式的<strong>掘墓人</strong>，如何解决这个问题，布罗德本特提出了第三个问题</p><h2 id="第三个问题"><a href="#第三个问题" class="headerlink" title="第三个问题"></a>第三个问题</h2><blockquote><p>新的数字货币如何去倒逼传统银行商业模式的改革 （胖银行➜瘦银行）</p></blockquote><h3 id="胖银行的基本运行模式"><a href="#胖银行的基本运行模式" class="headerlink" title="胖银行的基本运行模式"></a>胖银行的基本运行模式</h3><ul><li><p>货币金融学中的概念：<strong>部分准备金</strong>：允许银行用一块钱的准备金进行10倍的放大</p><p>，即用1块钱创造10块钱</p></li><li><p>银行体系因为这个制度有了巨大的竞争优势。<strong>开银行等于印钞</strong></p></li><li><p>其中的前提条件或基础<strong>就是一定要获得大量的储蓄然后才能进行放贷</strong></p></li><li><p>存在问题</p><ul><li>储蓄是别人的钱，是短期的，放贷的资产是长期的</li><li>在金融危机中，资产会迅速贬值，使得银行体系变得不稳定</li><li>危机爆发，银行倒闭，银行倒闭，社会流动性紧缩，钱荒，更多银行倒闭，工厂关门，工人下岗，消费力消失，导致金融危机和经济危机</li></ul></li><li><p><strong>特权化是社会动荡的罪魁祸首</strong></p></li></ul><h3 id="瘦银行"><a href="#瘦银行" class="headerlink" title="瘦银行"></a>瘦银行</h3><p>亚当·斯密，李嘉图等主张搞<strong>瘦银行（不赞同部分准备金制度）</strong> ，比如有名的芝加哥计划</p><p>周期性金融危机的爆发，就跟银行不断放大这种杠杆就直接的关系。其中的关键问题是：<strong>如果银行由胖变瘦，使银行总的资产负债表收缩，社会的流动性紧缩，发生钱荒，经济就会停滞不前</strong></p><h4 id="解决方式"><a href="#解决方式" class="headerlink" title="解决方式"></a>解决方式</h4><ul><li>央行给全体国民每个人开账户</li><li>传统意义上，只有金融机构可以在中央银行开账户，目的也是相互清算。以前做不到，主要原因是<strong>技术水平不够，效率太低，成本太高</strong></li><li>但在数字货币时代，这个问题很简单。意味着央行向人民开放资产负债表，人人可以在央行有账户。<strong>应对金融危机的方式变成，中央银行给每个国民的账户上打钱</strong></li></ul><h4 id="重资产"><a href="#重资产" class="headerlink" title="重资产"></a>重资产</h4><p>商业银行现在是<strong>重资产</strong></p><ul><li>持有大量的贷款，长期贷款。承当巨大的风险：比如利率，汇率不稳定；经济周期；地缘政治冲突；国际油价。进而引发贷款出现违约</li><li>在日益动荡的社会中，<strong>重资产的运行模式，风险大，利差小</strong></li></ul><h4 id="轻资产"><a href="#轻资产" class="headerlink" title="轻资产"></a>轻资产</h4><p>转型问题，就涉及到<strong>轻资产</strong>，这里可以用<strong>万达的转型之路</strong>来举例</p><ul><li>最开始<strong>重资产</strong>：从拿地，融资，投资，建设到经营，自己搞定。造成的问题是人多事杂；押占大量资金；销售也有压力</li><li>转型成<strong>轻资产模式</strong>：出品牌，设计广场，钱由社会上投资人来投 ➜负责运营，利润分成➜赚取管理费用</li></ul><p>银行也是类似的轻资产模式</p><ul><li>银行<strong>出品牌，出技术团队</strong>：因为<strong>银行的人对全国各种项目比较了解，知道哪个贷款比较可靠，风险低</strong></li><li>重点工作是：<strong>设计贷款产品</strong>；设计完，投资人来出钱，银行<strong>负责风控，运营</strong>，挣的钱也是<strong>服务费</strong></li></ul><h2 id="关于三个问题的思考"><a href="#关于三个问题的思考" class="headerlink" title="关于三个问题的思考"></a>关于三个问题的思考</h2><p>这么一套总结下来，的确想象中十分美好，但是我们不能忽略国家间的政治博弈，利益冲突。银行转型，也是涉及到了众多的问题和利益方面的权衡和Trade-off，但我认为，区块链比特币的出现，的确给了银行一定的压力，这样就和布罗德本特先生的真知灼见切合了，是一种<strong>倒逼</strong>，是<strong>一种时代潮流倾轧的必然产物</strong></p><h1 id="金融结算应用"><a href="#金融结算应用" class="headerlink" title="金融结算应用"></a>金融结算应用</h1><h2 id="结算步骤"><a href="#结算步骤" class="headerlink" title="结算步骤"></a>结算步骤</h2><ul><li>交易指令管理（包括交易验证）</li><li>清算（即计算交易双方的财务义务）</li><li>结算（即最终的资产转移）</li></ul><h2 id="CSDs功能"><a href="#CSDs功能" class="headerlink" title="CSDs功能"></a>CSDs功能</h2><p>中央证券登记机构（Central Security Depositories，CSDs）在结算中发挥了关键作用，承担了3项主要功能</p><ul><li>认证（公正并受信任地维护已发行证券的记录）</li><li>结算（将证券的所有权从卖方转给买方）</li><li>账目维护（建立并更新证券的所有权记录）</li></ul><p>中央证券登记机构还承担<strong>证券托管</strong>、<strong>资产服务</strong>、<strong>融资</strong>、<strong>报告</strong>或<strong>证券出借</strong>等功能</p><h2 id="结算行业的痛点"><a href="#结算行业的痛点" class="headerlink" title="结算行业的痛点"></a>结算行业的痛点</h2><p>在金融交易后结算中，一笔交易涉及<strong>多个中介机构</strong>。每个中介机构都使用自己的系统来处理、发送和接收交易指令、核对数据、管理差错等，并维护自己的交易记录。每个中介机构使用的数据标也准都不统一</p><p><strong>这些都会产生大量成本</strong>。<strong>区块链技术有助于建立并维护共享的、同时化（synchronized）的账目，简化交易对账过程。</strong></p><p>目前，<strong>结算行业</strong>讨论在金融交易后结算中引入私有的、有准入限制的区块链系统。其中，每一个节点扮演不同角色并且在读取区块链上信息上有不同权限，一组受信任的参与者承担验证职能</p><h2 id="区块链优势"><a href="#区块链优势" class="headerlink" title="区块链优势"></a>区块链优势</h2><ul><li>通过分布式、同时化、共享的证券所有权记录来简化和自动化交易后结算工作，<strong>降低交易对账和数据管理成本</strong></li><li><strong>缩短结算所需时间</strong>，减低结算风险敞口</li><li>因为与交易有关信息由交易双方共享，能促进<strong>自动清算</strong></li><li>缩短托管链，使投资者可以直接持有证券，<strong>降低投资者承担的法律和运营风险以及中介成本</strong></li><li>可跟踪性好，<strong>透明度高</strong></li><li>去中心化、<strong>多备份</strong>能提高系统<strong>安全性和抗压性</strong></li></ul><h2 id="应用难点"><a href="#应用难点" class="headerlink" title="应用难点"></a>应用难点</h2><ul><li><p>如何实现<strong>认证功能</strong>？</p><p>尽管区块链能保证分布式账本的准确性，但还需有一个受信任的机构来确保已发行证券信息的真实性，一定的中心化必须的，只是可以利用计算机和分布式存储大数据的方式来提高效率，这部分是非常靠谱的</p></li><li><p>如何实现<strong>存管功能</strong>？</p><p>特别是，如何将托管机构和存管机构持有的资产转移到区块链上。一个可行方案是使用电子凭证（digital token）来代表不在区块链上的资产，但需要一个受信任机构来确保电子凭证与资产之间的对应关系</p></li><li><p>如何实现<strong>券款对付</strong>（Delivery versus payment，DvP）？</p><p>这要求区块链能同时处理现金账户</p></li><li><p>如何确保结算的<strong>最终性</strong>（settlement finality）？</p><p>比如，比特币区块链系统因为分叉的存在，只能在概率意义上确保结算的最终性（尽管该概率随时间趋向1）</p></li><li><p>在法律上，区块链上的记录能否构成<strong>所有权证明</strong>？</p></li><li><p>交易匹配和差错管理。区块链在比较不同维度数据、处理合同不匹配和例外情况上还面临不少障碍</p></li><li><p>如何在多方参与验证的情况下，确保<strong>交易信息的保密性</strong>？</p><p>一个方案是一个受信任的机构和交易双方才能参加与交易有关的共识机制</p><p>另一个方案是区分交易数据和验证所需数据。零知识验证（zero-knowledge proofs, ZKPs）也是一个可能的解决工具</p></li><li><p>身份管理</p></li><li><p>可扩展性</p></li><li><p>与现有流程和基础设施的<strong>兼容性</strong>（interoperability）</p></li></ul><p>区块链在产权登记、确认、交易等中的应用逻辑和有待解决的问题，与金融交易后结算非常类似。在这个领域，仔细琢磨，还有<strong>很多难关需要攻克</strong></p><h1 id="什么是ICO"><a href="#什么是ICO" class="headerlink" title="什么是ICO"></a>什么是ICO</h1><p>最近中国强势出手，关停ICO，手段雷厉风行，很多ICO项目都变成了一场庞氏骗局，让人唏嘘，这里针对ICO做一些思考，出自借鉴<a href="http://www.sohu.com/a/162825922_735021" target="_blank" rel="noopener">科普文章</a></p><h2 id="赌场例子"><a href="#赌场例子" class="headerlink" title="赌场例子"></a>赌场例子</h2><ul><li>有一个人开了一间赌场，每个赌徒要来赌场玩，<strong>必须先换一些筹码，才能参与赌场内的赌局</strong>。赌场内所有赌局都是实时利用筹码结算的。</li><li>这间赌场<strong>服务特别好，赌具特别好，入场费收得也非常低</strong>，总之一切都特别好，于是越来越多的赌徒都慕名而来，跑到这间赌场来玩，<strong>赌局额度也越来越大</strong>。自然，这就需要更多的筹码来确保赌场的顺利运营。</li><li>但是，这间赌场的筹码是用一种特殊的金属、特殊的工艺制造的，这些赌具只能用这种筹码玩。<strong>赌场一开始的时候造了一万个，以后再也造不出来了</strong>。怎么办？</li><li>参与赌局的人越来越多，赌局额度越来越大，原本1个筹码1美元，同时100个人在玩，一次赢1美元，赌场运行得很顺利，除了在赌徒间流通的筹码外，赌场手里还有一些筹码，可以卖给刚进场的赌徒。<strong>现在来了1000个人，每次要赢100美元，依然只有10000个筹码</strong>。</li><li><strong>为了玩得尽兴</strong>，于是赌徒之间互相约定，我们1个筹码100美元，这样就能玩得尽兴了。新进场的赌徒从老赌徒手里高价买回了筹码，老赌徒大赚了一笔，新赌徒玩的尽兴。赌场呢？<strong>手里剩的筹码也可以100美元的价格卖出去了</strong>。</li><li>由于赌场运营得越来越好，来的赌徒越来越多，赌局越来越大，<strong>筹码的价格就一路上涨</strong>。</li><li>对于赌场而言，由于一开始有大量的筹码以1美元的价格卖给了老赌徒，如果按照100美元的价格承兑，赌场就亏大了。于是，赌场就宣布，<strong>找我承兑筹码可以，但是只能按照1美元的价格</strong>。</li><li>但是赌场在卖出筹码的时候，依然按照市场价100美元出售，这也成为赌场盈利的一种手段。<strong>于是大家都不会把赢来的筹码拿去找赌场退钱，而是留在手里等着卖给新的赌徒</strong>。</li></ul><h2 id="赌场例子背后的经济学常识"><a href="#赌场例子背后的经济学常识" class="headerlink" title="赌场例子背后的经济学常识"></a>赌场例子背后的经济学常识</h2><p><strong>随着生产力越来越高，市场越来越大，市场上流通的商品（总价值）越来越多，如果货币的流通速度不变，理论上就需要更多的货币</strong>。从赌场故事中，可以非常容易地看出，由于<strong>赌场固定了筹码的总额</strong>，加上很多人持币等待升值造成筹码流通速度变化不大，于是筹码价格只能上涨。</p><h2 id="进行一个赌场ICO"><a href="#进行一个赌场ICO" class="headerlink" title="进行一个赌场ICO"></a>进行一个赌场ICO</h2><ul><li>又有一个人，看到了赌场的生意这么好，眼红了，于是他也想开一间赌场。可是他没有足够的本钱，怎么办呢？于是他公开宣布：我要开一间赌场，<strong>赌场服务非常好，赌局非常好，手续费非常低</strong>。我的<strong>赌场只有10000个筹码，以后绝不增加</strong>。</li><li>现在筹码先造出来了，我把其中5000个筹码拿出来，任何人都可以来买。这5000个筹码卖完了以后，我就用卖掉的钱作为本钱开赌场。等赌场开业了，你们可以把手里的筹码卖给赌徒，或者自己来赌都行。</li><li>由于开始赌场还没开业，所以出售的筹码价格也是很低的，<strong>0.5美元1个</strong>。等赌场开业了，至少1美元1个，甚至更高。由于很多人都看好这个生意，于是5000个筹码很快就卖光了。这个人筹集到了2500美元，造了一些赌具，租了间房子，赌场就开始营业了。</li><li>由于<strong>他的服务真的很好，很快又聚集了大量的赌徒，于是筹码的价格一路飞涨，很快就到了100美元</strong>。在赌场开业前以0.5美元的价格买了筹码的人，筹码增值了200倍。</li></ul><p>我们看到，其中加粗的环节都是预先设计或者是预想的。并且这个案例和加密货币（区块链）的特别不谋而合</p><p><strong>ICO英文全称是Initial Coin Offering，翻译成中文是“初始货币供应”。</strong></p><h2 id="ICO的基本原理"><a href="#ICO的基本原理" class="headerlink" title="ICO的基本原理"></a>ICO的基本原理</h2><ul><li>公司创造了一种商业模式，在这种商业模式里，大家只能使用公司自己发行的“代币”（虚拟货币）进行交易。公司事先宣布，这种<strong>代币总额是固定</strong>，或者<strong>增发的方式是固定</strong>，也就是说，任何人都<strong>不能更改代币增发的规则（区块链技术从本质上保证了这一点）</strong>。</li><li>如果大家认为我们的商业模式非常有前途，我们的代币就会增值。现在公司拿出一定比例的代币进行发售，用筹得的经费作为本钱来运营这种商业模式。</li><li>这种依靠<strong>出售日后商业模式中的某种公司产品</strong>（如果代币可以视为公司产品的话）的方式来<strong>筹集资金的金融行为</strong>，就被称为ICO</li></ul><h2 id="ICO的特点"><a href="#ICO的特点" class="headerlink" title="ICO的特点"></a>ICO的特点</h2><ul><li>1、所发行的代币<strong>必须是在未来的商业模式中有使用价值</strong>，并且不可替代。</li><li>2、ICO的商业模式中，代币的发行方式必须事<strong>先固定规则</strong>，并且不可更改。</li><li>3、ICO虽然是一种商业融资的方式，但是ICO模式并不出让股权或者负债，也就是说，运营该商业的公司，<strong>未来仍可以继续出让股权或者举债</strong></li></ul><h2 id="ICO与区块链"><a href="#ICO与区块链" class="headerlink" title="ICO与区块链"></a>ICO与区块链</h2><p>如果你之前已经对区块链最大的核心思想了有了了解，你就知道ICO里面有一个C coin，本身就是看中了区块链<strong>没有任何一个中心能够控制这个系统，数据一旦产生便不可更改，并通过工作量证明，产生的强大信任</strong>。</p><p>但是，这个加密货币的实体在未来到底能不能变现，<strong>必须要落到实际问题中</strong>，真真正正可以解决人们生活中的实际问题。</p><p>加密货币直接能解决问题是金融体系的一些问题，这在布罗德本特的三个问题中已经进行了详细的阐述。正因为金融体系的局限性，这种货币不可能<strong>同时出现很多</strong>并且都具有那么高的价值。</p><p>那就需要以太坊这种本质上的服务类落地的想法来晚上这一落地过程，这部分的一些创新和面临的技术难题，在<a href="https://charlesliuyx.github.io/2017/09/25/%E8%AF%84%E4%BC%B0%E7%AB%9E%E4%BA%89%E5%B8%81%E7%9A%84%E4%BB%B7%E5%80%BC%E4%B8%8E%E6%99%BA%E8%83%BD%E5%90%88%E7%BA%A6/">如何评估竞争币的价值与智能合约</a>中我进行了一切探讨</p><h1 id="数字加密货币监管"><a href="#数字加密货币监管" class="headerlink" title="数字加密货币监管"></a>数字加密货币监管</h1><h2 id="监管事件"><a href="#监管事件" class="headerlink" title="监管事件"></a>监管事件</h2><ul><li>【2017年8月】中国严打数字加密货币交易所和ICO</li><li>【2018年1月】中国政府开始叫停数字加密货币的场外交易和“出海转内销”</li><li>日本对加密货币交易非常宽容，甚至有一定大财团入场的情况发生</li><li>【2017年1月】Coinbase上线比特币现金交易功能，造成<strong>流动性溢价</strong></li><li>【2018年1月】中国政府要求境内挖矿企业有序退出，一些“矿池”准备搬到加拿大</li></ul><h2 id="市场操纵"><a href="#市场操纵" class="headerlink" title="市场操纵"></a>市场操纵</h2><p>现阶段，40%的比特币被1000个以下的地址持有，代币过于集中，出现<strong>市场操纵</strong>，不说做空和对冲，典型的简单手法即：若干代币持有大户一起达成共识，提高代币价格，吸引<strong>散户投资者进入</strong>，然后大户集中减持。俗称【割韭菜】</p><h2 id="违法地带"><a href="#违法地带" class="headerlink" title="违法地带"></a>违法地带</h2><p>加密货币从一出现开始，就是黑市的青睐交易手段，数字加密货币被用来洗钱，绕开资本管制，逃税，赌博等</p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>加密货币在现阶段不可能取代法币（货币）的地位。人与人之间就有固定的地位差距，贫富差距，天赋差距，运气差距都有固定的隔阂，本身去中心化的分布式存储系统：区块链，并不能真正的做到全世界范围脱离政府，脱离权利中心的私有财产神圣不可侵犯</p><p>我作为一个学习CS专业，学习机器学习的人来说，对于金融的理解十分浅显，希望各位前辈能多多指教，共同探讨！</p><p>以上！鞠躬！</p><p>【参考】</p><p><a href="http://www.8btc.com/bitcoin-blockchain-0303" target="_blank" rel="noopener">与区块链和数字货币有关的思考</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】13min - 17min - 4187 words&lt;br&gt;【内容简介】其中讨论了区块链技术（比特币）对金融体系的影响，并解读了最近很火的热点问题：什么是ICO，对一些大事件的时间表进行记录和总结&lt;/p&gt;
    
    </summary>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/categories/BlockChain/"/>
    
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/tags/BlockChain/"/>
    
      <category term="FinTech" scheme="https://charlesliuyx.github.io/tags/FinTech/"/>
    
  </entry>
  
  <entry>
    <title>【区块链】现代区块链与新技术</title>
    <link href="https://charlesliuyx.github.io/2017/09/25/%E7%8E%B0%E4%BB%A3%E5%8C%BA%E5%9D%97%E9%93%BE%E4%B8%8E%E6%96%B0%E6%8A%80%E6%9C%AF/"/>
    <id>https://charlesliuyx.github.io/2017/09/25/现代区块链与新技术/</id>
    <published>2017-09-25T03:54:40.000Z</published>
    <updated>2018-03-05T21:25:55.488Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】<strong>不断更新</strong>的wiki博客<br>【内容简介】总结市面上不同的币种，关注区块链技术的最新进展，整理总结各种新名词，新概念，新技术相关概念和文章<br><a id="more"></a></p><h1 id="竞争币和竞争块链"><a href="#竞争币和竞争块链" class="headerlink" title="竞争币和竞争块链"></a>竞争币和竞争块链</h1><p>因为比特币的完全开源，所以基于比特币，有创新的，无创新仅仅修改一些参数的，出现非常多的竞争币和竞争块链（与比特币和区块链的关系一样，两者联系紧密）</p><p>竞争币区别与比特币主要是以下三点：</p><ul><li><strong>货币策略</strong>不同</li><li>基于工作量证明的<strong>一致性机制</strong>不同</li><li>一些特殊的功能，比如更强的匿名性等</li></ul><p>如果想关注所有竞争币（机密货币）的信息，可以访问：<a href="http://mapofcoins.com/bitcoin#" target="_blank" rel="noopener">MaoOfCoin</a>，打开会有所有你想知道的信息</p><h2 id="评估竞争币的价值"><a href="#评估竞争币的价值" class="headerlink" title="评估竞争币的价值"></a>评估竞争币的价值</h2><p>我们可以从问几个最基本的问题开始入手</p><ul><li>这款竞争币有没有引入<strong>重大创新</strong>？</li><li>如果有，那么这项创新是不是足够有<strong>吸引使用比特币的用户转移</strong></li><li>这款竞争币是不是致力于某一细分领域或引用？</li><li>这款竞争币可以吸引到足够的矿工来抵御一致性攻击吗？</li></ul><p>更多的，关于财务和市场的问题：</p><ul><li>这款竞争币的<strong>市场总值</strong>是多少？（一般最初来源于ICO）</li><li>整个系统的<strong>用户/钱包规模</strong>大概是多少？</li><li>接受其支付的<strong>商家</strong>有多少？</li><li>整个系统<strong>每日的交易数</strong>是多少？</li><li><strong>交易总量是</strong>多少？</li></ul><h2 id="元币平台-Meta-Coin"><a href="#元币平台-Meta-Coin" class="headerlink" title="元币平台 Meta Coin"></a>元币平台 Meta Coin</h2><p>元币和元区块链是<strong>比特币之上</strong>实现的<strong>软件层</strong>，也可以认为是覆盖在比特币系统之上的平台/协议，或者是一个<strong>币中币的实现</strong>。</p><p>这些功能扩展了核心比特币的协议，使得<strong>比特币交易和比特币地址附加信息</strong>称为可能</p><h3 id="彩色币-Colored-Coin"><a href="#彩色币-Colored-Coin" class="headerlink" title="彩色币 Colored Coin"></a>彩色币 Colored Coin</h3><p>通过仔细跟踪一些<strong>特定比特币的来龙去脉</strong>，可以将它们与其他的比特币区分开来，这些特定比特币就叫作彩色币。</p><p>它们具有一些<strong>特殊的属性</strong>，比如支持<strong>代理或聚集点</strong> ，从而具有与比特币面值无关的价值。</p><p>彩色币可以用作替代货币、商品证书、智能财产以及其他金融工具，如股票和债券等。 </p><p>彩色币<strong>本身就是比特币</strong>，存储和转移不需要第三方，可以利用已经存在的比特币的基础，因此彩色币可以为现实世界中难以通过传统方法去中心化的事物铺平道路。</p><h3 id="万事达币-MasterCoin"><a href="#万事达币-MasterCoin" class="headerlink" title="万事达币 MasterCoin"></a>万事达币 MasterCoin</h3><p>MasterCoin是比特币协议的应用层协议，类似HTTP协议是TCP协议的应用层一样</p><h2 id="货币属性不同于比特币的竞争币"><a href="#货币属性不同于比特币的竞争币" class="headerlink" title="货币属性不同于比特币的竞争币"></a>货币属性不同于比特币的竞争币</h2><p>比特币自身所具有的一些设计规则使得它成为了一个总额固定并且不通胀的虚拟货币，有一些竞争币通过对这些货币属性的微调，来达到实现不同的货币政策的目的。</p><h3 id="莱特币-LiteCoin"><a href="#莱特币-LiteCoin" class="headerlink" title="莱特币 LiteCoin"></a>莱特币 LiteCoin</h3><p>它是最早的一批竞争币的一员，自2011年发布至今，已经成为继比特币之后的第二成功的电子货币。它的主要创新是两点</p><ul><li>使用了<strong>Scrypt</strong>作为工作量证明的算法（这种算法比SHA256来说，主要的特点就是内存消耗更多，难度更大，使用ASCII或者GPU矿机更加难以计算）</li><li>更快的<strong>货币参数</strong></li></ul><h3 id="狗狗币-DogeCoin"><a href="#狗狗币-DogeCoin" class="headerlink" title="狗狗币 DogeCoin"></a>狗狗币 DogeCoin</h3><p>它是基于莱特币的一款竞争币，与2013年12月发布。之所以值得一提还是因为它飞快的出块速度和惊人的货币总量。现在已经一文不值</p><h3 id="Freicoin"><a href="#Freicoin" class="headerlink" title="Freicoin"></a>Freicoin</h3><p>于2012年7月发布。它是一种<strong>滞留性通货</strong>，可以理解为存在钱包中的货币的利率为负数，只有不断交易和消费才能保证它不变少。它的特点是它的货币政策正好和比特币的通货紧缩政策相反</p><h3 id="货币属性总结表"><a href="#货币属性总结表" class="headerlink" title="货币属性总结表"></a>货币属性总结表</h3><table><thead><tr><th style="text-align:center">货币名称</th><th style="text-align:center">出块速度</th><th style="text-align:center">货币总量</th><th style="text-align:center">一致性算法</th><th style="text-align:center">市场总值（到2017/9/25）</th><th style="text-align:center">24小时交易量</th></tr></thead><tbody><tr><td style="text-align:center">莱特币</td><td style="text-align:center">2分半</td><td style="text-align:center">2014年8400万</td><td style="text-align:center">Scrypt</td><td style="text-align:center">$2,716,920,950</td><td style="text-align:center">$214,787,000</td></tr><tr><td style="text-align:center">狗狗币</td><td style="text-align:center">60秒</td><td style="text-align:center">2015年达1000亿</td><td style="text-align:center">Scrypt</td><td style="text-align:center">$123,105,955</td><td style="text-align:center">$11,777,800</td></tr><tr><td style="text-align:center">Freicoin</td><td style="text-align:center">10分钟</td><td style="text-align:center">2014年1亿</td><td style="text-align:center">SHA256</td><td style="text-align:center">$108,614</td><td style="text-align:center">$1</td></tr></tbody></table><h2 id="一致性机制创新的竞争币"><a href="#一致性机制创新的竞争币" class="headerlink" title="一致性机制创新的竞争币"></a>一致性机制创新的竞争币</h2><p>在时代的发展中，除了SHA256找0的方式，还衍生出了<strong>不同的算法</strong>来实现工作量证明的一致性机制。包括Scrypt；Scrypt-N，Skein，Grosetl，SHA3，X11，Blake。这些算法都在一定程度上组织的ASIC矿机的泛滥</p><p>而在2013年，出现的一种替代方式：<strong><a href="#权益证明">权益证明</a>（或股权证明 Proof of Stake PoS）</strong>，称为现代竞争币的基础</p><p>在权益证明系统中，货币的所有人可以将自己的<strong>货币做利息抵押</strong>。类似于存款证明，参与者可以保有他们货币的一部分，通过<strong>利息和矿工费</strong>的方式获取回报</p><h3 id="Peercoin"><a href="#Peercoin" class="headerlink" title="Peercoin"></a>Peercoin</h3><p>与2012年8月发布，首款<strong>工作量证明和权益证明</strong>混用的竞争币</p><h3 id="Myriad"><a href="#Myriad" class="headerlink" title="Myriad"></a>Myriad</h3><p>与2014年2月发布，它同时使用了5中工作量证明算法（HA256d；Scrypt；Qubit；Skein；Myriad-Groestl），根据矿工的情况动态选择。这也是为了让系统不受集中化ASIC矿机的影响，也加强了其抵御一致性攻击的能力</p><h3 id="黑币-BlackCoin"><a href="#黑币-BlackCoin" class="headerlink" title="黑币 BlackCoin"></a>黑币 BlackCoin</h3><p>与2014年2月发布，使用的是权益证明的一致性机制。同时，它引入的可以根据收益自动切换到不同竞争币的“多矿池”机制也值得关注</p><h3 id="VeriCoin"><a href="#VeriCoin" class="headerlink" title="VeriCoin"></a>VeriCoin</h3><p>与2014年5月发布，它使用权益证明机制，并用<strong>市场供需关系动态调整利率</strong>。它是首款可以<strong>直接在钱包中兑换比特币支付</strong>的竞争币</p><h3 id="NXT"><a href="#NXT" class="headerlink" title="NXT"></a>NXT</h3><p>发音同Next，一种纯粹的权益证明竞争币，根本不采用工作量证明的挖矿机制。</p><p>它是一款完全自己实现的加密货币，并非衍生品。NXT具有很多先进的功能，包括名字注册、去中心化资产交易、集成的去中心化加密信息的权益委托。NXT也被称为加密货币2.0</p><h3 id="货币属性总结表-1"><a href="#货币属性总结表-1" class="headerlink" title="货币属性总结表"></a>货币属性总结表</h3><table><thead><tr><th style="text-align:center">货币名称</th><th style="text-align:center">出块速度</th><th style="text-align:center">货币总量</th><th style="text-align:center">一致性算法</th><th style="text-align:center">市场总值（到2017/9/25）</th><th style="text-align:center">24小时交易量</th></tr></thead><tbody><tr><td style="text-align:center">Peercoin</td><td style="text-align:center">10分钟</td><td style="text-align:center">没有上限</td><td style="text-align:center">工作量证明和权益证明混用</td><td style="text-align:center">$31,009,448</td><td style="text-align:center">$395,757</td></tr><tr><td style="text-align:center">Myriad</td><td style="text-align:center">30秒</td><td style="text-align:center">2024年到20亿</td><td style="text-align:center">多重算法</td><td style="text-align:center">$3,758,612</td><td style="text-align:center">$59,805</td></tr><tr><td style="text-align:center">Blackcoin</td><td style="text-align:center">1分钟</td><td style="text-align:center">没有上限</td><td style="text-align:center">权益证明机制</td><td style="text-align:center">$13,817,132</td><td style="text-align:center">$1,180,000</td></tr><tr><td style="text-align:center">VeriCoin</td><td style="text-align:center">1分钟</td><td style="text-align:center">没有上限</td><td style="text-align:center">权益证明机制</td><td style="text-align:center">$10,103,100</td><td style="text-align:center">$180,508</td></tr><tr><td style="text-align:center">NXT</td><td style="text-align:center">1分钟</td><td style="text-align:center">1亿</td><td style="text-align:center">权益证明机制</td><td style="text-align:center">$63,052,381</td><td style="text-align:center">$2,330,510</td></tr></tbody></table><h2 id="多目的挖矿创新"><a href="#多目的挖矿创新" class="headerlink" title="多目的挖矿创新"></a>多目的挖矿创新</h2><p>比特币的工作量证明机制的目的是：维护比特币系统的安全，构建去中心化的信任。<strong>很多人认为挖矿这一行为是一种浪费。</strong>（这个观点个人持保留态度）</p><p>多目的挖矿算法就是为了解决工作量证明导致的“浪费”问题而出现的。多目的挖矿的在为货币系统的安全加入额外需求的同时，也为<strong>该系统供需关系加入了额外的变量</strong></p><h3 id="PrimeCoin"><a href="#PrimeCoin" class="headerlink" title="PrimeCoin"></a>PrimeCoin</h3><p>与2013年7月发布，它的工作量证明算法可以搜索质数，计算孪生素数表。很有意思的，随着PrimeCoin新区块的不断产生，会不断的发现新的素数，构造一个科学成果：素数表</p><h3 id="CureCoin"><a href="#CureCoin" class="headerlink" title="CureCoin"></a>CureCoin</h3><p>与2013年5月发布。它把SHA256工作量证明算法和蛋白质褶皱结构的研究结合起来。蛋白质褶皱研究需要对蛋白质进行生化反应的模拟，用于发现治愈疾病的新药，但这一过程需要大量的计算资源</p><h3 id="GridCoin"><a href="#GridCoin" class="headerlink" title="GridCoin"></a>GridCoin</h3><p>与2013年10月发布。它结合了Scrpy为基础的工作量证明算法和参与BOINC计算项目的补贴机制。BONIC是伯克利发开的网络计算系统，算力是提供给这个平台的</p><h3 id="货币属性总结表-2"><a href="#货币属性总结表-2" class="headerlink" title="货币属性总结表"></a>货币属性总结表</h3><table><thead><tr><th style="text-align:center">货币名称</th><th style="text-align:center">出块速度</th><th style="text-align:center">货币总量</th><th style="text-align:center">一致性算法</th><th style="text-align:center">市场总值（到2017/9/25）</th><th style="text-align:center">24小时交易量</th></tr></thead><tbody><tr><td style="text-align:center">PrimeCoin</td><td style="text-align:center">1分钟</td><td style="text-align:center">没有上限</td><td style="text-align:center">计算素数</td><td style="text-align:center">$2,750,679</td><td style="text-align:center">$691,788</td></tr><tr><td style="text-align:center">CureCoin</td><td style="text-align:center">10分钟</td><td style="text-align:center">没有上限</td><td style="text-align:center">蛋白质研究</td><td style="text-align:center">$5,078,597</td><td style="text-align:center">$80,012</td></tr><tr><td style="text-align:center">GridCoin</td><td style="text-align:center">150秒</td><td style="text-align:center">没有上限</td><td style="text-align:center">BONIC</td><td style="text-align:center">$12,920,406</td><td style="text-align:center">$91,290</td></tr></tbody></table><h2 id="致力于匿名性的竞争币"><a href="#致力于匿名性的竞争币" class="headerlink" title="致力于匿名性的竞争币"></a>致力于匿名性的竞争币</h2><p>其实比特币的地址和显示中真是个人的关系还是比较容易通过大数据的分析手段计算出来的，所以有一些加密货币希望能在这方面有突破</p><h3 id="ZeroCoin-Zerocash"><a href="#ZeroCoin-Zerocash" class="headerlink" title="ZeroCoin/Zerocash"></a>ZeroCoin/Zerocash</h3><p>还在开发当中</p><h3 id="CryptoNote"><a href="#CryptoNote" class="headerlink" title="CryptoNote"></a>CryptoNote</h3><p>它提供一种以电子货币为基础的匿名性的参考实现，与2013年10月发布。它可以被克隆继而衍生出其他的实现，并内建了一个周期性的重置机制使其不能作为货币，很多竞争币基于它实现：入ByteCoin，Aeon，Boolberry，DuckNote，FantomCoin，Monero，MonetaVerde和Quazarcoin</p><h3 id="ByteCoin"><a href="#ByteCoin" class="headerlink" title="ByteCoin"></a>ByteCoin</h3><p>与2012年发布，是CryptoNote的第一个实现，之前还有一个同名的ByteCOin电子货币，BTE，这个为BCN。</p><p>ByteCoin使用了基于CryptNote的工作量证明机制，每个实例至少2MB的内存，是的GPU和ASIC矿机无法在Bytecoin中运行，它继承了CryptoNote的环签名、不可链接交易和块链抗分析匿名性等机制</p><h3 id="Monero"><a href="#Monero" class="headerlink" title="Monero"></a>Monero</h3><p>货币区县比ByteCoin平缓，在系统运行最开始的四年发型80%的货币</p><h3 id="货币属性总结表-3"><a href="#货币属性总结表-3" class="headerlink" title="货币属性总结表"></a>货币属性总结表</h3><table><thead><tr><th style="text-align:center">货币名称</th><th style="text-align:center">出块速度</th><th style="text-align:center">货币总量</th><th style="text-align:center">一致性算法</th><th style="text-align:center">市场总值（到2017/9/25）</th><th style="text-align:center">24小时交易量</th></tr></thead><tbody><tr><td style="text-align:center">ByteCoin</td><td style="text-align:center">2分钟</td><td style="text-align:center">1840亿</td><td style="text-align:center">基于CryptoNote</td><td style="text-align:center">$237,302,332</td><td style="text-align:center">$1,501,490</td></tr><tr><td style="text-align:center">Monero</td><td style="text-align:center">1分钟</td><td style="text-align:center">1840万</td><td style="text-align:center">基于CryptoNote</td><td style="text-align:center">$1,395,218,943</td><td style="text-align:center">$28,579,800</td></tr></tbody></table><h2 id="非货币型竞争区块链"><a href="#非货币型竞争区块链" class="headerlink" title="非货币型竞争区块链"></a>非货币型竞争区块链</h2><p>这些区块链设计模式有着自己独特的设计模式，并不主要作为货币使用。当然不少这种区块链也含有货币，但只不过它们的货币仅是一种象征，用于分配其他东西，比如一种资源或者一份合约。</p><h3 id="域名币-NameCoin"><a href="#域名币-NameCoin" class="headerlink" title="域名币 NameCoin"></a>域名币 NameCoin</h3><p>它是一种使用区块链的去中心化平台，用来注册和转让键-值对。也就是域名注册。现在，.bit的替代性域名服务（DNS）就是使用这个系统来完成。</p><p>用它注册的域名空间不受限制，人和人都可以以任意方式使用任意的命名空间</p><h3 id="Bitmessage"><a href="#Bitmessage" class="headerlink" title="Bitmessage"></a>Bitmessage</h3><p>它是一种去中心化安全消息服务的比特币竞争区块链。其本质是一个无服务器的加密电子邮件系统。</p><p>Bitmessage可以让用户通过一个Bitmessage地址来编写和发送消息。这些消息的运作方式与比特币交易大致相同，区别在于，消息的保存是有时间时间限制的，如果两天还没被送到目的地，就会消失。</p><p>Bitmessage的好处是可以抵御全面监视，除非网络偷听者破坏了接收方的谁被，否则无法截取邮件信息</p><h3 id="以太坊"><a href="#以太坊" class="headerlink" title="以太坊"></a>以太坊</h3><p>以太坊是一种图灵完备的平台，基于区块链账本，用于合约的处理和执行。它不是比特币的一个克隆，而是完全独立设计和实现的。币用来付合约执行的花费。</p><p>以太坊区块链记录的东西叫做合约，所谓合约，就是一种低级二进制码。本质上，合约是<strong>运行在以太坊系统中各个节点上的程序</strong>。这些程序可以存储数据、支付及收取、存储币以及执行无穷范围的计算行为，在系统中充当去中心化的<strong>自制软件代理</strong></p><h3 id="货币属性总结表-4"><a href="#货币属性总结表-4" class="headerlink" title="货币属性总结表"></a>货币属性总结表</h3><table><thead><tr><th style="text-align:center">货币名称</th><th style="text-align:center">出块速度</th><th style="text-align:center">货币总量</th><th style="text-align:center">一致性算法</th><th style="text-align:center">市场总值（到2017/9/25）</th><th style="text-align:center">24小时交易量</th></tr></thead><tbody><tr><td style="text-align:center">NameCoin</td><td style="text-align:center">10分钟</td><td style="text-align:center">2140刀2100万</td><td style="text-align:center">SHA256</td><td style="text-align:center">$20,536,647</td><td style="text-align:center">$125,689</td></tr><tr><td style="text-align:center">Ethereum</td><td style="text-align:center">14秒</td><td style="text-align:center">1亿</td><td style="text-align:center">转POS中</td><td style="text-align:center">$27,458,433,693</td><td style="text-align:center">$459,104,000</td></tr></tbody></table><h1 id="权益证明"><a href="#权益证明" class="headerlink" title="权益证明"></a>权益证明</h1><h2 id="什么是权益证明"><a href="#什么是权益证明" class="headerlink" title="什么是权益证明"></a>什么是权益证明</h2><p>权益证明（又称股权证明），英文单词 Proof of Stake，缩写PoS，与之平级的概念是工作量证明，Proof of Work，这个我们应该很熟悉了</p><p>PoS会根据你持有货币的量和时间，给你发利息。<strong>持有货币的时间，被称之为“币龄”</strong>，每个币每天产生<strong>1币龄</strong>。</p><p>例如，你持有100个币，总共持有30天，你的币龄就是3000，此时，若你发现了一个PoS算法支持的区块（<strong>直观来说就是你拥有币的数量和时间越长，你新建区块的几率越大</strong>），你的币龄就会被置0。你每被清空365币龄，你将会从区块中获得0.05个币的利息（相当于年利率5%），那么在这个案例中，利息 = 3000 * 5% / 365 = 0.41个币。</p><blockquote><p>这个利息的数量也是不同的币种自己来设定的，变为一种货币属性</p></blockquote><p>也就是说，<strong>你的“挖矿”收益将正比于你的币龄</strong>，与算力无关</p><p>这种新的一致性算法不要求证明完成一定数量的计算工作，而是要求证明者对<strong>某些数量的钱展示其所有权</strong>。中本聪没有这么做的原因其实是因为当年还没有一个去中心化的能展示个人财产的方式，而现如今，有一个展示财产的方式就是比特币本身。</p><h2 id="为什么要设计PoS"><a href="#为什么要设计PoS" class="headerlink" title="为什么要设计PoS"></a>为什么要设计PoS</h2><p>设计权益证明的初衷其实是为了解决比特币本身规则的几个痛点，这也是PoS的设计者，或者很多人公认的一些原因的概括，个人观点上<strong>并不完全认同</strong></p><h3 id="挖矿动机衰减"><a href="#挖矿动机衰减" class="headerlink" title="挖矿动机衰减"></a>挖矿动机衰减</h3><p>比特币每过240000个区块，区块奖励（Coinbase）就会减半。很多人对此表示担忧，<strong>他们认为在未来因为奖励的减少导致大家挖矿的动力越来越低</strong>，整个比特币网络就会陷入瘫痪（一种情况是大家都减少运行比特币客户端的时间，P2P可用链接节点就越来越少）</p><p>【解决方案】</p><p>在PoS体系中，<strong>只有打开钱包客户端程序，才能发现PoS区块，才能获得利息</strong>，这促使很多不想挖矿的人，也会打开钱包客户端（为了获得利息）</p><h3 id="共识攻击"><a href="#共识攻击" class="headerlink" title="共识攻击"></a>共识攻击</h3><p>按照第一条的逻辑，随着矿工的减少，比特币很有可能被一些高算力的人进行51%攻击，导致整个比特币网络攻击。个人观点是，只要比特币还有价值（甚至的对应电费的价值），世界上的人类贪婪的本性不会变，只有有利可图，或者利益足够吸引人，马上会有足够多人的去挖矿，所以会维持一种诡异的平衡。这个问题在各种PoS的说明书上被反复提到，个人观点是：不应该设想一种情况的发生，而是详细的从用户动机的角度来论证和思考，你很自然的通过现象得出一个结论，这种做法是很武断的</p><p>【解决方案】</p><p>当然，在PoS体系中，利息产生的货币是保存在PoS算法的区块中，直观结果是，这会要求攻击者还需要持有超过全球51%的货币量才可以，从侧面来说提高了攻击的难度</p><h3 id="通货紧缩体系"><a href="#通货紧缩体系" class="headerlink" title="通货紧缩体系"></a>通货紧缩体系</h3><p>比特币因为货币总量和丢失等问题，会导致通货紧缩</p><p>【解决方案】</p><p>对于PoS体系来说，可以通过调整年利率的方法来调控整体的紧缩和通胀状态。但是从侧面来讲，通货紧缩和通货膨胀都是经济学问题，说白了，是一种经济体（国家）运行状态，其中涉及到十分复杂的学问，对<strong>于加密货币本身来说，还远远没有到需要讨论紧缩和通胀的时候</strong></p><h1 id="智能合约"><a href="#智能合约" class="headerlink" title="智能合约"></a>智能合约</h1><p>自2017年以来，随着IBM，微软两大巨头的加入，以及各大银行的支持，区块链+智能合约的解决方案越来越受到大家的关注和重视。</p><h2 id="什么是智能合约"><a href="#什么是智能合约" class="headerlink" title="什么是智能合约"></a>什么是智能合约</h2><h3 id="合约"><a href="#合约" class="headerlink" title="合约"></a>合约</h3><p>合约的概念即合同，一个承诺，规定一个规则，大家必须遵守，并设定违反惩罚机制，这就是合约。但我们知道，合约的执行必须要有权威中心机构背书，在现代区块链实现点对点信任的基础上，合约的执行过程从某种程度来说，可以去中心化。从另一方面来说，<strong>提高了很多办事情的核心效率</strong>。</p><p>为什么这样说呢？因为现实生活中，我们对交易对象，合作伙伴，甚至婚姻都是不能说完全信任的，一方面因为<strong>人的善变特质</strong>，另一方面因为<strong>事物随时间进程推进的不确定性</strong>（比如车祸，或者不可预知的特殊情况）合约在当今社会是一个<strong>巨大的市场</strong>，没有合约，寸步难行，这么说，一点也不为过。而市场巨大的价值就是其提供的信任，而<strong>所谓智能合约，智能而字除了自动执行外，更加包含了一种由区块链本身原理带来的信任，</strong>这也是其本质价值所在</p><h3 id="智能合约-1"><a href="#智能合约-1" class="headerlink" title="智能合约"></a>智能合约</h3><p>这个名词或者说概念，提出的了时间非常早，是由尼克萨博于1996年提出的，定义为：</p><blockquote><p>一个智能合约是一套以数字形式定义的约定，包括合约参与方<strong>可以在上面执行这些约定</strong>的协议，智能合约的基本思想是，各种各样的合约条款，可以嵌入到我们所使用的硬件和软件中，从而使得攻击者需要很大的代价去攻击</p></blockquote><p>你可以想象，最简单的智能合约是就是一台自动售货机。合约内容是，你给他钱，他出商品，非常简单的内容。</p><p>复杂的合约，可以想象，现在Uber的所有打车过程都是由Uber的服务器完成，并且使用第三方支付系统来付款，如果使用智能合约变成“去中心化的Uber”，场景就变为，每一次乘车，以一种<strong>没有破绽的逻辑</strong>来触发<strong>乘车交易</strong>这一智能合约的内容，那么就可以完全省去付款的部分，合约自动打钱（当然这里打的钱只是区块链的上加密货币）。当然这只是<strong>强行设想</strong>的一种非常复杂的智能合约形式，在现实中，基本上是完全无法实现的。</p><p>智能合约（用于<strong>实现事务的业务规则</strong>结合后的产物）实际上是一种<strong>过程调用</strong>（Procedure call），可在网络中多个节点上运行，运行后输出的结果通过<strong>合意</strong>（Consensus）过程被所有网络成员认可</p><p>个人观点是：区块链+智能合约必须对应特定场景，特定需求，才可能有应用价值，比如对信任十分需求的场景，而传统解决方案中为了信任本身需要花费很大的代价或效率十分低下。</p><p>从最近各大银行的动态，还有新闻来看，<strong>银行贷款，保险，供应链管理，合规领域</strong>都是很有潜力的</p><p>但是智能合约+区块链面临的问题也很多，截止今天，也有很多项目或技术在为了落地它而努力</p><p>比如执行速度，执行成本，可扩展性，匿名性，和现实世界的隔离性，还有政策和法律的监管等等问题。</p><h2 id="以太坊技术栈"><a href="#以太坊技术栈" class="headerlink" title="以太坊技术栈"></a>以太坊技术栈</h2><p><a href="http://solidity.readthedocs.io/en/develop/" target="_blank" rel="noopener">Solidity</a>是一门需要学习的<strong>开发语言</strong></p><p>在应用层来说，还有对应网络部分的<a href="http://ethdocs.org/en/latest/connecting-to-clients/web3.js/" target="_blank" rel="noopener">web3.js</a>作为一个和<strong>网络部分交互的JavaScript API</strong></p><p>还有一些编译器（Solc），机器层面的（EVM）的工具，社区Library（Zepplin）等</p><h1 id="热点名词或概念总结"><a href="#热点名词或概念总结" class="headerlink" title="热点名词或概念总结"></a>热点名词或概念总结</h1><p>这个版块不定期更新，主要作为新技术的一个总结窗口</p><h2 id="RootStock"><a href="#RootStock" class="headerlink" title="RootStock"></a>RootStock</h2><p><a href="http://www.8btc.com/rootstock" target="_blank" rel="noopener">RootStock</a> 是一个建立在比特币区块链上的<strong>智能合约分布式平台</strong>。它的目标是，将复杂的智能合约实施为一个<strong>侧链</strong>，为核心比特币网络增加价值和功能。RootStock实现了<strong>以太坊虚拟机的一个改进版本</strong>，它将作为比特币的一个侧链，使用了一种可转换为比特币的代币作为智能合约的“燃料”。</p><h2 id="侧链-Sidechain"><a href="#侧链-Sidechain" class="headerlink" title="侧链 Sidechain"></a>侧链 Sidechain</h2><p><a href="http://www.8btc.com/sidechain" target="_blank" rel="noopener">楔入式侧链技术</a>（ pegged sidechains），它将<strong>实现比特币和其他数字资产在多个区块链间的转移</strong>，这就意味着用户们在使用他们已有资产的情况下，就可以访问新的加密货币系统。目前，侧链技术主要是由Blockstream公司负责开发。</p><h2 id="闪电网络-Lightning-Network"><a href="#闪电网络-Lightning-Network" class="headerlink" title="闪电网络 Lightning Network"></a>闪电网络 Lightning Network</h2><p><a href="http://www.8btc.com/lightning-network" target="_blank" rel="noopener">闪电网络</a>的目的是<strong>实现安全地进行链下交易</strong>，其本质上是使用了哈希时间锁定智能合约来安全地进行0确认交易的一种机制，通过<strong>设置巧妙的‘智能合约’</strong>，使得用户在闪电网络上进行未确认的交易和黄金一样安全（或者和比特币一样安全）。</p><h2 id="超级账本-Hyperledger"><a href="#超级账本-Hyperledger" class="headerlink" title="超级账本 Hyperledger"></a>超级账本 Hyperledger</h2><p><a href="http://www.8btc.com/hyperledger" target="_blank" rel="noopener">超级账本</a>（hyperledger）是Linux基金会于2015年发起的<strong>推进区块链数字技术和交易验证的开源项目</strong>，加入成员包括：荷兰银行（ABN AMRO）、埃森哲（Accenture）等十几个不同利益体，<strong>目标是让成员共同合作，共建开放平台，满足来自多个不同行业各种用户案例，并简化业务流程</strong>。</p><p>由于点对点网络的特性，分布式账本技术是完全共享、透明和去中心化的，故非常适合于在金融行业的应用，以及其他的例如制造、银行、保险、物联网等无数个其他行业。</p><p>通过创建<strong>分布式账本的公开标准</strong>，实现虚拟和数字形式的价值交换，例如资产合约、能源交易、结婚证书、能够安全和高效低成本的进行追踪和交易。</p><p>如果想进一步具体案例，这篇文章可能可以帮到你，<a href="http://www.8btc.com/blockchain-poc-hyperledger" target="_blank" rel="noopener">使用Hyperledger Composer十分钟搭建区块链概念验证环境</a></p><h2 id="面向商业的区块链基础设施平台"><a href="#面向商业的区块链基础设施平台" class="headerlink" title="面向商业的区块链基础设施平台"></a>面向商业的区块链基础设施平台</h2><p>现在最常见<strong>四大区块链技术开源平台</strong>，Ethereum、来自IBM的Fabric、Corda和BCOS</p><p>在四个开源技术平台中，Ethereum代表的是<strong>公有链技术</strong>，Fabric、Corda和BCOS代表的是<strong>联盟链，即多个机构联合创建，需要身份验证的半公开“受控”系统</strong>。</p><p>在<strong>公有链、私有链还是联盟链</strong>中选型，取决于开发者和应用场景的需求。<strong>对于“安全”有特殊需求的金融机构和企业级应用</strong>来说，联盟链的低风险与高可控，最有利于说服法律部门和监管者</p><h2 id="OpenBazzar"><a href="#OpenBazzar" class="headerlink" title="OpenBazzar"></a>OpenBazzar</h2><p><a href="http://www.8btc.com/openbazaar" target="_blank" rel="noopener">OpenBazzar</a>是一个结合了ebay与BitTorrentt特点的<strong>去中心化商品交易市场</strong>，使用比特币进行交易，既没有费用，也不用担心受到审查。</p><p>因此相对于易趣与亚马逊这些提供中心化服务的电子商务平台，<strong>通过OpenBazz不需要支付高额费用、不需要担心平台收集个人信息致使个人信息泄露或被转卖用作其他用途</strong>。</p><p>2015年，获得了由科技行业的两大风投公司Andreessen Horowitz和Union Square Ventures 投资。</p><p>关于如何使用OpenBazzar建立新的交易推荐文章：<a href="http://www.8btc.com/what-is-openbazaar" target="_blank" rel="noopener">什么是OpenBazzar</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】&lt;strong&gt;不断更新&lt;/strong&gt;的wiki博客&lt;br&gt;【内容简介】总结市面上不同的币种，关注区块链技术的最新进展，整理总结各种新名词，新概念，新技术相关概念和文章&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/categories/BlockChain/"/>
    
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/tags/BlockChain/"/>
    
      <category term="Ethereum" scheme="https://charlesliuyx.github.io/tags/Ethereum/"/>
    
  </entry>
  
  <entry>
    <title>【区块链】一文看懂区块链：一步一步发明比特币</title>
    <link href="https://charlesliuyx.github.io/2017/09/24/%E4%B8%80%E6%96%87%E5%BC%84%E6%87%82%E5%8C%BA%E5%9D%97%E9%93%BE-%E4%BB%A5%E6%AF%94%E7%89%B9%E5%B8%81%E4%B8%BA%E4%BE%8B/"/>
    <id>https://charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/</id>
    <published>2017-09-24T07:09:42.000Z</published>
    <updated>2019-03-28T13:14:13.417Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】29 ~ 35 min | 11872 words<br>【内容简介】此文潜在面向群体是对区块链或比特币的运行原理完全不了解的人。所以会从<strong>用户需求</strong>的角度出发，<strong>一步一步发明区块链（或者说比特币，因为两者互相依存）</strong>，在此之后的内容有关比特币与金融，ICO，竞争币等，可选择性阅读。<br><a id="more"></a></p><p><a href="https://www.zhihu.com/question/37290469/answer/236442981" target="_blank" rel="noopener">如果有帮助求知乎点个赞，感谢！</a></p><blockquote><p><strong>因为贪婪，所以信任</strong></p></blockquote><h1 id="加密货币"><a href="#加密货币" class="headerlink" title="加密货币"></a>加密货币</h1><p>在一步一步发明发明比特币之前，解释几个直观的认知：</p><p>我们常说的比特币，是<strong>加密货币（Cryptocurrency）</strong>的一种，而加密货币<strong>实现去中心化</strong>的最关键的技术是<strong>区块链</strong></p><p>有些地方可能把加密货币又称为数字货币（或称电子货币），但实际上，加密货币是数字货币的子集，同为子集的还有<strong>虚拟货币</strong>（如Q币），<strong>加密货币</strong>的称谓要更加专业</p><p>加密货币一定具有下列三个特点</p><ul><li><strong>去中心的清算</strong></li><li><strong>分布式的记账</strong></li><li><strong>离散化的支付</strong></li></ul><p><strong>为了实现这些特点</strong>，需要使用到<strong>区块链技术</strong>。这里的区块链技术是一个很广义的范畴，它包含了密码学，算法等很多不同的内容，其中最精彩的点子，可算是<strong>工作量证明 = 共识</strong>了</p><p>还有另一个<font color="FF0000">层次更高</font>的角度：从<strong>解决拜占庭将军问题</strong>的角度入手来<strong>分析和科普</strong>【区块链技术】的（可参看我的另一篇博客<a href="">【区块链】如何解决拜占庭将军问题</a>），我觉得这个角度更加接近于区块链哲学的本质，毕竟，比特币具有价值属性和交易属性，和金融有紧密的联系，但是区块链是一种<strong>分布式存储系统</strong>，若仅仅从比特币（代币）的角度来解释，非常片面。<font color="“17139C”">毕竟，比特币，就是<strong>分布式去中心化共识记录系统</strong>中的一个字段</font></p><h1 id="一步一步发明比特币"><a href="#一步一步发明比特币" class="headerlink" title="一步一步发明比特币"></a>一步一步发明比特币</h1><h2 id="第一个用户需求-账本和电子签名的由来"><a href="#第一个用户需求-账本和电子签名的由来" class="headerlink" title="第一个用户需求 - 账本和电子签名的由来"></a>第一个用户需求 - 账本和电子签名的由来</h2><blockquote><p>第一个用户需求描述了<strong>中心化清算系统</strong>几个关键内容的由来，只对区块链感兴趣的读者可以跳过</p></blockquote><p>经济体的蓬勃发展离不开<strong>交易</strong>。在交易过程中，人们早已发现使用一般等价物（如金银）十分麻烦，发明了纸币（最早的来自中国，北宋时代四川地区的纸币交子的<strong>清算体系</strong>，是<strong>生产力发展的必然产物，最终的目标是提高生产效率</strong>），现如今，人们发现，<strong>携带现金也很麻烦</strong></p><p>这是第一个基本用户需求：<strong>摆脱现金进行交易带来的不便</strong></p><p><strong>【解决办法】</strong>几个用户使用<strong>公共账本</strong>记录转账记录，<strong>月底结算</strong>，<strong>账本公开</strong>，每个人都可以修改，也就是说可以在上面添加新行（一笔交易），如<code>小明转账给小红10块钱</code></p><h3 id="产生的问题1：身份问题"><a href="#产生的问题1：身份问题" class="headerlink" title="产生的问题1：身份问题"></a>产生的问题1：身份问题</h3><p>在这个账本条目上我们无法确认交易双方<code>小明</code>和<code>小红</code>是否是本人，可能出现伪造（逍遥法外电影中的伪造支票）</p><p><strong>【解决办法】</strong>使用<strong>电子签名</strong>，即公钥 - 私钥对</p><p>记住，<strong>电子签名被发明的核心目的</strong>是希望在电子文档也能有一个类似与现实中个人笔迹的签名，目的一定是：<strong>确认写这个签名的人是本人，即身份确认（验证）</strong></p><p>私钥顾名思义，也叫做密钥，是你<strong>本人需要需要妥善保管和保存的</strong><br>$$<br>Sign(\text{信息},私钥) = \text{电子签名}<br>$$<br>Sign在这里是一个函数，可以理解为<strong>一连串计算（变换）</strong>，这一连串计算有一个特点，就是<strong>输入值只要改变一点点</strong>，输出就会<strong>完全改变</strong>。信息和私钥一起，可以得到一个电子签名。并且这个电子签名不能被轻易的复制到其他信息里，原因是因为每一个电子签名都和<strong>这一段信息</strong>有关联。<br>$$<br>Verify(\text{信息},\text{电子签名},\text{公钥}) = \text{真/假}<br>$$<br>在进行<strong>验证</strong>的时候，Verify也是一个函数，<strong>输入值是信息，电子签名，公钥，输出是一个True or False</strong>，来判断这个<strong>电子签名</strong>是真的还是假的。</p><p>这个时候可能有人就要问了，这个电子签名我难道不能试出来吗？很不幸，这是一个有<strong>256bit的1/0字符串</strong>，可能性是2的256次方，2的10次方是1024，我只能告诉你这么多了。</p><p>解释完电子签名，我们来看看实例。<code>小明</code>使用自己的私钥加上<code>小明转给小红10块钱</code><strong>这段话</strong>通过Sign函数生成一个签名（256位），把签名放在这条转账信息的后面，通过之前的讲解，这个签名就能保证<code>小明</code>已经过目了，并且说：“这真的是我<code>小明</code>，不用怀疑了！肯定是我”</p><p>直观结果是，我们可以利用<strong>密码学的手段</strong>，只要有对应人的<strong>数字签名</strong>，我们保证<code>小明</code>和<code>小红</code>的<strong>身份能被100%确认真实</strong></p><p>但是这个解决方案有一个小漏洞：可以<strong>复制同一行信息</strong>来伪造交易记录，解决的办法是添加一个<strong>这笔交易独有的信息（比如时间戳）</strong></p><h3 id="产生的问题2：欠债跑路问题"><a href="#产生的问题2：欠债跑路问题" class="headerlink" title="产生的问题2：欠债跑路问题"></a>产生的问题2：欠债跑路问题</h3><p>如果<code>小明</code>在此时账户上已经没有足够的余额进行支付，就会出现超支问题</p><p><strong>【解决办法】</strong>添加余额记录，此时就不可避免的需要一个<strong>中间担保人（国家？信誉机构？银行？）</strong>为<code>小明</code>进行余额担保</p><h3 id="一个大家都遵守的协议"><a href="#一个大家都遵守的协议" class="headerlink" title="一个大家都遵守的协议"></a>一个大家都遵守的协议</h3><p>此时，现代金融体系的框架基本建立完毕，协议内容是</p><ul><li>任何人都可以在<strong>账本上添加新行</strong></li><li>固定时间间隔时用<strong>真金白银进行清算</strong></li><li>只有有<strong>签名的交易</strong>是有效的</li><li>中间担保的人<strong>保证不可超支</strong></li></ul><p>此时发现一个很有趣的发现，这个比较严谨的协议有一个特点：<strong>如果所有人都按照这个协议来办事，我们可以用任何形式的东西来代替人民币了</strong>，换句话说，就是我根本不关心你在账本上添加的新行的交易内容是什么，可以是任何东西</p><p>利用这个提出需求再解决问题的过程，强化一个<strong>认知</strong>：<strong>货币 = 交易记录（账本），即货币的本质是交易记录</strong>，在这背后，有一个前提是，货币的另一个本质是一种<strong>共识</strong>，我们都信任它有价值的共识</p><h2 id="第二个用户需求：账本放在哪里？"><a href="#第二个用户需求：账本放在哪里？" class="headerlink" title="第二个用户需求：账本放在哪里？"></a>第二个用户需求：账本放在哪里？</h2><p>传统的（现在的）解决方案当时是，使用中心代理-<strong>银行</strong>，来存放账本</p><p>既然是第二个用户需求，那肯定就是因为现在的解决方案大家都<strong>不满意</strong></p><h3 id="核心需求：去中心化"><a href="#核心需求：去中心化" class="headerlink" title="核心需求：去中心化"></a>核心需求：去中心化</h3><p>中心化的痛点大致可以说几点</p><ul><li>银行<strong>效率低下</strong>，一笔跨国转账的等待时间较长</li><li><strong>胖银行金融体系</strong>因部分准备金制度等等方便的规则，能抬升杠杆，产生金融泡沫，进一步诱发金融危机</li><li><strong>私有财产神圣不可侵犯</strong>是精英与平民，剥削与被剥削者几个世纪以来博弈的风暴中心</li></ul><p>当然还有很多没有提到（比如好处，控制经济发展速度，调控供需平衡等），总之，是一种一直饱受诟病的清算方式，此时，中本聪在2009年横空出世，他提出了一种全新的<strong>清算方法</strong>，并且真正解决了陌生人间信用的问题！接下来就是真正的一步一步的发明比特币了</p><h3 id="如何实现分布记账（去中心化）"><a href="#如何实现分布记账（去中心化）" class="headerlink" title="如何实现分布记账（去中心化）"></a>如何实现分布记账（去中心化）</h3><p>为了去中心化，我们可以反其道而行之：每个用户保存账本，分布记账。用户产生一笔交易就<strong>将这笔交易广播到到网络上所有的节点上</strong>，这样不就完美的去中心化了？</p><div align="center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/broadcast.gif" alt="广播示意图" width="550"></div><p>只要是明眼人都能发现，太天真的，这个方法行不通。若行不通，那就把行不通的原因总结出来</p><blockquote><p>遇到问题，总结不可行的原因，寻找解决方案。这是<strong>整个人类不断前进的核心最小单位</strong></p></blockquote><h4 id="问题核心"><a href="#问题核心" class="headerlink" title="问题核心"></a>问题核心</h4><font color="FF0000">如何让所有人都同意这个新账本？如何保持这些账本同步？有一笔交易发生时，如何让其他人都听到并相信这一笔交易呢？</font><p>这些问题才是真正的核心：<strong>是否能在协议（办法，规则）中添加几行，找到办法，来决定是否接受交易，并确定交易顺序，使你可以放心的相信，世界上遵守同一协议的所有人手上的账本都和你的一模一样呢？</strong>（问题描述值得品读，只有抽象出问题才能更好的去寻找解决方案）</p><h4 id="☆解决方案"><a href="#☆解决方案" class="headerlink" title="☆解决方案"></a>☆解决方案</h4><p>解决的思路是：哪个账本的<strong>计算工作量大</strong>，就信任哪个账本。换个角度来说是<strong>【让交易欺诈和账本不一的情形的计算力成本高到不能接受甚至完全不可行】</strong>。那问题就来了，到底什么是【计算工作量】，账本怎么可能有计算工作量呢？这里思维跳跃会大一些，需要一些耐心，慢慢来</p><h5 id="1、密码学：哈希函数"><a href="#1、密码学：哈希函数" class="headerlink" title="1、密码学：哈希函数"></a>1、密码学：哈希函数</h5><p>哈希函数，<strong>输入</strong>可以是任意信息或者文件，<strong>输出</strong>是固定长度的比特串。例如256bit的1/0串，这个输出叫做这个信息的<strong>“哈希值”或者“摘要”（digest）</strong>。SHA256就是一个哈希函数</p><div align="center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/hashfunction.gif" alt="" width="600"></div><p>密码哈希函数有几个特点</p><ul><li>特点是<strong>输入值稍微变化后，结果就会有很大的不同，完全无法预测不同输入间的规律</strong></li><li><strong>逆向计算</strong>不可行，只能使用试错法（穷举法），解空间 $2^{256}$ </li></ul><p>在每一个账本后添加一个<strong>特殊数字</strong>，对账本的<strong>所有字符</strong>使用SHA256函数处理，我们要求这个<strong>特殊数字</strong>（账本结尾的一串数字）可以使得SAH256函数输出值的开头有<strong>30个零</strong>（关于如何确定0的个数问题，在后面部分有详细的说明）</p><div align="center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/30zero2.gif" alt="" width="600"></div><p>根据之前说过SHA256的性质：输入变化输出不可预测，找到这个特殊数字唯一的办法就是穷举。换言之，你很容易就证明了他们<strong>进行了海量的计算</strong>。而这个<strong>寻找特殊数字的过程</strong>就是<strong>工作量证明</strong>（proof of work）</p><p>这就意味着，所有的工作量证明就对应了交易列表（账本 Ledger），如果你修改了一个交易，哪怕只是其中一个字符，就会完全改变哈希值，就得<strong>重做工作量证明</strong>，直观动图如下</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/30zerochange.gif" alt="修改后的重新计算" title="">                </div>                <div class="image-caption">修改后的重新计算</div>            </figure><h5 id="2、区块链-信任与共识的基石"><a href="#2、区块链-信任与共识的基石" class="headerlink" title="2、区块链 - 信任与共识的基石"></a>2、区块链 - 信任与共识的基石</h5><p>每一个小账本被称为<strong>区块</strong>，<strong>每一个不同的区块链协议（产生不同的加密货币）</strong>都会规定每一个<strong>区块的大小</strong>（最初比特币为1M）    </p><p><strong>账本组成区块，区块构成链表，区块的头包含前一块的哈希值，这就是区块链</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/blockchain1.gif" alt="区块链的诞生" title="">                </div>                <div class="image-caption">区块链的诞生</div>            </figure><p>如此一来，<strong>任何人就不能随意修改其中的内容，或者交换顺序</strong>。如果你这么做，意味着<strong>你需要重新计算所有的特殊数字</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/blockchain2.gif" alt="修改任何部分都以为着重新计算" title="">                </div>                <div class="image-caption">修改任何部分都以为着重新计算</div>            </figure><p>规定，<strong>允许世界上的每一个人建造区块</strong>。每一个新建区块的人（找到了这个特殊数字 - SHA256值有30个零）都能获得奖励，对于<strong>新建区块的这部分人（矿工）</strong>来说</p><ul><li>没有发送者信息，不需要签名</li><li>每一个新区块都会给<strong>整个币种增加新的虚拟（加密）货币</strong></li><li>新建区块的过程又被称为“挖矿”：需要大量工作量并且可以向整个经济体注入新的货币</li><li>挖矿的工作是：<strong>接受交易信息，建造区块，把区块广播出去，然后得到新的钱作为奖励</strong></li><li>对每个矿工来说，每个区块就像一个<strong>小彩票</strong>，所有人都在拼命快速猜数字，直到有一个幸运儿找到了一个<strong>特殊数字</strong>，<strong>使得整个区块的哈希值开头有许多个零，就能得到奖励</strong>。我记得有一个知乎答主给了一个形象的比喻，区块链就像一个拥有貌美如花女儿（区块）的国王，有很多的青年翘首以盼，而国王的方法是<strong>出了一道很难得题目</strong>让所有的青年计算（学习改变人生），谁算的快（在计算哈希值过程也可能是运气好）就能抱得美人归</li><li><strong>对于想用这个系统来收付款的用户来说，他们不需要收听所有的交易，而只要收听矿工们广播出来的区块，然后更新到自己保存的区块链中就可以了</strong></li></ul><h5 id="3、51-算力-共识攻击"><a href="#3、51-算力-共识攻击" class="headerlink" title="3、51%算力-共识攻击"></a>3、51%算力-共识攻击</h5><p>这里有一个小漏洞，因为网络的延迟或者有人在篡改区块链等因素，你作为一个收听网络广播的用户，如果同时接受到两条不同的区块链怎么办？其中的交易信息发生了冲突</p><blockquote><p>注：区块链本身就是最终的大账本，发生交易的唯一方法就是把你的交易加入到大账本上。具体来说，就是让矿工把你的交易记录加入它新挖到的区块中，并把这个区块链接到区块链上。链表的纽带，当然就是工作量证明</p></blockquote><p>对于上面的问题，用户的解决方案也比较简单：即，<strong>只保留最长的且难度系数最高的，也就是包含的工作量最大的那一条</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/bloackchain-conflict.gif" alt="用户保留最长的区块链" title="">                </div>                <div class="image-caption">用户保留最长的区块链</div>            </figure><p>这里有一个Trick，<strong>即所谓信任工作量最大不仅仅是出【一道难题】，还通过等待多个区块的产生引入世界上所有矿工之间的博弈</strong>（吃瓜群众，坐看大戏，谁厉害我选谁，你们尽管斗）</p><p>个人观点：区块链的Idea最核心的创新就是从技术上把<strong>信任和贪婪画了等号</strong>。<font color="“FF0000”">因为贪婪</font>（希望去竞争建立区块的建立和交易费）<font color="“FF0000”">所以信任</font>（全网算力越大，用户越放心），这句话甚至带上了些许哲学和传奇的色彩</p><p>对于用户来说，是这样一种情景</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/bloackchain-trust.gif" alt="如何更新本地区块链" title="">                </div>                <div class="image-caption">如何更新本地区块链</div>            </figure><p>其中的原因是，你可以假设Alice希望篡改一个交易信息，那么就意味着Alice需要不断的通过计算维护这个区块链了。<strong>也就是说每一次有新的区块链产生，Alice都需要不断的抢到这个彩票</strong>，理论上来说，他至少必须拥有全网51%以上的算力才能做到这一点，更多的，<strong>随着用户等待区块的增加，这个难度，幂次上升</strong>，在7-8个区块链产生后，概率上来讲，就是<strong>绝对信任</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/bloackchain-conflict2.gif" alt="无穷大的篡改成本" title="">                </div>                <div class="image-caption">无穷大的篡改成本</div>            </figure><p>此时</p><ul><li>我们用<strong>数字签名</strong>保证了不能伪造交易记录</li><li>用<strong>区块链及工作量证明</strong>保证了不能篡改其中的信息</li></ul><p>这两点，就完成了：<font color="FF0000"><strong>证明区块链的每一条交易记录都是可信的这一终极目标</strong></font></p><h3 id="总结-系统可行性分析"><a href="#总结-系统可行性分析" class="headerlink" title="总结 - 系统可行性分析"></a>总结 - 系统可行性分析</h3><p>只需给出一个命题来思考：<strong>我们如何才能在这个系统下骗人呢</strong>？</p><ul><li>如果你想篡改一笔不存在的交易记录，那么你必须比所有人都算的快，赢得这个彩票</li><li>但<strong>所有用户</strong>会继续收听其他矿工的广播</li><li>所以为了让所有用户继续相信这个伪造的区块</li><li>你必须投入自己所有的工作量，不断给<strong>篡改后的区块链分叉</strong>增添新的区块</li><li><strong>记住：根据协议，所有用户会一直信任他所知道的最长的链</strong></li><li>是的，你<strong>持续的竞争过世界上所有的矿工</strong>的概率或者说代价，实在太大了，得不偿失（其实<strong>法律也是一样的道理</strong>，它强制给违法的人给予惩罚，让违法者付出他们不能承受的代价了保证公平和社会稳定运行）</li><li>注意，作为一个用户，你不能立马相信你所听到的最新区块，而是应该等待多几个区块被创建过后，再确认这的确是世界所有人都在使用的区块链（比特币的原则中，<strong>等待6个区块</strong>，才确认）</li></ul><h2 id="发明过程中的关键点"><a href="#发明过程中的关键点" class="headerlink" title="发明过程中的关键点"></a>发明过程中的关键点</h2><ul><li>电子签名 Digital Signatures</li><li>公共账本就是货币 The Ledger is the currency</li><li>去中心化 Decentralize</li><li>工作量证明 Proof of work</li><li>区块链 Block Chain</li></ul><h1 id="比特币技术"><a href="#比特币技术" class="headerlink" title="比特币技术"></a>比特币技术</h1><p>到这里，已经发明了比特币，<strong>解决了去中心化的信任这一难题</strong>。只对比特币和区块链是什么这个问题感兴趣的读者，<font color="“FF0000”">可以停在这里了</font>，希望大家可以在我的叙述中解决一些困惑！鞠躬！</p><p>针对比特币的一些实现的内在细节，继续在探索和学习的道路上披荆斩棘。新技术，新点子，要拥抱它，使用它，判断它，<strong>必须先追根究底了解它</strong></p><p>我们知道区块链中记载的核心内容，对于比特币（加密货币）来说就是<strong>转账记录</strong>。但是，<strong>一个概念真正落地成大众可以用的服务</strong>，有很多技术上，协议上的细节。接下里的部分主要探讨一些<strong>比特币具体实现方面的细节</strong>，如网络节点构成，比特币的计算难度系数，比特币总量的由来，比特币一笔交易发生的内部细节等</p><h2 id="比特币网络节点的构成"><a href="#比特币网络节点的构成" class="headerlink" title="比特币网络节点的构成"></a>比特币网络节点的构成</h2><p>比特币网络是一种<strong>点对点的数字现金系统（P2P）</strong>，网络节点中每台机器都彼此对等。P2P网络不存在任何服务端、层级关系或者中心化服务。</p><h3 id="节点类型与分工"><a href="#节点类型与分工" class="headerlink" title="节点类型与分工"></a>节点类型与分工</h3><div align="center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/AllFunctionNode.svg" alt="全功能节点" width="250"></div><p>一个全功能节点包含上述4个模块【钱包<strong>W</strong>allet】【矿工<strong>M</strong>iner】【完整区块链full <strong>B</strong>lock-chain database】【网络路由节点<strong>N</strong>etwork routing】</p><ul><li>【网络路由节点】使得节点具有<strong>参与验证并传播交易与区块信息，发现监听并维持点对点的链接</strong>的能力</li><li>【完整区块链】具有此模块的节点被称为：全节点。它能够<strong>独自自主的校验所有交易</strong>，不需要任何其他信息。</li><li>【钱包】比特币的所有权是通过数字密钥、比特币地址和数字签名来确定的，数字密钥实际上并不是存储在网络中，而是由用户生成并存储在一个文件或简单的数据库中，称为钱包。有些节点仅仅保留<strong>区块链的一部分</strong>，通过一种”简易支付验证“（SPV Simplified Payment Verification）的方法来完成交易</li><li>【矿工】挖矿节点以相互竞争的方式创造新的区块。有一些挖矿节点也是全节点，可以独立挖矿；还有一些参与矿池挖矿的节点是轻量级节点，<strong>必须依赖矿池服务器维护全节点进行工作</strong></li></ul><p>拥有全部四个模块被称之为<strong>核心客户端（Bitcoin Core）</strong>，除了这些主要节点类型外，还有一些服务器及节点运行其他协议，如特殊矿池挖矿协议、轻量级客户端访问协议。</p><p>下表为扩展比特币网络的不同节点类型</p><table><thead><tr><th style="text-align:center">图示</th><th style="text-align:center">名称</th><th style="text-align:center">说明</th></tr></thead><tbody><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/SoloMiner.svg" alt="" width="80"></td><td style="text-align:center">独立矿工</td><td style="text-align:center">具有完整区块链副本</td></tr><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/FullBlockChainNode.svg" alt="" width="80"></td><td style="text-align:center">完整区块链节点</td><td style="text-align:center">此种节点有时有中继作用，不断收听网络广播，维护完整区块链</td></tr><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/SPVwallet.svg" alt="" width="80"></td><td style="text-align:center">轻量(SPV)钱包</td><td style="text-align:center">移动端，或者不想太过于笨重的桌面端，只需要进行交易广播操作</td></tr><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/PoolProtocolServers.svg" alt="" width="80"></td><td style="text-align:center">矿池协议服务器</td><td style="text-align:center">将运行其他协议的节点，连接至P2P网络的网关路由器</td></tr><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/MiningNodes.svg" alt="" height="80px"></td><td style="text-align:center">挖矿节点</td><td style="text-align:center">不具有区块链，但具备Stratum协议的节点或其他矿池挖矿协议的网络节点</td></tr><tr><td style="text-align:center"><img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/StratumWallet.svg" alt="" width="80"></td><td style="text-align:center">轻量 Stratum 钱包</td><td style="text-align:center">不具有区块链的钱包、运行Stratum协议的网络节点</td></tr></tbody></table><h3 id="扩展比特币网络"><a href="#扩展比特币网络" class="headerlink" title="扩展比特币网络"></a>扩展比特币网络</h3><p>要在全世界的网络中完成整个的交易，下图描述了一个扩展比特币网络，它包含了多重类型的节点、网关服务器、边缘路由器、钱包客户端以及它们互相连接所需要的各类协议，比特币互相连接的接口一般使用<code>8333端口</code></p><p>可以参看这个文章了解Stratum协议，<a href="http://www.8btc.com/stratum_protocol" target="_blank" rel="noopener">Stratum协议详解</a></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/BitcoinNet.png" alt="扩展比特币网络" title="">                </div>                <div class="image-caption">扩展比特币网络</div>            </figure><h2 id="如何控制区块产生速度恒定"><a href="#如何控制区块产生速度恒定" class="headerlink" title="如何控制区块产生速度恒定"></a>如何控制区块产生速度恒定</h2><h3 id="难度系数"><a href="#难度系数" class="headerlink" title="难度系数"></a>难度系数</h3><p>我们在发明比特币的过程已经详细说明了<strong>工作量证明</strong>寻找一个特殊数字使得SHA256函数的输出字符串的前<code>n</code>位是零</p><p>对于每一种不同的加密货币来说，都有<strong>一个值</strong>需要在建立货币的时候时候被定义，即<strong>每一个新区块在当前全网算力的条件被发现的【平均时间】</strong>，这也是难度系数的由来</p><blockquote><p> 比特币10分钟；以太坊15秒；瑞波币3.5秒；莱特币2.5分钟</p></blockquote><p>抛开代码算法层面来说，实现方法就是通过找前<code>n</code>位是0的方法。从概率角度来说，n值越大，意味找到这个这个数的解范围越小。</p><p>随着需求<code>0</code>的数目一个一个增加，<strong>需要的计算时间将会程指数增长</strong>。</p><p>那么肯定会问，这个难度值如何动态调整？由谁调整？</p><h3 id="难度调整方式"><a href="#难度调整方式" class="headerlink" title="难度调整方式"></a>难度调整方式</h3><p>难度的调整实在每个完整节点中自动发生的。如果网络发现区块产生速率比10分钟要快时会增加难度。如果发现比10分钟慢时则降低难度。</p><p>例如比特币中的是这样定义的：每2016个区块后计算生成它们花费的时长，比上20160（14天）调整一次。有人可能会问，如果在这十四天内计算能力暴涨怎么办，其实这个10分钟的区块新建间隔的规定也只是一个估计要求，真实情况下，<strong>这个时间会偏离10分钟这个设定值很多，但是这种偏差并不会对整个区块链的运行产生影响</strong></p><p>但是有人会问，这个过程是靠脚本（代码）来实现的，还是自己手动调整的呢？答案是，本地挖矿节点根据自己看到的链上信息自己调整。</p><p>问题又来了，为何我不自己降低难度，让自己更加容易新建区块呢？其实，因为链上所有节点确认新的区块（只有确认了你才能得到回报）是按照最长链并且计算难度最大来判断的，你如果用很小的难度新加的区块，是肯定跑不赢全网的其他矿工的</p><h2 id="比特币总量的由来"><a href="#比特币总量的由来" class="headerlink" title="比特币总量的由来"></a>比特币总量的由来</h2><p>我们已经知道，矿工没新建一个区块就可以得到一定数量的比特币作为奖励，最开始，一个区块可以得到<code>50BTC</code>的奖励，之后每210000个区块，奖励减半，直到2140年，所有的比特币将会发放完毕，可以得到公式<br>$$<br>Total = 210000 \times(50 + 25 + 12.5 + \ldots) = 20999999980 \approx \text{2100万}<br>$$<br>而这个规则不同的竞争币种都可以自由设置。但是因为<strong>交易费的存在</strong>，挖矿的人还是会有收益，否则无法建立新的区块，那么整个比特币网络就瘫痪了</p><h2 id="比特币的交易处理能力"><a href="#比特币的交易处理能力" class="headerlink" title="比特币的交易处理能力"></a>比特币的交易处理能力</h2><h3 id="现在比特币区块链的区块信息"><a href="#现在比特币区块链的区块信息" class="headerlink" title="现在比特币区块链的区块信息"></a>现在比特币区块链的区块信息</h3><p>我现在直接从<a href="https://blockchain.info/" target="_blank" rel="noopener">BLOCKCHAIN</a>上，在我写下这句话的时候，最新的区块是情况</p><table><thead><tr><th style="text-align:center">区块高度</th><th style="text-align:center">存在时间</th><th style="text-align:center">交易数量</th><th style="text-align:center">交易额</th><th style="text-align:center">创建人(矿池)</th><th style="text-align:center">大小(KB)</th><th style="text-align:center">重量(kWU)</th></tr></thead><tbody><tr><td style="text-align:center">486883</td><td style="text-align:center">3分钟</td><td style="text-align:center">2126</td><td style="text-align:center">25992.38</td><td style="text-align:center">BTC.TOP</td><td style="text-align:center">999.34</td><td style="text-align:center">3917.54</td></tr><tr><td style="text-align:center">486882</td><td style="text-align:center">23分钟</td><td style="text-align:center">2422</td><td style="text-align:center">33926.89</td><td style="text-align:center">BTCC Pool</td><td style="text-align:center">1034.39</td><td style="text-align:center">3996.58</td></tr><tr><td style="text-align:center">486881</td><td style="text-align:center">51分钟</td><td style="text-align:center">358</td><td style="text-align:center">4480.22</td><td style="text-align:center">BTC.TOP</td><td style="text-align:center">191.92</td><td style="text-align:center">718.14</td></tr><tr><td style="text-align:center">486880</td><td style="text-align:center">53分钟</td><td style="text-align:center">352</td><td style="text-align:center">3770.26</td><td style="text-align:center">BTC.TOP</td><td style="text-align:center">197.27</td><td style="text-align:center">715.72</td></tr></tbody></table><p>其中的重量是指的实际存储的大小，这个值和交易协议有关，其实可以忽略。非常幸运的是，<strong>这几个区块放佛是专门为讲解这一节而出现的</strong>，这可能是天意吧</p><p>另外插一句，你会发现<strong>平均区块建立间隔时间</strong>，的确和10分钟这个设计值差距很大吧</p><h3 id="区块容量"><a href="#区块容量" class="headerlink" title="区块容量"></a>区块容量</h3><p>比特币区块链从被<strong>第一次部署</strong>时，或者说源代码中已经规定，<strong>区块容量是1M</strong>。最初设计成1M的原因一方面，<strong>防止DOS攻击</strong>。另一方面，当年中本聪在创建区块链的时候的容量是32M，但是他通过一个说明为”Clear up“这样毫不起眼的Commit把区块容量改成了1M，为<strong>防止区块链体积增长过快</strong>，为区块容量这个问题添加了些神秘色彩。好吧，我承认，中本聪就已经非常具有神秘色彩了，是在神秘色彩上添上了些故事</p><p>截止2018年4月1号，完整区块链大小已经有约<strong>151GB</strong>的大小了</p><p>上表中，可以观察到，<strong>1M的容量</strong>意味着比特币最大的处理交易数量在<strong>约2400</strong>（486882区块1034.39的大小很接近了），从代码及技术文档来看，一个区块的最大处理交易数量在2700笔，意味着在一定程度上区块利用率可以超过100%。下面再给出<a href="http://charts.woobull.com/bitcoin-transactions-per-second/" target="_blank" rel="noopener">一张时间和每秒交易数量的关系图表</a>(交互表格点击链接)</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/BitcoinTraPS.png" alt="每秒比特币交易数量" title="">                </div>                <div class="image-caption">每秒比特币交易数量</div>            </figure><blockquote><p>【蓝色圆圈的大小】代表的是比特币内存池（mempool）的大小（交易在等待矿工处理之前都会暂时存在这里）直观来说，就是<strong>圆越大，在等待的交易数量越多</strong><br>【纵坐标】是每秒交易数量（对数变换后）<br>【横坐标】是时间</p></blockquote><p>一句话总结，这是一个拥堵的网络，重负不堪。</p><p>再来看一张<a href="http://charts.woobull.com/bitcoin-blocksize-fees/" target="_blank" rel="noopener">比特币交易费和区块使用率之间的关系图</a>(交互表格可以点击链接)</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/FeesVsBlocksize.png" alt="Bitcoin Fees VS BlockSize" title="">                </div>                <div class="image-caption">Bitcoin Fees VS BlockSize</div>            </figure><blockquote><p>【蓝色的圈大小】是<strong>Mempool的大小</strong>，直观来说，就是<strong>圆越大，在等待的交易数量越多</strong><br>【横坐标】是区块容量的使用情况<br>【纵坐标】是每一个区块的可以得到的交易费用，单位是BTC，注意这里是一个区块被新建时候所有交易费之和（大约2400交易的所有交易费加起来）</p></blockquote><p>手续费随区块使用率开始增长，甚至出现了10BTC一个区块2400笔交易的情况，意味着挖到这个区块的人通过交易费得到的回报接近了本身建立区块的回报。另，之所以可能有人看到最大交易是2700笔，应该和这个区块链大小为最大值的110%有关，从设计角度上来说，是一种<strong>缓冲</strong></p><p>有一个结论是，扩容后，因为每一个区块的交易承载量增加，矿工的交易费收入肯定会减少。因为，通过上表可以发现，只有当区块使用程度接近95%时候，交易费才有明显的增长</p><p>再看一张<a href="http://charts.woobull.com/bitcoin-blocksize-confirm-time/" target="_blank" rel="noopener">用户执行交易需要等待的时长和区块使用比例间关系的图表</a>(交互图表点击链接)</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/TimeVSBlocksize.png" alt="Bitcoin Median Confirmation Time VS Bloacksize" title="">                </div>                <div class="image-caption">Bitcoin Median Confirmation Time VS Bloacksize</div>            </figure><blockquote><p>【蓝色的圈大小】是<strong>Mempool的大小</strong>，直观来说，就是<strong>圆越大，在等待的交易数量越多</strong><br>【横坐标】是区块容量的使用情况<br>【纵坐标】是用户平均需要等待的时间，单位是分钟。</p></blockquote><p>通过上面三张表我们可以知道，矿工的计算力是整个区块链信用的基石（记住贪婪=信任），所以对矿工的激励不能少，而对于用户来说，当然希望自己的交易越快速完成越好。</p><p>对于矿工来说，区块使用率超过95%是一个很好的信号，那意味着可以拿到更多的奖励。奖励太低，在区块建立奖励越来越少的情况下，安全性（信任）就慢慢的得不到保障。这么说来，<strong>这也就变成了一个Trade-off博弈过程</strong></p><p>分析下来，<strong>类似门罗币（menero）实现的根据网络负载来动态调整区块容量的设计似乎很合理</strong></p><h3 id="比特币扩容之争"><a href="#比特币扩容之争" class="headerlink" title="比特币扩容之争"></a>比特币扩容之争</h3><p>这是一场复杂的博弈斗争，使用隔离见证增长区块容量，并出现了<strong>比特币现金</strong>这个新的币种。</p><p>如果想要了解这里面的很多技术，英文是必须过硬的，因为比特币代码开源，可以随意fork，只要英文功底过硬，阅读白皮书，文档等，这些不同技术的处理方法都是能够学到的</p><h2 id="比特币的一笔交易过程中到底发生了什么"><a href="#比特币的一笔交易过程中到底发生了什么" class="headerlink" title="比特币的一笔交易过程中到底发生了什么"></a>比特币的一笔交易过程中到底发生了什么</h2><p>我们可以确认的是，每一笔都将记录在大账本中，那么我们需要研究的内容，就是区块中交易内容内的具体数据结构</p><h3 id="交易结构"><a href="#交易结构" class="headerlink" title="交易结构"></a>交易结构</h3><p>每一个交易块包含的内容如下表所示</p><table><thead><tr><th style="text-align:center">大小</th><th style="text-align:center">字段</th><th style="text-align:center">描述</th></tr></thead><tbody><tr><td style="text-align:center">4 bytes</td><td style="text-align:center">版本</td><td style="text-align:center">明确这笔交易参照的规则</td></tr><tr><td style="text-align:center">1 - 9 bytes</td><td style="text-align:center">输入数量</td><td style="text-align:center">输入值的数量</td></tr><tr><td style="text-align:center">不定</td><td style="text-align:center">输入</td><td style="text-align:center"><strong>一个或多个交易输入</strong></td></tr><tr><td style="text-align:center">1 - 9 bytes</td><td style="text-align:center">输出数量</td><td style="text-align:center">输出值的数量</td></tr><tr><td style="text-align:center">不定</td><td style="text-align:center">输出</td><td style="text-align:center"><strong>一个或多个交易输出</strong></td></tr><tr><td style="text-align:center">4 bytes</td><td style="text-align:center">时钟时间</td><td style="text-align:center">UNIX时间戳或区块号</td></tr></tbody></table><p>最后这个值是解锁时间，定义了能被加到区块链里的最早交易时间。大多是时候设为0，表示<strong>立马执行</strong>。</p><p>一笔比特币交易是一个含有<strong>输入值</strong>和<strong>输出值</strong>的<strong>数据结构</strong>。该数据结构<strong>包含了将一笔资金从初始点（输入值）转移至目标地址（输出值）的代码信息</strong>。比特币交易的输入值和输出值与账号或者身份信息无关。可以把它理解为一种<strong>被特定秘密信息锁定的一定数量的比特币</strong>。只有拥<strong>有者或者知道这个秘密信息的人</strong>可以解锁</p><h3 id="交易的输入和输出"><a href="#交易的输入和输出" class="headerlink" title="交易的输入和输出"></a>交易的输入和输出</h3><p>比特币交易的基本单位是<strong>未经使用的一个交易输出</strong>，简称UTXO（unspent transaction outputs）</p><p>可以把UTXO类比为我们使用的<strong>人民币1，5，10，20，50，100的面值</strong>，对于UTXO来说，它的面值可以是一”聪“的任意倍数（1BTC等于一亿聪）<strong>但是</strong>这个有着任意面值的”人民币“不能随意打开，还被加上一道类似<strong>红包支付口令的密码</strong>，只有拥有这个密码的人才可以使用这个UTXO，UTXO包含，币值+一段代码（锁，只有有钥匙的人才能打开）</p><p>被交易消耗的UTXO被称为交易输入，由交易创建的UTXO被称为交易输出</p><h4 id="交易输出"><a href="#交易输出" class="headerlink" title="交易输出"></a>交易输出</h4><p><strong>不同面值的UTXO是由交易输出来提供的</strong>。你可以想象你需要购买一个3.1BTC的物品，你并不能从你的钱包中找到几个UTXO来得到3.1BTC，但是你刚好拥有一个4BTC的UTXO，你使用这个UTXO作为付款，那么你需要自己<strong>手动构建一个0.9的UTXO返还给你自己</strong>。</p><p>一个交易输出包含两个部分</p><ul><li>一定量的比特币。被命名为“聪”（satoshis）</li><li>一个<strong>锁定脚本</strong>。给这个UTXO上锁，保证只有<strong>收款人地址</strong>的私钥才可以打开</li></ul><h4 id="交易输入"><a href="#交易输入" class="headerlink" title="交易输入"></a>交易输入</h4><p>每个交易输入是在构造的一笔交易（使用UTXO），比如你需要支付0.015BTC，钱包会寻找一个0.01BTC和0.005BTC的UTXO来组成这一笔交易。交易输入中还会<strong>包含一个解锁脚本</strong>，这是一个签名，可以类比成支付宝红包密码的口令</p><h4 id="交易费"><a href="#交易费" class="headerlink" title="交易费"></a>交易费</h4><p>交易费 = 求和（所有输入） - 求和（所有输出）</p><p>这里有一个比较有意思的地方，就是因为找零的输出UTXO是交易的发起这自己构建的，如果很不幸，你忘记了自己构建找零的UTXO，那么这些多余的BTC就会变成矿工的劳务费</p><p>例如，我需要和小明进行交易，需要购买一个商品，花费<code>0.8BTC</code>，为了确保这笔交易能被更快的处理（添加到大账本上），我要在其中添加一笔交易费，假设<code>0.01BTC</code>（忽略人傻钱多），那就意味着这笔交易会需要我从钱包中找到几个UTXO能组成<code>0.81BTC</code>。但如果我的钱包内找不出这样的UTXO，只有一个<code>1BTC</code>的UTXO可用，那么我就需要构建一个<code>0.19BTC</code>的UTXO作为找零回到自己的钱包</p><p><strong>交易费只和交易字段使用的字节大小有关，与参与交易的比特币币值无关</strong>。UTXO是有尺寸的，比如某人想支付一笔很大的BTC交易，但是他的钱包中有很多小尺寸的UTXO，如果加入了很多个UTXO，就意味着他的交易会变复杂，存储空间需求多。当然，很多钱包会提供这方面的优化功能，保证你的交易使用的字段大小最优化</p><h4 id="解锁和锁定脚本"><a href="#解锁和锁定脚本" class="headerlink" title="解锁和锁定脚本"></a>解锁和锁定脚本</h4><p>在实际实现的时候，这个“支付宝红包口令”被称为脚本，是一种基于逆波兰表示法的基于堆栈的执行语言。具体细节感兴趣的读者可以去<a href="https://github.com/bitcoin/bitcoin" target="_blank" rel="noopener">比特币的Github</a>研究代码。关于脚本有很多细节上的定义和实现方法，这里限于篇幅不展开描述了</p><h3 id="矿工费和优先级"><a href="#矿工费和优先级" class="headerlink" title="矿工费和优先级"></a>矿工费和优先级</h3><p>我们知道，<strong>每一笔交易都是广播到区块链上，由矿工决定是不是加入到新区块上的</strong>。那么这里就会涉及到一个问题，谁的交易的优先级更高，是先来后到？还是谁给前多谁就能加入到新区块中？</p><p>在<a href="#区块容量">区块容量</a>一节中，有一张图表直观的展示了现在网络中一笔交易的等待时间，其中最长的，也就是30分钟，如果你不是一个超级急性子，很多时候还是可以接受的（毕竟跨国转账1-2个工作日）</p><p>优先级 = 输入值块龄 * 输出值块龄 / 交易总长度</p><p>一个交易想成为<strong>“较高优先级”</strong>，需满足条件：<strong>优先值大于57600000</strong>，等价于1个BTC，年龄为1天，交易的大小为250字节</p><p>区块中前50KB的字节是保留给“较高优先级”的，其实这一机制也保证了一笔交易不会等待时间无现长。但是我们要知道，内存池（存放待处理交易的位置）中的交易，如果在没有处理后消失，所以钱包必须拥有不断重新广播未被处理交易的功能</p><h3 id="创币交易-Coinbase"><a href="#创币交易-Coinbase" class="headerlink" title="创币交易 - Coinbase"></a>创币交易 - Coinbase</h3><p>每一个<strong>新建立的区块</strong>，都会有新的比特币作为奖励被产生，这个交易是一个特殊交易，被称为<strong>创币交易（Coinbase奖励）</strong></p><p>创币交易中不存在解锁脚本（也叫ScriptSig字段），被Coinbase的数据取代，长度最小2字节，最大100字节，除了开始的几个自己以外，矿工可以任意使用Coinbase的其他部分。比如创世区块中，Coinbase的输入中的字段是：The Times 03/Jan/2009 Chancellor on brink of second bailout for banks，是泰晤士日报当天的头版文章标题：财政大臣将再次对银行施以援手。</p><h2 id="Merkle树"><a href="#Merkle树" class="headerlink" title="Merkle树"></a>Merkle树</h2><p><strong>每个区块中的所有交易，都是用Merkle树来表示的</strong>。换句话说，交易的存储数据结构是，Merkle树</p><h3 id="什么是Merkle树"><a href="#什么是Merkle树" class="headerlink" title="什么是Merkle树"></a>什么是Merkle树</h3><p>Merkle树是一种<strong>哈希二叉树</strong>，它可以用来进行<strong>快速查找和检验大规模数据完整性</strong>。对于比特币网络来说，使用Merkle树来存储交易信息的目的是为了<strong>高效的查找和校验某笔交易的信息是否存在</strong></p><p>当N个数据元素经过加密（使用两次SHA256算法，也称double-SHA256），<strong>至多</strong>计算 $2log_2(N)$ 次就能<strong>检查出任意某元素是否在树中</strong></p><h3 id="构造Merkle树"><a href="#构造Merkle树" class="headerlink" title="构造Merkle树"></a>构造Merkle树</h3><p>假设我们有A B C D四笔交易字段，首先需要把这四个数据Hash化。然后把这些哈细化的<strong>数据通过串联相邻叶子节点</strong>的哈希值然后哈希化。基本过程如下图所示</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/24/一文弄懂区块链-以比特币为例/MerkleTree.png" alt="Merkle树的构造过程" title="">                </div>                <div class="image-caption">Merkle树的构造过程</div>            </figure><p>叶子节点必须是偶数（平衡树），如果遇到奇数的情况，把最后一个节点自身复制一个，凑偶</p><h3 id="Merkle树的效率"><a href="#Merkle树的效率" class="headerlink" title="Merkle树的效率"></a>Merkle树的效率</h3><p>下表显示了<strong>证明区块中存在某笔交易</strong>所需转化为Merkle路径的数据量</p><table><thead><tr><th style="text-align:center">交易数量</th><th style="text-align:center">区块的近似大小</th><th style="text-align:center">路径大小（哈希数量）</th><th style="text-align:center">路径大小（字节）</th></tr></thead><tbody><tr><td style="text-align:center">16</td><td style="text-align:center">4KB</td><td style="text-align:center">4个哈希</td><td style="text-align:center">128 bytes</td></tr><tr><td style="text-align:center">512</td><td style="text-align:center">128KB</td><td style="text-align:center">9个哈希</td><td style="text-align:center">288 bytes</td></tr><tr><td style="text-align:center">2048</td><td style="text-align:center">512KB</td><td style="text-align:center">11个哈希</td><td style="text-align:center">352 bytes</td></tr><tr><td style="text-align:center">65535</td><td style="text-align:center">16MB</td><td style="text-align:center">16个哈希</td><td style="text-align:center">512 bytes</td></tr></tbody></table><p>可以发现，即使区块容量达到16MB规模，为证明交易存在的Merkle路径长度增长也极其缓慢（幂指数增长取对数变为线性增长）</p><h3 id="Merkle应用-简单支付验证节点（SPV）"><a href="#Merkle应用-简单支付验证节点（SPV）" class="headerlink" title="Merkle应用 - 简单支付验证节点（SPV）"></a>Merkle应用 - 简单支付验证节点（SPV）</h3><p>我们知道，每当一笔新的交易产生的时候，我们必须<strong>验证这笔交易是否真的存在</strong>，在SPV节点中，不保存区块链，仅仅保存区块头。<strong>使用认证路径或者Merkle路径来验证交易是否存在于区块中</strong></p><p>例如，一个SPV节点需要处理一笔支付，它<strong>需要验证这笔交易在某个区块中是否存在</strong>，才能决定是不是把这笔交易添加到这个区块中，那么它只需要接收少于1KB大小的，<strong>有关区块头和Merkle路径的信息</strong>，比接收完整区块（大约1MB）大小少了1千倍。简单来说，可以想象，Merkle树类似<strong>一个数组</strong>（这也是哈希表的最简单表示），<strong>下标是区块字段</strong>，下标对应<strong>数组存储的内容是这笔交易是否存在的值（True or False）</strong></p><h1 id="区块链（比特币）与金融"><a href="#区块链（比特币）与金融" class="headerlink" title="区块链（比特币）与金融"></a>区块链（比特币）与金融</h1><p><a href="https://bitinfocharts.com/" target="_blank" rel="noopener">BitInfoChart</a>是我个人觉得最好的加密货币信息网站！可以添加到收藏夹</p><p>因为比特币具有价值，那就必须谈到它和金融的关系。</p><p>限于篇幅（太长了太可怕了，一个博客写2万字莫不是有病），这部分另起一篇：<a href="https://charlesliuyx.github.io/2017/09/25/%E5%8C%BA%E5%9D%97%E9%93%BE%EF%BC%88%E6%AF%94%E7%89%B9%E5%B8%81%EF%BC%89%E4%B8%8E%E9%87%91%E8%9E%8D/">链接（直接点不会打开新标签）</a>，如果对<strong>ICO和金融方面</strong>感兴趣的读者欢迎移步讨论</p><h1 id="竞争币和其他技术创新"><a href="#竞争币和其他技术创新" class="headerlink" title="竞争币和其他技术创新"></a>竞争币和其他技术创新</h1><p>所谓竞争币当然是利用区块链技术为即使，仿照比特币的基本协议架构进行的创新后的新币种，或者是新的区块链实现模式。这篇文章围绕什么是区块链展开，这部分的内容请移步<strong>（持续更新）</strong><a href="https://charlesliuyx.github.io/2017/09/25/%E7%8E%B0%E4%BB%A3%E5%8C%BA%E5%9D%97%E9%93%BE%E4%B8%8E%E6%96%B0%E6%8A%80%E6%9C%AF/">如何评估竞争币的价值与新技术创新（直接点不会打开新标签）</a></p><p>其中谈到了工作量证明的其他替代手段；到底什么是智能合约；以太坊开发技术栈等</p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>感谢您看到这里，写这篇文章的目的一方面也是回答<strong>区块链（比特币）到底是什么</strong>这个困扰了自己很久的问题，另一方面，也是因为最近区块链技术非常火，需要<strong>一些接地气的科普文</strong></p><p>比如最近最新的消息称一家保险公司，使用区块链技术来赔偿航班晚点2小时，基于以太坊智能合约第一款落地应用。</p><p>如果你已经对区块链的实现原理有了初步的认知，就明白这些应用利用了区块链的分布式特点。说到底，并没有<strong>贪婪=信任工作量证明核心</strong>，只是一种基于云的新型运用，也很有想法，但是<strong>和比特币之类就没什么关系了</strong>（当然，这是我的个人看法，最近区块链方面的有很多突破性技术，比如侧链，闪电网络等等，太多的新概念，新名词，新技术，对此，也只能不断学习）。</p><p>但你只需牢记，贪婪=信任，以太坊也是利用以太币这个媒介来实现了合约价值，中本聪用人内核的贪婪来给陌生人之间加上了信任的纽带，这个代价是永远不会变的。换句话说，如何抵抗共识攻击和安全漏洞是一个永远不会消失的议题。</p><p>一句话来说，万变不离其宗，道生一，一生二，二生三，三生万物。中本聪给了道，是个妙人，但是<strong>万物</strong>依旧有无穷可能。<strong>信任作为一个人类社会一直以来的重要问题（痛点）</strong>，为了解决它，出现了<strong>权威机构进行信任背书（中心化）</strong>。建立信任，一定要付出代价，天底下没有免费的午餐，最终这些技术都会回归于一个投入产出的博弈过程（Trade-off），梳理主干，抓住要点，才能游刃有余！</p><p>那么如何才能梳理主干，抓住要点，提升学习能力呢？见谅加一个软广告</p><p><strong>幕布是一款笔记本软件，博主参与了部分研发工作</strong>，如果你喜爱<strong>沉浸式层次化输入</strong>，并<strong>喜欢思维导图</strong>，还喜爱<strong>记录总结整理各种书籍或文章</strong>，幕布完美切合这三类人群的需求：一键生成思维导图，极简输入界面，快捷键操作，全平台支持！Organize your brain by mubu</p><p><a href="https://mubu.com/inv/121749" target="_blank" rel="noopener">点我</a>一键微信注册，一个月9块钱，良心商家，<a href="https://www.zhihu.com/question/20772002/answer/192382928" target="_blank" rel="noopener">这是一篇</a>自己写的有关幕布的介绍文章</p><p><a href="https://www.zhihu.com/question/37290469/answer/236442981" target="_blank" rel="noopener">如果感觉看完有帮助求知乎点个赞，感谢！</a></p><p>以上！鞠躬！</p><p>除了<a href="https://www.zhihu.com/question/22076666" target="_blank" rel="noopener">江卓尔 知乎回答</a>等优秀的知乎答主的回答，附参考文献出处：<br>【1】文章中引用多个Gif的出处：<a href="https://www.bilibili.com/video/av12465079/" target="_blank" rel="noopener">比特币原理-3B1B</a>，这也是让我真正弄懂比特币的一个视频，不得不说，外国人在让门外汉入行这件事上，领先了很多<br>【2】一本入门教材。包含代码和实现，以及很多数据结构，具体实现方式的细节，如果想成为加密货币（区块链）开发者，这本书5星推荐：<a href="http://8btc.com/topic-mastering-bitcoin.html" target="_blank" rel="noopener">精通比特币</a><br>【3】宋老师的<a href="http://v.youku.com/v_show/id_XMjc3MDU4MDY2OA==.html?spm=a2h1n.8261147.reload_201705.1~3!2~5~A" target="_blank" rel="noopener">鸿观125期</a> （需要优酷会员）<br>【4】只能膜拜之的创世区块作者的论文：<a href="http://www.8btc.com/wiki/bitcoin-a-peer-to-peer-electronic-cash-system" target="_blank" rel="noopener">比特币白皮书</a><br>【5】<a href="http://www.sohu.com/a/162825922_735021" target="_blank" rel="noopener">ICO科普文章</a>中的例子引用</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】29 ~ 35 min | 11872 words&lt;br&gt;【内容简介】此文潜在面向群体是对区块链或比特币的运行原理完全不了解的人。所以会从&lt;strong&gt;用户需求&lt;/strong&gt;的角度出发，&lt;strong&gt;一步一步发明区块链（或者说比特币，因为两者互相依存）&lt;/strong&gt;，在此之后的内容有关比特币与金融，ICO，竞争币等，可选择性阅读。&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/categories/BlockChain/"/>
    
    
      <category term="BlockChain" scheme="https://charlesliuyx.github.io/tags/BlockChain/"/>
    
      <category term="BTCoin" scheme="https://charlesliuyx.github.io/tags/BTCoin/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】拉格朗日乘法和KKT条件</title>
    <link href="https://charlesliuyx.github.io/2017/09/20/%E6%8B%89%E6%A0%BC%E6%9C%97%E6%97%A5%E4%B9%98%E6%B3%95%E5%92%8CKKT%E6%9D%A1%E4%BB%B6/"/>
    <id>https://charlesliuyx.github.io/2017/09/20/拉格朗日乘法和KKT条件/</id>
    <published>2017-09-20T02:49:49.000Z</published>
    <updated>2017-09-21T05:58:53.000Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】8min - 10mun<br>【内容简介】直观的解读了什么是拉格朗日乘子法，以及如何求解拉格朗日方程，并且给出几个直观的例子，针对不等式约束解读了KKT条件的必要条件和充分条件<br><a id="more"></a></p><h1 id="What-amp-Why"><a href="#What-amp-Why" class="headerlink" title="What &amp; Why"></a>What &amp; Why</h1><p>拉格朗日乘法（Lagrange multiplier）是一种在<strong>最优化的问题中</strong>寻找多元函数在其变量<strong>受到一个或多个条件的相等约束</strong>时的<strong>求局部极值的方法</strong>。这种方法可以将一个有 n 个变量和 k 个约束条件的最优化问题转换为一个<strong>解有 n+k 个变量的方程组的解的问题</strong></p><p>考虑一个最优化问题</p>$$\operatorname*{max}_{x,y} f(x,y) \qquad s.t.\;\; g(x,y)=c$$<p>为了求 $x$ 和 $y$ ，引入一个新的变量 $\lambda$ 称为<strong>拉格朗日乘数</strong>，再引入朗格朗日函数的极值<br>$$<br>\mathcal{L}(x,y,\lambda)=f(x,y)-\lambda \cdot \bigl( g(x,y) - c\bigl) \tag 1<br>$$<br><img src="//charlesliuyx.github.io/2017/09/20/拉格朗日乘法和KKT条件/LagrangeMultiplier.png" width="500px"></p><blockquote><p>红线表示 $g(x,y) = c$ ，蓝线是 $f(x,y)$ 的<strong>等高线</strong>，所有箭头表示梯度下降最快的方向。图中<strong>红线与等高线相切</strong>的位置就是待求的极大值</p></blockquote><h1 id="How"><a href="#How" class="headerlink" title="How"></a>How</h1><p>那么如何求这个极值点呢？</p><h2 id="单约束"><a href="#单约束" class="headerlink" title="单约束"></a>单约束</h2><p>对(1)式直接求微分，并令其为零，计算出<strong>鞍点</strong></p>$$\nabla_{x,y,\lambda} \mathcal{L}(x,y,\lambda) = 0$$有三个未知数，所以需要3个方程。求 $\lambda$ 的偏微分有 $\nabla_{\lambda} \mathcal{L}(x,y,\lambda) = 0 \implies g(x,y)=0$，则总结得$$\nabla_{x,y,\lambda} \mathcal{L}(x,y,\lambda) = 0 \iff \begin{cases}\nabla_{x,y} f(x,y) = \lambda \nabla_{x,y} g(x,y) \\g(x,y)=0\end{cases}$$<h3 id="例子1"><a href="#例子1" class="headerlink" title="例子1"></a>例子1</h3><p>设一个具体的例子，我们需要求下列问题<br>$$\operatorname*{max}_{x,y} f(x,y) = x^2y \qquad s.t.\;\; g(x,y): x^2+y^2-3=0$$<br><img src="//charlesliuyx.github.io/2017/09/20/拉格朗日乘法和KKT条件/Lagrange_simple_1.png" width="500px"><br>只有<strong>一个约束</strong>，使用<strong>一个乘子</strong>，设为 $\lambda$，列出<strong>拉格朗日函数</strong><br>$$\mathcal{L}(x,y,\lambda)=f(x,y)-\lambda \cdot \bigl( g(x,y) - c\bigl) = x^2y + \lambda(x^2+y^2-3)$$<br>接下来求解上式，分别对<strong>三个待求量偏微分</strong><br>$$\begin{align}\nabla_{x,y,\lambda} \mathcal{L}(x,y,\lambda) & = \left( \frac{\partial \mathcal{L}}{\partial x},\frac{\partial \mathcal{L}}{\partial y},\frac{\partial \mathcal{L}}{\partial \lambda}\right)\\& = (2xy + 2\lambda x, x^2 + 2\lambda y, x^2 + y^2 - 3)\end{align}$$<br>令<strong>偏微分分别等于0</strong>，得到<br>$$\nabla_{x,y,\lambda} \mathcal{L}(x,y,\lambda) = 0 \iff \begin{cases}2xy+2\lambda x = 0 \\x^2 + 2\lambda y = 0 \\x^2 + y^2 - 3 = 0\end{cases}\iff\begin{cases}x(y + \lambda) = 0  & (i)\\x^2 = -2\lambda y  & (ii)\\x^2 +y^2 = 3 & (iii)\end{cases}$$<br>根据上式，我们可以解得 $\mathcal{L}$:<br>$$(\pm \sqrt{2},1,-1 ); (\pm \sqrt{2},-1,1 );(0,\pm \sqrt{3},0)$$<br>根据几个不同的解带入 $f(x,y)$ 得到，2，-2，0，也就是我们需要的最大值，最小值，对应的直观图像解释如下图所示（<strong>非常直观的展现约束和等高线的含义</strong>）</p><h3 id="例子2"><a href="#例子2" class="headerlink" title="例子2"></a>例子2</h3><p>关于拉格朗日乘子法的应用，有一个十分著名的：求<strong>离散概率分布  $p_1,p_2,\cdots,p_n$  的最大<a href="https://charlesliuyx.github.io/2017/09/11/%E4%BB%80%E4%B9%88%E6%98%AF%E4%BF%A1%E6%81%AF%E7%86%B5%E3%80%81%E4%BA%A4%E5%8F%89%E7%86%B5%E5%92%8C%E7%9B%B8%E5%AF%B9%E7%86%B5/">信息熵</a></strong><br>$$f(p1,p2,\cdots,p_n) = - \sum_{j=1}^n p_j log_2{p_j} \\s.t. \quad g(p1,p2,\cdots,p_n) = \sum_{k=1}^n p_k = 1 \text{（概率和为1）}$$</p><p>单约束问题，引入一个乘子 $\lambda$ ，对于 $k \in [1,n]$ ，要求<br>$$\frac{\partial}{\partial p_k} (f + \lambda(g - 1)) = 0$$将 $f$ 和 $g$ 带入有$$\frac{\partial}{\partial p_k} \left(  -\sum_{k=1}^np_klog_2{p_k} + \lambda (\sum_{k=1}^n p_k - 1)\right) = 0$$计算这 n 个等式的偏微分，我们可以得到：$$-\left( \frac{1}{\ln(2)} + log_2p_k \right) + \lambda = 0$$</p><p>这说明所有的 $p_i$ 都相等，所以得到 $p_k = \frac{1}{n}$ </p><p>我们可以得到一个结论是：<strong>均匀分布的信息熵是最大的</strong></p><h2 id="多约束"><a href="#多约束" class="headerlink" title="多约束"></a>多约束</h2><p>既然可以解决单约束，继续思考一下多约束情况的直观表现，假设我们的约束是两条线，如下图所示</p><p><img src="//charlesliuyx.github.io/2017/09/20/拉格朗日乘法和KKT条件/lgm_parab.png" width="450px"></p><p>和单约束的解决方法类似，我们画出等高线图，目的就是<strong>在约束线上找到一个点可以和等高线相切，所得的值实在约束范围内的最大值或者最小值</strong>，直观表示如下图</p><p><img src="//charlesliuyx.github.io/2017/09/20/拉格朗日乘法和KKT条件/lgm_levelsets.png" width="450px"></p><p>解算方法是讲单约束的扩展到多约束的情况，较为类似，可举一反三</p><h1 id="KKT条件"><a href="#KKT条件" class="headerlink" title="KKT条件"></a>KKT条件</h1><p>已经解决的在<strong>等式约束条件下</strong>的求函数极值的问题，那<strong>不等式约束条件</strong>下，应该如何解决呢？</p><p>这就需要引出<strong>KKT条件</strong>（Karush-Kuhn-Tucker Conditions），它是在满足一些有规则的条件下，一个<strong>非线性规划问题能有最优化解法</strong>的一个必<strong>要和充分条件</strong></p><p>考虑以下非线性最优化问题，含有 $m$ 个不等式约束，$l$ 个等式约束<br>$$<br>\operatorname*{min}_{x}f(x) \qquad s.t. \; g_i(x) \leqslant 0,\; h_j(x) =0<br>$$</p><h2 id="必要条件"><a href="#必要条件" class="headerlink" title="必要条件"></a>必要条件</h2><p>假设 $f,g_i,h_j$ 三个函数为<strong>实数集映射</strong>，再者，他们都在 $x^<em>$ 这点<strong>连续可微</strong>，如果 $x^</em>$  是一个<strong>局部极值</strong>，那么<strong>将会存在</strong>一组<strong>称为乘子</strong>的常数 $\lambda \geqslant 0,\mu_i \geqslant0, \nu_j$  令<br>$$\lambda + \sum_{i=1}^m \mu_i + \sum_{j=1}^l |\nu_i| \gt 0, \\\lambda \nabla f(x^*) + \sum_{i=1}^m \mu_i  \nabla g_i(x^*) + \sum_{j=1}^l \nu_i  \nabla h_j(x^*) = 0, \\\mu_i  g_i(x^*) =0 \; \text{for all} \; i=1,\ldots,m$$</p><p>这里有一些<strong>正则性条件或约束规范</strong>能保证解法不是退化的（比如$\lambda$为0），<a href="https://zh.wikipedia.org/wiki/%E5%8D%A1%E7%BE%85%E9%9C%80%EF%BC%8D%E5%BA%AB%E6%81%A9%EF%BC%8D%E5%A1%94%E5%85%8B%E6%A2%9D%E4%BB%B6" target="_blank" rel="noopener">详见</a></p><h2 id="充分条件"><a href="#充分条件" class="headerlink" title="充分条件"></a>充分条件</h2><p>假设 $f,g_i$ 为<strong>凸函数</strong>，$h_j$ 函数是<strong>仿射函数</strong>（平移变换），假设有一个可行点 $x^*$，如果有常数 $\mu_i \geqslant 0$ 及 $\nu_j$ 满足<br>$$\nabla f(x^*) + \sum_{i=1}^m \mu_i  \nabla g_i(x^*) + \sum_{j=1}^l \nu_i  \nabla h_j(x^*) = 0 \\\mu_i  g_i(x^*) =0 \; \text{for all} \; i=1,\ldots,m$$</p><p>那么 $x^*$ 就是<strong>全局极小值</strong></p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>总的来说，拉格朗日乘子法是<strong>一个工具（手段或方法）</strong>，来<strong>解决在有约束情况的求函数极值的问题</strong></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】8min - 10mun&lt;br&gt;【内容简介】直观的解读了什么是拉格朗日乘子法，以及如何求解拉格朗日方程，并且给出几个直观的例子，针对不等式约束解读了KKT条件的必要条件和充分条件&lt;br&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】支持向量机SVM</title>
    <link href="https://charlesliuyx.github.io/2017/09/19/%E6%94%AF%E6%8C%81%E5%90%91%E9%87%8F%E6%9C%BASVM%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    <id>https://charlesliuyx.github.io/2017/09/19/支持向量机SVM学习笔记/</id>
    <published>2017-09-19T10:23:39.000Z</published>
    <updated>2017-09-21T23:32:45.000Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】13min - 19min<br>【内容简介】详解解读什么是支持向量机，如何解支持向量以及涉及的拉普拉斯乘子法，还有核方法的解读</p><a id="more"></a><h1 id="什么是支持向量机-SVM"><a href="#什么是支持向量机-SVM" class="headerlink" title="什么是支持向量机-SVM"></a>什么是支持向量机-SVM</h1><p>支持向量机-SVM(Support Vector Machine)从本质来说是一种：<strong>用一条线（方程）分类两种事物</strong></p><p>SVM的任务是找到这条分界线<strong>使得它到两边的<code>margin</code>都最大</strong>，<font color="FF00000">注意，这里的横坐标是 $x_1$ 纵坐标为 $x_2$</font>，如下图所示</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/19/支持向量机SVM学习笔记/SVM-margin.jpg" alt="margin" title="">                </div>                <div class="image-caption">margin</div>            </figure><p>有了直观的感知，在定义这一节在做一些深入的思考，分解名词（Support Vector Machine）并尝试解释：</p><ul><li><strong>Machine</strong> - Classification Machine 说明它的本质是一个<strong>分类器</strong></li><li><strong>Support Vector</strong> - 如上图所示，在<code>Maximum Margin</code>上的<strong>这些点</strong>就是<strong>支持向量</strong>，具体说即最终分类器表达式中<strong>只含有这些支持向量</strong>的信息，而与其他数据点无关。在下面的公式中，只有<strong>支持向量的系数</strong> $\alpha_i$ 不等于0。说人话，<strong>上图中两个红色的点，一个蓝色的点，合起来就是支持向量</strong>$$\mathbf w \cdot \varphi (\mathbf x) = \sum_i \lambda_i y_i k(\mathbf x_i,\mathbf x)$$</li></ul><blockquote><p>公式中每一个符号的含义在后文有说明</p></blockquote><h1 id="如何求解支持向量机"><a href="#如何求解支持向量机" class="headerlink" title="如何求解支持向量机"></a>如何求解支持向量机</h1><p>对于我们需要求解的这个超平面（直线）来说，我们知道</p><ul><li>它离<strong>两边一样远</strong>（待分类的两个部分的样本点）</li><li><strong>最近的距离</strong>就是到<strong>支持向量中的点</strong>的距离</li></ul><p>根据这两点，抽象SVM的直接表达（Directly Representation）</p><blockquote><p>注：$arg \operatorname*{max}_{x} f(x)$ 表示当 $f(x)$ <strong>取最大值时，x的取值</strong></p></blockquote>$$arg \operatorname*{max}_{boundary} margin(boundary) \\ \text{所有正确归类的两类到boundary的距离} \ge margin \tag{1}$$<p>其实这个公式是一点也不抽象，需要更进一步的用符号来表达。</p><p>我们知道<strong>在准确描述世界运行的规律这件事上，数学比文字要准确并且无歧义的多，文字（例子）直观啰嗦，数学（公式）准确简介</strong></p><h2 id="硬间隔"><a href="#硬间隔" class="headerlink" title="硬间隔"></a>硬间隔</h2><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/19/支持向量机SVM学习笔记/SVM-Intuitive.jpg" alt="SVM支持向量机" title="">                </div>                <div class="image-caption">SVM支持向量机</div>            </figure><blockquote><p>注：公式中加粗或者带有向量箭头的都<strong>表达一个向量</strong></p></blockquote><ul><li>假设这些数据<strong>线性可分</strong>，也可称为<strong>硬间隔</strong>（Hard Margin）</li><li>首先定义超平面：$\mathbf w^T \vec x_i + b = 0$，接下来为了方便，设  $\vec x = (x_1,x_2)$  即一条直线</li><li>任意点 $\vec x_i$ 到该直线的距离为 $\frac{1}{\lVert \mathbf w \lVert} (\mathbf w^T \vec x_i + b)$</li><li>对于空间内所有训练点的坐<strong>标记为</strong> $(\vec x_i,y_i)$，其中 $y_i$ = 1 or -1， 表示点 $\vec x_i$ <strong>所属的类</strong></li><li>如果这些训练数据是线性可分的，选出两条直线（上图中的虚线），使得他们的距离尽可能的大，这两条直线的中央就是<strong>待求的超平面</strong>（直线）</li><li><p>为了表达直观，我们定义这两个超平面（直线）分别为 $\mathbf w^T \vec x_i + b = 1$ 和 $\mathbf w^T \vec x_i + b = -1$，两个超平面（直线）之间的距离为 $\gamma = \frac{2}{\lVert \mathbf w \lVert}$</p><blockquote><p>注：选择<code>1</code>的好处是，<code>w</code> 和<code>b</code>进行尺缩变换（<code>kw</code>和<code>kb</code>）不改变距离，方便计算</p></blockquote></li><li><p>为了使得所有<strong>样本数据都在间隔区（两条虚线）以外</strong>，我们需要保证对于所有的 $i$ 满足下列的条件</p><ul><li>$\mathbf w^T \vec x_i + b \geqslant 1$ 若 $y_i = 1$</li><li>$\mathbf w^T \vec x_i + b \leqslant -1$ 若 $y_i = -1$</li></ul></li><li>上述两个条件可以写作  $y_i(\mathbf w^T \vec x_i + b) \geqslant 1, \;\text{for all 1}\; 1\leqslant i \leqslant n$  这里的<code>n</code>指样本点的数量</li><li><p>上面的表达（Directly Representation）可以被写成</p>$$arg \operatorname*{max}_{\mathbf w,b} \left\{ {\frac{1}{\lVert \mathbf w \lVert} \operatorname*{min}_{n} [y_i(\mathbf w^T\vec x_i}+b)]\right\} \tag{2}$$</li><li><p>最终目的是<strong>找到具有“最大间隔”（Maximum Margin）的划分超平面（直线），找到参数 $\mathbf w$ 和 $b$ 使得 $\gamma$ 最大</strong></p></li><li>则可以对(2)式进行形式变换，得到 canonical representation$$arg \operatorname*{max}_{\mathbf w,b} \frac{2}{\lVert \mathbf w \lVert} \implies  arg \operatorname*{min}_{\mathbf w,b} \frac{1}{2}\lVert \mathbf w \lVert ^2 \\ s.t.\; y_i(\mathbf w^T\vec x_i+b) \geqslant1,\;i = 1,2,\ldots,m  \tag{3}$$</li></ul><blockquote><p>注：<code>s.t.</code> ：subject to 表示约束条件，表达的意思等价于：为了使得所有<strong>样本数据都在间隔区（两条虚线）以外</strong></p></blockquote><p>为了解(3)式，需要用到<strong>拉格朗日乘子法</strong>（Method of lagrange multiplier），它是用来求解在约束条件目标函数的极值的，<a href="https://charlesliuyx.github.io/2017/09/20/%E6%8B%89%E6%A0%BC%E6%9C%97%E6%97%A5%E4%B9%98%E6%B3%95%E5%92%8CKKT%E6%9D%A1%E4%BB%B6/">详细直观详解</a></p><blockquote><p>注：以下解算过程希望完全看懂强烈建议理解阅读<a href="https://charlesliuyx.github.io/2017/09/20/%E6%8B%89%E6%A0%BC%E6%9C%97%E6%97%A5%E4%B9%98%E6%B3%95%E5%92%8CKKT%E6%9D%A1%E4%BB%B6/">详细直观详解</a>，很多地方推导过程只写必要过程及结论</p></blockquote><p>根据约束的形式，我们引入<code>m</code>个拉格朗日乗法子，记为  $\boldsymbol \lambda = (\lambda_1,\ldots,\lambda_m)^T$ ，原因是，有<code>m</code>个约束，所以需要<code>m</code>个拉格朗日乗法子。可以得出拉格朗日方程如下：<br>$$\mathcal{L}(\mathbf w,b,\boldsymbol \lambda) = \frac{1}{2}\lVert \mathbf w \lVert ^2  - \sum_{i=1}^m \lambda_i \{  y_i(\mathbf w^T\vec x_i+b) -1 \} \tag{4}$$</p><p>解这个拉格朗日方程，对 $\mathbf w$ 和 $b$ 求偏导数，可以得到以下两个条件<br>$$\mathbf w = \sum_{i=1}^m \lambda_i y_i \vec x_i \\0 = \sum_{i=1}^m \lambda_i y_i$$</p><p>将这两个条件带回公式(4)，可以得到<strong>对偶形式（dual representaiton）</strong>，我们的目的也变为最大化 $\mathcal{L}(\boldsymbol \lambda)$，表达式如下<br>$$arg \operatorname*{max}_{\boldsymbol \lambda}\mathcal{L}(\boldsymbol \lambda)  = \sum_{i=1}^m \lambda_i - \frac{1}{2} \sum_{i=1}^m \sum_{j=1}^m \lambda_i \lambda_j \vec x_i \vec x_j \mathbf x_i^T \mathbf x_j \\s.t. \qquad \lambda_i \geqslant 0, \forall i\;;\quad \sum_{i=1}^m \lambda_i y_i = 0 \tag{5}$$</p><p>以上表达式可以通过<strong>二次规划</strong>算法解出 $\boldsymbol \lambda$ 后，带回，求出$\mathbf w$ 和 $b$，即可得到模型<br>$$f(\mathbf x) = \mathbf w^T\mathbf x + b = \sum_{i=1}^m \lambda_i y_i \mathbf x_i^T \mathbf x + b \tag{6}$$</p><p>补充一些关于<strong>二次规划</strong>算法的相关，(3)式的约束是一个不等式约束，所以我们可以使用KKT条件得到三个条件：<br>$$\lambda_i \geqslant0 ;\quad y_i f(\mathbf x_i)-1 \geqslant0; \quad \lambda_i\{ y_i f(\mathbf x_i)-1 \}=0$$</p><p>使用这些条件，可以构建高效算法来解这个方程，比如<strong>SMO（Sequential Minimal Optimization）</strong>就是其中一个比较著名的。至于SMO是如何做的，考虑到现代很多SVM的Pakage都是直接拿来用，秉承着<strong>前人付出了努力造了轮子就不重复造的核心精神</strong>，直接调用就好</p><h2 id="软间隔"><a href="#软间隔" class="headerlink" title="软间隔"></a>软间隔</h2><p>已经说明了如何求得方程，以上的推导形式都是建立在<strong>样本数据线性可分</strong>的基础上，如果样本数据<strong>你中有我我中有你</strong>（线性不可分），应该如何处理呢？这里就需要引入<strong>软间隔（Soft Margin）</strong>，意味着，<strong>允许支持向量机在一定程度上出错</strong></p><div align="center"><img src="//charlesliuyx.github.io/2017/09/19/支持向量机SVM学习笔记/SoftMargin.png" width="450px" alt="SoftMargin"></div><p>由上一节我们得知，约束为： $y_i(\mathbf w^T\vec x_i+b) \geqslant1,\;i = 1,2,\ldots,m$ ，目标是<strong>使目标函数可以在一定程度不满足这个约束条件</strong>，我们引入常数 $C$ 和 损失函数 $\ell_{0/1}(z)$ 为<code>0/1损失函数</code>，当z小于0函数值为1，否则函数值为0<br>$$\operatorname*{min}_{\mathbf w,b} \frac{1}{2}\lVert w \lVert^2 + C \sum_{i=1}^m \ell_{0/1}(y_i(\mathbf w^T\vec x_i+b) -1) \tag {7}$$</p><p>对于(7)式来说 $C \geqslant 0$ 是个常数，<strong>当C无穷大时，迫使所有样本均满足约束；当C取有限值时，允许一些样本不满足约束</strong></p><p>但 $\ell_{0/1}(z)$ 损失函数<strong>非凸、非连续</strong>，数学性质不好，<strong>不易直接求解</strong>，我们用其他一些函数来代替它，叫做<code>替代损失函数（surrogate loss）</code><br>$$\begin{align}& \text{hinge损失:} \ell_{hinge}(z) = max(0,1-z)\\& \text{指数损失:} \ell_{exp}(z) =  e^{-z}\\& \text{对数损失:} \ell_{log}(z) = log(1+e^{-z})\\\end{align}$$<br>三种常见损失函数如下图</p><div align="center"><img src="//charlesliuyx.github.io/2017/09/19/支持向量机SVM学习笔记/lossfunction.png" alt="损失函数" width="450px"></div><p>为了书写方便，我们引入<strong>松弛变量（slack variables）</strong>: $\xi_i \geqslant 0$，可将(7)式重写为<br>$$\operatorname*{min}_{\mathbf w,b,\xi_i} \frac{1}{2}\lVert w \lVert^2 + C \sum_{i=1}^m \xi_i \\ s.t. \quad y_i(\mathbf w^T\vec x_i+b) \geqslant 1 - \xi_i ;\; \xi_i \geqslant 0,\; i = 1,2,\ldots,m \tag{8}$$<br>(8)式就是常见的<strong>软间隔支持向量机</strong>，其中，每一个样本都有一个对应的松弛变量，用以<strong>表征该样本不满足约束的程度</strong>，求解的方法同理硬间隔支持向量机</p><h1 id="支持向量机扩展"><a href="#支持向量机扩展" class="headerlink" title="支持向量机扩展"></a>支持向量机扩展</h1><h2 id="核方法"><a href="#核方法" class="headerlink" title="核方法"></a>核方法</h2><p>以上我们求解的支持向量机都是在<strong>线性情况下</strong>的，那么<strong>非线性情况</strong>下如何处理？这里就引入：核方法</p><p>对于这样的问题，可以将<strong>样本从原始空间映射到一个更高为的特征空间，使得样本在这个特征空间内线性可分</strong>，<a href="https://v.qq.com/x/page/k05170ntgzc.html" target="_blank" rel="noopener">直观可视化解释</a></p><p>为了完成这个目的，令 $\phi(\mathbf x)$ 表示将 $\mathbf x$ <strong>映射后的特征向量</strong>，于是，在特征空间<strong>划分超平面</strong>所对应的模型可表示为：<br>$$f(\mathbf x) = \mathbf w^T \phi(\mathbf x) + b$$</p><p>同理上文中引入拉格朗日乘子，求解整个方程后可得<br>$$\begin{align}f(\mathbf x) &=   \mathbf w^T \phi(\mathbf x) + b \\&= \sum_{i=1}^m \lambda_i y_i \phi(\mathbf x_i)^T \phi(\mathbf x) + b \\&= \sum_{i=1}^m \lambda_i y_i k(\mathbf x,\mathbf x_i)+ b\end{align}$$</p><p>这里的函数 $k(\cdot,\cdot)$ 就是<strong>核函数（kernel function）</strong>，常见的核函数见下表</p><table><thead><tr><th style="text-align:center">名称</th><th style="text-align:center">表达式</th><th style="text-align:center">参数</th></tr></thead><tbody><tr><td style="text-align:center">线性核</td><td style="text-align:center"> $\boldsymbol x_i^T \boldsymbol x_j$ </td><td style="text-align:center">无</td></tr><tr><td style="text-align:center">多项式核</td><td style="text-align:center"> $(\boldsymbol x_i^T \boldsymbol x_j)^d$ </td><td style="text-align:center">$d \geqslant 1$ 多项式次数</td></tr><tr><td style="text-align:center">高斯核</td><td style="text-align:center"> $exp(-\frac{\lVert\boldsymbol x_i - \boldsymbol x_j \lVert^2}{2\sigma^2})$ </td><td style="text-align:center">$\sigma&gt;0$  高斯核带宽</td></tr><tr><td style="text-align:center">拉普拉斯核</td><td style="text-align:center"> $exp(-\frac{\lVert\boldsymbol x_i - \boldsymbol x_j \lVert^2}{\sigma})$ </td><td style="text-align:center">$\sigma&gt;0$</td></tr><tr><td style="text-align:center">Sigmoid核</td><td style="text-align:center"> $tanh(\beta \boldsymbol x_i^T\boldsymbol x_j + \theta)$ </td><td style="text-align:center">$\beta&gt;0$ $\theta&gt;0$</td></tr></tbody></table><p>也可以通过<strong>函数组合</strong>得到这些值</p><h2 id="多类问题"><a href="#多类问题" class="headerlink" title="多类问题"></a>多类问题</h2><p>多类问题可以使用两两做支持向量机，再由所有的支持向量机投票选出这个类别的归属，被称为<code>one-versus-one approace</code>。</p><p>Reference<br><a href="https://www.zhihu.com/question/21094489" target="_blank" rel="noopener">知乎各类回答</a><br><a href="https://zh.wikipedia.org/wiki/%E6%94%AF%E6%8C%81%E5%90%91%E9%87%8F%E6%9C%BA" target="_blank" rel="noopener">Wiki百科</a><br>PRML<br>周志华-机器学习</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】13min - 19min&lt;br&gt;【内容简介】详解解读什么是支持向量机，如何解支持向量以及涉及的拉普拉斯乘子法，还有核方法的解读&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>Dota2伤害类型详解</title>
    <link href="https://charlesliuyx.github.io/2017/09/18/Dota2%E4%BC%A4%E5%AE%B3%E7%B1%BB%E5%9E%8B%E8%AF%A6%E8%A7%A3/"/>
    <id>https://charlesliuyx.github.io/2017/09/18/Dota2伤害类型详解/</id>
    <published>2017-09-18T06:31:12.000Z</published>
    <updated>2017-10-06T01:33:40.488Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】5min 百科类<br>【内容简介】有关<code>Dota2</code>所有伤害来源的总结和互相作用总结，方便查阅</p><a id="more"></a><h1 id="伤害来源"><a href="#伤害来源" class="headerlink" title="伤害来源"></a>伤害来源</h1><h2 id="攻击伤害"><a href="#攻击伤害" class="headerlink" title="攻击伤害"></a>攻击伤害</h2><p>主要来自于普通物理攻击 - <strong>平A</strong></p><p><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#物理攻击伤害">具体计算方式</a></p><h2 id="技能伤害"><a href="#技能伤害" class="headerlink" title="技能伤害"></a>技能伤害</h2><p><a href="https://dota2-zh.gamepedia.com/%E6%8A%80%E8%83%BD%E4%BC%A4%E5%AE%B3" target="_blank" rel="noopener">详情参见</a></p><p>包含了所有来自技能的伤害，三种类型：魔法，物理和纯粹</p><h1 id="伤害类型"><a href="#伤害类型" class="headerlink" title="伤害类型"></a>伤害类型</h1><p><strong>互相作用机制表格</strong></p><table><thead><tr><th style="text-align:center">游戏机制</th><th style="text-align:center">物理攻击</th><th style="text-align:center">物理技能</th><th style="text-align:center">魔法伤害</th><th style="text-align:center">纯粹伤害</th></tr></thead><tbody><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#护甲">护甲</a></td><td style="text-align:center">降低</td><td style="text-align:center">降低</td><td style="text-align:center">正常</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#BD-Blocked-Damage-被格挡伤害">伤害格挡</a></td><td style="text-align:center">降低</td><td style="text-align:center">正常<a href="唯一的例外是`月刃`的弹射伤害和`虫群`的攻击伤害，会被格挡">^1</a></td><td style="text-align:center">正常</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#魔法抗性">魔法抗性</a></td><td style="text-align:center">正常</td><td style="text-align:center">正常</td><td style="text-align:center">降低</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://dota2-zh.gamepedia.com/虚无" target="_blank" rel="noopener">虚无</a></td><td style="text-align:center">没有效果</td><td style="text-align:center">美国效果</td><td style="text-align:center">降低</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#闪避">闪避</a></td><td style="text-align:center">可能落空</td><td style="text-align:center">正常</td><td style="text-align:center">正常</td><td style="text-align:center">降低</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#致盲来源">致盲</a></td><td style="text-align:center">可能落空</td><td style="text-align:center">正常</td><td style="text-align:center">正常</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#伤害调整">伤害加深</a><a href="这些效果只针对那些直接对伤害进行操作的技能效果，即减免，加深或完全格挡，不包括通过增加/减少魔法抗性/护甲的技能">^2</a></td><td style="text-align:center">加深</td><td style="text-align:center">加深</td><td style="text-align:center">加深</td><td style="text-align:center">加深</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#伤害减免和加深">伤害减免</a><a href="这些效果只针对那些直接对伤害进行操作的技能效果，即减免，加深或完全格挡，不包括通过增加/减少魔法抗性/护甲的技能">^2</a></td><td style="text-align:center">降低</td><td style="text-align:center">降低</td><td style="text-align:center">降低</td><td style="text-align:center">降低</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#伤害无效化">伤害无效化</a><a href="这些效果只针对那些直接对伤害进行操作的技能效果，即减免，加深或完全格挡，不包括通过增加/减少魔法抗性/护甲的技能">^2</a></td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td></tr><tr><td style="text-align:center"><a href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/#魔法吸收护盾">魔法伤害护盾</a></td><td style="text-align:center">正常</td><td style="text-align:center">正常</td><td style="text-align:center">没有效果</td><td style="text-align:center">正常</td></tr><tr><td style="text-align:center"><a href="https://dota2-zh.gamepedia.com/%E6%97%A0%E6%95%8C" target="_blank" rel="noopener">无敌</a></td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td><td style="text-align:center">没有效果</td></tr><tr><td style="text-align:center"><a href="https://dota2-zh.gamepedia.com/%E6%8A%80%E8%83%BD%E5%85%8D%E7%96%AB" target="_blank" rel="noopener">技能免疫</a></td><td style="text-align:center">正常</td><td style="text-align:center">不定</td><td style="text-align:center">不定</td><td style="text-align:center">不定</td></tr></tbody></table><h2 id="物理"><a href="#物理" class="headerlink" title="物理"></a>物理</h2><p>与护甲和伤害格挡有关，虚无和一些技能可以造成物理免疫，召唤单位和守卫的平A也是物理攻击</p><h3 id="物理免疫技能"><a href="#物理免疫技能" class="headerlink" title="物理免疫技能"></a>物理免疫技能</h3><p><code>炼金术士：酸性喷雾</code> <code>炼金术士：不稳定化合物</code> <code>敌法师：法力损毁</code> <code>兽王：野性飞斧</code> <code>赏金猎人：暗影步</code> <code>钢背兽：针刺扫射</code> <code>人马：反击</code> <code>克林克次：灼热之箭</code> <code>戴泽：剧毒之触</code> <code>戴泽：暗影波</code> <code>死亡先知：驱使恶灵</code> <code>龙骑士：古龙形态溅射</code> <code>上古巨神：裂地沟壑</code> <code>上古巨神：回音重踏</code> <code>灰烬之灵：无影拳</code> <code>主宰：无敌斩</code> <code>昆卡：潮汐使者</code> <code>拉席克：恶魔赦令</code> <code>噬魂鬼：盛宴</code> <code>露娜：月刃</code> <code>马格纳斯：加强力量溅射</code> <code>司夜刺客：复仇</code> <code>剃刀：风暴之眼</code> <code>力丸：背刺</code> <code>斯拉达：鱼人碎击</code> <code>斯拉达：重击</code> <code>狙击手：爆头</code> <code>熊灵：缠绕之爪</code> <code>斯温：巨力挥舞</code> <code>圣堂刺客：隐匿</code> <code>潮汐猎人：锚机</code> <code>熊战士：怒意狂击</code> <code>冥界亚龙：幽冥剧毒</code> <code>编织者：虫群</code> </p><h2 id="魔法"><a href="#魔法" class="headerlink" title="魔法"></a>魔法</h2><p>大多数技能都是魔法伤害，虚无状态会承受更多伤害</p><p>在纯粹和物理技能中未提及的都是魔法伤害</p><h2 id="纯粹"><a href="#纯粹" class="headerlink" title="纯粹"></a>纯粹</h2><p>纯粹伤害能作用与技能免疫单位，不能作用于无敌单位</p><p><code>斧王-反击螺旋</code> <code>祸乱之源：蚀脑</code> <code>祸乱之源：噩梦</code> <code>嗜血狂魔：血之祭祀</code> <code>嗜血狂魔：割裂</code> <code>陈：忠诚考验</code> <code>末日使者：末日</code> <code>魅惑魔女：推进</code> <code>谜团：午夜凋零</code> <code>谜团：黑洞</code> <code>祈求者：炎阳冲击</code> <code>杰奇洛：A烈焰焚身</code> <code>莉娜：A神灭斩</code> <code>美杜莎：（石化）秘术异蛇</code> <code>司夜刺客：尖刺外壳</code> <code>全能骑士：洗礼</code> <code>殁境神蚀者：奥术天球</code> <code>帕吉：肉钩</code> <code>痛苦女王：超声冲击波</code> <code>沉默术士：智慧之刃</code> <code>幽鬼：荒芜</code> <code>圣堂刺客：灵能之刃</code> <code>伐木机：锯齿飞轮</code> <code>伐木机：伐木锯链</code> <code>伐木机：死亡旋风</code> <code>修补匠：激光</code> <code>骨灰</code></p><h1 id="标记"><a href="#标记" class="headerlink" title="标记"></a>标记</h1><p>是一种特殊标记，为的是与其他技能区分开来</p><h2 id="生命移除标记"><a href="#生命移除标记" class="headerlink" title="生命移除标记"></a>生命移除标记</h2><p>某些生命移除标记的技能可以<strong>立即杀死幻想</strong></p><p><code>干扰者：恶念瞥视</code> <code>莱恩：妖术</code> <code>莱恩：法力抽取</code> <code>美杜莎：石化凝视</code> <code>帕格纳：生命吸取</code> <code>羊刀：变羊</code> <code>暗影萨满：变羊</code></p><p>有些技能<strong>利用生命移除</strong>来制造<strong>生命消耗效果</strong>，通常都是<strong>非致命伤害</strong>，<strong>伤害类型也是纯粹</strong>，被标记为生命移除</p><p><code>臂章：扣血</code> <code>哈斯卡：沸血之矛对自身</code> <code>艾欧：过载</code> <code>凤凰：凤凰冲击</code> <code>凤凰：烈火精灵</code> <code>凤凰：烈日炙烤</code> <code>魂戒：献身</code> <code>工程师：自爆起飞</code> <code>不朽尸王：噬魂</code></p><h2 id="不反弹标记"><a href="#不反弹标记" class="headerlink" title="不反弹标记"></a>不反弹标记</h2><p>不反弹标记会使得一些受到伤害事件不会与带有不反弹标记的伤害相互作用，这防止了无限伤害循环(</p><p><code>刃甲：反弹伤害</code> <code>司夜刺客：尖刺外壳</code> <code>冥界亚龙：腐蚀皮肤</code> <code>术士：致命链接</code></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】5min 百科类&lt;br&gt;【内容简介】有关&lt;code&gt;Dota2&lt;/code&gt;所有伤害来源的总结和互相作用总结，方便查阅&lt;/p&gt;
    
    </summary>
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/categories/Dota2/"/>
    
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/tags/Dota2/"/>
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】机器学习分类器性能指标详解</title>
    <link href="https://charlesliuyx.github.io/2017/09/12/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E5%88%86%E7%B1%BB%E5%99%A8%E6%80%A7%E8%83%BD%E6%8C%87%E6%A0%87%E8%AF%A6%E8%A7%A3/"/>
    <id>https://charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/</id>
    <published>2017-09-12T05:05:32.000Z</published>
    <updated>2017-10-06T01:34:47.217Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】16 - 26 min<br>【内容简介】系统详解分类器性能指标，什么是<code>准确率 - Accuracy</code>、<code>精确率 - Precision</code>、<code>召回率 - Recall</code>、<code>F1值</code>、<code>ROC曲线</code>、<code>AUC曲线</code>、<code>误差 - Error</code>、<code>偏差 - Bias</code>、<code>方差 - Variance</code>及<code>Bias-Variance Tradeoff</code></p><a id="more"></a><p>在任何领域，评估（Evaluation）都是一项很重要的工作。在Machine Learning领域，定义了许多概念并有很多手段进行评估工作</p><h1 id="混淆矩阵-Confusion-Matrix"><a href="#混淆矩阵-Confusion-Matrix" class="headerlink" title="混淆矩阵 - Confusion Matrix"></a>混淆矩阵 - Confusion Matrix</h1><p><strong>准确率</strong>定义：对于给定的测试数据集，分类器<strong>正确分类的样本数</strong>与<strong>总样本数</strong>的之比</p><p>通过准确率，的确可以在一些场合，从某种意义上得到一个分类器是否有效，但它并不总是能有效的评价一个分类器的工作。一个例子，Google抓取了100个特殊页面，它的索引中有10000000页面。随机抽取一个页面，这是不是特殊页面呢？如果我们的分类器确定一个分类规则：“只要来一个页面就判断为【不是特殊页面】”，这么做的效率非常高，如果计算按照准确率的定义来计算的话，是(9,999,900/10,000,000) = 99.999%。虽然高，但是这不是我们并不是我们真正需要的值，就需要新的定义标准了</p><p>对于一个二分类问题来说，将实例分为<strong>正类（Positive/+）</strong>或<strong>负类（Negative/-）</strong>，但在使用分类器进行分类时会有四种情况</p><ul><li>一个实例是正类，并被预测为正类，记为真正类（True Positive <strong>TP/T+</strong>）</li><li>一个实例是正类，但被预测为负类，记为假负类（False Negative <strong>FN/F-</strong>）</li><li>一个实例是负类，但被预测为正类，记为假正类（False Positive <strong>FP/F+</strong>）</li><li>一个实例是负类，但被预测为负类，记为真负类（True Negative <strong>TN/F-</strong>）</li></ul><p><strong>TP和TN中的真表示分类正确，同理FN和FP表示分类错误的</strong></p><p>为了全面的表达所有二分问题中的指标参数，下列矩阵叫做<strong>混淆矩阵 - Confusion Matrix</strong>，目的就是看懂它，搞清楚它，所有模型评价参数就很清晰了</p><?xml version="1.0" standalone="no"?><svg xmlns="http://www.w3.org/2000/svg" xmlns:xlink="http://www.w3.org/1999/xlink" width="100%" height="100%" viewbox="0 5.5 96 48"> <title>DiagnosticTesting Diagram</title> <desc>Relationships between various measures of diagnostic testing by CMG Lee. In the SVG image, hover over a block or relation to highlight it.</desc> <style type="text/css">  #mainsvg         { font-family:Helvetica,Arial,sans-serif; font-size:6px; text-anchor:middle;                  stroke-linejoin:round; stroke-linecap:round; stroke-width:0.7; fill:none;                  stroke-opacity:1;    fill-opacity:1;    }  #mainsvg:hover   { stroke-opacity:0.25; fill-opacity:0.25; }  .active:hover { stroke-opacity:1;    fill-opacity:1;    }  text          { fill:#000000; cursor:default; }  .label        { stroke:none; fill:#000000 }  .op           { stroke-width:0.15; font-size:5px; font-weight:bold; } </style> <defs>  <rect id="box" x="-6" y="-1.3" width="12" height="2.6" stroke-width="2.8" stroke-opacity="1"/>  <g id="top"><path d="M  0, 0 q  0,-4  5,-4 h  30 q  5, 0   5, 4 m -20,  0 q  0,-4 -5,-4" stroke-dasharray="0.1,1"/><text class="op" x="8" y="-3" dy="0.7ex">+</text></g>  <g id="bottom1"><path d="M  0, 0 q  0, 4 -5, 4 h -50 q -5, 0  -5,-4 m  20,  0 q  0, 4  5, 4" stroke-dasharray="2,1"/><text class="op" x="0" y="4" dy="0.7ex">&#247;</text></g>  <g id="bottom2"><path d="M  0, 0 q  0, 5 -5, 5 h -69 q -5, 0  -5,-5 m  40,  0 q  0, 5  5, 5"/><text class="op" x="0" y="4.5" dy="0.7ex">&#247;</text></g>  <g id="bottom3"><path d="M  0, 0 q  0, 4 -5, 4 h -30 q -5, 0  -5,-4 m  20,  0 q  0, 4  5, 4"/><text class="op" x="0" y="4" dy="0.7ex">&#247;</text></g>  <g id="left"><path d="M  0, 0 q -9, 0 -9, 5 v  10 q  0, 5   9, 5 m   0,-10 q -9, 0 -9,-5" stroke-dasharray="0.1,1"/><text class="op" x="-8.5" y="1" dy="0.7ex">+</text></g>  <g id="right1"><path d="M  0, 0 q  9, 0  9,-5 v -20 q  0,-5  -9,-5 m   0, 10 q  9, 0  9, 5" stroke-dasharray="2,1"/><text class="op" x="8.5" y="-1" dy="0.7ex">&#247;</text></g>  <g id="right2"><path d="M  0, 0 q 10, 0 10,-5 v -30 q  0,-5 -10,-5 m   0, 20 q 10, 0 10, 5"/><text class="op" x="8.5" y="0" dy="0.7ex">&#247;</text></g>  <g id="acc"><path d="M  0, 0 q  0, 5 -5, 5 h -69 q -5, 0  -5,-5 m  22, 10 q  0,-5  5,-5                           M  0, 0 q  0, 5 -5, 5 h -17 q -5, 0  -5, 5 v       5 q  0, 1 -1, 1 h -5 q -4,0 -4,4"/><text class="op" x="2.5" y="4.5" dy="0.7ex">+,&#247;</text></g>  <g id="dor"><path d="M  0, 0 q  0, 4 -5, 4 h  -5 q -5, 0  -5,-4 m   0,  8 q  0,-4  5,-4" stroke-dasharray="4,1"/><text class="op" x="0" y="4" dy="0.7ex">&#247;</text></g>  <g id="f1"><path d="M  0, 0 q -10,0 -9,-4 v -22 q  0,-2  -2,-2                           M -9,-3 q -1,-1 -2,-1 h -43 q -5, 0  -5,-5" stroke-dasharray="0.1,1"/></g> </defs> <circle cx="0" cy="0" r="99999" fill="#999999"/> <g id="mainsvg">  <g class="active" transform="translate(88,48)" stroke="#ddffdd"><use xlink:href="#f1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">F1 s.</text><title>F1 score = 2 / (1 / Recall + 1 / Precision)</title></g>  <g class="active" transform="translate(88,10)" stroke="#cceecc"><use xlink:href="#acc"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">ACC</text><title>Accuracy = (&#931; True positive + &#931; True negative) / &#931; Total population</title></g>  <g class="active" transform="translate(88,39)" stroke="#dddddd"><use xlink:href="#dor"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">DOR</text><title>Diagnostic odds ratio = Positive likelihood ratio / Negative likelihood ratio</title></g>  <g class="active" transform="translate(70,39)" stroke="#eeeeee"><use xlink:href="#bottom3"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">LR+</text><title>Positive likelihood ratio = True positive rate / False positive rate</title></g>  <g class="active" transform="translate(70,48)" stroke="#cccccc"><use xlink:href="#bottom3"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">LR&#8722;</text><title>Negative likelihood ratio = False negative rate / True negative rate</title></g>  <g class="active" transform="translate(88,20)" stroke="#cceeff"><use xlink:href="#bottom2"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">FDR</text><title>False discovery rate = &#931; False positive / &#931; Predicted condition positive</title></g>  <g class="active" transform="translate(70,20)" stroke="#ccffee"><use xlink:href="#bottom1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">PPV</text><title>Positive predictive value, Precision = &#931; True positive / &#931; Predicted condition positive</title></g>  <g class="active" transform="translate(88,30)" stroke="#aaddcc"><use xlink:href="#bottom2"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">NPV</text><title>Negative predictive value = &#931; True negative / &#931; Predicted condition negative</title></g>  <g class="active" transform="translate(70,30)" stroke="#eeddee"><use xlink:href="#bottom1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">FOR</text><title>False omission rate = &#931; False negative / &#931; Predicted condition negative</title></g>  <g class="active" transform="translate(30,39)" stroke="#eeffcc"><use xlink:href="#right1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">TPR</text><title>True positive rate, Recall, Sensitivity, probability of detection = &#931; True positive / &#931; Condition positive</title></g>  <g class="active" transform="translate(30,48)" stroke="#ffeecc"><use xlink:href="#right2"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">FNR</text><title>False negative rate, Miss rate = &#931; False negative / &#931; Condition positive</title></g>  <g class="active" transform="translate(50,39)" stroke="#eeddbb"><use xlink:href="#right1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">FPR</text><title>False positive rate, Fall-out, probability of false alarm = &#931; False positive / &#931; Condition negative</title></g>  <g class="active" transform="translate(50,48)" stroke="#ddeebb"><use xlink:href="#right2"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">TNR</text><title>True negative rate, Specificity = &#931; True negative / &#931; Condition negative</title></g>  <g class="active" transform="translate(70,10)" stroke="#eeeecc"><use xlink:href="#bottom1"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">prev.</text><title>Prevalence = &#931; Condition positive / &#931; Total population</title></g>  <g class="active" transform="translate(10,10)" stroke="#dddddd"><use xlink:href="#top"/><use xlink:href="#left"/><use xlink:href="#box"/><text class="label" x="0" y="0.4ex">pop.</text><title>Total population = Condition positive + Condition negative = Predicted condition positive + Predicted condition negative 样本空间 = 正类 + 负类 = 预测结果正类 + 预测结果负类</title></g>  <g class="active" transform="translate(10,30)" stroke="#aadddd"><use xlink:href="#top"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">Pc&#8722;</text><title>Predicted condition negative = False negative + True negative</title></g>  <g class="active" transform="translate(10,20)" stroke="#ccffff"><use xlink:href="#top"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">Pc+</text><title>Predicted condition positive = True positive + False positive</title></g>  <g class="active" transform="translate(30,10)" stroke="#ffffcc"><use xlink:href="#left"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">C+</text><title>Condition positive = True positive + False negative</title></g>  <g class="active" transform="translate(50,10)" stroke="#ddddaa"><use xlink:href="#left"/><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">C&#8722;</text><title>Condition negative = False positive + True negative</title></g>  <g class="active" transform="translate(50,30)" stroke="#bbeebb"><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">T&#8722;</text><title>负类中预测正确的部分</title></g>  <g class="active" transform="translate(30,30)" stroke="#ffdddd"><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">F&#8722;</text><title>负类中预测错误的部分</title></g>  <g class="active" transform="translate(50,20)" stroke="#eedddd"><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">F+</text><title>正类中预测错误的部分</title></g>  <g class="active" transform="translate(30,20)" stroke="#ccffcc"><use xlink:href="#box"/><text class="label" x="0" y="0.5ex">T+</text><title>正类中预测正确的部分</title></g> </g></svg><p>通过上面的的讨论已经有<code>T+:TP</code> <code>F+:FP</code> <code>T-:TN</code> <code>F-:FN</code> <code>C+:样本正类</code> <code>C-:样本负类</code> <code>Pc+:预测正类</code> <code>Pc-:预测负类</code> </p><p>用样本中的正类和负类进行计算的定义</p><table><thead><tr><th style="text-align:center">缩写</th><th style="text-align:center">全称</th><th style="text-align:center">等价称呼</th><th style="text-align:center">计算公式</th></tr></thead><tbody><tr><td style="text-align:center">TPR</td><td style="text-align:center">True Positive Rate</td><td style="text-align:center">真正类率 <code>Recall</code> <code>Sensitivity</code></td><td style="text-align:center">$ \frac {\sum T+}{\sum C+}$</td></tr><tr><td style="text-align:center">FNR</td><td style="text-align:center">False Negative Rate</td><td style="text-align:center">假负类率<code>Miss rate</code> <code>Type rs  error</code></td><td style="text-align:center">$ \frac {\sum F-}{\sum C+}$</td></tr><tr><td style="text-align:center">FPR</td><td style="text-align:center">False Positive Rate</td><td style="text-align:center">假正类率<code>fall-out</code> <code>Type 1 error</code></td><td style="text-align:center">$ \frac {\sum F+}{\sum C-}$</td></tr><tr><td style="text-align:center">TNR</td><td style="text-align:center">Tre Negative Rate</td><td style="text-align:center">真负类率<code>Specificity</code></td><td style="text-align:center">$ \frac {\sum T-}{\sum C-}$</td></tr></tbody></table><p>用预测结果的正类和负类进行计算的定义</p><table><thead><tr><th style="text-align:center">缩写</th><th style="text-align:center">全称</th><th style="text-align:center">等价称呼</th><th style="text-align:center">计算公式</th></tr></thead><tbody><tr><td style="text-align:center">PPV</td><td style="text-align:center">Positive Predictive Value</td><td style="text-align:center">正类预测率<code>Precision</code></td><td style="text-align:center">$ \frac {\sum T+}{\sum Pc+}$</td></tr><tr><td style="text-align:center">FOR</td><td style="text-align:center">False Omission Rata</td><td style="text-align:center">假错误率</td><td style="text-align:center">$ \frac {\sum F-}{\sum Pc-}$</td></tr><tr><td style="text-align:center">FDR</td><td style="text-align:center">False Discovery Rate</td><td style="text-align:center">假发现率</td><td style="text-align:center">$ \frac {\sum F+}{\sum Pc+}$</td></tr><tr><td style="text-align:center">NPV</td><td style="text-align:center">Negative Predictive Value</td><td style="text-align:center">负类预测率</td><td style="text-align:center">$ \frac {\sum T-}{\sum Pc-}$</td></tr></tbody></table><p>其他定义概念</p><table><thead><tr><th style="text-align:center">缩写</th><th style="text-align:center">全称</th><th style="text-align:center">等价称呼</th><th style="text-align:center">计算公式</th></tr></thead><tbody><tr><td style="text-align:center">ACC</td><td style="text-align:center">Accuracy</td><td style="text-align:center">准确率</td><td style="text-align:center">$ \frac {\sum (T+) + \sum {T-}}{样本空间}$</td></tr><tr><td style="text-align:center">LR+</td><td style="text-align:center">Positive Likelihood Ratio</td><td style="text-align:center">正类似然比</td><td style="text-align:center">$ \frac {TPR}{FPR}$</td></tr><tr><td style="text-align:center">LR-</td><td style="text-align:center">Negative likelihood ratio</td><td style="text-align:center">负类似然比</td><td style="text-align:center">$ \frac {FNR}{TNR}$</td></tr><tr><td style="text-align:center">DOR</td><td style="text-align:center">Diagnostic odds ratio</td><td style="text-align:center">诊断胜算比</td><td style="text-align:center">$ \frac {LR+}{LR-}$</td></tr><tr><td style="text-align:center">F1 score</td><td style="text-align:center">$F_1$ test measure</td><td style="text-align:center">F1值</td><td style="text-align:center">$\frac{2}{\frac{1}{recall}+\frac{1}{precision}}$</td></tr><tr><td style="text-align:center">MCC</td><td style="text-align:center">Matthews Correlation coefficient</td><td style="text-align:center">马修斯相关性系数</td><td style="text-align:center">$\frac{TP \times TN - FP \times FN}{\sqrt {(TP + FP)(TP + FN)(TN + FP)(TN +FN)}}$</td></tr></tbody></table><p><code>LR+/-</code>指的是似然比，<strong>LR+ 越大表示模型对正类的分类越好，LR-越大表示模型对负类的分类效果越好</strong></p><p><code>F1值</code>是精确值和召回率的调和均值，其实原公式是 $F_\beta = (1 + \beta^2)\frac{precision \times recall}{(\beta^2recall)+recall}$，这里的β表示：<strong>召回率的权重是准确率的β倍</strong>。即F值是一种精确率和召回率的综合指标，权重由β决定</p><p><code>MCC</code>值在[-1,1]之间，靠近1表示完全预测正确，靠近-1表示完全悖论，0表示随机预测</p><p>最终为了不那么麻烦，说人话，还是<strong>一图胜千言</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/Precisionrecall.png" alt="Precision - Recall" title="">                </div>                <div class="image-caption">Precision - Recall</div>            </figure><p>图片详解：</p><blockquote><p>左边暗一些部分的点都是<strong>真正的正类</strong>，右边亮一些部分的点都是<strong>真正的负类</strong></p><p>中间的一个圆圈就是我们的<strong>正类分类器</strong>：注意，这个<strong>圈是的预测结果都是正类</strong>，也就是说在这个分类器看来，它选择的这些元素都是它所认为的<strong>正类</strong>，对应的，当然是圈以外的部分，也就是<strong>预测结果是负类的部分</strong></p><p>底下的Precision和Recall示意图也相当的直观，看一下就能明白</p></blockquote><h1 id="ROC-Curve"><a href="#ROC-Curve" class="headerlink" title="ROC Curve"></a>ROC Curve</h1><p>ROC - Receiver Operating Characteristic Curve，接受者操作特征曲线，ROC曲线</p><p>这个曲线乍看下为啥名称那么奇怪呢，原来这个曲线最早是由二战中的电子工程师和雷达工程师发明的，用来侦测战场上的敌军飞机，舰艇等，是一种信号检测理论，还被应用到心理学领域做知觉检测。</p><h2 id="什么是ROC曲线"><a href="#什么是ROC曲线" class="headerlink" title="什么是ROC曲线"></a>什么是ROC曲线</h2><p>ROC曲线和混淆矩阵息息相关，上一部分已经详细解释了相关内容，这里直接说明ROC曲线的横坐标和纵坐标分别是什么</p><p>横坐标：FPR假正类率，纵坐标：TPR真正类率</p><p>初看之下你不懂一个曲线表示的什么意思，那么看几个特征点或特殊曲线是一个非常好的方法。按照这种方法来分析ROC曲线：</p><ul><li>第一个点：(0,1)，<code>FPR=0</code> <code>TPR=1</code> ，这意味着所有的正类全部分类正确，或者说<strong>这是一个完美的分类器</strong>，将所有的样本都分类正确了</li><li>第二个点：(1,0)， <code>FPR=1</code> <code>TPR=0</code> ，和第一个点比较，这是第一个点的完全反面，意味着是个<strong>最糟糕的分类器</strong>，将所有的样本都分类错误了（但其实可以直接取反，就是最好的模型，因为是二分类问题）</li><li>第三个点：(0,0)，<code>FPR=0</code> <code>TPR=0</code> 也就是原点，这个点表示的意思是，<strong>分类器预测所有的样本都为负类</strong></li><li>第四个点：(1,1)，<code>FPR=1</code> <code>TPR=1</code>，和第三个点对应，表示<strong>分类器预测所有的样本都为正类</strong></li><li>一条线：y=x。这<strong>条对角线上的点</strong>实际上就是一个<strong>采用随机猜测策略的分类器的结果</strong></li></ul><p>总结来说，ROC曲线的面积越大，模型的效果越好；ROC曲线光滑以为着Overfitting越少</p><p>还是一图胜千言</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/ROCfig.png" alt="ROC曲线解释" title="">                </div>                <div class="image-caption">ROC曲线解释</div>            </figure><p>$TPR = \frac{TP}{TP+FN}$ $FPR = \frac{FP}{FP+TN}$ 蓝色图像是正类分类器的概率分布，红色图像负类分类器的概率分布，竖直的黑线是阈值（Threshold），<strong>二分类分类器的输出就是一个取值在[0,1]间的值（概率）</strong>，我们将黑线从0移动到1，就能得出一条曲线，这条线就是ROC曲线</p><p>如果问这个<strong>分类器画成的图像为</strong>何是一个类似帽子的形状，例子是最佳的说明方法，我们就来算一个ROC曲线看看，下图是20个测试样本的结果，“Class”一栏表示每个测试样本真正的标签（p表示正类，n表示负类），“Score”表示每个测试样本属于正样本的概率，Inst#是序号数</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/score-ranking.png" alt="example-data" title="">                </div>                <div class="image-caption">example-data</div>            </figure><p>接下来，我们从高到低，<strong>依次将“Score”值作为阈值threshold</strong>，当测试样本属于正样本的概率大于或等于这个threshold时，我们认为它为正样本，否则为负样本。举例来说，对于图中的<strong>第4个样本</strong>，其“Score”值为0.6，那么样本1，2，3，4都被认为是正样本，因为它们的“Score”值都大于等于0.6，而其他样本则都认为是负样本。<strong>每次选取一个不同的threshold，我们就可以得到一组FPR和TPR，即ROC曲线上的一点。</strong>这样一来，我们一共得到了<strong>20组FPR和TPR的值（和你的测试样本的数量有关）</strong>，将它们画在ROC曲线的结果如下图：</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/roc-example.png" alt="example-roc-curve" title="">                </div>                <div class="image-caption">example-roc-curve</div>            </figure><p>当然我们也可以曲很多个阈值画曲线，不一定非要从测试样本的结果中取20个</p><h2 id="为什么使用ROC曲线"><a href="#为什么使用ROC曲线" class="headerlink" title="为什么使用ROC曲线"></a>为什么使用ROC曲线</h2><p>ROC曲线有一个很好的特性：当测试集中的<strong>正负样本的分布变化</strong>的时候，ROC曲线能够保持不变。在实际的数据集中经常会出现<strong>类不平衡（class imbalance）现象</strong>，即<strong>负样本比正样本多很多（或者相反）</strong>，而且<strong>测试数据中的正负样本的分布也可能随着时间变化</strong>。下图是ROC曲线和Precision-Recall曲线的对比：</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/roc-and-precall.png" alt="ROC-PrecisionRecall" title="">                </div>                <div class="image-caption">ROC-PrecisionRecall</div>            </figure><p>在上图中，<strong>(a)和(c)为ROC曲线</strong>，<strong>(b)和(d)为Precision-Recall曲线</strong>。</p><p>(a)和(b)展示的是<strong>分类其在原始测试集（正负样本分布平衡）的结果</strong>，(c)和(d)是将测试集中<strong>负样本的数量增加到原来的10倍后</strong>，分类器的结果。可以明显的看出，<strong>ROC曲线基本保持原貌，而Precision-Recall曲线则变化较大</strong>，记住这个结论即可</p><h1 id="PRC-Curve"><a href="#PRC-Curve" class="headerlink" title="PRC Curve"></a>PRC Curve</h1><p>在上面提到了一个指标，PRC - Precision-Recall 曲线，画法和ROC很相似，但是使用值是Precision和Recall</p><h1 id="AUC-Value"><a href="#AUC-Value" class="headerlink" title="AUC Value"></a>AUC Value</h1><p>AUC - Area Under Curve被定义为ROC曲线下的面积</p><p>AUC在[0.5,1]之间，这是因为ROC曲线一般都处于y=x这条直线的上方（否则这个做分类器的人连简单的取非都不会真可以去死了）</p><p>AUC值越大，证明这个模型越好</p><h1 id="Bias-Variance-Tradeoff"><a href="#Bias-Variance-Tradeoff" class="headerlink" title="Bias-Variance Tradeoff"></a>Bias-Variance Tradeoff</h1><p>三个名词，<code>Error误差</code> <code>Bisa偏差</code> <code>Variance方差</code></p><h2 id="三个名词表示了什么"><a href="#三个名词表示了什么" class="headerlink" title="三个名词表示了什么"></a>三个名词表示了什么</h2><p>再来一次，一图胜千言</p><div align="center"><br><br><img src="//charlesliuyx.github.io/2017/09/12/机器学习分类器性能指标详解/BV-Tradeoff.png" alt="Bias-Variance-Tradeoff" width="450px"><br><br></div><ul><li><strong>准</strong>：Bias 描述的是<strong>根据样本</strong>训练的模型的<strong>输出预测结果的期望</strong>与<strong>样本真实结果</strong>的差距，说人话，这个模型对样本拟合的好不好。想在Bias上表现好，降低Bias，就是复杂化模型，增加模型的参数，但这样容易过拟合（Overfitting）<strong>Low Bias对应的就是点都在靶心附近，所以瞄的都是准的，但手不一定稳</strong></li><li><strong>确</strong>：Variance 描述的是<strong>根据样本</strong>训练的模型在<strong>测试集上的表现（泛化能力） </strong>，想在Variance上表现好，降低Variance，需要简化模型，减少模型的参数，这样做容易欠拟合，对应上图的High Bias，点偏离的中心。<strong>Low Variance对应的是点打的都很集中，但不一定在靶心附近，手很稳，但是瞄的不准</strong></li></ul><p>要准确表达这两个定义的含义必须要使用公式化的语言，不得不感叹，<strong>在准确描述世界运行的规律这件事上，数学比文字要准确并且无歧义的多，文字（例子）直观啰嗦，数学（公式）准确简介</strong></p><p>我们假设有这样的一个函数，$y=f(x) + \epsilon$ ，其中噪声 $\epsilon$ 均值为0，<strong>方差为 $\sigma^2$</strong> </p><p>我们的目的是去找到一个函数 $\hat {f}(x)$ <strong>尽可能接近</strong> $f(x)$ ，我们可以用<strong>均方误差（MSE）或者交叉熵，或者DL散度</strong>来表示这个接近程度，我们希望 $(y - \hat f(x) )^2$ 对样本空间内的所有样本和测试集中的所有样本都<strong>最小</strong></p><p>机器学习核心就是用各种不同的算法去找这个 $\hat f$，希望最小，那就使用一个公式来表征这个值得大小，<strong>即期望，<font color="#FF0000">也称Total Error（误差），在机器学习的训练中，这个值是评判模型好坏最重要：</font></strong><br>$$<br>E[(y - \hat f(x))^2] = Bias[\hat f(x)]^2 + Var[\hat f(x)] + \sigma^2<br>$$</p><p>其中 $Bias[\hat f(x)] = E[\hat f(x) - f(x)]$，且 $Var[\hat f(x)] = E[\hat f(x)^2] - E[\hat f(x)]^2$</p><p><code>Bias-Variance Tradeoff</code>作为机器学习一个核心训练的观点或者说概念，<strong>推导觉得还是十分重要</strong>，整理如下</p><h2 id="推导过程"><a href="#推导过程" class="headerlink" title="推导过程"></a>推导过程</h2><p>为了公式简介，把 $f(x)$ 与 $\hat f(x)$ 简写为 $f$ 与 $\hat f$ ，记随机变量为 $X$，有<br>$$<br>Var[X] = E[X^2] - E[X]^2 \implies E[X^2] = Var[X] + E[X]^2<br>$$</p><p>因为 $f$ 是一个已经确定的函数，所以 $E[f] = f$ 成立 </p><p>根据 $y = f + \epsilon$ 和 $E[\epsilon] = 0$ 有<br>$$<br>E[y] = E[f + \epsilon] = E[f] = f<br>$$<br>噪声的方差 $ Var[\epsilon] = \sigma^2$<br>$$Var[y] = E[(y-E[y])^2] = E[(y - f)^2] = E[(f + \epsilon - f)^2] = E[\epsilon^2] = Var[\epsilon] + E[\epsilon]^2 = \sigma^2$$由于 $\epsilon$ 和 $\hat f$ 互相独立$$\begin{align}E[(y - \hat f)^2] & = E[y^2 + \hat f^2 - 2y\hat f] \\ & = E[y^2] + E[\hat f^2] - E[2y\hat f] \\& = Var[y] + E[y]^2 + Var[\hat f] + E[\hat f]^2 - 2fE[\hat f] \\& = Var[y] + Var[\hat f] + (f^2 - 2fE[\hat f] + E[\hat f]^2) \\& = Var[y] + Var[\hat f] + (f - E[\hat f])^2 \\& = \sigma^2 + Var[\hat f] + Bias[\hat f]^2\end{align}$$</p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>感觉在实际使用中，你不需要去自己写代码来画这些曲线，只要是框架是一定整合了这些值得结果，但是知其然知其所以然，越了解它是如何画的，越能<strong>处理奇怪的特殊情况</strong></p><p>常见的处理方式是记下来所有指标的结果，即这些指标怎么变，表示了模型的那些方面好或者坏的结论，但是如果在特殊的问题出现了不在你看的结果中的情况可能还是会捉襟见肘，还是脚踏实地，能看见更大的世界！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】16 - 26 min&lt;br&gt;【内容简介】系统详解分类器性能指标，什么是&lt;code&gt;准确率 - Accuracy&lt;/code&gt;、&lt;code&gt;精确率 - Precision&lt;/code&gt;、&lt;code&gt;召回率 - Recall&lt;/code&gt;、&lt;code&gt;F1值&lt;/code&gt;、&lt;code&gt;ROC曲线&lt;/code&gt;、&lt;code&gt;AUC曲线&lt;/code&gt;、&lt;code&gt;误差 - Error&lt;/code&gt;、&lt;code&gt;偏差 - Bias&lt;/code&gt;、&lt;code&gt;方差 - Variance&lt;/code&gt;及&lt;code&gt;Bias-Variance Tradeoff&lt;/code&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】信息熵、交叉熵和相对熵</title>
    <link href="https://charlesliuyx.github.io/2017/09/11/%E4%BB%80%E4%B9%88%E6%98%AF%E4%BF%A1%E6%81%AF%E7%86%B5%E3%80%81%E4%BA%A4%E5%8F%89%E7%86%B5%E5%92%8C%E7%9B%B8%E5%AF%B9%E7%86%B5/"/>
    <id>https://charlesliuyx.github.io/2017/09/11/什么是信息熵、交叉熵和相对熵/</id>
    <published>2017-09-10T16:25:49.000Z</published>
    <updated>2021-06-29T07:46:51.069Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】10min - 13min<br>【内容简介】使用一个现实中直观的例子详解<strong>信息熵、交叉熵及相对熵</strong>的核心概念，读完后，希望能帮助你建立起这三个概念的固有直觉，不再疑惑</p><p>要完成题目的最终解释，必须从<strong>熵</strong>这个神奇的概念开始讲起</p><a id="more"></a><h1 id="什么是熵-Entropy"><a href="#什么是熵-Entropy" class="headerlink" title="什么是熵 - Entropy"></a>什么是熵 - Entropy</h1><h2 id="词源-最初来源于热力学"><a href="#词源-最初来源于热力学" class="headerlink" title="词源 - 最初来源于热力学"></a>词源 - 最初来源于热力学</h2><p>Entropy来源于希腊语，原意：内向，即：一个系统不受外部干扰时<strong>往内部稳定状态发展</strong>的特性。定义的其实是一个热力学的系统<strong>变化的趋势</strong></p><p>$$<br>\Delta S = \frac{Q}{T} = \frac{热量}{温度} \tag{1-1}<br>$$<br>1923年，德国科学家普朗克来中国讲学用到<code>entropy</code>这个词，胡刚复教授看到这个公式，<strong>创造了“熵”字</strong>，因为“火”和热量有关，定义式又是热量比温度，相当自洽</p><h2 id="信息论"><a href="#信息论" class="headerlink" title="信息论"></a>信息论</h2><p>信息论中，熵是接受的每条消息中<strong>包含的信息的平均值</strong>。又被称为信息熵、信源熵、平均自信息量。可以被理解为<strong>不确定性的度量</strong>，熵越大，信源的分布越随机</p><p>1948年，由克劳德·爱尔伍德·香农将热力学中的熵引入信息论，所以也叫做：香农熵</p><h2 id="生态学"><a href="#生态学" class="headerlink" title="生态学"></a>生态学</h2><p>在生态学中，熵表示<strong>生物多样性的指标</strong></p><h2 id="广义的定义"><a href="#广义的定义" class="headerlink" title="广义的定义"></a>广义的定义</h2><p>熵是描述一个系统的<strong>无序程度</strong>的变量；同样的表述还有，熵是系统混乱度的度量，一切自发的不可逆过程都是从<strong>有序</strong>到<strong>无序</strong>的变化过程，向熵增的方向进行</p><p>我们接下来要讨论的<code>信息熵</code> <code>交叉熵</code> <code>相对熵</code> 更多的着眼于信息论的角度，换句话说，更加关注概率和不确定性</p><h1 id="什么是信息熵、交叉熵、相对熵"><a href="#什么是信息熵、交叉熵、相对熵" class="headerlink" title="什么是信息熵、交叉熵、相对熵"></a>什么是信息熵、交叉熵、相对熵</h1><p>可以将对熵的理解从简单到复杂依次分解成三个层次来理解</p><h2 id="如何衡量不确定事物的发生？"><a href="#如何衡量不确定事物的发生？" class="headerlink" title="如何衡量不确定事物的发生？"></a>如何衡量不确定事物的发生？</h2><p>数学是一种工具，使用数学来描述现实中的各种事物是一个数学家本质的工作目标。而现实中不确定性，或者说不太确定是否会发生的事件必须要找到一种<strong>抽象的</strong>、<strong>符号化</strong>和<strong>公式化</strong>的手段去表示。</p><p>比如天气情况，假设可能有【阴、晴、雨、雪】四种情况，使用概率符号表示 $\mathbf P = [p_1,p_2,p_3,p_4]$，接下来自然而然的思考：那么，什么<strong>条件</strong>（情况）会影响这些值呢？</p><p>假设有一下三种描述，或者说条件</p><ul><li>今天是晴天，所以明天可能也是晴天</li><li>天气预报说明天下雨</li><li>9月12日苹果公司举行发布会</li></ul><p>那么这三个描述中，很明显，第二条的信息量更大，因为它可以使得不确定事件发生在 $p_3$ 的<strong>概率更大</strong>。类似的，第三条对判断毫无帮助，信息量为0。<em>注意，信息量不等于信息熵，如果是这样，那么直接用概率来衡量就可以了，不需要在重新定义一个概念</em></p><p><strong>其实信息熵是信息量的期望（均值），它不是针对每条信息，而是针对整个不确定性结果集而言，信息熵越大，事件不确定性就越大。单条信息只能从某种程度上影响结果集概率的分布</strong></p><h2 id="考虑到信息冗余，信息量存储下来究竟需要多大空间？"><a href="#考虑到信息冗余，信息量存储下来究竟需要多大空间？" class="headerlink" title="考虑到信息冗余，信息量存储下来究竟需要多大空间？"></a>考虑到信息冗余，信息量存储下来究竟需要<u>多大空间</u>？</h2><p>我们已经有了 $\mathbf P = [p_1,p_2,p_3,p_4]$ 来表示天气情况，那么用计算机来存储每天的天气，那该如何编码呢？</p><p>常见的做法是，4个不同的信息，只需要2bit就能做到，<code>00</code> <code>01</code> <code>11</code> <code>10</code>，假设我们在南方城市，肯定要把<code>00</code>编码成雨天，这样可以<strong>节省存储空间</strong>，至于为什么能节省存储空间，这就要讨论编码方式。可以简单的理解为，如果一串信息一串<code>0</code>很多，可以<strong>通过编码压缩这一群0来节省空间</strong></p><p>使用一个公式来计算记录<strong>n天数据</strong>需要的<strong>存储空间</strong>：Sn</p>$$S_n = n \times \sum_{i = 1}^4{\left(P_i \times F(P_i) \right) } \tag{2-1}$$<blockquote><p>$P_i$ 表示第i个事件发生的概率；$F(P_i)$ 表示存储空间的存储因子</p></blockquote><p>如何确定这个函数 $F(P_i)$ 的形式？考虑这个函数需要满足条件：<strong>概率大的事件对应小的存储空间，说人话，就是成反比</strong>，你的数学功底不错的话，脑海中第一反应出来满足这个条件最直观是<strong>反比例函数</strong>，说人话， $\frac{1}{P_i}$ 。</p><p>之后我们发现这个公式中有个除法非常讨厌，我们想着去掉它，脑海中第一反应出来的满足这个条件的一定是<strong>取对数</strong>，至于为什么取对数，那说道就很多，取对数是指数的<strong>逆操作</strong>，</p><ul><li>对数操作可以让原本不符合正态分布的模型符合正态分布，比如随着模型自变量的增加，因变量的方差也增大的模型取对数后会更加稳定</li><li>取对数操作可以rescale（原谅我，这里思前想后还是感觉一个英文单词更加生动）其实本质来说都是因为第一点。说人话版本，人不喜欢乘法，对数可以把乘法变加法</li></ul><p>那么我们结束清楚之后，就很容易就可以定义出<br>$$<br>F(P_i) = \log_a ({\frac{1}{P_i}}) \tag{2-2}<br>$$<br> a作为底数，可以取2（处理2bit数据），10（万金油），e（处理正态分布相关的数据）</p><p>结合对信息熵的定义（第一节最后的粗体字）然后把（2-2）带入（2-1），就会发现，哦！看着有点眼熟啊<br>$$<br>H(P) = \sum_i {P(i)log_a {\frac{1}{P(i)}}} = - \sum_i {P(i)log_a {P(i)}} \tag{2-3}<br>$$<br>这这这，就是信息熵的定义式吧？总结就发现，信息熵其实从某种意义上反映了<strong>信息量存储下来需要多少存储空间</strong></p><p>总结为：根据<strong>真实分布</strong>，我们能够找到一个最优策略，以<strong>最小的代价消除系统的不确定性（</strong>比如编码），而<strong>这个代价的大小就是信息熵</strong></p><h2 id="理解基于信息熵的交叉熵和相对熵"><a href="#理解基于信息熵的交叉熵和相对熵" class="headerlink" title="理解基于信息熵的交叉熵和相对熵"></a>理解基于信息熵的交叉熵和相对熵</h2><p>因为是我们用2bit模式存储，为了计算方便，这里取a = 2</p><p>先计算刚刚有关天气问题 $\mathbf P = [p_1,p_2,p_3,p_4]$ ：【阴、晴、雨、雪】的信息熵，假设我们对天气的概率一无所知，那么四种天气的发生概率为<strong>等概率（服从平均分布）</strong>，即 $\mathbf P = [\frac {1}{4},\frac {1}{4},\frac {1}{4},\frac {1}{4}]$ ，带入公式2-3，得到 $H(P) = 2$ ，存储信息需要的空间 $S_n = 2n$ </p><p>继续思考，假设我们考虑天气的城市是一个地处中国南方雨季的城市，那么阴天和雨天的概率从<strong>经验角度（先验概率）</strong>来看大于晴天雪天，把这种分布<strong>记为</strong> $\mathbf Q = [\frac{1}{4},\frac{1}{8},\frac{1}{2},\frac{1}{8}]$，带入公式2-3，信息熵 $H(Q) = 1.75$，存储信息需要的空间 $S_n = 1.75n$ </p><p>直观的来考虑上面不同的两种情况，明显当<strong>事件的不确定性变小</strong>时候，我们可以改变存储策略（00 雨天 01 阴天），再通过编码，节省存储空间。信息熵的大小<strong>就是用来度量这个不确定大小的</strong></p><p>关于编码的方式，这里提一下，<a href="https://zhuanlan.zhihu.com/p/25181781" target="_blank" rel="noopener">哈夫曼树与哈夫曼编码</a> ，有兴趣的读者可以去研究一下</p><h3 id="交叉熵的由来"><a href="#交叉熵的由来" class="headerlink" title="交叉熵的由来"></a>交叉熵的由来</h3><p>我们把这个问题再扩展一下</p><table><thead><tr><th style="text-align:center">天气【阴、晴、雨、雪】</th><th style="text-align:center">信息熵</th></tr></thead><tbody><tr><td style="text-align:center">$\mathbf P = [\frac{1}{4},\frac{1}{4},\frac{1}{4},\frac{1}{4}]$</td><td style="text-align:center">$H(P) = 2$</td></tr><tr><td style="text-align:center">$\mathbf Q = [\frac{1}{4},\frac{1}{8},\frac{1}{2},\frac{1}{8}]$</td><td style="text-align:center">$H(Q) = 1.75$</td></tr><tr><td style="text-align:center">$\mathbf Z = [\frac{1}{8},\frac{1}{16},\frac{3}{4},\frac{1}{16}]$</td><td style="text-align:center">$H(Z) = \frac{7}{8}+\frac{3}{4}\log_2 {\frac{4}{3}} = 1.186$</td></tr><tr><td style="text-align:center">$\mathbf W = [0,0,1,0]$</td><td style="text-align:center">$H(W) = 0$</td></tr></tbody></table><p>接下来，假定在<strong>确定性更大的概率分布</strong>情况下，用<strong>更不确定的存储策略</strong>来计算，比如使用 $\mathbf P$ 的概率乘上 $\mathbf Q$ 的存储因子，套用公式2-3<br>$$<br>H(\mathbf P,\mathbf Q) = \sum_i {P(i) \log_a {\frac{1}{Q(i)}}} \tag{3-1}<br>$$<br>顾名思义，看公式3-1的形式，就不难发现，这就是所谓的<strong>交叉熵</strong>，计算可得</p><table><thead><tr><th style="text-align:center">交叉熵</th><th style="text-align:center">P</th><th style="text-align:center">Q</th><th style="text-align:center">Z</th><th style="text-align:center">W</th></tr></thead><tbody><tr><td style="text-align:center">P</td><td style="text-align:center">$H(P,P)  = 2$</td><td style="text-align:center">$H(P,Q) = 2.25$</td><td style="text-align:center">$H(P,Z) = \frac{11}{4}+\frac{1}{4}\log_2 {\frac{4}{3}} = 2.85$</td><td style="text-align:center">$+\infty$</td></tr><tr><td style="text-align:center">Q</td><td style="text-align:center">$H(Q,P) =  2$</td><td style="text-align:center">$H(Q,Q) = 1.75$</td><td style="text-align:center">$H(Q,Z) = \frac{7}{4}+\frac{1}{2}\log_2 {\frac{4}{3}} = 1.96$</td><td style="text-align:center">$+\infty$</td></tr><tr><td style="text-align:center">Z</td><td style="text-align:center">$H(Z,P) = 2$</td><td style="text-align:center">$H(Z,Q) = 1.375$</td><td style="text-align:center">$H(Z,Z)  = \frac{7}{8}+\frac{3}{4}\log_2 {\frac{4}{3}} = 1.186$</td><td style="text-align:center">$+\infty$</td></tr><tr><td style="text-align:center">W</td><td style="text-align:center">$H(W,P) = 2$</td><td style="text-align:center">$H(W,Q) = 1$</td><td style="text-align:center">$H(W,Z) = \log_2 {\frac{4}{3}} = 0.415$</td><td style="text-align:center">$H(W,W)  = 0$</td></tr></tbody></table><p>上表直观的展现的<strong>交叉熵</strong>的数值表现，PQZW依次<strong>不确定性越来越低</strong>，极端情况的W不确定性为0，即<strong>是确定的</strong></p><p><strong>交叉熵，用来高衡量在给定的真实分布下，使用非真实分布指定的策略消除系统的不确定性所需要付出努力的大小</strong></p><p>总的来说，<strong>我们的目的是：让熵尽可能小，即存储空间小（消除系统的不确定的努力小）。</strong>（不要问为什么想要存储空间小，这都是钱更是效率和时间）</p><p>通过上表我们发现一个规律，为了让熵小，解决方案是：<strong>是用确定性更大的概率乘以确定性更小的存储因子</strong>，比如不确定性越大的概率分布，如P概率分布，其信息熵越大；<strong>基于同一真实（确定性）分布的情况下</strong>，套用不确定性更大的存储因子，如P的存储因子，得出的交叉熵越大</p><p>在机器学习中，即用测试结果集（样本结果集）的概率乘以训练出来的结果集存储因子，而在不断的训练过程中，我们要做的就是通过不断调整参数，降低这个值，<strong>使得模型更加的稳定，不确定性越来越小</strong>，即突出需要表征的数值的特点（白话文也就是分类的效果更好）</p><h3 id="相对熵的由来"><a href="#相对熵的由来" class="headerlink" title="相对熵的由来"></a>相对熵的由来</h3><p>有了信息熵和交叉熵后，<strong>相对熵是用来衡量两个概率分布之间的差异</strong>，记为 $D(P||Q) = H(P,Q) - H(P)$，也称之为KL散度<br>$$<br>D_{KL}(P||Q) = \sum_i{P(i) \log_a {\frac{P(i)}{Q(i)}}}<br>$$<br>当 $P(i) = Q(i)$ 的时候，该值为0，深度学习过程也是一个降低该值的过程，<strong>该值越低，训练出来的概率Q越接近样本集概率P，即越准确</strong>，或者可以理解为<strong>相对熵一把标尺，用来衡量两个函数是否相似，一样就是0</strong>，当然，这种解释十分牵强，但是更直观</p><blockquote><p>关于底数 $a$ 的选择问题，其实和概率分布的情况是分不开的。比如使用2进制编码，那么所能表示的不同情况的数量，$\sum_{i=0}^N 2^i$，我们知道，指数函数变化率变化很大，不好分析，稳定性差。对数操作可以<strong>乘法变加法，指数放下来</strong>，是十分好用的数学工具（其实是一种变换域的思想，这种思想在整个信息论，统计学中处处可见）</p><p>比如使用 $ln()$ 的时候，对应的分布，其实是<strong>正态分布</strong>，很好理解，正太分布的底数是 $e$</p></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】10min - 13min&lt;br&gt;【内容简介】使用一个现实中直观的例子详解&lt;strong&gt;信息熵、交叉熵及相对熵&lt;/strong&gt;的核心概念，读完后，希望能帮助你建立起这三个概念的固有直觉，不再疑惑&lt;/p&gt;
&lt;p&gt;要完成题目的最终解释，必须从&lt;strong&gt;熵&lt;/strong&gt;这个神奇的概念开始讲起&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>Dota2机制总结</title>
    <link href="https://charlesliuyx.github.io/2017/09/05/Dota2%E6%9C%BA%E5%88%B6%E6%80%BB%E7%BB%93/"/>
    <id>https://charlesliuyx.github.io/2017/09/05/Dota2机制总结/</id>
    <published>2017-09-05T15:50:56.000Z</published>
    <updated>2018-03-15T18:27:55.257Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】百科类型文章<br>【内容简介】这是一份有关Dota2游戏机制的总结，核心目的是为了方便查阅，<strong>计算公式</strong>。针对人群是对数据和游戏机制有很大兴趣的高玩，从中你可能能了解<strong>如何通过击杀或得更多的经济</strong>，<strong>哪些操作可以躲避技能</strong>等等</p><p>版本信息：更新到7.09</p><a id="more"></a><h1 id="金钱"><a href="#金钱" class="headerlink" title="金钱"></a>金钱</h1><h2 id="击杀英雄奖励"><a href="#击杀英雄奖励" class="headerlink" title="击杀英雄奖励"></a>击杀英雄奖励</h2><p>获得金钱 = 110 + 连杀奖励 + （被击杀者等级 * 8）</p><p>连杀奖励 = 60 * （连杀数-2）[大于0]</p><h2 id="助攻奖励"><a href="#助攻奖励" class="headerlink" title="助攻奖励"></a>助攻奖励</h2><table><thead><tr><th style="text-align:center">助攻英雄数</th><th>获得金钱</th></tr></thead><tbody><tr><td style="text-align:center">1</td><td>财产总和<strong>贫穷</strong>系数 × 财产总和<strong>排名</strong>系数 × ( 126 + 4.5 × 阵亡英雄等级 + 财产总和<strong>前期</strong>系数 × 90 + 财产总和系数 × 0.03375 )</td></tr><tr><td style="text-align:center">2</td><td>财产总和<strong>贫穷</strong>系数 × 财产总和<strong>排名</strong>系数 × ( 63 + 3.6 × 阵亡英雄等级 + 财产总和<strong>前期</strong>系数 × 67.5 + 财产总和系数 × 0.03375 )</td></tr><tr><td style="text-align:center">3</td><td>财产总和<strong>贫穷</strong>系数 × 财产总和<strong>排名</strong>系数 × ( 31.5 + 2.7 × 阵亡英雄等级 + 财产总和<strong>前期</strong>系数 × 45 + 财产总和系数 * 0.03375 )</td></tr><tr><td style="text-align:center">4</td><td>财产总和<strong>贫穷</strong>系数 × 财产总和<strong>排名</strong>系数 × ( 22.5 + 1.8 × 阵亡英雄等级 + 财产总和<strong>前期</strong>系数 × 31.5 + 财产总和系数 × 0.027 )</td></tr><tr><td style="text-align:center">5</td><td>财产总和<strong>贫穷</strong>系数 × 财产总和<strong>排名</strong>系数 × ( 18 + 0.9 × 阵亡英雄等级 + 财产总和<strong>前期</strong>系数 × 22.5 + 财产总和系数 × 0.02025 )</td></tr></tbody></table><ul><li>7.11更新：<ul><li>【新】（阵亡英雄财产综合 × 0.026  + 70） / 击杀涉及英雄的数量</li><li>【旧】财产总和前期系数 × {} + 财产总和系数 × {}</li></ul></li></ul><p>财产总和差异 = （ 敌方总经济/己方总经济 ） - 1 【最大值1，最小值0】</p><p>【财产总和系数】 =  财产总和差异 * 阵亡英雄财产总和</p><p>【财产总和<strong>前期</strong>系数】 = （敌方总经济 - 己方总经济）/4000 【最大值为1】</p><p>【财产总和<strong>贫穷</strong>系数】 = 1.3 - 0.1 * 财产总和排名（阵亡英雄经济在队伍中的排名）</p><p>【财产总和<strong>排名</strong>系数】 1/2/3/4/5个英雄中，最富的到最穷的分别为{1} / {0.7; 1.3} / {0.7; 1; 1.3} / {0.7; 0.7; 1.3; 1.3} / {0.7; 0.7; 1; 1.3; 1.3}</p><h2 id="Roshan"><a href="#Roshan" class="headerlink" title="Roshan"></a>Roshan</h2><p>200 团队奖励</p><p>150 - 400 击杀奖励</p><h2 id="死亡掉钱"><a href="#死亡掉钱" class="headerlink" title="死亡掉钱"></a>死亡掉钱</h2><p>损失不可靠金钱 = 50 + 财产总和 ÷ 40</p><p><code>5千经济 ➜ 175</code> <code>1万经济 ➜ 290</code> <code>2万经济 ➜ 550</code> </p><h1 id="复活"><a href="#复活" class="headerlink" title="复活"></a>复活</h1><h2 id="复活时间"><a href="#复活时间" class="headerlink" title="复活时间"></a>复活时间</h2><ul><li>每级增加2秒</li><li>每到6级的倍数增加10秒</li><li>18级后每级增加4秒</li></ul><h2 id="买活花费"><a href="#买活花费" class="headerlink" title="买活花费"></a>买活花费</h2><p>买活金钱 = 100 + (英雄等级 <em> 英雄等级 </em> 1.5) + (游戏时间(s) * 0.25 )</p><h2 id="放弃比赛"><a href="#放弃比赛" class="headerlink" title="放弃比赛"></a>放弃比赛</h2><p>掉线<strong>超过5分钟后</strong>，所有金钱被队友平分</p><h1 id="物理攻击伤害"><a href="#物理攻击伤害" class="headerlink" title="物理攻击伤害"></a>物理攻击伤害</h1><h2 id="最终攻击伤害"><a href="#最终攻击伤害" class="headerlink" title="最终攻击伤害"></a>最终攻击伤害</h2>$$最终攻击伤害 = \\ \{ [\text {MD} × (1 + \sum \text {PBD}) + \text {FBD}] \times \text {CSM} - \text {BD} \}\\ \times \text {AVM} \times \text {ATM} \times \text {GDM}$$<p><a href="https://dota2.gamepedia.com/Attack_damage" target="_blank" rel="noopener">wiki链接</a></p><h3 id="MD-Main-Damage-主要攻击力【白字攻击力】"><a href="#MD-Main-Damage-主要攻击力【白字攻击力】" class="headerlink" title="MD(Main Damage) 主要攻击力【白字攻击力】"></a>MD(Main Damage) 主要攻击力【白字攻击力】</h3><p>主要攻击力 = 基础攻击力 + 主属性</p><p>除此之外，所有加成的攻击力都是【绿字攻击力】</p><h3 id="PBD-Percentage-bonus-damage-百分比攻击力加成"><a href="#PBD-Percentage-bonus-damage-百分比攻击力加成" class="headerlink" title="PBD(Percentage bonus damage) 百分比攻击力加成"></a>PBD(Percentage bonus damage) 百分比攻击力加成</h3><p>这个加成是<strong>加法叠加</strong></p><p>Tips: 圣者遗物可以增加60攻击力，一个出支配带头狼的VS，36%+30% = 66%，60 / 0.66 = 90，也就是说，白字攻击力达到90就等于这个英雄出了一个圣者遗物，相当的可怕。</p><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">加成数值</th></tr></thead><tbody><tr><td style="text-align:center">头狼光环</td><td style="text-align:center">30%</td></tr><tr><td style="text-align:center">强化图腾</td><td style="text-align:center">100%/200%/300%/400%</td></tr><tr><td style="text-align:center">野性驱使</td><td style="text-align:center">15%/26%/37%/48%（只影响狼人控制的单位）</td></tr><tr><td style="text-align:center">授予力量</td><td style="text-align:center">20%/30%/40%/50% (天赋 30%/40%/50%/60%)</td></tr><tr><td style="text-align:center">神之力量</td><td style="text-align:center">80%/120%/160% (友军A帐: 75%/100%/125%)</td></tr><tr><td style="text-align:center">复仇光环</td><td style="text-align:center">12%/20%/28%/36% (天赋 32%/40%/48%/56%)</td></tr><tr><td style="text-align:center">祭品光环</td><td style="text-align:center">15%</td></tr></tbody></table><h3 id="FBD-Flat-Bonus-Damage-固定值百分比加成"><a href="#FBD-Flat-Bonus-Damage-固定值百分比加成" class="headerlink" title="FBD(Flat Bonus Damage) 固定值百分比加成"></a>FBD(Flat Bonus Damage) 固定值百分比加成</h3><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">加成数值</th><th style="text-align:center">其他数值</th></tr></thead><tbody><tr><td style="text-align:center">臂章-邪恶之力</td><td style="text-align:center">31</td><td style="text-align:center"></td></tr><tr><td style="text-align:center">嗜血渴望</td><td style="text-align:center"><strong>最高</strong>攻击力加成/英雄: 16/24/32/40</td><td style="text-align:center">按照敌方英雄<strong>生命值百分比</strong>线性变化</td></tr><tr><td style="text-align:center">战意</td><td style="text-align:center">最高叠加层数: 5/7/9 每层攻击力加成: 18/24/30</td><td style="text-align:center">持续时间：14s</td></tr><tr><td style="text-align:center">极度饥渴</td><td style="text-align:center">60/100/140</td><td style="text-align:center">持续时间：14s</td></tr><tr><td style="text-align:center">死亡契约</td><td style="text-align:center">基于目标最大生命值的攻击力加成: 5%/7%/9%</td><td style="text-align:center">持续时间：65s</td></tr><tr><td style="text-align:center">精准光环</td><td style="text-align:center">敏捷  20%/26%/32%/38% (天赋26%/32%/38%/44%)</td><td style="text-align:center">范围：全地图</td></tr><tr><td style="text-align:center">星体游魂</td><td style="text-align:center">小兵6/9/12/15 英雄 12/24/36/48 (天赋92/104/116/128)</td><td style="text-align:center">持续时间：9s</td></tr><tr><td style="text-align:center">灵动迅捷</td><td style="text-align:center">10/25/40/55/70/85/100 A帐115</td><td style="text-align:center">持续时间：9s</td></tr><tr><td style="text-align:center">卡尔-火</td><td style="text-align:center">4/8/12/16/20/24/28 * 3</td><td style="text-align:center"></td></tr><tr><td style="text-align:center">决斗</td><td style="text-align:center">10/14/18 (天赋50/54/58)</td><td style="text-align:center">永久存在buff</td></tr><tr><td style="text-align:center">战斗嚎叫</td><td style="text-align:center">70/100/130</td><td style="text-align:center">持续时间：6s</td></tr><tr><td style="text-align:center">月之祝福</td><td style="text-align:center">14/22/30/38</td><td style="text-align:center">光环范围：900</td></tr><tr><td style="text-align:center">狼人 - 嚎叫</td><td style="text-align:center">英雄 10/15/20/25 非英雄  4/6/8/10 夜晚翻倍</td><td style="text-align:center">持续时间：13s</td></tr><tr><td style="text-align:center">静电连接</td><td style="text-align:center">每秒偷取 7/14/21/28 (天赋21/28/35/42)</td><td style="text-align:center">链接时间：8s 持续时间：18s</td></tr><tr><td style="text-align:center">支配死灵</td><td style="text-align:center">最大灵魂数: 18/24/30/36 (A帐 22/30/38/46)</td><td style="text-align:center">每个灵魂攻击力：2（天赋4）</td></tr><tr><td style="text-align:center">折光</td><td style="text-align:center"><strong>攻击次数</strong>: 3/4/5/6 (天赋6/7/8/9)<strong>攻击力加成</strong>: 20/40/60/80</td><td style="text-align:center">持续时间：17s</td></tr><tr><td style="text-align:center">魔化</td><td style="text-align:center">20/40/60/80</td><td style="text-align:center">持续时间：40/44/48/52s</td></tr><tr><td style="text-align:center">长大</td><td style="text-align:center">30/45/60 加主要攻击力</td><td style="text-align:center"></td></tr><tr><td style="text-align:center">衰退光环</td><td style="text-align:center">英雄死亡 30/35/40/45 小兵死亡 5</td><td style="text-align:center">持续时间：30/40/50/60s</td></tr></tbody></table><h3 id="CSM-Critical-Strike-Multiplier-致命一击倍数"><a href="#CSM-Critical-Strike-Multiplier-致命一击倍数" class="headerlink" title="CSM(Critical Strike Multiplier) 致命一击倍数"></a>CSM(Critical Strike Multiplier) 致命一击倍数</h3><table><thead><tr><th style="text-align:center">致命一击来源</th><th style="text-align:center">几率%</th><th style="text-align:center">伤害%</th><th style="text-align:center">DPS期望%</th></tr></thead><tbody><tr><td style="text-align:center">头狼 - 致命一击</td><td style="text-align:center">20</td><td style="text-align:center">200</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">血棘 - 致命一击</td><td style="text-align:center">20</td><td style="text-align:center">175</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">酒仙 - 醉拳</td><td style="text-align:center">10/15/20/25</td><td style="text-align:center">230</td><td style="text-align:center">13/19.5/26/32.5</td></tr><tr><td style="text-align:center">混沌一击</td><td style="text-align:center">12</td><td style="text-align:center">125/175/225/275</td><td style="text-align:center">3/9/15/21</td></tr><tr><td style="text-align:center">水晶剑 - 致命一击</td><td style="text-align:center">20</td><td style="text-align:center">175</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">大炮 - 致命一击</td><td style="text-align:center">30</td><td style="text-align:center">235</td><td style="text-align:center">40.5</td></tr><tr><td style="text-align:center">剑舞</td><td style="text-align:center">20/25/30/35</td><td style="text-align:center">200%</td><td style="text-align:center">20/25/30/35</td></tr><tr><td style="text-align:center">狼人 - 变身</td><td style="text-align:center">40</td><td style="text-align:center">160/180/200</td><td style="text-align:center">24/32/40</td></tr><tr><td style="text-align:center">恩赐解脱</td><td style="text-align:center">15</td><td style="text-align:center">230/340/450</td><td style="text-align:center">19.5/36/52.5</td></tr><tr><td style="text-align:center">殊死一搏</td><td style="text-align:center">15</td><td style="text-align:center">英雄 150/200/250/300</td><td style="text-align:center">7.5/15/22.5/30</td></tr><tr><td style="text-align:center">血棘 - 灵魂撕裂</td><td style="text-align:center">100</td><td style="text-align:center">140</td><td style="text-align:center">140</td></tr><tr><td style="text-align:center">忍术</td><td style="text-align:center">100</td><td style="text-align:center">150/175/200/225</td><td style="text-align:center">12/10/8/6 天赋 -5</td></tr><tr><td style="text-align:center">棒击大地</td><td style="text-align:center">100</td><td style="text-align:center">150/175/200/225 天赋+100</td><td style="text-align:center">触发条件</td></tr><tr><td style="text-align:center">暗杀</td><td style="text-align:center">100</td><td style="text-align:center">A帐 280</td><td style="text-align:center">距离内所有敌人</td></tr><tr><td style="text-align:center">海象神拳</td><td style="text-align:center">100</td><td style="text-align:center">350/A帐500</td><td style="text-align:center">冷却 36/24/12</td></tr></tbody></table><p>游戏中出现的<strong>红字代表的是减少前的物理伤害</strong></p><h3 id="BD-Blocked-Damage-被格挡伤害"><a href="#BD-Blocked-Damage-被格挡伤害" class="headerlink" title="BD(Blocked Damage) 被格挡伤害"></a>BD(Blocked Damage) 被格挡伤害</h3><table><thead><tr><th style="text-align:center">伤害格挡来源</th><th style="text-align:center">几率%</th><th style="text-align:center">格挡伤害</th></tr></thead><tbody><tr><td style="text-align:center">圆盾</td><td style="text-align:center">50</td><td style="text-align:center">近战16 远程8</td></tr><tr><td style="text-align:center">穷鬼盾</td><td style="text-align:center">英雄100 非英雄50</td><td style="text-align:center">近战20 远程10</td></tr><tr><td style="text-align:center">先锋盾</td><td style="text-align:center">50</td><td style="text-align:center">近战70 远程35</td></tr><tr><td style="text-align:center">赤红甲 - 坚盾</td><td style="text-align:center">100</td><td style="text-align:center">60</td></tr><tr><td style="text-align:center">海妖外壳</td><td style="text-align:center">100</td><td style="text-align:center">12/24/36/48</td></tr></tbody></table><p>伤害格挡不格挡物理伤害技能，守卫的攻击也不格挡</p><h3 id="AVM-Armor-Value-Multiplier-护甲值倍数"><a href="#AVM-Armor-Value-Multiplier-护甲值倍数" class="headerlink" title="AVM(Armor Value Multiplier) 护甲值倍数"></a>AVM(Armor Value Multiplier) 护甲值倍数</h3><p>见<a href="#Armor"><strong>护甲</strong></a></p><h3 id="ATM-Armor-Type-Multiplier-护甲类型倍数"><a href="#ATM-Armor-Type-Multiplier-护甲类型倍数" class="headerlink" title="ATM(Armor Type Multiplier) 护甲类型倍数"></a>ATM(Armor Type Multiplier) 护甲类型倍数</h3><p>见<a href="#AT"><strong>攻击类型</strong></a>，英雄打英雄100%</p><h3 id="GDM-General-Damage-Multipliers-一般伤害倍数"><a href="#GDM-General-Damage-Multipliers-一般伤害倍数" class="headerlink" title="GDM(General Damage Multipliers) 一般伤害倍数"></a>GDM(General Damage Multipliers) 一般伤害倍数</h3><p>见<a href="#DM"><strong>伤害调整</strong></a><br><a name="AT"></a></p><h2 id="攻击类型"><a href="#攻击类型" class="headerlink" title="攻击类型"></a>攻击类型</h2><p>基础打英雄护甲75%伤害</p><p>穿刺打英雄护甲50%伤害，基础护甲（小兵护甲）150%伤害<br><a name="DM"></a></p><h2 id="伤害调整"><a href="#伤害调整" class="headerlink" title="伤害调整"></a>伤害调整</h2><h3 id="伤害减免和加深"><a href="#伤害减免和加深" class="headerlink" title="伤害减免和加深"></a>伤害减免和加深</h3><p>除了<strong>回光返照，幽灵船，魔法护盾</strong>之外，伤害减免和加深的叠加为<strong>加法叠加</strong></p><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">来源</th><th style="text-align:center">数值%</th></tr></thead><tbody><tr><td style="text-align:center">血之狂暴</td><td style="text-align:center">加深接受输出</td><td style="text-align:center">25/30/35/40 远处 减半</td></tr><tr><td style="text-align:center">赎罪</td><td style="text-align:center">加深接受</td><td style="text-align:center">18/24/30/36</td></tr><tr><td style="text-align:center">灵魂猎手</td><td style="text-align:center">加深接受</td><td style="text-align:center">20/30/40/50</td></tr><tr><td style="text-align:center">守卫冲刺</td><td style="text-align:center">加深接受</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">血肉傀儡</td><td style="text-align:center">加深接受</td><td style="text-align:center">20/25/30 200范围内最高</td></tr><tr><td style="text-align:center">回光返照</td><td style="text-align:center">减免接受</td><td style="text-align:center">0 全免 4/5/6 A帐+1</td></tr><tr><td style="text-align:center">刚毛后背</td><td style="text-align:center">减免接受</td><td style="text-align:center">背后 16/24/32/40 侧面 减半</td></tr><tr><td style="text-align:center">奔袭冲撞</td><td style="text-align:center">减免接受</td><td style="text-align:center">A帐 40 持续4秒</td></tr><tr><td style="text-align:center">过载</td><td style="text-align:center">减免接受</td><td style="text-align:center">5/10/15/20</td></tr><tr><td style="text-align:center">幽灵船</td><td style="text-align:center">减免接受</td><td style="text-align:center">40/45/50 持续10秒</td></tr><tr><td style="text-align:center">决斗</td><td style="text-align:center">减免接受</td><td style="text-align:center">A帐 100 持续6/7/8秒</td></tr><tr><td style="text-align:center">魔法护盾</td><td style="text-align:center">减免接受</td><td style="text-align:center">60 1.6/1.9/2.2/2.5</td></tr><tr><td style="text-align:center">钻地</td><td style="text-align:center">减免接受</td><td style="text-align:center">40</td></tr><tr><td style="text-align:center">折射</td><td style="text-align:center">减免接受</td><td style="text-align:center">10/14/18/22</td></tr><tr><td style="text-align:center">激怒</td><td style="text-align:center">减免接受</td><td style="text-align:center">80 持续4秒</td></tr><tr><td style="text-align:center">陵卫斗篷</td><td style="text-align:center">减免接受</td><td style="text-align:center">4层 8/12/16/20 冷却6/5/4/3</td></tr><tr><td style="text-align:center">寒冬诅咒</td><td style="text-align:center">减免接受</td><td style="text-align:center">100 3.25/4/4.75</td></tr><tr><td style="text-align:center">战斗饥渴</td><td style="text-align:center">降低输出</td><td style="text-align:center">A帐 30 持续10秒</td></tr><tr><td style="text-align:center">白银之锋</td><td style="text-align:center">降低输出</td><td style="text-align:center">50 持续5秒</td></tr></tbody></table><h3 id="伤害无效化"><a href="#伤害无效化" class="headerlink" title="伤害无效化"></a>伤害无效化</h3><p>伤害实例仍然存在，如果一些与伤害触发相关的事件并且没有低于伤害阈值的伤害，仍然会触发<strong>伤害事件</strong></p><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">说明</th></tr></thead><tbody><tr><td style="text-align:center">无天光盾</td><td style="text-align:center">110/140/170/200 天赋 +300 15s持续时间</td></tr><tr><td style="text-align:center">回光返照</td><td style="text-align:center">3/4/5(A 5/6/7) 伤害转化为治疗</td></tr><tr><td style="text-align:center">凝魂之类</td><td style="text-align:center">5次 大于50点的伤害抵挡120点</td></tr><tr><td style="text-align:center">尖刺外壳</td><td style="text-align:center">2.25s持续时间 无效化每个玩家的<strong>第一次</strong>伤害</td></tr><tr><td style="text-align:center">守护天使</td><td style="text-align:center">6/7/8 (A 8/9/10) 物理伤害无效化</td></tr><tr><td style="text-align:center">虚妄芝诺</td><td style="text-align:center">7/8/9(天赋 +2) 持续时间结束受到被无效化的伤害</td></tr><tr><td style="text-align:center">折光</td><td style="text-align:center">次数 3/4/5/6(天赋 +3) 忽略低于5点的伤害</td></tr><tr><td style="text-align:center">活体护甲</td><td style="text-align:center">所有类型伤害无效化 20/40/60/80 次数 4/5/6/7(天赋 +4) 持续15s  低于5伤害忽略</td></tr><tr><td style="text-align:center">极寒之拥</td><td style="text-align:center">持续时间4s 无效物理伤害</td></tr></tbody></table><h1 id="技能攻击伤害"><a href="#技能攻击伤害" class="headerlink" title="技能攻击伤害"></a>技能攻击伤害</h1><h2 id="技能伤害计算"><a href="#技能伤害计算" class="headerlink" title="技能伤害计算"></a>技能伤害计算</h2><p>魔法伤害受到<a href="#MR">魔法抗性影响</a>，技能伤害可以由智力获得增强</p>$$增强数值 = [初始智力 + (当前等级 - 1) \times 智力成长]  / 14 / 100 + 技能增强天赋$$$$技能最终伤害 = 技能伤害数值 \times (1 + 增强数值) \times \\ \prod_{i=1}^n{(1 - 魔法抗性增加_i)} \times\prod_{i=1}^n{(1 + 魔法抗性降低_i)}$$<h3 id="技能增强天赋"><a href="#技能增强天赋" class="headerlink" title="技能增强天赋"></a>技能增强天赋</h3><p><code>远古冰魄10：8%</code> <code>蝙蝠骑士15：5%</code> <code>人马20：10%</code> <code>死亡先知10：5%</code> <code>干扰者20：10%</code> <code>大地之灵20：15%</code> <code>灰烬之灵10：8%</code> <code>矮人直升机10：6%</code> <code>杰奇洛10：8%</code> <code>拉西克20：5%</code> <code>莉娜20：6%</code> <code>莱恩20：8%</code> <code>马格纳斯10：15%</code> <code>米拉娜15：5%</code> <code>食人魔魔法师25：15%</code> <code>殁境神蚀者25：8%</code> <code>凤凰20：8%</code> <code>帕克20：10%</code> <code>拉比克20：8%</code> <code>暗影恶魔15：8%</code> <code>影魔15：6%</code> <code>风暴之灵25：10%</code> <code>伐木机20：5%</code> <code>修补匠15：4%</code> <code>孽主15：12%</code> <code>维萨吉25：20%</code> <code>风行者20：15%</code></p><h2 id="技能伤害类型"><a href="#技能伤害类型" class="headerlink" title="技能伤害类型"></a>技能伤害类型</h2><p>分为：魔法伤害，物理伤害，纯粹伤害</p><p>大部分伤害为魔法伤害</p><h3 id="物理伤害技能"><a href="#物理伤害技能" class="headerlink" title="物理伤害技能"></a>物理伤害技能</h3><p><code>炼金术士：酸性喷雾</code> <code>炼金术士：不稳定化合物</code> <code>敌法师：法力损毁</code> <code>斧王：反击螺旋</code> <code>兽王：野性飞斧</code> <code>赏金猎人：暗影步</code> <code>钢背兽：针刺扫射</code> <code>人马：反击</code> <code>克林克兹：灼热之箭</code> <code>戴泽：剧毒之触</code> <code>戴泽：暗影波</code> <code>死亡先知：驱使恶灵</code> <code>主宰：无敌斩</code> <code>昆卡：潮汐使者</code> <code>拉西克：恶魔的赦令</code> <code>噬魂鬼：盛宴</code> <code>剃刀：风暴之眼</code> <code>斯拉达：鱼人碎击</code> <code>斯拉达：深海重击</code> <code>狙击手：爆头</code> <code>工程师：感应地雷</code> <code>工程师：爆破起飞</code> <code>潮汐猎人：锚机</code> <code>熊战士：怒意狂击</code> <code>冥界亚龙：幽冥剧毒</code> <code>编织者：虫群</code></p><h3 id="纯粹伤害技能"><a href="#纯粹伤害技能" class="headerlink" title="纯粹伤害技能"></a>纯粹伤害技能</h3><p><code>祸乱之源：蚀脑</code> <code>祸乱之源：噩梦</code> <code>刃甲：反弹伤害</code> <code>嗜血狂魔：血之祭祀</code> <code>嗜血狂魔：割裂</code> <code>陈：忠诚考验</code> <code>死亡先知：吸魂巫术</code> <code>末日使者：末日</code> <code>魅惑魔女：推进</code> <code>谜团：午夜凋零</code> <code>祈求者：电磁脉冲</code> <code>祈求者：阳炎冲击</code> <code>莉娜：神灭斩A帐</code> <code>美杜莎：石化后秘术异蛇</code> <code>司夜刺客：尖刺外壳</code> <code>全能骑士：洗礼</code> <code>殁境神蚀者：奥术天球</code> <code>帕吉：肉狗</code> <code>痛苦女王：超声波冲击</code> <code>沉默术士：智慧之刃</code> <code>幽鬼：荒芜</code> <code>圣堂刺客：灵能之刃</code> <code>伐木机：锯齿飞轮</code> <code>伐木机：伐木锯链</code> <code>伐木机：带树木死亡旋风</code> <code>修补匠：激光</code> <code>骨灰</code></p><h1 id="攻击速度"><a href="#攻击速度" class="headerlink" title="攻击速度"></a>攻击速度</h1><h2 id="基础攻击间隔-BAT"><a href="#基础攻击间隔-BAT" class="headerlink" title="基础攻击间隔 BAT"></a>基础攻击间隔 BAT</h2><p>英雄在没有额外攻速加成的情况下每两次攻击间的<strong>时间间隔</strong></p><h2 id="攻击速度-ISA"><a href="#攻击速度-ISA" class="headerlink" title="攻击速度 ISA"></a>攻击速度 ISA</h2><ul><li>面板中英雄增加的攻击速度</li><li>由装备获得的攻击速度加成</li><li>每个英雄基础100点基础攻速</li><li>由Debuff造成的攻速减低</li></ul><h2 id="攻击速度计算公式"><a href="#攻击速度计算公式" class="headerlink" title="攻击速度计算公式"></a>攻击速度计算公式</h2>$$每秒攻击的次数 = \frac{(100 + IAS) × 0.01} {BAT}$$$$每次攻击的时间 = \frac{1}{每秒攻击的次数}$$<table><thead><tr><th style="text-align:center">攻击速度</th><th style="text-align:center">效果</th></tr></thead><tbody><tr><td style="text-align:center">-80</td><td style="text-align:center">五分之一BAT时间来攻击</td></tr><tr><td style="text-align:center">-75</td><td style="text-align:center">四分之一BAT时间来攻击</td></tr><tr><td style="text-align:center">-66</td><td style="text-align:center">三分之一BAT时间来攻击</td></tr><tr><td style="text-align:center">-50</td><td style="text-align:center">二分之一BAT时间来攻击</td></tr><tr><td style="text-align:center">+00</td><td style="text-align:center">正常状态</td></tr><tr><td style="text-align:center">+100 * n</td><td style="text-align:center">（1+n）倍攻击速度</td></tr></tbody></table><p>根据表格我们可以知道减攻速的技能在基础攻速很高的情况下基本没有什么效果，但是越接近0速度，减速效果越明显</p><h2 id="增加攻击速度技能列表"><a href="#增加攻击速度技能列表" class="headerlink" title="增加攻击速度技能列表"></a>增加攻击速度技能列表</h2><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">增加数值</th><th style="text-align:center">持续时间s</th></tr></thead><tbody><tr><td style="text-align:center">魔霭诅咒</td><td style="text-align:center">10/20/30/40</td><td style="text-align:center">4.5</td></tr><tr><td style="text-align:center">雷肤兽 - 暴怒</td><td style="text-align:center">75</td><td style="text-align:center">8</td></tr><tr><td style="text-align:center">雷肤兽 - 战鼓光环</td><td style="text-align:center">15</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">天穹守望者 - 磁场</td><td style="text-align:center">50/60/70/80</td><td style="text-align:center">3.5/4.5/5.5/6.5</td></tr><tr><td style="text-align:center">淘汰之刃</td><td style="text-align:center">30</td><td style="text-align:center">6 A帐10 成功淘汰</td></tr><tr><td style="text-align:center">野性之心</td><td style="text-align:center">15/25/35/45</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">扫射</td><td style="text-align:center">130 天赋 +70</td><td style="text-align:center">4/6/8/10</td></tr><tr><td style="text-align:center">熊怪 - 迅捷光环</td><td style="text-align:center">15</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">飓风之力</td><td style="text-align:center">100</td><td style="text-align:center">5</td></tr><tr><td style="text-align:center">狂战士之血</td><td style="text-align:center">220/260/300/340</td><td style="text-align:center">剩下10%生命值最高</td></tr><tr><td style="text-align:center">灵动迅捷</td><td style="text-align:center">10/25/40/55/70/85/100/A115</td><td style="text-align:center">9</td></tr><tr><td style="text-align:center">卡尔 - 雷</td><td style="text-align:center">2/4/6/8/10/12/14 * 3</td><td style="text-align:center">开关</td></tr><tr><td style="text-align:center">过载</td><td style="text-align:center">40/50/60/70</td><td style="text-align:center">开关</td></tr><tr><td style="text-align:center">强攻</td><td style="text-align:center">65/90/115/140</td><td style="text-align:center">5</td></tr><tr><td style="text-align:center">狂暴</td><td style="text-align:center">50/60/70/80</td><td style="text-align:center">3/4/5/6</td></tr><tr><td style="text-align:center">炽魂</td><td style="text-align:center">每层40/55/70/85(天赋 75/90/105/120)</td><td style="text-align:center">10 最高3层</td></tr><tr><td style="text-align:center">德鲁伊 - 狂猛</td><td style="text-align:center">10/20/30/40</td><td style="text-align:center">18/22/26/30</td></tr><tr><td style="text-align:center">跳跃</td><td style="text-align:center">16/32/48/64 (天赋 +100)</td><td style="text-align:center">5</td></tr><tr><td style="text-align:center">死灵射手光环</td><td style="text-align:center">5/7/9</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">暗夜猎影</td><td style="text-align:center">45/60/75/90</td><td style="text-align:center">夜晚</td></tr><tr><td style="text-align:center">嗜血术</td><td style="text-align:center">30/40/50/60 (天赋 +40)</td><td style="text-align:center">30</td></tr><tr><td style="text-align:center">幻影突袭</td><td style="text-align:center">130</td><td style="text-align:center">4s or 4次攻击</td></tr><tr><td style="text-align:center">战斗专注</td><td style="text-align:center">60/120/180</td><td style="text-align:center">5</td></tr><tr><td style="text-align:center">热血战魂</td><td style="text-align:center">15/20/25/30 (105/140/175/210)</td><td style="text-align:center">每次攻击同个目标</td></tr><tr><td style="text-align:center">超强力量</td><td style="text-align:center">400</td><td style="text-align:center">15 or 3/4/5/6次攻击</td></tr><tr><td style="text-align:center">黄泉颤抖</td><td style="text-align:center">64</td><td style="text-align:center">3/4/5/6</td></tr><tr><td style="text-align:center">集中火力</td><td style="text-align:center">500</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">寒冬诅咒</td><td style="text-align:center">70</td><td style="text-align:center">3.25/4/4.75</td></tr></tbody></table><h2 id="降低攻击速度技能"><a href="#降低攻击速度技能" class="headerlink" title="降低攻击速度技能"></a>降低攻击速度技能</h2><p>比较有效果的降低攻速的技能</p><p><code>烈火精灵：80/100/120/140</code> <code>不可侵犯：40/70/100/130</code>，<code>蝮蛇突袭：40/60/80</code> <code>重生：75</code> <code>黄泉颤抖：64</code> <code>小狼-致残：60</code> <code>冰封魔印：30/40/50/60</code> <code>雷霆一击：25/35/45/55</code> <code>原始咆哮：50</code> <code>冰霜新星：20/30/40/50</code> <code>液态火：20/30/40/50</code> <code>石化凝视：50</code> <code>夜魔虚空：50</code> <code>冰眼：45</code> <code>豪猪：10/20/30/40</code> <code>冰火交加：28/32/36/40</code> <code>毒龙法球：10/20/30/40</code> <code>全能光环：10/18/26/34</code></p><p><a name="Armor"></a></p><h1 id="护甲"><a href="#护甲" class="headerlink" title="护甲"></a>护甲</h1><h2 id="白字护甲"><a href="#白字护甲" class="headerlink" title="白字护甲"></a>白字护甲</h2><p>$$<br>敏捷 = 基础敏捷 + (等级 - 1) * 敏捷成长<br>$$</p><p>$$<br>白字护甲 = 基础护甲 + ( \frac{敏捷}{7})<br>$$</p><h2 id="护甲值倍数"><a href="#护甲值倍数" class="headerlink" title="护甲值倍数"></a>护甲值倍数</h2><p>$$<br>护甲值倍数 = 1 - \frac{0.06 \times 护甲值}{1 + 0.06 \times |护甲值| }<br>$$</p><h2 id="护甲值倍数倍数和护甲值的相关曲线"><a href="#护甲值倍数倍数和护甲值的相关曲线" class="headerlink" title="护甲值倍数倍数和护甲值的相关曲线"></a>护甲值倍数倍数和护甲值的相关曲线</h2><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/05/Dota2机制总结/Dota_2_armor_debuff_efficiency.png" alt="相关曲线" title="">                </div>                <div class="image-caption">相关曲线</div>            </figure><p>纵坐标是护甲值倍数，横坐标是现在英雄的护甲，不同颜色的线是此时减少的护甲（越上面的线减的越多）</p><h2 id="有效生命值-（EHP）"><a href="#有效生命值-（EHP）" class="headerlink" title="有效生命值 （EHP）"></a>有效生命值 （EHP）</h2><p>有效生命值 = 总生命值 ÷ 护甲值倍数</p>$$实时有效物理生命值 = 当前生命值 \div (1 - \frac{0.06 \times 当前总护甲值}{1 + 0.06 \times |当前总护甲值| })$$$$实时有效魔法生命值 = 当前生命值 \div (0.75 \times (1 - 装备提供抗性_1) \times \ldots \times (1 - 装备提供抗性_n))$$<h2 id="护甲调整"><a href="#护甲调整" class="headerlink" title="护甲调整"></a>护甲调整</h2><h3 id="增加护甲的技能"><a href="#增加护甲的技能" class="headerlink" title="增加护甲的技能"></a>增加护甲的技能</h3><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">加成数值</th><th style="text-align:center">持续时间s</th></tr></thead><tbody><tr><td style="text-align:center">黑龙 - 龙肤光环</td><td style="text-align:center">3</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">狂战士怒吼</td><td style="text-align:center">40</td><td style="text-align:center">2/2.4/2.8/3.2</td></tr><tr><td style="text-align:center">编织</td><td style="text-align:center">0.75/1.0/1.25 每秒  18/24/30</td><td style="text-align:center">24</td></tr><tr><td style="text-align:center">龙族血统</td><td style="text-align:center">3/6/9/12(天赋 翻倍)</td><td style="text-align:center">永久</td></tr><tr><td style="text-align:center">霜冻护甲</td><td style="text-align:center">3/5/7/9</td><td style="text-align:center">40</td></tr><tr><td style="text-align:center">战斗嚎叫</td><td style="text-align:center">10/15/20</td><td style="text-align:center">6</td></tr><tr><td style="text-align:center">变形术</td><td style="text-align:center">4/6/8</td><td style="text-align:center">变形状态</td></tr><tr><td style="text-align:center">寒冰盔甲</td><td style="text-align:center">8</td><td style="text-align:center">45</td></tr><tr><td style="text-align:center">战吼</td><td style="text-align:center">5/10/15/20</td><td style="text-align:center">8</td></tr><tr><td style="text-align:center">活性护甲</td><td style="text-align:center">5/10/15/20 每层 1/1.2/1.4/1.6</td><td style="text-align:center">10/13/16/19</td></tr><tr><td style="text-align:center">崎岖外表</td><td style="text-align:center">3/4/5/6</td><td style="text-align:center">永久</td></tr><tr><td style="text-align:center">巨魔 - 狂战士之怒</td><td style="text-align:center">6</td><td style="text-align:center">切换</td></tr></tbody></table><h3 id="减低护甲的技能"><a href="#减低护甲的技能" class="headerlink" title="减低护甲的技能"></a>减低护甲的技能</h3><table><thead><tr><th style="text-align:center">技能</th><th style="text-align:center">降低数值</th><th style="text-align:center">持续时间s</th></tr></thead><tbody><tr><td style="text-align:center">酸性喷雾</td><td style="text-align:center">4/5/6/7 (天赋 +4)</td><td style="text-align:center">16</td></tr><tr><td style="text-align:center">远古 - 亵渎</td><td style="text-align:center">50%</td><td style="text-align:center">6</td></tr><tr><td style="text-align:center">粘稠鼻液</td><td style="text-align:center">1/1.4/1.8/2.2 最高层数4(8)</td><td style="text-align:center">英雄5 小兵10</td></tr><tr><td style="text-align:center">实相裂隙</td><td style="text-align:center">3/4/5/6</td><td style="text-align:center">8</td></tr><tr><td style="text-align:center">编织</td><td style="text-align:center">0.75/1/1.25每秒 (18/24/30)</td><td style="text-align:center">24</td></tr><tr><td style="text-align:center">自然秩序</td><td style="text-align:center">基础护甲：40%/60%/80%/100%</td><td style="text-align:center">光环范围 275</td></tr><tr><td style="text-align:center">火人 - 攻击</td><td style="text-align:center">每次1点 上限10</td><td style="text-align:center">5 击中刷新时间</td></tr><tr><td style="text-align:center">激流</td><td style="text-align:center">2/3/4/5</td><td style="text-align:center">8 范围 320</td></tr><tr><td style="text-align:center">风暴之眼</td><td style="text-align:center">0.7/0.6/0.5 (天赋 -0.1) 打击1次1点</td><td style="text-align:center">30</td></tr><tr><td style="text-align:center">魔王降临</td><td style="text-align:center">3/4/5/6</td><td style="text-align:center">光环范围 900</td></tr><tr><td style="text-align:center">侵蚀雾霭</td><td style="text-align:center">10/15/20</td><td style="text-align:center">18</td></tr><tr><td style="text-align:center">隐匿</td><td style="text-align:center">2/4/6/8</td><td style="text-align:center">10</td></tr><tr><td style="text-align:center">巨浪</td><td style="text-align:center">3/4/5/6 (天赋 +5)</td><td style="text-align:center">4</td></tr><tr><td style="text-align:center">死亡旋风</td><td style="text-align:center">敏捷损失 * 0.14</td><td style="text-align:center">14</td></tr><tr><td style="text-align:center">恐怖波动</td><td style="text-align:center">3/4/5/6 1400距离 300范围</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">虫群</td><td style="text-align:center">1.4/1.25/1.1/0.95 攻击一次1点</td><td style="text-align:center">16</td></tr></tbody></table><h3 id="护甲相关装备"><a href="#护甲相关装备" class="headerlink" title="护甲相关装备"></a>护甲相关装备</h3><p>强袭 +5 玄冥盾牌系列 +2  勋章 +7 天鹰 +2 炎阳纹章 +10 祭品 +4 </p><p>黯灭 -7 勋章 -7 炎阳纹章 -10 强袭 -5 枯萎之石 -2 疯脸 -5</p><h1 id="闪避"><a href="#闪避" class="headerlink" title="闪避"></a>闪避</h1><h2 id="机制"><a href="#机制" class="headerlink" title="机制"></a>机制</h2><p>闪避与致盲都会在<strong>攻击完成</strong>（弹道击中）时有一定几率触发</p><h2 id="叠加与计算"><a href="#叠加与计算" class="headerlink" title="叠加与计算"></a>叠加与计算</h2><p>多个闪避来源<strong>乘法叠加</strong></p><h3 id="上下坡落空几率"><a href="#上下坡落空几率" class="headerlink" title="上下坡落空几率"></a>上下坡落空几率</h3><p>如果攻击者处于比目标更低的位置时，远程攻击会有25%的几率落空。</p><p>攻击者和目标之间的地形的高低差异实在<strong>击中目标时决定的</strong>，中路对线过程中，可以使用弹道飞行过程位移来保持和目标的同样地形高度保证必中</p><p><strong>飞行单位</strong>无上下坡落空几率</p><h3 id="计算公式"><a href="#计算公式" class="headerlink" title="计算公式"></a>计算公式</h3><p>$\prod_{i=0}^n$ 的含义是把i=0到n所有的项相乘<br>$$落空几率 = \prod_{i=0}^n (1 - 闪避来源_i) \times  \prod_{j=0}^n (1 - 致盲来源_j) \times 上下坡落空几率$$$$命中几率 = 1 - \prod_{i = 0}^n{(1 - 必中/克敌先机来源_i)}$$$$最终命中几率 = 1 - 落空几率 \times (1 - 命中几率)$$$$最终落空几率 = 落空几率 \times (1 - 命中几率)$$<br>公式只是为了程序数值计算使用，是需要记住：<strong>每一次攻击要绕过所有的闪避成功命中，只有当所有的闪避都失败了，这次攻击才可以造成伤害</strong>。所以说，出很多个闪避装备，在一定程度上对物理核心非常克制，这时候物理核心必须出金箍棒</p><h2 id="闪避来源"><a href="#闪避来源" class="headerlink" title="闪避来源"></a>闪避来源</h2><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">闪避几率%</th></tr></thead><tbody><tr><td style="text-align:center">敌法师 - 20级右天赋</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">磁场</td><td style="text-align:center">100 3.5/4.5/5.5/6.5s</td></tr><tr><td style="text-align:center">醉拳</td><td style="text-align:center">10/15/20/25 一段时间的100%闪避</td></tr><tr><td style="text-align:center">赏金猎人 - 25级右天赋</td><td style="text-align:center">25</td></tr><tr><td style="text-align:center">蝴蝶</td><td style="text-align:center">35</td></tr><tr><td style="text-align:center">人马 - 15级右天赋</td><td style="text-align:center">10</td></tr><tr><td style="text-align:center">克林克兹 - 20级右天赋</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">虚空 - 25级右天赋</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">黑暗贤者 - 10级右天赋</td><td style="text-align:center">12</td></tr><tr><td style="text-align:center">天堂之戟</td><td style="text-align:center">25</td></tr><tr><td style="text-align:center">噬魂鬼 - 20级右天赋</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">狼人 - 20级右天赋</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">美杜莎 - 15级左天赋</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">米波 - 20级右天赋</td><td style="text-align:center">10</td></tr><tr><td style="text-align:center">大圣 - 10级左天赋</td><td style="text-align:center">12</td></tr><tr><td style="text-align:center">模糊</td><td style="text-align:center">20/30/40/50</td></tr><tr><td style="text-align:center">猴子 - 20级左天赋</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">炎阳纹章</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">炎阳纹章- 队友使用 - 日耀</td><td style="text-align:center">20 7s</td></tr><tr><td style="text-align:center">斯温 - 20级左天赋</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">闪避护肤</td><td style="text-align:center">20</td></tr><tr><td style="text-align:center">圣堂刺客 - 15级左天赋</td><td style="text-align:center">12</td></tr><tr><td style="text-align:center">风行</td><td style="text-align:center">100 3/4/5/6a</td></tr></tbody></table><h3 id="致盲来源"><a href="#致盲来源" class="headerlink" title="致盲来源"></a>致盲来源</h3><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">落空几率%</th></tr></thead><tbody><tr><td style="text-align:center">醉酒云雾</td><td style="text-align:center">70 4s</td></tr><tr><td style="text-align:center">麻痹之咬</td><td style="text-align:center">30/40/50/60 2s</td></tr><tr><td style="text-align:center">致盲之光</td><td style="text-align:center">80 3/4/5s</td></tr><tr><td style="text-align:center">伤残恐惧</td><td style="text-align:center">白天10 3s 夜晚50 5/6/7/8s</td></tr><tr><td style="text-align:center">辉耀 - 辉耀灼烧</td><td style="text-align:center">17</td></tr><tr><td style="text-align:center">烟雾</td><td style="text-align:center">40/50/60/70 6s</td></tr><tr><td style="text-align:center">激光</td><td style="text-align:center">100 3/3.5/4/4.5s 小兵 6s</td></tr><tr><td style="text-align:center">近战旋风飞斧</td><td style="text-align:center">60 4/5/6/7s</td></tr></tbody></table><h3 id="克敌机先来源"><a href="#克敌机先来源" class="headerlink" title="克敌机先来源"></a>克敌机先来源</h3><p>为一种<u>攻击特效</u>，防止该次攻击落空，用来反制闪避，致盲，以及远程单位上下坡的25%几率落空，也能够防止近战攻击由于目标在攻击之前超过了350距离而落空</p><p>但是攻击弹道依旧可以<strong>躲避</strong></p><p>对建筑物无效</p><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">备注 不会落空为100%</th></tr></thead><tbody><tr><td style="text-align:center">强化图腾</td><td style="text-align:center">带有Buff的一次攻击不会落空</td></tr><tr><td style="text-align:center">棒击大地</td><td style="text-align:center">不会落空的即时攻击</td></tr><tr><td style="text-align:center">金箍棒</td><td style="text-align:center">每次攻击带有克敌先机</td></tr><tr><td style="text-align:center">复仇</td><td style="text-align:center">破影一击不会落空</td></tr><tr><td style="text-align:center">窒息之刃</td><td style="text-align:center">不会落空的即时攻击</td></tr><tr><td style="text-align:center">白银之锋 - 暗影步</td><td style="text-align:center">破影一击不会落空</td></tr><tr><td style="text-align:center">暗杀</td><td style="text-align:center">需要A帐</td></tr><tr><td style="text-align:center">自然庇护</td><td style="text-align:center">破影一击不会落空</td></tr><tr><td style="text-align:center">海象神拳！</td><td style="text-align:center">不会落空</td></tr><tr><td style="text-align:center">死亡守卫</td><td style="text-align:center">需要A帐 不会落空</td></tr></tbody></table><h3 id="必中来源"><a href="#必中来源" class="headerlink" title="必中来源"></a>必中来源</h3><p>必中防止一个单位受到的任何攻击落空</p><p>血棘的灵魂撕裂，岗哨守卫，炎阳纹章给敌方使用提供35%的必中效果</p><h1 id="移动速度"><a href="#移动速度" class="headerlink" title="移动速度"></a>移动速度</h1><p><a href="https://dota2.gamepedia.com/Movement_speed#Movement_speed_comparison" target="_blank" rel="noopener">英雄移动速度表</a></p><h2 id="叠加"><a href="#叠加" class="headerlink" title="叠加"></a>叠加</h2><p>相似的装备提供的移动速度不叠加，除了风帐</p><p>多个鞋类物品不叠加</p><p>夜叉 散夜对剑 幻影斧不叠加</p><p>多个战鼓或风灵之纹不叠加</p><p><u>风灵之纹和战鼓鞋类物品叠加</u></p><h2 id="公式"><a href="#公式" class="headerlink" title="公式"></a>公式</h2><p>移动速度 = （基础移动速度 + 具体移动速度加成） * （1 + 百分比移动速度加成和减速的和）</p><h1 id="转身速度"><a href="#转身速度" class="headerlink" title="转身速度"></a>转身速度</h1><h2 id="转身速率表"><a href="#转身速率表" class="headerlink" title="转身速率表"></a>转身速率表</h2><table><thead><tr><th style="text-align:center">英雄</th><th style="text-align:center">基础转身速率</th><th style="text-align:center">转180°时间</th></tr></thead><tbody><tr><td style="text-align:center"><strong>凤凰, 噬魂鬼, 影魔, 石鳞剑士, 虚空假面, 蝙蝠骑士, 钢背兽</strong></td><td style="text-align:center">1</td><td style="text-align:center">0.094</td></tr><tr><td style="text-align:center"><strong>撼地者</strong></td><td style="text-align:center">0.9</td><td style="text-align:center">0.105</td></tr><tr><td style="text-align:center"><strong>风暴之灵, 风行者, 马格纳斯</strong></td><td style="text-align:center">0.8</td><td style="text-align:center">0.118</td></tr><tr><td style="text-align:center"><strong>卓尔游侠, 圣堂刺客, 巨牙海民, 帕吉, 拉比克, 狙击手, 艾欧, 邪影芳灵</strong></td><td style="text-align:center">0.7</td><td style="text-align:center">0.135</td></tr><tr><td style="text-align:center">米波</td><td style="text-align:center">0.65</td><td style="text-align:center">0.145</td></tr><tr><td style="text-align:center">不朽尸王, 主宰, 伐木机, 修补匠, 先知, 全能骑士, 力丸, 发条技师, 变体精灵, 复仇之魂, 大地之灵, 天穹守望者, 孽主, 宙斯, 幻影刺客, 幻影长矛手, 戴泽, 斧王, 斯温, 昆卡, 暗影恶魔, 沉默术士, 炼金术士, 矮人直升机, 祸乱之源, 赏金猎人, 远古冰魄, 酒仙, 陈, 露娜, 食人魔魔法师, 黑暗贤者, 齐天大圣, 龙骑士</td><td style="text-align:center">0.6</td><td style="text-align:center">0.157</td></tr><tr><td style="text-align:center">上古巨神, 亚巴顿, 光之守卫, 克林克兹, 兽王, 军团指挥官, 冥界亚龙, 冥魂大帝, 剃刀, 剧毒术士, 半人马战行者, 司夜刺客, 哈斯卡, 嗜血狂魔, 天怒法师, 娜迦海妖, 寒冬飞龙, 小小, 工程师, 巨魔战将, 巫医, 巫妖, 帕克, 帕格纳, 干扰者, 幽鬼, 德鲁伊, 恐怖利刃, 拉席克, 敌法师, 斯拉克, 斯拉达, 暗夜魔王, 暗影萨满, 末日使者, 术士, 杰奇洛, 树精卫士, 死亡先知, 殁境神蚀者, 水晶室女, 沙王, 混沌骑士, 潮汐猎人, 灰烬之灵, 熊战士, 狼人, 痛苦女王, 瘟疫法师, 祈求者, 神谕者, 米拉娜, 维萨吉, 编织者, 美杜莎, 育母蜘蛛, 莉娜, 莱恩, 裂魂人, 谜团, 魅惑魔女</td><td style="text-align:center">0.5</td><td style="text-align:center">0.188</td></tr></tbody></table><p>大部分英雄的转身速度都比较慢，第一梯队1-0.7速率几个英雄在这方面有<strong>明显的优势</strong></p><h2 id="特殊说明"><a href="#特殊说明" class="headerlink" title="特殊说明"></a>特殊说明</h2><ul><li>艾欧和石鳞剑士，执行命令不需要转身，如果是技能需要转身，但<strong>使用物品不需要转身</strong></li><li><strong><code>无敌斩</code> <code>无影拳</code> <code>凤凰冲击</code> <code>烈日炙烤</code> 期间，不需要转身执行</strong></li><li><strong>使用 <code>洪流</code> <code>暗影护符</code> <code>微光披风</code> <code>魔瓶</code> <code>净化药水</code> <code>魔法芒果</code> <code>治疗药膏</code> 都不需要转身面向目标</strong></li></ul><h2 id="影响转身速率的技能"><a href="#影响转身速率的技能" class="headerlink" title="影响转身速率的技能"></a>影响转身速率的技能</h2><table><thead><tr><th style="text-align:center">技能名称</th><th style="text-align:center">效果</th></tr></thead><tbody><tr><td style="text-align:center">蝙蝠骑士 - 粘性燃油（叠油）</td><td style="text-align:center">转身速率减缓：<strong>70%</strong> 持续时间：8s</td></tr><tr><td style="text-align:center">美杜莎 - 石化凝视</td><td style="text-align:center">转身速率减缓：35% 持续时间：5/6/7</td></tr><tr><td style="text-align:center">石鳞剑士 - 地雷滚滚（对自身）</td><td style="text-align:center">转身速率：0.063<br>初始/跳跃/反弹后转身速率加成：0.086<br>转身速率加成持续时间：0.25</td></tr><tr><td style="text-align:center">凤凰 - 烈日炙烤（对自身）</td><td style="text-align:center">转身速率：0.013 = 每秒转25°（龟速）</td></tr></tbody></table><p><a name="MR"></a></p><h1 id="魔法抗性"><a href="#魔法抗性" class="headerlink" title="魔法抗性"></a>魔法抗性</h1><p>魔法抗性除了米波35%，维萨吉10%魔法抗性外，其他英雄都为25%基础魔法抗性</p><p>魔法抗性乘法叠加，不同的提高魔法抗性的装备可以叠加</p><h2 id="魔法抗性加成来源"><a href="#魔法抗性加成来源" class="headerlink" title="魔法抗性加成来源"></a>魔法抗性加成来源</h2><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">加成数值%及备注</th></tr></thead><tbody><tr><td style="text-align:center">法术护盾</td><td style="text-align:center">26/34/42/50</td></tr><tr><td style="text-align:center">小马or小熊怪光环</td><td style="text-align:center">英雄5 非英雄20 可叠加</td></tr><tr><td style="text-align:center">魔抗斗篷</td><td style="text-align:center">15</td></tr><tr><td style="text-align:center">微光披风</td><td style="text-align:center">15 被动</td></tr><tr><td style="text-align:center">微光披风 - 微光</td><td style="text-align:center">45 5s 0.6s渐隐时间</td></tr><tr><td style="text-align:center">挑战头巾</td><td style="text-align:center">25</td></tr><tr><td style="text-align:center">狂战士之血</td><td style="text-align:center">20/30/40/50 最大10%生命值</td></tr><tr><td style="text-align:center">洞察烟斗</td><td style="text-align:center">30 被动</td></tr><tr><td style="text-align:center">洞察烟斗光环</td><td style="text-align:center">10</td></tr><tr><td style="text-align:center">腐肉堆积</td><td style="text-align:center">6/8/10/12</td></tr><tr><td style="text-align:center">失效力场</td><td style="text-align:center">10/14/18/22</td></tr><tr><td style="text-align:center">腐蚀皮肤</td><td style="text-align:center">10/15/20/25</td></tr></tbody></table><h2 id="魔法抗性减少来源"><a href="#魔法抗性减少来源" class="headerlink" title="魔法抗性减少来源"></a>魔法抗性减少来源</h2><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">减少数值%</th><th style="text-align:center">备注</th></tr></thead><tbody><tr><td style="text-align:center">冰霜漩涡</td><td style="text-align:center">15/20/25/30</td><td style="text-align:center">16s 0.5s粘滞时间</td></tr><tr><td style="text-align:center">自然秩序</td><td style="text-align:center">40/60/80/100</td><td style="text-align:center">光环范围350 1s粘滞时间</td></tr><tr><td style="text-align:center">虚化冲击</td><td style="text-align:center">40</td><td style="text-align:center">敌方3s 友方4s</td></tr><tr><td style="text-align:center">幽灵形态</td><td style="text-align:center">40</td><td style="text-align:center">4s</td></tr><tr><td style="text-align:center">幽魂护罩</td><td style="text-align:center">20</td><td style="text-align:center">3/3.5/4/4.5</td></tr><tr><td style="text-align:center">衰老</td><td style="text-align:center">30/40/50/60</td><td style="text-align:center">3.5</td></tr><tr><td style="text-align:center">上古封印</td><td style="text-align:center">30/35/40/45</td><td style="text-align:center">3/4/5/6</td></tr><tr><td style="text-align:center">纷争面纱</td><td style="text-align:center">25</td><td style="text-align:center">16</td></tr></tbody></table><h2 id="魔法抗性100-来源"><a href="#魔法抗性100-来源" class="headerlink" title="魔法抗性100%来源"></a>魔法抗性100%来源</h2><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">备注</th></tr></thead><tbody><tr><td style="text-align:center">黑皇杖</td><td style="text-align:center">10/9/8/7/6/5</td></tr><tr><td style="text-align:center">牺牲</td><td style="text-align:center">跳跃时间or持续5s</td></tr><tr><td style="text-align:center">剑刃风暴</td><td style="text-align:center">5s</td></tr><tr><td style="text-align:center">狂暴</td><td style="text-align:center">3/4/5/6 (天赋+1s)</td></tr><tr><td style="text-align:center">石化凝视</td><td style="text-align:center">3s 天赋5s</td></tr><tr><td style="text-align:center">驱逐</td><td style="text-align:center">4/5/6/7</td></tr><tr><td style="text-align:center">命运赦令</td><td style="text-align:center">3/3.5/4/4.5</td></tr></tbody></table><h2 id="魔法吸收护盾"><a href="#魔法吸收护盾" class="headerlink" title="魔法吸收护盾"></a>魔法吸收护盾</h2><p>魔法吸收护盾计算是计算魔抗后的吸收数值，<strong>魔抗越高，护盾效果越好</strong></p><p>任何类型魔法护盾<strong>无法叠加</strong>，同时吸收伤害</p><table><thead><tr><th style="text-align:center">技能或物品名称</th><th style="text-align:center">吸收数值</th></tr></thead><tbody><tr><td style="text-align:center">烈火罩</td><td style="text-align:center">50/200/350/500 （天赋 +500）</td></tr><tr><td style="text-align:center">挑战头巾 - 绝缘</td><td style="text-align:center">325 持续12s</td></tr><tr><td style="text-align:center">洞察烟斗 - 法术护盾</td><td style="text-align:center">400 持续12s</td></tr></tbody></table><h1 id="施法距离"><a href="#施法距离" class="headerlink" title="施法距离"></a>施法距离</h1><p><a href="https://mubu.com/doc/1druVPzNpl" target="_blank" rel="noopener">幕布笔记链接</a></p><h1 id="物品被动效果叠加"><a href="#物品被动效果叠加" class="headerlink" title="物品被动效果叠加"></a>物品被动效果叠加</h1><h2 id="独立叠加"><a href="#独立叠加" class="headerlink" title="独立叠加"></a>独立叠加</h2><ul><li>攻击力</li><li>属性加成</li><li>魔法值/生命值</li><li>生命恢复速率/魔法恢复速率（基础速率 * 加成倍数）</li><li>攻击速度加成</li><li>护甲加成</li><li>分裂区域</li><li>移动速度加成</li></ul><h2 id="乘法叠加"><a href="#乘法叠加" class="headerlink" title="乘法叠加"></a>乘法叠加</h2><p>出现边缘递减效应<br>$$<br>加成 = 1 - (1-x) \times (1-y) \times (1-z) \times \ldots<br>$$<br>其中 $x y z$ 都表示一个百分比</p><p>魔法抗性乘法叠加</p><ul><li>一个100点魔法伤害的技能</li><li>英雄本身25%魔法抗性，伤害变为 100 * （1 - 25%） = 75</li><li>再装备挑战头巾，再降低30%，伤害变为 75 * （1 - 30%） = 52.5</li></ul><h1 id="躲避"><a href="#躲避" class="headerlink" title="躲避"></a>躲避</h1><p>躲避是一种躲避弹道的行为，更确切的说，是使弹道完全失去跟踪目标能力的行为。白话文就是：<strong>秀操作，骚</strong></p><h2 id="躲避技能的方式"><a href="#躲避技能的方式" class="headerlink" title="躲避技能的方式"></a>躲避技能的方式</h2><h3 id="技能"><a href="#技能" class="headerlink" title="技能"></a>技能</h3><p>以下技能在施法时能躲避弹道</p><p><code>炼金术士：化学狂暴</code> <code>酒仙：元素分离</code> <code>混沌骑士：混沌之军</code> <code>噬魂鬼：感染`</code>幻影斧：镜像<code></code>变体精灵：波浪形态<code></code>娜迦海妖：镜像<code></code>幻影长矛手：神行百变<code></code>凤凰：超新星<code></code>帕克：相位转移<code></code>力丸：绝杀秘技<code></code>风暴之灵：球状闪电`</p><h3 id="传送"><a href="#传送" class="headerlink" title="传送"></a>传送</h3><p>所有的真闪烁都能<strong>躲避弹道</strong>，躲避发生在使用技能移动时</p><p><code>敌法师：闪烁</code> <code>闪烁匕首：闪烁</code> <code>远行鞋：传送</code>  <code>艾欧：传送</code>(只有艾欧传送过去时可以躲避) <code>先知：传送</code> <code>帕克：灵动之翼</code> <code>痛苦女王：闪烁</code> <code>熊灵：回归</code> <code>回城卷轴：传送</code> <code>孽主：黑暗之门</code> <code>编织者：时光倒流</code> <code>陈：忠诚考验</code> <code>光之守卫：召回</code> <code>变体精灵：替换复制品</code></p><h3 id="隐身"><a href="#隐身" class="headerlink" title="隐身"></a>隐身</h3><p>所有能获得隐身状态的技能技能都能躲避弹道，除非敌人的在弹道到达之前使用了反隐，但是必须要注意不同技能的渐隐时间</p><h3 id="隐藏"><a href="#隐藏" class="headerlink" title="隐藏"></a>隐藏</h3><p>变为临时性的隐藏不能躲避弹道。</p><p>躲避与变为隐藏无关，而是与技能本身有关。这意味着隐藏技能不一定都能躲避弹道，</p><p>但是，利用合适的时机，可<strong>阻止弹道或一般技能，击中施法者或目标</strong>。</p><p>隐藏来源有一下技能</p><p><code>酒仙：元素分离</code> <code>混沌骑士：混沌之军</code> <code>大地之灵：残炎魔咒</code> <code>噬魂鬼：吸收</code> <code>幻影斧：镜像</code> <code>娜迦海妖：镜像</code> <code>殁境神蚀者：星体禁锢</code> <code>幻影长矛手：神行百变</code> <code>凤凰：超新星</code> <code>帕克：相位转移</code> <code>力丸：绝杀秘技</code> <code>暗影恶魔：崩裂禁锢</code> <code>巨牙海民：雪球</code></p><h3 id="无敌"><a href="#无敌" class="headerlink" title="无敌"></a>无敌</h3><p>变为无敌不能躲避弹道，但是可以在击中时减轻或使其效果无效。</p><p><strong>攻击伤害和技能伤害会被忽略</strong>。有一些技能<strong>可以影响无敌单位</strong>。</p><p>无敌来源</p><p><code>祸乱之源：噩梦</code> <code>酒仙：元素分离</code> <code>混沌骑士：混沌之军</code> <code>大地之灵：残岩魔咒</code> <code>灰烬之灵：无影拳</code> <code>灰烬之灵：激活残焰</code> <code>风帐：龙卷风</code> <code>虚空假面：时间漫游</code> <code>佣兽：石像形态</code> <code>祈求者：强袭飓风</code> <code>主宰：无敌斩</code> <code>噬魂鬼：吸收</code> <code>噬魂鬼：感染</code> <code>幻影斧：镜像</code> <code>变体精灵：波浪形态</code> <code>娜迦海妖：镜像</code> <code>娜迦海妖：海妖之歌</code> <code>殁境神蚀者：星体禁锢</code> <code>幻影长矛手：神行百变</code> <code>凤凰：超新星</code> <code>帕克：相位转移</code> <code>力丸：绝杀秘技</code> <code>暗影恶魔：崩裂禁锢</code> <code>狂风：龙卷风</code> <code>风暴之灵：球状闪电</code> <code>巨牙海民：雪球</code></p><h2 id="可以被躲避的弹道"><a href="#可以被躲避的弹道" class="headerlink" title="可以被躲避的弹道"></a>可以被躲避的弹道</h2><p>任何单位和英雄的所有物理攻击的弹道都可以躲避</p><h3 id="可以被躲避的技能"><a href="#可以被躲避的技能" class="headerlink" title="可以被躲避的技能"></a>可以被躲避的技能</h3><p><code>亚巴顿：迷雾缠绕</code> <code>赏金猎人：投掷飞镖</code> <code>酒仙：醉酒云雾</code> <code>钢背兽：粘稠鼻涕</code> <code>育母蜘蛛：孵化蜘蛛</code> <code>混沌骑士：混乱之箭</code> <code>陈：赎罪</code> <code>戴泽：剧毒之触</code> <code>龙骑士：神龙摆尾</code> <code>大地：投掷巨石</code> <code>撼地者：回音击</code> <code>虚灵之刃：虚化冲击</code> <code>变体精灵：变体攻击</code> <code>泥土傀儡：投石</code> <code>娜迦海妖：诱捕</code> <code>食人魔魔法师：引燃</code> <code>神谕者：气运之末</code> <code>幻影刺客：窒息之刃</code> <code>幻影长矛手：灵魂之矛</code> <code>痛苦女王：暗影突袭</code> <code>阿托斯：致残</code> <code>天怒法师：震荡光弹</code> <code>狙击手：暗杀</code> <code>斯温：风暴之拳</code> <code>潮汐猎人：巨浪</code> <code>修补匠：导热飞弹</code> <code>复仇之魂：魔法箭</code> <code>冥界亚龙：蝮蛇突袭</code> <code>维萨吉：灵魂超度</code> <code>风行者：束缚击</code> <code>寒冬飞龙：碎裂冲击</code> <code>冥魂大帝：冥火暴击</code></p><h3 id="不可以被躲避的技能"><a href="#不可以被躲避的技能" class="headerlink" title="不可以被躲避的技能"></a>不可以被躲避的技能</h3><p><code>炼金术士：不稳定化合物</code> <code>天穹守望者：闪光幽魂</code> <code>爱人直升机：追踪导弹</code> <code>哈斯卡：牺牲</code> <code>拉西克：闪电风暴</code> <code>巫妖：连环霜冻</code> <code>莉娜：神灭斩</code> <code>莱恩：死亡一指</code> <code>美杜莎：秘术异蛇</code> <code>米拉娜：流星风暴</code> <code>瘟疫法师：死亡脉冲</code> <code>痛苦女王：痛苦尖叫</code> <code>拉比克：技能窃取</code> <code>天怒法师：奥法鹰隼</code> <code>幽鬼：幽鬼之刃</code> <code>小小：投掷</code> <code>树精卫士：寄生种子</code> <code>巨牙海民：雪球</code> <code>寒冬飞龙：碎裂冲击弹射</code> <code>巫医：麻痹药剂</code></p><h1 id="视野"><a href="#视野" class="headerlink" title="视野"></a>视野</h1><p>Dota2中，掌握视野掌握主动权，通常来说，白天视野1800，夜晚视野800，装备银月之晶获得<strong>300额外夜间视野</strong>，吞噬获得<strong>150夜间视野</strong></p><h2 id="视野例外英雄"><a href="#视野例外英雄" class="headerlink" title="视野例外英雄"></a>视野例外英雄</h2><p>模型视野不同列表</p><table><thead><tr><th style="text-align:center">英雄名称</th><th style="text-align:center">白天</th><th style="text-align:center">夜晚</th></tr></thead><tbody><tr><td style="text-align:center">斯拉克</td><td style="text-align:center">1800</td><td style="text-align:center">1800</td></tr><tr><td style="text-align:center">暗夜魔王</td><td style="text-align:center">800</td><td style="text-align:center">1800</td></tr><tr><td style="text-align:center">狙击手</td><td style="text-align:center">1800</td><td style="text-align:center">1100</td></tr><tr><td style="text-align:center">蝙蝠骑士</td><td style="text-align:center">1200</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">赏金猎人</td><td style="text-align:center">1800</td><td style="text-align:center">1000</td></tr></tbody></table><p>增加视野技能</p><table><thead><tr><th style="text-align:center">英雄名称</th><th style="text-align:center">白天视野</th><th style="text-align:center">夜间视野</th></tr></thead><tbody><tr><td style="text-align:center">露娜 - 月之祝福</td><td style="text-align:center">1800</td><td style="text-align:center">800/1050/1300/1550/1800</td></tr><tr><td style="text-align:center">狼人 - 变身</td><td style="text-align:center">1800</td><td style="text-align:center">800/1800</td></tr><tr><td style="text-align:center">寒冬飞龙 - 严寒灼烧</td><td style="text-align:center">1800</td><td style="text-align:center">800/1200</td></tr></tbody></table><p>裂魂人【10级】天赋夜晚视野 +400</p><p>寒冬飞龙【15级】天赋夜晚视野 +500</p><p>斯拉达【20级】天赋夜晚视野 +1000</p><h2 id="野怪也召唤单位视野"><a href="#野怪也召唤单位视野" class="headerlink" title="野怪也召唤单位视野"></a>野怪也召唤单位视野</h2><table><thead><tr><th style="text-align:center">单位名称</th><th style="text-align:center">白天</th><th style="text-align:center">夜晚</th></tr></thead><tbody><tr><td style="text-align:center">尸王 - 不朽僵尸</td><td style="text-align:center">1400</td><td style="text-align:center">1400</td></tr><tr><td style="text-align:center">丘陵巨魔牧师</td><td style="text-align:center">1400</td><td style="text-align:center">1400</td></tr><tr><td style="text-align:center">死灵龙 - 佣兽（高空视野）</td><td style="text-align:center">390</td><td style="text-align:center">390</td></tr><tr><td style="text-align:center">冥魂大帝 - 骷髅兵</td><td style="text-align:center">800</td><td style="text-align:center">600</td></tr><tr><td style="text-align:center">术士 - 地狱火</td><td style="text-align:center">1800</td><td style="text-align:center">1800</td></tr><tr><td style="text-align:center">酒仙 - 大地</td><td style="text-align:center">1800</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">先知 - 大树人</td><td style="text-align:center">500</td><td style="text-align:center">500</td></tr><tr><td style="text-align:center">兽王 - 战鹰</td><td style="text-align:center">1000</td><td style="text-align:center">1000</td></tr><tr><td style="text-align:center">上古巨神 - 星体游魂（高空视野）</td><td style="text-align:center">400</td><td style="text-align:center">400</td></tr><tr><td style="text-align:center">先知 - 树人</td><td style="text-align:center">500</td><td style="text-align:center">500</td></tr><tr><td style="text-align:center">死灵射手/死灵战士</td><td style="text-align:center">1300/1400/1500</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">酒仙 - 烈火</td><td style="text-align:center">1800</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">德鲁伊 - 熊灵</td><td style="text-align:center">1400</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">祈求者 - 熔炉精灵</td><td style="text-align:center">1200</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">酒仙 - 狂风</td><td style="text-align:center">1800</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">狗头人</td><td style="text-align:center">1400</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">甲虫</td><td style="text-align:center">321</td><td style="text-align:center">321</td></tr><tr><td style="text-align:center">狼人 - 精灵狼</td><td style="text-align:center">1200</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">谜团 - 精神体</td><td style="text-align:center">1200</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">蜘蛛 - 小蜘蛛</td><td style="text-align:center">700</td><td style="text-align:center">700</td></tr><tr><td style="text-align:center">兽王 - 豪猪</td><td style="text-align:center">1400</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">豺狼人刺客</td><td style="text-align:center">400</td><td style="text-align:center">400</td></tr><tr><td style="text-align:center">远古岚肤兽</td><td style="text-align:center">1400</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center">远古雷肤兽</td><td style="text-align:center">1400</td><td style="text-align:center">800</td></tr><tr><td style="text-align:center"><strong>鹰身女妖侦察者</strong></td><td style="text-align:center"><strong>1800</strong></td><td style="text-align:center"><strong>1800</strong></td></tr><tr><td style="text-align:center"><strong>鹰身女妖风暴巫师</strong></td><td style="text-align:center"><strong>1800</strong></td><td style="text-align:center"><strong>1800</strong></td></tr></tbody></table><h2 id="视野类型"><a href="#视野类型" class="headerlink" title="视野类型"></a>视野类型</h2><p><a href="https://mubu.com/doc/1druVPzNpl" target="_blank" rel="noopener">幕布笔记链接</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】百科类型文章&lt;br&gt;【内容简介】这是一份有关Dota2游戏机制的总结，核心目的是为了方便查阅，&lt;strong&gt;计算公式&lt;/strong&gt;。针对人群是对数据和游戏机制有很大兴趣的高玩，从中你可能能了解&lt;strong&gt;如何通过击杀或得更多的经济&lt;/strong&gt;，&lt;strong&gt;哪些操作可以躲避技能&lt;/strong&gt;等等&lt;/p&gt;
&lt;p&gt;版本信息：更新到7.09&lt;/p&gt;
    
    </summary>
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/categories/Dota2/"/>
    
    
      <category term="Dota2" scheme="https://charlesliuyx.github.io/tags/Dota2/"/>
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
      <category term="Data Analysis" scheme="https://charlesliuyx.github.io/tags/Data-Analysis/"/>
    
  </entry>
  
  <entry>
    <title>【直观详解】Logistic Regression</title>
    <link href="https://charlesliuyx.github.io/2017/09/04/LogisticRegression%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    <id>https://charlesliuyx.github.io/2017/09/04/LogisticRegression学习笔记/</id>
    <published>2017-09-03T16:21:50.000Z</published>
    <updated>2017-11-15T00:46:30.947Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】17min - 22min<br>【内容简介】从不同角度解释<strong>为何使用Logistic回归模型</strong>，解读模型的<strong>现实意义</strong>，详细解读<strong>为何使用</strong>以及<strong>什么是</strong>交叉熵损失函数。并详细梳理符号表达，对公式不再恐惧</p><a id="more"></a><h2 id="什么是【回归（Regression）】"><a href="#什么是【回归（Regression）】" class="headerlink" title="什么是【回归（Regression）】"></a>什么是【回归（Regression）】</h2><p>回归（Regression）是一项模拟技术，用来从<strong>一个或多个解释变量</strong>中<u>预测</u><strong>输出变量的值</strong></p><h2 id="什么是及为什么【Logistic-Regression】"><a href="#什么是及为什么【Logistic-Regression】" class="headerlink" title="什么是及为什么【Logistic Regression】"></a>什么是及为什么【Logistic Regression】</h2><p>回归（Regression）是用来预测的，比如给你一组虫子的腿长和翅膀长数据，让你判断虫子是A类虫还是B类虫。</p><p><strong>逻辑回归</strong>则是用来预测<strong>二进制</strong>输出变量取值（如：<strong>是/不是</strong>）的预测技术</p><blockquote><p>即输出变量只有<strong>两个值</strong>得预测技术</p></blockquote><p>下文中将会从不同的角度</p><h3 id="概率论角度"><a href="#概率论角度" class="headerlink" title="概率论角度"></a>概率论角度</h3><p>首先，需要回忆一下几个概念</p><p>【大数定理】</p>$$\lim_{n\to\infty} \frac{1}{n} \sum_{i=1}^n {X_i} = \mu$$<p>不断的采样一个随机变量，得到n个值，当n趋向于<strong>正无穷</strong>的时候，这个<strong>平均值</strong>就收敛于随机变量的<strong>期望</strong></p><p>【中心极限定理】</p><p>大量<strong>相互独立{条件1</strong>}的随机变量，其均值的分布以<strong>正态分布{结论}</strong>为<strong>极限{条件2}</strong></p><p>【贝叶斯公式】</p><p>默认你已经对<strong>条件概率</strong>了若指掌（在某件事情已经发生的情况下另一件事发生的概率），关于<a href="https://mubu.com/doc/2pJ0IojsIl" target="_blank" rel="noopener">贝叶斯方法的前世今生</a>，这个链接或许可以帮到你。</p><p>那贝叶斯公式是如何推出来的？</p><h4 id="问题描述"><a href="#问题描述" class="headerlink" title="问题描述"></a>问题描述</h4><p>我们需要求的问题是：你在校园里面随机游走，遇到了<strong>N个穿长裤的人</strong>（但是可能因为你高度近视你无法看出他们的性别），<strong>问，这N个人里面有多少个女生，多少个男生</strong>，即，穿裤子的人里面有多少个女生</p><h4 id="解决过程"><a href="#解决过程" class="headerlink" title="解决过程"></a>解决过程</h4>$$穿裤子的人中的女生比例 = \frac{穿长裤的女生人数}{穿长裤的总人数} =\\  \frac {U\times P(Girl)\times P(Paints|Girl)}{U\times P(Boy)\times P(Paints|Boy) + U\times P(Girl)\times P(Paints|Girl)}\tag{1-1}$$化简上式，可以发现其实分母合起来就是 $P(Paints)$ ，分子其实就是既穿裤子又是女孩，整理得$$P(Girl|Paints) = \frac{P(Girl) \times P(Paints|Girl)}{P(Paints)}$$ <p>再一般化，用A表示穿裤子的，B表示女生<br>$$<br>P(B|A) = \frac{P(B)\times P(A|B)}{P(A)} = \frac{P(AB)}{P(A)}\tag{1-2}<br>$$<br>上式就是贝叶斯公式的一般形式，我们在推导中发现，<strong>正常人类对频率的感知和理解速度要高于对概率的</strong>。</p><p>比如“穿长裤的女生人数”这个概念，用总人数乘以<strong>女人比例</strong>，得出<strong>女生人数</strong>，再用女生人数乘以<strong>女生中穿裤子人数的比例</strong>得到<strong>穿裤子的女生人数</strong>。这一串推导感觉毫无困难。但如果读成：在A发生条件下，发成B的概率，会让人乍看下，感到有一定的理解困难。</p><p>我们常说Sense，我觉得这就是一种敏感，对条件概率表达方式的敏感，在你看到的时候，抓住那个最关键的点，不存在任何的迷惑</p><p>那Logistic Function和贝叶斯公式有什么联系呢？</p><p>如果我们把公式（1-1）也符号化，$B_1$ 表示女生，$B_2$表示男生，$A$ 表示穿裤子<br>$$<br>P(B_1|A) = \frac {P(B_1)P(A|B_1)}{P(B_2)P(A|B_2) + P(B_1)P(A|B_1)}\tag{1-3}<br>$$<br>右边同时除以 $P(B_1)\times P(A|B_1)$ ，并定义 $a = \ln{\left( \frac{P(B_1)P(A|B_1)}{P(B_2)P(A|B_2)}\right)}$ 直接由公式(1-3)可得到<br>$$<br>f(a) = \frac{1}{1 + e^{-a}} \tag{1-4}<br>$$<br>很熟悉的形式，其实就是<code>logistic函数</code>的一般形式（对数几率函数），而这个函数的值就是 $f(a)$ ，很明显，<strong>是一个概率</strong></p><p><strong>另一个很重要超级重要的常识就是：正态分布的的累计分布函数（就是从负无穷到x积分）和概率分布函数长得样子很像Logistic累计分布函数和概率密度函数</strong>，可能看到这句话很多人就已经真相大白了，应给无论从中心极限定理出发，还是从统计学概率论角度来看，<strong>概率分布存在的价值是为了描述自然界（现实）中的随机事件，构造函数本身就十分重要，不同的规律需要不同的函数去拟合</strong></p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/04/LogisticRegression学习笔记/Normal_distribution.png" alt="正太分布概率密度函数（左）累计密度函数（右）" title="">                </div>                <div class="image-caption">正太分布概率密度函数（左）累计密度函数（右）</div>            </figure><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/04/LogisticRegression学习笔记/Logistit_function.png" alt="Logistic函数概率密度函数（左）累计密度函数（右）" title="">                </div>                <div class="image-caption">Logistic函数概率密度函数（左）累计密度函数（右）</div>            </figure><h3 id="统计学角度"><a href="#统计学角度" class="headerlink" title="统计学角度"></a>统计学角度</h3><h4 id="动机-需要解决什么问题"><a href="#动机-需要解决什么问题" class="headerlink" title="动机 - 需要解决什么问题"></a>动机 - 需要解决什么问题</h4><p>在现实生活中，有时候需要探究<strong>某一事件 $A$ 发生的概率 $P$ （0 - 1 之间的一个数）与某些因素 $\mathbf X = (X_1, X_2, \ldots, X_p)’$ 之间的关系</strong>。（其中1到p是各种不同的因素）</p><p>☆ 【<strong>核心问题</strong>】考虑到很多情况下，$P$ 对 $\mathbf X$ 的变化并不敏感，即 $\mathbf X$ 需要发生<strong>很大的变化</strong>才能引起 $P$  的<strong>微弱改变</strong></p><blockquote><p>比如，<u>农药的用量</u>和<u>杀死害虫的概率</u>之间，在农药用量在很小的范围内增长的时候，因为药效不够，杀死害虫的概率增长很慢。</p></blockquote><p>因此，我们要构造一个关于 $P$ 的函数 $\theta(P)$ ，使得它在 $P = 0$ 或 $P = 1$ 附近，$P$ 的微小变化对应 $\theta(P)$ 的较大改变，同时，$\theta(P)$ 要尽可能的简单。于是，我们可以<strong>构造一个函数</strong>（注意：构造函数是数学中很有效的手段，我们需要什么特性就用什么方法来构造一个满足我们需求的函数）c<br>$$<br>\frac {\partial \theta(P)}{\partial P} =\frac{1}{P} +\frac{1}{1-P}<br>$$<br>根据上述公式可以<strong>解得</strong><br>$$<br>\theta(P) =\ln\left(\frac{P}{1-P}\right)<br>$$<br><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/09/04/LogisticRegression学习笔记/Visualizaiton1.png" alt="可视化" title="">                </div>                <div class="image-caption">可视化</div>            </figure></p><p>这个 $\theta(P)​$ 就是<code>Logit变换</code>，可以看到，这个函数很符合我们的要求： $P = 0​$ 或 $P = 1​$ 附近，$P​$ 的微小变化对应 $\theta(P)​$ 的较大改变</p><h4 id="方案-如何解决这个问题"><a href="#方案-如何解决这个问题" class="headerlink" title="方案 - 如何解决这个问题"></a>方案 - 如何解决这个问题</h4><p>为了建立因变量 $P$ 与自变量 $\mathbf X$ 之间的<strong>合理变动关系</strong>，一个很自然的假设就是<strong>线性关系</strong>，也就是：<br>$$<br>P = \mathbf X’  \boldsymbol{\beta}<br>$$<br>其中 $\boldsymbol \beta = (\beta_1,\beta_1,\ldots,\beta_p)$ 表示每一个不同因素对最终概率 $P$ 产生的影响（这个也可以写作，权重weight）</p><p>由需求可知，在某些情况下，$P = 0$ 或 $P = 1$ 附近，$P$ 对 $\mathbf X$ 的变化并不敏感，简单的线性关系<strong>不能反映这一特征</strong>。此时，构造的  $\theta(P)$ 就派上用场了<br>$$<br>\ln\left(\frac{P}{1-P}\right) = \mathbf X’  \boldsymbol{\beta}<br>$$<br>进行一系列的公式推导有<br>$$<br>\ln\left(\frac{P}{1-P}\right) = \mathbf X^\mathrm T \boldsymbol{\beta} \implies \frac{P}{1-P} = e^{\mathbf X^\mathrm T \boldsymbol{\beta}} \implies P = \frac{e^{\mathbf X^\mathrm T \boldsymbol{\beta}}}{1 + e^{\mathbf X^\mathrm T \boldsymbol{\beta}}}<br>$$<br>则上述最后推出的就是<code>Logistic回归模型</code></p><h3 id="机器学习角度"><a href="#机器学习角度" class="headerlink" title="机器学习角度"></a>机器学习角度</h3><p>周志华《机器学习》，3.3 对数几率回归笔记</p><p>和统计学角度相同，我们的目的是依旧是完成一个<strong>二分类任务</strong>，输出标记 $y \in {0,1}$ ，而线性回归模型产生的预测值 $z = \boldsymbol w^{T}\boldsymbol x + b$ 是实值，于是，我们需要把 z 转换为0/1值，最理想的是<code>单位阶跃函数</code>（unit-step function z &gt; 0➜y=1，z&lt;0➜y=1）</p><p>单单位阶跃函数<strong>不连续</strong>，不能微分，积分，求逆，于是我们希望找到能在一定程度上近似单位阶跃函数的<code>替代函数（surrogate function）</code>，并希望它单调可微，答案很明显，就是<code>对数几率函数（logistic function）</code><br>$$<br>y = \frac{1}{1+e^{-z}}<br>$$</p><p>z 为预测值，y 为输出，<code>对数几率函数</code>是一种<code>Sigmoid函数</code>【一种形状类似S的函数】，将$z = \boldsymbol w^{T}\boldsymbol x + b$ 带入上面的公式</p><p>$$<br>y = \frac{1}{1+e^{-(\boldsymbol w^{T}\boldsymbol x + b)}} \implies \ln(\frac{y}{1-y}) = \boldsymbol w^{T}\boldsymbol x + b<br>$$<br>如果将 $y$ 作为 $\mathbf x$ 作为正例的可能性，$1-y$ 为其反例的可能性<br>$$<br>\frac {y}{1-y}<br>$$<br>上面的式子成为“几率”(odds)：表示 $\mathbf x$ 是正例的<strong>相对可能性</strong>，对odds取对数得到“几率对数”(log odds，也就做logit)</p><h3 id="生态学角度"><a href="#生态学角度" class="headerlink" title="生态学角度"></a>生态学角度</h3><p>可以换一个角度来解读这个问题的前世今生</p><p>1798年的时候一个叫Malthus的英国牧师发现<strong>人口的变化率</strong>和<strong>人口的数目</strong>成正比，需要用数学的手法建立一个公式来表征这个现象，则，使用 $N(t)$ 这个函数来表示<code>t</code>时刻某个地区的<strong>总人口数</strong>（根据<strong>成正比</strong>）<br>$$<br>\frac{dN(t)}{dt} = {rN(t)}<br>$$</p><blockquote><p>其中，<code>r</code>是常数，表示 $N(t)$ 的变化率</p></blockquote><p>直接解出这个方程<br>$$<br>N(t) = N_0e^{rt}<br>$$<br>这很明显是一个指数增长函数，其实也是种群增长的函数表示</p><p>但是问题也是很明显的：种群因为<strong>环境容量</strong>的限制一定是<strong>不能无限增长的</strong>，即，这个模型非常不靠谱，需要重新设计模型来复合现实中的情况。Pierre-François Verhulst 在1838年提出，<strong>构造一个函数</strong><br>$$<br>\frac{dN(t)}{dt} = {rN(t)}\left(1 - \frac{N(t)}{K}\right)<br>$$</p><blockquote><p>K是一个常数，表示系统的容量（capacity）</p></blockquote><p>令 $f(t) = \frac{N(t)}{K}$ ，在方程两边同时除以 $K$ ，上述方程变为：<br>$$<br>\frac{df(t)}{dt} = rf(1 - f)<br>$$<br>这也是<code>Logistic方程</code>的一般形式</p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><p>从不同的角度来研究问题就会发现，其实很多时候我们解决一个问题具有一个<strong>相似的模式</strong>，包括<strong>大数定律</strong>，<strong>贝叶斯全概率公式</strong>是一切的基石和解决问题的主要工具</p><p>一个模型的建立规则依据<strong>数据的分布特征</strong>，而这里依托的一个关键信息就是：<strong>在靠近输入0，1两点的时候，y随x的变化不明显</strong>，线性模型没法很好的反应这个特征，所以就构造了一个逻辑回归模型来表示这个特征</p><p>并且<code>Logistic回归模型</code>的<strong>本质</strong>是一个<strong>概率模型</strong>，因为在描述该分类时，我们其实是以概率来衡量的</p><h2 id="重要概念"><a href="#重要概念" class="headerlink" title="重要概念"></a>重要概念</h2><h3 id="均方误差-Mean-Squre-Error-MSE"><a href="#均方误差-Mean-Squre-Error-MSE" class="headerlink" title="均方误差 Mean Squre Error MSE"></a>均方误差 Mean Squre Error MSE</h3><p>指参数估计值与参数真值之差平方的<strong>期望值</strong>，是一种目标函数（Objective Function），常用于线性回归<br>$$<br>MSE = \frac{1}{n} \sum_{t = 1}^n{(observed_t - predicted_t)}^2<br>$$</p><h3 id="交叉熵-Cross-Entropy"><a href="#交叉熵-Cross-Entropy" class="headerlink" title="交叉熵 Cross Entropy"></a>交叉熵 Cross Entropy</h3><p>又称为logloss，是Objective function的一种，也称Loss function or Coss Function</p><h4 id="什么是熵"><a href="#什么是熵" class="headerlink" title="什么是熵"></a>什么是熵</h4><p>我觉得这个问题必须搞明白一件事就是：什么是<code>熵 Entropy</code></p><ul><li>广义的定义是：熵是描述一个系统的<strong>无序程度</strong>的变量；同样的表述还有，熵是系统混乱度的度量，一切自发的不可逆过程都是从<strong>有序</strong>到<strong>无序</strong>的变化过程，向熵增的方向进行</li><li>有一个很神奇的解释是：熵字为火字旁加商。当时有位姓胡的学者作为普朗克的防疫。S(entropy)定义为热量Q与温度的<strong>比值</strong>，所以造字：熵</li><li>至于信息论上熵的概念更有意思，有兴趣可以<a href="https://www.zhihu.com/question/22178202/answer/49929786" target="_blank" rel="noopener">转到</a></li></ul><p>要理解这个<code>Cross Entropy</code>，必须了解它是用来干啥的？</p><p>延伸：<code>信息熵</code> <code>交叉熵</code> <code>相对熵</code>的理解，需要跳转到另一篇笔记：<a href="https://charlesliuyx.github.io/2017/09/11/%E4%BB%80%E4%B9%88%E6%98%AF%E4%BF%A1%E6%81%AF%E7%86%B5%E3%80%81%E4%BA%A4%E5%8F%89%E7%86%B5%E5%92%8C%E7%9B%B8%E5%AF%B9%E7%86%B5/">什么是信息熵、交叉熵和相对熵</a> </p><p>简单来说<code>Cross Entropy</code>可以表示可以度量<strong>最终训练结果于测试集的差异程度</strong>，MSE也是同样的作用。</p><p>换种更具体的说法：我们用p表示真实标记（训练样本标记）的分布，q是训练后的模型的预测标记（输出值标记）的分布，而<strong>交叉熵损失函数可以衡量p与q的相似性</strong>。</p><h4 id="似然函数"><a href="#似然函数" class="headerlink" title="似然函数"></a>似然函数</h4><p>定义：给定联合样本值 $x$ 关于（未知 - 因为也是一边的自变量）参数 $\theta$ 的函数<br>$$<br>L(\theta|x) = f(x;\theta)<br>$$</p><blockquote><p>$x$ 指联合样本随机变量 $X$ 取到的值，比如天气取值 $X$ =【晴，阴，雨，雪】$x$ = 晴</p><p>$\theta$ 指未知参数，属于参数空间，比如正态分布的均值，方差等</p><p>$f(x;\theta)$ 是<strong>密度函数</strong>，<strong>表示 $\theta$ 参数下</strong>联合样本值 $x$ 的<strong>联合密度函数</strong>（所以这里不用|符号，|符号表达的意思是<strong>条件概率或条件分布</strong>）</p></blockquote><p>从定义上，似然函数和密度函数是完全不同的<strong>两个数学对象</strong>：前者是关于 $\theta$ 的函数，后者是关于 $x$ 的函数。中间的等号理解成<strong>函数值形式相等</strong></p><p>这个等式表示的是对于事件发生的<strong>两种角度的看法</strong>。左边表示概率，右边表示可能性。要表达的含义都是：给定一个样本 $x$ 后，我们去测度这个样本出现的可能性到底有多大。说人话，比如样本空间是 $X =【晴，阴，雨，雪】$，函数表达的就是样本 $x$ = 晴在这个样本空间下发生的概率或可能性</p><p>从<strong>统计学</strong>的角度来说，这个样本的出现一定是<strong>基于一个分布的</strong>（比如二项分布，只正态分布等等），那么我们假设这个分布为 $f(x;\theta)$ ，对于不同的 $\theta$ 样本的分布不一样。</p><p>$f(x;\theta)$ 函数表示的就是在参数 $\theta$ 下 $x$ <strong>出现的概率</strong>有多大（可以带入天气例子思考）</p><p>$L(\theta|x)$ 表示在<strong>给定样本</strong> $x$ ，哪个参数 $\theta$ 使得 $x$ 出现的可能性有多大。说人话，我们已经知道天气是晴天，哪个参数（可能是 $\theta_1$ $\theta_2$）使得这个<strong>函数值最大</strong></p><h4 id="对于Logistic-Regression-为什么要用LogLoss-Cross-Entropy"><a href="#对于Logistic-Regression-为什么要用LogLoss-Cross-Entropy" class="headerlink" title="对于Logistic Regression 为什么要用LogLoss - Cross Entropy"></a>对于Logistic Regression 为什么要用LogLoss - Cross Entropy</h4><p>了解了熵，和似然函数，我们可以开始看看在Logistic Regression的条件下为什么要用LogLoss，换句话也就是说，它一定有它的优势，我们采用，那么它有什么优势？</p><p>Logistic Regression的本质还是一个二分类问题，即Y = 0，or Y = 1</p><p>令 $P(Y=0|x) = \pi(x)$ $P(Y=1|x) = 1 - \pi(x)$ </p><blockquote><p>$y_i$ 表示i次试验，取值就是0 or 1（二分类问题）</p><p>$\pi(x) = \frac{1}{1 + e^{-wx}}$  是Logistic Function的表现形式，其中w相当于似然函数一节提到的 $\theta$ 是需要求的参数（加深理解，其实在二分类问题中，Logistic函数就是一种形式上的概率分布的表现形式）</p></blockquote><p>所以使用基本概率方法可以求解二分类的问题的似然函数<br>$$\ell(w) = \prod_{i = 1}^{N} [\pi(x_i)]^{y_i}[1-\pi(x_i)]^{1-y_i}$$</p><blockquote><p>注解：说白就和算扔N次硬币，一个连续正反事件串的概率是多少一个含义</p></blockquote><p>看到乘法和指数，第一反应取对数，得到<strong>对数似然函数</strong><br>$$<br>L(w) = \sum_{i=1}^N{[y_ilog_a\pi(x_i) + (1-y_i)log_a(1-\pi(x_i))]}<br>$$</p><p>如果跟随我的步伐走到这一步，你会发现，这个形式，<strong>前半部分是“正例成立”的交叉熵，后半部是“反例成立”的交叉熵</strong>，说实话，叫做交叉熵和二项分布，伯努利过程分不开联系。在上面不远的地方已经详细定义了这几个符号代表的意思</p><p>我们发现，$-\frac{L(w)}{N}$ 就是我们一直使用的Objective function or Loss Function or Cost Function（加负号才是最终的形式）。总之，<strong>训练的目的就是要求能够使得这个函数达到最小的参数</strong>，最终的目的还是<strong>计算出模型参数</strong>，就是 $w$ ，这个参数在上方的统计学角度，和机器学习角度都进行的讨论，重复阅读可以链接这些知识点</p><p>至于LogLoss的好处，一是取对数之后，<strong>乘法边加法，指数放下来</strong>，是凸函数，方便可以寻找最优解。二是<strong>加快了收敛速度</strong>，这里有个形象的步长比喻，可以想象成去了对数后，缩小了尺度，可以让最快梯度下降法要走的距离变短</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】17min - 22min&lt;br&gt;【内容简介】从不同角度解释&lt;strong&gt;为何使用Logistic回归模型&lt;/strong&gt;，解读模型的&lt;strong&gt;现实意义&lt;/strong&gt;，详细解读&lt;strong&gt;为何使用&lt;/strong&gt;以及&lt;strong&gt;什么是&lt;/strong&gt;交叉熵损失函数。并详细梳理符号表达，对公式不再恐惧&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/tags/Machine-Learning/"/>
    
      <category term="Theory" scheme="https://charlesliuyx.github.io/tags/Theory/"/>
    
  </entry>
  
  <entry>
    <title>Xpath-Wiki</title>
    <link href="https://charlesliuyx.github.io/2017/08/28/Xpath%E4%BD%BF%E7%94%A8%E6%8C%87%E5%8D%97/"/>
    <id>https://charlesliuyx.github.io/2017/08/28/Xpath使用指南/</id>
    <published>2017-08-28T04:00:33.000Z</published>
    <updated>2017-10-06T01:32:59.666Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】查阅类文档<br>【内容简介】Xpath相关使用法法和例子文档，以供查阅（➜ 后是对应语句的输出output）</p><a id="more"></a><h1 id="XPath-相关例子Note"><a href="#XPath-相关例子Note" class="headerlink" title="XPath 相关例子Note"></a>XPath 相关例子Note</h1><h2 id="例子1"><a href="#例子1" class="headerlink" title="例子1"></a>例子1</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> lxml <span class="keyword">import</span> etree</span><br><span class="line">sample1 = <span class="string">"""&lt;html&gt;</span></span><br><span class="line"><span class="string">  &lt;head&gt;</span></span><br><span class="line"><span class="string">    &lt;title&gt;My page&lt;/title&gt;</span></span><br><span class="line"><span class="string">  &lt;/head&gt;</span></span><br><span class="line"><span class="string">  &lt;body&gt;</span></span><br><span class="line"><span class="string">    &lt;h2&gt;Welcome to my &lt;a href="#" src="x"&gt;page&lt;/a&gt;&lt;/h2&gt;</span></span><br><span class="line"><span class="string">    &lt;p&gt;This is the first paragraph.&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;!-- this is the end --&gt;</span></span><br><span class="line"><span class="string">  &lt;/body&gt;</span></span><br><span class="line"><span class="string">&lt;/html&gt;</span></span><br><span class="line"><span class="string">"""</span></span><br><span class="line"><span class="function"><span class="keyword">def</span> <span class="title">getxpath</span><span class="params">(html)</span>:</span></span><br><span class="line">    <span class="keyword">return</span> etree.HTML(html)</span><br><span class="line">s1 = getxpath(sample1)</span><br></pre></td></tr></table></figure><p><code>//</code>绝对路径 <code>text()</code> 获取内容中的文字信息<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath(<span class="string">'//title/text()'</span>) ➜ [<span class="string">'My page'</span>]</span><br></pre></td></tr></table></figure></p><p><code>/</code> 相对路径<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath(<span class="string">'/html/head/title/text()'</span>) ➜ [<span class="string">'My page'</span>]</span><br></pre></td></tr></table></figure></p><p>获取属性<code>src</code>的值<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath(<span class="string">'//h2/a/@src'</span>) ➜ [<span class="string">'x'</span>]</span><br></pre></td></tr></table></figure></p><p>获取所有属性<code>href</code>的值<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath(<span class="string">'//@href'</span>) ➜ [<span class="string">'#'</span>]</span><br></pre></td></tr></table></figure></p><p>获取网页中的<strong>所有文本</strong><br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath(<span class="string">'//text()'</span>)</span><br><span class="line">➜</span><br><span class="line">[<span class="string">'\n  '</span>,</span><br><span class="line"> <span class="string">'\n    '</span>,</span><br><span class="line"> <span class="string">'My page'</span>,</span><br><span class="line"> <span class="string">'\n  '</span>,</span><br><span class="line"> <span class="string">'\n  '</span>,</span><br><span class="line"> <span class="string">'\n    '</span>,</span><br><span class="line"> <span class="string">'Welcome to my '</span>,</span><br><span class="line"> <span class="string">'page'</span>,</span><br><span class="line"> <span class="string">'\n    '</span>,</span><br><span class="line"> <span class="string">'This is the first paragraph.'</span>,</span><br><span class="line"> <span class="string">'\n    '</span>,</span><br><span class="line"> <span class="string">'\n  '</span>,</span><br><span class="line"> <span class="string">'\n'</span>]</span><br></pre></td></tr></table></figure></p><p>获取网页中的<strong>所有注释</strong><br><figure class="highlight"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s1.xpath('//comment()') ➜ [&lt;!-- this is the end --&gt;]</span><br></pre></td></tr></table></figure></p><h2 id="例子2"><a href="#例子2" class="headerlink" title="例子2"></a>例子2</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">sample2 = <span class="string">"""</span></span><br><span class="line"><span class="string">&lt;html&gt;</span></span><br><span class="line"><span class="string">  &lt;body&gt;</span></span><br><span class="line"><span class="string">    &lt;ul&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;Quote 1&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;Quote 2 with &lt;a href="..."&gt;link&lt;/a&gt;&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;Quote 3 with &lt;a href="..."&gt;another link&lt;/a&gt;&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;&lt;h2&gt;Quote 4 title&lt;/h2&gt;Something here.&lt;/li&gt;</span></span><br><span class="line"><span class="string">    &lt;/ul&gt;</span></span><br><span class="line"><span class="string">  &lt;/body&gt;</span></span><br><span class="line"><span class="string">&lt;/html&gt;</span></span><br><span class="line"><span class="string">"""</span></span><br><span class="line">s2 = getxpath(sample2)</span><br></pre></td></tr></table></figure><p>获取所有<code>li</code>中的文本<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li/text()'</span>) ➜ [<span class="string">'Quote 1'</span>, <span class="string">'Quote 2 with '</span>, <span class="string">'Quote 3 with '</span>, <span class="string">'Something here.'</span>]</span><br></pre></td></tr></table></figure></p><p>获取第一个 第二个<code>li</code>中的文本，两种写法均可<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[position() = 1]/text()'</span>) ➜ [<span class="string">'Quote 1'</span>]</span><br></pre></td></tr></table></figure></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[1]/text()'</span>) ➜ [<span class="string">'Quote 1'</span>]</span><br></pre></td></tr></table></figure><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[position() = 2]/text()'</span>) ➜ [<span class="string">'Quote 2 with '</span>]</span><br></pre></td></tr></table></figure><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[2]/text()'</span>) ➜ [<span class="string">'Quote 2 with '</span>]</span><br></pre></td></tr></table></figure><p>奇数 偶数 最后一个<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[position() mod2 = 1]/text()'</span>) ➜ [<span class="string">'Quote 1'</span>, <span class="string">'Quote 3 with '</span>]</span><br></pre></td></tr></table></figure></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[position() mod2 = 0]/text()'</span>) ➜ [<span class="string">'Quote 2 with '</span>, <span class="string">'Something here.'</span>]</span><br></pre></td></tr></table></figure><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[last()]/text()'</span>) ➜ [<span class="string">'Something here.'</span>]</span><br></pre></td></tr></table></figure><p><code>li</code>下面<code>a</code>中的文本<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[a]/text()'</span>) ➜ [<span class="string">'Quote 2 with '</span>, <span class="string">'Quote 3 with '</span>]</span><br></pre></td></tr></table></figure></p><p><code>li</code>下<code>a</code>或者<code>h2</code>的文本<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//li[a or h2]/text()'</span>) ➜ [<span class="string">'Quote 2 with '</span>, <span class="string">'Quote 3 with '</span>, <span class="string">'Something here.'</span>]</span><br></pre></td></tr></table></figure></p><p>使用 | 同时获取 a 和 h2 中的内容<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s2.xpath(<span class="string">'//a/text()|//h2/text()'</span>) ➜ [<span class="string">'link'</span>, <span class="string">'another link'</span>, <span class="string">'Quote 4 title'</span>]</span><br></pre></td></tr></table></figure></p><h2 id="例子3"><a href="#例子3" class="headerlink" title="例子3"></a>例子3</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">sample3 = <span class="string">"""&lt;html&gt;</span></span><br><span class="line"><span class="string">  &lt;body&gt;</span></span><br><span class="line"><span class="string">    &lt;ul&gt;</span></span><br><span class="line"><span class="string">      &lt;li id="begin"&gt;&lt;a href="https://scrapy.org"&gt;Scrapy&lt;/a&gt;begin&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;&lt;a href="https://scrapinghub.com"&gt;Scrapinghub&lt;/a&gt;&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li&gt;&lt;a href="https://blog.scrapinghub.com"&gt;Scrapinghub Blog&lt;/a&gt;&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li id="end"&gt;&lt;a href="http://quotes.toscrape.com"&gt;Quotes To Scrape&lt;/a&gt;end&lt;/li&gt;</span></span><br><span class="line"><span class="string">      &lt;li data-xxxx="end" abc="abc"&gt;&lt;a href="http://quotes.toscrape.com"&gt;Quotes To Scrape&lt;/a&gt;end&lt;/li&gt;</span></span><br><span class="line"><span class="string">    &lt;/ul&gt;</span></span><br><span class="line"><span class="string">  &lt;/body&gt;</span></span><br><span class="line"><span class="string">&lt;/html&gt;</span></span><br><span class="line"><span class="string">"""</span></span><br><span class="line">s3 = getxpath(sample3)</span><br></pre></td></tr></table></figure><p>获取 <code>a</code> 标签下 <code>href</code> 以https开始的<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//a[starts-with(@href, "https")]/text()'</span>) ➜ [<span class="string">'Scrapy'</span>, <span class="string">'Scrapinghub'</span>, <span class="string">'Scrapinghub Blog'</span>]</span><br></pre></td></tr></table></figure></p><p>获取 <code>href</code>=<a href="https://scrapy.org" target="_blank" rel="noopener">https://scrapy.org</a><br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//li/a[@href="https://scrapy.org"]/text()'</span>) ➜ [<span class="string">'Scrapy'</span>]</span><br></pre></td></tr></table></figure></p><p>获取 <code>id</code> = begin<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//li[@id="begin"]/text()'</span>) ➜ [<span class="string">'begin'</span>]</span><br></pre></td></tr></table></figure></p><p>获取<code>text</code> = Scrapinghub<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//li/a[text()="Scrapinghub"]/text()'</span>) ➜ [<span class="string">'Scrapinghub'</span>]</span><br></pre></td></tr></table></figure></p><p>获取某个标签下 某个参数 = xx<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//li[@data-xxxx="end"]/text()'</span>) ➜ [<span class="string">'end'</span>]</span><br></pre></td></tr></table></figure></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s3.xpath(<span class="string">'//li[@abc="abc"]/text()'</span>) ➜ [<span class="string">'end'</span>]</span><br></pre></td></tr></table></figure><h2 id="例子4"><a href="#例子4" class="headerlink" title="例子4"></a>例子4</h2><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line">sample4 = <span class="string">u"""</span></span><br><span class="line"><span class="string">&lt;html&gt;</span></span><br><span class="line"><span class="string">  &lt;head&gt;</span></span><br><span class="line"><span class="string">    &lt;title&gt;My page&lt;/title&gt;</span></span><br><span class="line"><span class="string">  &lt;/head&gt;</span></span><br><span class="line"><span class="string">  &lt;body&gt;</span></span><br><span class="line"><span class="string">    &lt;h2&gt;Welcome to my &lt;a href="#" src="x"&gt;page&lt;/a&gt;&lt;/h2&gt;</span></span><br><span class="line"><span class="string">    &lt;p&gt;This is the first paragraph.&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="test"&gt;</span></span><br><span class="line"><span class="string">    编程语言&lt;a href="#"&gt;python&lt;/a&gt;</span></span><br><span class="line"><span class="string">    &lt;img src="#" alt="test"/&gt;javascript</span></span><br><span class="line"><span class="string">    &lt;a href="#"&gt;&lt;strong&gt;C#&lt;/strong&gt;JAVA&lt;/a&gt;</span></span><br><span class="line"><span class="string">    &lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="content-a"&gt;a&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="content-b"&gt;b&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="content-c"&gt;c&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="content-d"&gt;d&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;p class="econtent-e"&gt;e&lt;/p&gt;</span></span><br><span class="line"><span class="string">    &lt;!-- this is the end --&gt;</span></span><br><span class="line"><span class="string">  &lt;/body&gt;</span></span><br><span class="line"><span class="string">&lt;/html&gt;</span></span><br><span class="line"><span class="string">"""</span></span><br><span class="line">s4 = etree.HTML(sample4)</span><br></pre></td></tr></table></figure><p>获取 <code>class</code> = test 标签中的<strong>所有</strong>文字<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">s4.xpath(<span class="string">'//p[@class="test"]/text()'</span>)</span><br><span class="line">➜ [<span class="string">'\n    编程语言'</span>, <span class="string">'\n    '</span>, <span class="string">'javascript\n    '</span>, <span class="string">'\n    '</span>]</span><br></pre></td></tr></table></figure></p><p>使用<code>String</code>来获得文字段； <code>strip()</code> 移除字符串收尾字符，默认为空格<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">print</span> (s4.xpath(<span class="string">'string(//p[@class="test"])'</span>).strip())</span><br><span class="line">➜</span><br><span class="line">编程语言python</span><br><span class="line">    javascript</span><br><span class="line">    C<span class="comment">#JAVA</span></span><br></pre></td></tr></table></figure></p><p>获取所有<code>class</code>属性中<strong>以content开始</strong>的<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s4.xpath(<span class="string">'//p[starts-with(@class,"content")]/text()'</span>) ➜ [<span class="string">'a'</span>, <span class="string">'b'</span>, <span class="string">'c'</span>, <span class="string">'d'</span>]</span><br></pre></td></tr></table></figure></p><p>获取所有<code>class</code>属性中<strong>包含</strong>content的<br><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">s4.xpath((<span class="string">'//*[contains(@class,"content")]/text()'</span>)) ➜ [<span class="string">'a'</span>, <span class="string">'b'</span>, <span class="string">'c'</span>, <span class="string">'d'</span>, <span class="string">'e'</span>]</span><br></pre></td></tr></table></figure></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】查阅类文档&lt;br&gt;【内容简介】Xpath相关使用法法和例子文档，以供查阅（➜ 后是对应语句的输出output）&lt;/p&gt;
    
    </summary>
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/categories/Tools/"/>
    
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
      <category term="crawl" scheme="https://charlesliuyx.github.io/tags/crawl/"/>
    
  </entry>
  
  <entry>
    <title>PDF复制粘贴去除多余的回车符</title>
    <link href="https://charlesliuyx.github.io/2017/07/29/PDF%E5%A4%8D%E5%88%B6%E7%B2%98%E8%B4%B4%E5%8E%BB%E9%99%A4%E5%A4%9A%E4%BD%99%E7%9A%84%E5%9B%9E%E8%BD%A6%E7%AC%A6/"/>
    <id>https://charlesliuyx.github.io/2017/07/29/PDF复制粘贴去除多余的回车符/</id>
    <published>2017-07-29T15:03:08.000Z</published>
    <updated>2017-10-06T01:35:14.905Z</updated>
    
    <content type="html"><![CDATA[<p>直接上解决步骤，但是只能适用于Windows平台，Mac这边可以尝试用<a href="https://www.alfredapp.com/" target="_blank" rel="noopener">Alfred</a> + workflow来对剪切板操作来解决，或者用<a href="https://www.boastr.net/" target="_blank" rel="noopener">BetterTouchTool</a>的自带个性化功能来尝试。只是一个思路，没有在Mac系统尝试</p><a id="more"></a> <ul><li>下载 <a href="https://autohotkey.com/download/" target="_blank" rel="noopener">Autohotkey</a> ，安装（这一步都卡住那估计救不了了）</li><li>桌面右键 ➜ 新建 ➜ 创建新的AutoHotkey Script</li><li>右键创建的文件 ➜ 选择 Edit Script 出来一个记事本</li><li>编辑记事本文件，在已经有的内容下直接加上</li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line">#IfWinActive ahk_class classFoxitReader</span><br><span class="line">^c:: </span><br><span class="line">    old := ClipboardAll</span><br><span class="line">    clipboard := &quot;&quot;</span><br><span class="line">    send ^c</span><br><span class="line">    clipwait 0.1</span><br><span class="line">    if clipboard = </span><br><span class="line">        clipboard := old</span><br><span class="line">    else &#123;</span><br><span class="line">        tmp := RegExReplace(clipboard, &quot;(\S.*?)\R(.*?\S)&quot;, &quot;$1 $2&quot;)</span><br><span class="line">        clipboard := tmp</span><br><span class="line">        StringReplace clipboard, clipboard, % &quot;  &quot;, % &quot; &quot;, A</span><br><span class="line">        clipwait 0.1</span><br><span class="line">        &#125;</span><br><span class="line">    old := &quot;&quot;</span><br><span class="line">    tmp := &quot;&quot;</span><br><span class="line">return</span><br></pre></td></tr></table></figure><blockquote><p>这里有个问题 <code>IfWinActive ahk_class classFoxitReader</code> 第一行的<code>classFoxitReader</code> 是指的你用什么程序打开PDF </p><p>如果是FoxitReader就是<code>classFoxitReader</code> 如果是Acrobat Adobe就是<code>AcrobatSDIWindow</code></p><p>可以用Autohotkey中的  <a href="https://autohotkey.com/docs/commands/WinGetClass.htm" target="_blank" rel="noopener">WinGetClass</a> 来获得某一个窗口的<code>ahk_class</code></p></blockquote><ul><li>保存退出</li><li>桌面上双击你刚刚编辑的文件，可以看到右下角出现了一个<code>H</code>形状的图标</li></ul><p>大功告成，这时候你再试试去PDF文档里面<code>ctrl + c</code>就没有回车符了（当然，段落还是无法区分的），也不一定，这一段既然是脚本语言，那就有无限的可能性，就看你的算法实现能力了对吧！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;直接上解决步骤，但是只能适用于Windows平台，Mac这边可以尝试用&lt;a href=&quot;https://www.alfredapp.com/&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;Alfred&lt;/a&gt; + workflow来对剪切板操作来解决，或者用&lt;a href=&quot;https://www.boastr.net/&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;BetterTouchTool&lt;/a&gt;的自带个性化功能来尝试。只是一个思路，没有在Mac系统尝试&lt;/p&gt;
    
    </summary>
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/categories/Tools/"/>
    
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/tags/Tools/"/>
    
      <category term="Autohotkey" scheme="https://charlesliuyx.github.io/tags/Autohotkey/"/>
    
  </entry>
  
  <entry>
    <title>LeetcodeNote</title>
    <link href="https://charlesliuyx.github.io/2017/07/01/LeetcodeNote/"/>
    <id>https://charlesliuyx.github.io/2017/07/01/LeetcodeNote/</id>
    <published>2017-06-30T16:18:41.000Z</published>
    <updated>2017-10-06T01:36:36.434Z</updated>
    
    <content type="html"><![CDATA[<p>算法培训课程基本模型汇总笔记</p><a id="more"></a><h1 id="线"><a href="#线" class="headerlink" title="线"></a>线</h1><h2 id="基本模型"><a href="#基本模型" class="headerlink" title="基本模型"></a>基本模型</h2><h3 id="数学归纳法"><a href="#数学归纳法" class="headerlink" title="数学归纳法"></a>数学归纳法</h3><h1 id="树"><a href="#树" class="headerlink" title="树"></a>树</h1><h2 id="基本模板"><a href="#基本模板" class="headerlink" title="基本模板"></a>基本模板</h2><ul><li>Draw/Equation -&gt; Tree shape</li><li>Define TreeNode <ul><li>本点信息必然是辅助变量，计入TreeNode</li><li>孩子信息决定TreeNode的形状</li><li>任何第一次走的节点，如果不能走，一定要画出来打一把叉</li></ul></li></ul><h3 id="Binary-Search"><a href="#Binary-Search" class="headerlink" title="Binary Search"></a>Binary Search</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="function">Public <span class="keyword">int</span> <span class="title">func</span><span class="params">(T[] array, V tartget )</span></span>&#123;</span><br><span class="line"><span class="keyword">int</span> pos = -<span class="number">1</span>;</span><br><span class="line"><span class="keyword">int</span> start = <span class="number">0</span>;</span><br><span class="line"><span class="keyword">int</span> end array.length - <span class="number">1</span>;</span><br><span class="line"><span class="keyword">while</span> ( start &lt;= end )&#123;</span><br><span class="line"><span class="keyword">int</span> mid = start + (end - start)/<span class="number">2</span>;</span><br><span class="line"><span class="keyword">if</span> ( f(a[mid]) &lt;= target )&#123;</span><br><span class="line">pos = mid;</span><br><span class="line">start = mid + <span class="number">1</span>;</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line">end = mid - <span class="number">1</span>;</span><br><span class="line">   &#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">return</span> pos;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="Bottom-up-Recursion"><a href="#Bottom-up-Recursion" class="headerlink" title="Bottom up - Recursion"></a>Bottom up - Recursion</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> &lt;T_P&gt; func(T_v_1, v1 …)&#123;</span><br><span class="line">checkhastreeNode();</span><br><span class="line"><span class="keyword">return</span> helper(root(T_v_1, v_1, …))</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">private</span> &lt;T_P&gt; helper(T_v_1, v1, …)&#123;</span><br><span class="line">resultchildfirst = helper(childFirst);</span><br><span class="line">…</span><br><span class="line">resultchildlast = helper(childLast);</span><br><span class="line"></span><br><span class="line">-&gt; result by childs</span><br><span class="line"><span class="comment">//generate cur node's result;</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">return</span> result;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="DFS"><a href="#DFS" class="headerlink" title="DFS"></a>DFS</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DFSTree</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> Type_R <span class="title">func</span><span class="params">(T_1, e1, T_2, e2)</span></span>&#123;</span><br><span class="line">checkrootexists();</span><br><span class="line"></span><br><span class="line">TreeNode[] array = <span class="keyword">new</span> TreeNode[TREE_HEIGHT];</span><br><span class="line"></span><br><span class="line">Stack&lt;TreeNode&gt; stack = Stack&lt;&gt;();</span><br><span class="line">stack.push(root);</span><br><span class="line"><span class="keyword">while</span> (!stack.Empty())&#123;</span><br><span class="line">TreeNode curNode = stack.pop();</span><br><span class="line"></span><br><span class="line">Operation at node;</span><br><span class="line"></span><br><span class="line">stack.push(childLast);</span><br><span class="line">…</span><br><span class="line">stack.push(childFirst);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">return</span> result;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">private</span> <span class="class"><span class="keyword">class</span> <span class="title">TreeNode</span></span>&#123;</span><br><span class="line">T_V_1 field_1;</span><br><span class="line">…</span><br><span class="line">T_V_q field_q;</span><br><span class="line"></span><br><span class="line"><span class="keyword">int</span> _height;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="BFS"><a href="#BFS" class="headerlink" title="BFS"></a>BFS</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">BFS</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> TypeR <span class="title">func</span><span class="params">(T_1 v_1, T_p, v_p)</span> </span>&#123;</span><br><span class="line">checkexistroot();</span><br><span class="line"></span><br><span class="line">Queue&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">queue.add(root);</span><br><span class="line"></span><br><span class="line"><span class="keyword">while</span> ( !queue.isEmpty() )&#123;</span><br><span class="line"></span><br><span class="line"><span class="keyword">int</span> size = queue.size();</span><br><span class="line"><span class="keyword">for</span> ( <span class="keyword">int</span> I = <span class="number">0</span>; I &lt; size; i++ )&#123;</span><br><span class="line">TreeNode node = queue.remove();</span><br><span class="line"></span><br><span class="line">op at node;</span><br><span class="line"></span><br><span class="line">queue.add(childFirst);</span><br><span class="line">…</span><br><span class="line">queue.add(childLast);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">update var_l,…,var_k <span class="keyword">for</span> next level</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">return</span> result;</span><br><span class="line"></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">private</span> <span class="class"><span class="keyword">class</span> <span class="title">TreeNode</span></span>&#123;</span><br><span class="line">T_1 field_1;</span><br><span class="line">…</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h1 id="图"><a href="#图" class="headerlink" title="图"></a>图</h1><h2 id="基本模板-1"><a href="#基本模板-1" class="headerlink" title="基本模板"></a>基本模板</h2>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;算法培训课程基本模型汇总笔记&lt;/p&gt;
    
    </summary>
    
      <category term="Algorithm" scheme="https://charlesliuyx.github.io/categories/Algorithm/"/>
    
    
      <category term="Algorithm" scheme="https://charlesliuyx.github.io/tags/Algorithm/"/>
    
      <category term="Leetcode" scheme="https://charlesliuyx.github.io/tags/Leetcode/"/>
    
  </entry>
  
  <entry>
    <title>幕布-全平台笔记思维导图工具</title>
    <link href="https://charlesliuyx.github.io/2017/06/17/%E5%B9%95%E5%B8%83-%E5%85%A8%E5%B9%B3%E5%8F%B0%E7%AC%94%E8%AE%B0%E6%80%9D%E7%BB%B4%E5%AF%BC%E5%9B%BE%E5%B7%A5%E5%85%B7/"/>
    <id>https://charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/</id>
    <published>2017-06-17T02:30:47.000Z</published>
    <updated>2017-10-06T01:35:41.947Z</updated>
    
    <content type="html"><![CDATA[<p>利益相关：幕布深度使用用户</p><p>向大家强烈自来水一款从知乎上了解到的<strong>效率神器</strong>：<strong><a href="https://mubu.com/inv/121749" target="_blank" rel="noopener">幕布</a></strong>，简直相见恨晚，自从它4月正式上线后就一直使用，对我的日常生活、学习和计划帮助巨大（个人情况：硕士CE在读，ML方向，效率至上主义者，简约UI风格拥护者）</p><p><strong>幕布</strong>是一款<strong>思维管理工具</strong>，可以用来<strong>做笔记</strong>，<strong>梳理思路</strong>，<strong>做待办事项</strong>等等等等。</p><a id="more"></a><p>人类的记忆是有缺陷的，计算机能帮助人进行记忆。我们可以记住大方向的条目，再借助一个<strong>笔记软件</strong>来唤起我们的记忆。<strong>树形结构</strong>是一种极为高效的模式及手段。</p><p>笔记软件很多，思维导图软件很多，但是<strong>能同时满足</strong>以下几点的我找了很久都没有找到，直到遇到<strong>幕布</strong>。如果你和我也有同样的需求，真心的希望这款优秀的软件能帮助到你，提高的你的日常效率，让每一次阅读，每一个计划都高效落地</p><h2 id="UI简约，专注于层次输入本身"><a href="#UI简约，专注于层次输入本身" class="headerlink" title="UI简约，专注于层次输入本身"></a>UI简约，专注于层次输入本身</h2><p>幕布的官网是这样的：</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/MainPage.webp" alt="幕布官网" title="">                </div>                <div class="image-caption">幕布官网</div>            </figure><p>幕布作为一款笔记软件编辑界面是这样的，幕布专注于<strong>层次化输入</strong>，每一个输入对于幕布来说都是一个<strong>条目</strong>，条目就是我们进行知识梳理的主干</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/EditPage.png" alt="幕布编辑界面" title="">                </div>                <div class="image-caption">幕布编辑界面</div>            </figure><p>每一个操作都<strong>提倡使用快捷键</strong>，拒绝鼠标 + 键盘混用带来的输入思路打断的低效率</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/ShortCut.png" alt="幕布快捷键页面" title="">                </div>                <div class="image-caption">幕布快捷键页面</div>            </figure><h2 id="全平台，云存储和同步，客户端离线编辑"><a href="#全平台，云存储和同步，客户端离线编辑" class="headerlink" title="全平台，云存储和同步，客户端离线编辑"></a>全平台，云存储和同步，客户端离线编辑</h2><p>答主因为同时使用各种设备：12.9寸iPad，Mac，Windows + Linux 台式机和iPhone手机几个工作平台，平常使用电脑进行笔记记录，碎片化时间使用个手机进行背诵记忆等，需要一款全平台的笔记软件。</p><p>而幕布，只要有<strong>浏览器</strong>，有网络就能流畅使用，有离线需求的用户，也可以通过客户端的形式满足日常编辑的需求。</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/Platform.png" alt="幕布全平台" title="">                </div>                <div class="image-caption">幕布全平台</div>            </figure><h2 id="一键生成思维导图"><a href="#一键生成思维导图" class="headerlink" title="一键生成思维导图"></a>一键生成思维导图</h2><p>选择幕布的重要理由之一，废话不多说，上Gif！</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/mindmaps.gif" alt="幕布快捷键页面" title="">                </div>                <div class="image-caption">幕布快捷键页面</div>            </figure><p>用过各种软件，<a href="https://coggle.it/" target="_blank" rel="noopener">Coggle</a>是UI最漂亮的，但是基本的演示需求幕布完全可以满足，清楚明了</p><hr><p>那么话说回来了，幕布可以用来干什么呢？下面就展示几个主要应用场景（有我自己的，也有来自于<a href="https://mubu.com/doc/explore/55" target="_blank" rel="noopener">幕布使用趣味案例</a>）</p><p>首先，官网给出了一份<a href="https://mubu.com/doc/explore/56" target="_blank" rel="noopener">幕布产品引导</a>，其中详细介绍了幕布的使用场景</p><ul><li>读书笔记</li><li>方案计划</li><li>流程说明</li><li>等等</li></ul><hr><p>下面案例一些答主自己日常的一些<strong>特殊</strong>使用场景，基本应用比如做笔记，待办事项，做日程规划等不一一列出来了，就是基本的笔记需求。</p><h2 id="TED演讲笔记"><a href="#TED演讲笔记" class="headerlink" title="TED演讲笔记"></a>TED演讲笔记</h2><p>没有遇到幕布之前，我经常看TED的各种演讲，用于开拓视野，进行英语表达的积累，做笔记的速度太慢，太不方便，遇到幕布之后，我将TED的视频中很关键的内容记录成幕布的条目层次，之后<strong>利用碎片化的时间使用手机客户端进行记忆和背诵</strong>，极大的丰富了我的谈资（<strong>记住的东西才能侃，有条理有依据的说辞才有说服力</strong>）</p><p><a href="https://mubu.com/doc/2LGkymz_vl" target="_blank" rel="noopener">埃里克 哈世延：下一个科学界大突破是什么</a></p><p>对于这个TED笔记例子</p><ul><li>演讲人大体思路</li><li>经典的<strong>单句</strong>和<strong>例子</strong>（中英文）</li></ul><p>另一方面，因为幕布的全平台特性，我会用碎片化的时间利用电脑端的幕布来进行背诵（TED的演讲内容对于<strong>积累对应领域的英文表达方式</strong>有很大的帮助）</p><h2 id="程序设计和Presentation"><a href="#程序设计和Presentation" class="headerlink" title="程序设计和Presentation"></a>程序设计和Presentation</h2><p>编程前先走流程和功能设计是我平时的习惯，这里有一个很简单的Server-Client模式的练习设计用法：设计程序功能，直接一键思维导图展示，PPT完全不用做了，非常愉悦</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/progd.png" alt="程序Feature" title="">                </div>                <div class="image-caption">程序Feature</div>            </figure><p><img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/progp.png" alt="程序演示"></p><h2 id="Dota2-Wiki"><a href="#Dota2-Wiki" class="headerlink" title="Dota2 Wiki"></a>Dota2 Wiki</h2><p>在国外我发现Dota2维基十分的给力，作为Dota2玩家有一些施法距离，施法机制等有时候需要查看（进阶），但是使用网站一方面内容太多，国内访问实在太慢了，而且<strong>搜索功能</strong>也做的不好，至于我做了什么事情，各位看gif自行感受</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/dota.gif" alt="Dota2" title="">                </div>                <div class="image-caption">Dota2</div>            </figure><p>【利益相关：正在制作，预计Ti7前可以上线，希望也能通过数据帮助到中国军团吧，作为一个做计算机的程序员也希望贡献自己的一份力量】</p><h2 id="期末考试复习"><a href="#期末考试复习" class="headerlink" title="期末考试复习"></a>期末考试复习</h2><p>幕布可以帮助我们把书读薄，我们知道所有的书的特点就是具有层次化，每一本非常优秀的教材都有一套自己对于本学科的<strong>知识体系的理解和层次化抽象</strong>，之前我进行期末复习需要的时间大概是7天左右，有了幕布可以把时间缩减为3天或者更短</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/Final1.png" alt="期末复习笔记总览" title="">                </div>                <div class="image-caption">期末复习笔记总览</div>            </figure><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/Final2.png" alt="期末复习笔记具体内容" title="">                </div>                <div class="image-caption">期末复习笔记具体内容</div>            </figure><h2 id="幕布精选"><a href="#幕布精选" class="headerlink" title="幕布精选"></a>幕布精选</h2><p>在幕布里，学习知乎模式，你也可以分享自己中意的作品，获得点赞，在后面讨论，甚至有打赏功能，因为软件本身还很年轻，一切还在发展阶段，对于我本人来说，幕布精选的内容只是锦上添花，我个人不太需求这个功能，但是其中还有一份驾考总结挺有用的，哈哈</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/mubuchoice.png" alt="幕布精选" title="">                </div>                <div class="image-caption">幕布精选</div>            </figure><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/06/17/幕布-全平台笔记思维导图工具/mubureward.png" alt="幕布精选打赏功能" title="">                </div>                <div class="image-caption">幕布精选打赏功能</div>            </figure><h2 id="总结和杂七杂八"><a href="#总结和杂七杂八" class="headerlink" title="总结和杂七杂八"></a>总结和杂七杂八</h2><p>我现在的习惯是，只要是读微信公众号的文章，做笔记，读书等，都会用幕布进行记录和整理，感觉提升效率十分明显（节省了我30-40%左右的时间，每天）</p><p>幕布提高我的三个能力</p><ul><li>整理和总结的能力【如何把书读薄】</li><li>层次化思维能力【有组织的整理自己的知识体系和思路模式，加强效率，节省时间】</li><li>背诵能力【全平台（手机），我对碎片化时间能有效利用，我可以多次<strong>重复</strong>背诵需要背诵的内容】</li></ul><p>最后，谢谢你阅读本答案到这个位置，对于我来说，幕布这种层次化的思维模式解决了我当年考高考时候的问题：<strong>什么学习方法是最好的？</strong>我觉得幕布的层次化整理知识的能力就是答案，<strong>幕布提供的是一张纸，一支笔，最后使用幕布能把你的学习生活提升到什么程度，完全取决于你的能力本身</strong>，幕布只是工具，帮助你整理你的大脑，帮你进行背诵，方便查阅。</p><p>工具永远是工作，创造效益的永远是你，未来也是人创造的，不是工具。</p><p>【利益相关，<strong>使用我的幕布分享链接可以获得15天的免费高级版试用机会</strong>，跪求点击注册！hohohohoho】</p><p><a href="https://mubu.com/inv/121749" target="_blank" rel="noopener">我的分享链接</a> </p><p>幕布，绝对是一个<strong>神器</strong>，希望能帮助到各位，提升效率，创造更大的价值！</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;利益相关：幕布深度使用用户&lt;/p&gt;
&lt;p&gt;向大家强烈自来水一款从知乎上了解到的&lt;strong&gt;效率神器&lt;/strong&gt;：&lt;strong&gt;&lt;a href=&quot;https://mubu.com/inv/121749&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;幕布&lt;/a&gt;&lt;/strong&gt;，简直相见恨晚，自从它4月正式上线后就一直使用，对我的日常生活、学习和计划帮助巨大（个人情况：硕士CE在读，ML方向，效率至上主义者，简约UI风格拥护者）&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;幕布&lt;/strong&gt;是一款&lt;strong&gt;思维管理工具&lt;/strong&gt;，可以用来&lt;strong&gt;做笔记&lt;/strong&gt;，&lt;strong&gt;梳理思路&lt;/strong&gt;，&lt;strong&gt;做待办事项&lt;/strong&gt;等等等等。&lt;/p&gt;
    
    </summary>
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/categories/Tools/"/>
    
    
      <category term="Tools" scheme="https://charlesliuyx.github.io/tags/Tools/"/>
    
      <category term="Mubu" scheme="https://charlesliuyx.github.io/tags/Mubu/"/>
    
  </entry>
  
  <entry>
    <title>深入浅出看懂AlphaGo如何下棋</title>
    <link href="https://charlesliuyx.github.io/2017/05/27/AlphaGo%E8%BF%90%E8%A1%8C%E5%8E%9F%E7%90%86%E8%A7%A3%E6%9E%90/"/>
    <id>https://charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/</id>
    <published>2017-05-27T03:51:22.000Z</published>
    <updated>2018-03-03T22:25:23.550Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读时间】15min 8506 words<br>【阅读内容】针对论文AlphaGo第一版本，进行了详细的说明和分析，力求用通俗移动的语言让读者明白：AlphaGo是如何下棋的</p><a id="more"></a><h1 id="问题分析"><a href="#问题分析" class="headerlink" title="问题分析"></a>问题分析</h1><p>围棋问题，棋盘 <code>19 * 19 = 361</code> 个交叉点可供落子，每个点三种状态，白（用<code>1</code>表示），黑（用<code>-1</code>表示），无子（用<code>0</code>表示），用 $\vec s$ <strong>描述</strong>此时<strong>棋盘的状态</strong>，即棋盘的<strong>状态向量</strong>记为 $ \vec s$ （state首字母）。</p><p>$$<br>\vec s = (\underbrace{1,0,-1,\ldots}_{\text{361}})\tag {1-1}<br>$$<br>假设状态 $\vec s$ 下，暂不考虑不能落子的情况， 那么下一步可走的位置空间也是361个。将下一步的<strong>落子行动</strong>也用一个361维的向量来表示，记为 $\vec a$ （action首字母）。<br>$$<br>\vec a = (0,\ldots,0,1,0,\ldots)\tag {1-2}<br>$$<br>公式1.2 假设其中<code>1</code>在向量中位置为<code>39</code>，则  $\vec a$ 表示在棋盘<code>(3,1)</code>位置落<strong>白子</strong>，3为横坐标，1为列坐标</p><p>有以上定义，我们就把围棋问题转化为。</p><blockquote><p>任意给定一个状态  $\vec s$ ，寻找最优的应对策略  $\vec a$ ，最终可以获得棋盘上的最大地盘</p></blockquote><blockquote><p>总之</p><p>看到 $\vec s$ ，脑海中就是<strong>一个棋盘，上面有很多黑白子</strong></p><p>看到 $\vec a$ ，脑海中就想象一个人<strong>潇洒的落子</strong></p></blockquote><p>接下来的问题是，如何解决这样一个问题呢？</p><p>先上论文！干货第一</p><p><a href="http://ai.arizona.edu/sites/ai/files/resources/mastering_the_game_of_go_with_deep_neural_networks_and_tree_search.pdf" target="_blank" rel="noopener">Mastering the game of Go with deep neural networks and tree search</a></p><h1 id="问题解决"><a href="#问题解决" class="headerlink" title="问题解决"></a>问题解决</h1><p>首先想到，棋盘也是一幅图像，那么在当时最好用的图像处理算法就是<strong>深度卷积神经网络</strong>（Deep Convolutional Neural Network）。</p><h2 id="深度卷积神经网络——策略函数（Policy-Network）"><a href="#深度卷积神经网络——策略函数（Policy-Network）" class="headerlink" title="深度卷积神经网络——策略函数（Policy Network）"></a>深度卷积神经网络——策略函数（Policy Network）</h2><p>关于什么是<code>CNN</code>，这篇文章十分靠谱，深入浅出的讲解了什么是<code>CNN</code></p><p><a href="http://www.kdnuggets.com/2016/11/intuitive-explanation-convolutional-neural-networks.html" target="_blank" rel="noopener">An Intuitive Explanation of Convolutional Neural Networks</a> （好像<a href="https://ujjwalkarn.me/2016/08/11/intuitive-explanation-convnets/" target="_blank" rel="noopener">原地址</a>挂了）（5.29更新，原地址已经恢复，原地址的排版更好，估计之前那个博主在进行博客的整理）</p><p>大致可以理解为：</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/CNN.png" alt="CNN例子" title="">                </div>                <div class="image-caption">CNN例子</div>            </figure><p>对一副图像进行处理，给定很多样本进行训练，使得最后的神经网络可以获得指定（<strong>具有分类效果</strong>）的输出。</p><p>比如，根据上图可以观察到（这是一个已经训练好的神经网络），最右侧的<strong>输出</strong>是<code>[0.01 , 0.04 , 0.94 , 0.02]</code>，其中第三个值<code>0.94</code>代表的是boat，接近1，所以我们判断这幅图片中有船这个物体（类似的，如果使用这幅图像进行训练，那么<strong>指定</strong>输出应该是[0, 0, 1, 0]，因为图中只有船这个物体）</p><ul><li>在Deep Learning中，卷积层的中的<strong>Filter</strong>也需要<strong>训练</strong>，也就是说<strong>我们使用已有数据来学习图像的关键特征，这样，就可以把网络的规模大幅度的降低</strong></li></ul><p>总而言之，<strong><code>CNN</code>可以帮助我们提取出图像中有实际含义的特征</strong>，那么这和围棋又有什么关系呢？我们来看看Deepmind团队是怎么运用<code>CNN</code>来解决围棋问题。</p><h3 id="深度卷积神经网络解决围棋问题"><a href="#深度卷积神经网络解决围棋问题" class="headerlink" title="深度卷积神经网络解决围棋问题"></a>深度卷积神经网络解决围棋问题</h3><p>2015年，<code>Aja Huang</code>在ICLR的论文<a href="https://arxiv.org/pdf/1412.6564.pdf" target="_blank" rel="noopener">Move Evaluation in Go Using Deep Convolutional Neural Networks</a>中就提出了如何使用<code>CNN</code>来解决围棋问题。</p><p>他从围棋对战平台KGS上获得了人类选手的围棋对弈棋谱，对于每一个状态 $ \vec s$，都会有一个人类进行 $ \vec a$ 的落子，这也就是一个天然训练样本 $ \langle \vec s,\vec a\rangle $，如此可以得到3000万个训练样本。</p><p>之后，将 $ \vec s$ 看做一个<code>19*19</code>的二维图像（具体实现依据论文输入数据是<code>19*19*48</code>（48是这个位置的其他信息，比如气等信息，激励函数用的 tanh）使用<code>CNN</code>进行训练，目标函数就是人类落子向量 ${\vec a}’$，通过使用海量的数据，不断让计算机接近人类落子的位置。就可以得到一个<strong>模拟</strong>人类棋手下棋的神经网络。</p><p>使用训练的结果，我们可以得到一个神经网络用来计算对于每一个当前棋盘状态 $ \vec s$ ，所对应的落子向量 $ \vec a$ 的概率分布（之所以是概率分布，是因为，计算好的神经网络，输出一般是一个0-1之间的浮点数，越接近1的点表示在这个位置越接近人类的风格，也可以等同于作为人类概率最大的落点。<br>$$<br>\vec a=f(\vec s) \tag{2-1}<br>$$<br>根据公式2.1，我们记 $f()$ 为$P_{human}(\vec s)$ ，论文中也叫做<code>Policy Network</code>，也称策略函数。表示的含义是</p><blockquote><p>在状态 $\vec s$ 下，进行哪一个落子 $\vec a$ 是<strong>最接近人类风格的</strong></p></blockquote><p>计算出来的直观结果，对应到棋盘上如下图，可以看到，红色的区域的值有60%，次大值位于右方，是35%（此图来自于AlphaGo论文）</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/PolicyNetwork.png" alt="Policy Network" title="">                </div>                <div class="image-caption">Policy Network</div>            </figure><p>还记得刚刚举得船图的例子嘛？可以类比一下，机器发现现在的状态 $ \vec s$ 和之前的某一种类型有些类似，输出是一个<code>1*361</code>的向量，其中有几个值比较大（接近1就是100%），那么就用这个值当做下一个 $ \vec a$ 的位置。不幸的，这种训练方法有很大的局限的，可以直观想到的是，如果对战平台上数据本身就都是<code>俗手</code>，那不是训练出来一个很蠢的神经网络嘛？棋力如何呢？</p><h3 id="深度卷积网络策略的棋力"><a href="#深度卷积网络策略的棋力" class="headerlink" title="深度卷积网络策略的棋力"></a>深度卷积网络策略的棋力</h3><p>很不幸，据<code>Aja Huang</code>本人说，这个网络的棋力大概相当于业余6段所有的的人类选手。远远未能超过当时最强的围棋电脑程序<code>CrazyStone</code>。</p><p>既然比不过，那么就学习它，<code>Aja Huang</code>打算把 $P_{human}(\vec s)$ 和<code>CrazyStone</code>结合一下，那么问题就来了，    <code>CrazyStone</code>是怎么来解决围棋问题的呢？</p><p>这是<code>Aja Huang</code>的老师<code>Remi Colulum</code>在2006年对围棋AI做出的另一大重要突破</p><p><strong>干货论文送上</strong> MCTS</p><p><a href="https://github.com/papers-we-love/papers-we-love/blob/5a54fa883a813e81b1e54bfed9669fc8961dedb4/artificial_intelligence/efficient-selectivity-and-backup-operators-in-monte-carlo-tree-search.pdf" target="_blank" rel="noopener">Efficient Selectivity and Backup Operators in Monte-Carlo Tree Search</a></p><h2 id="MCTS-蒙特卡洛搜索树——走子演算（Rollout）"><a href="#MCTS-蒙特卡洛搜索树——走子演算（Rollout）" class="headerlink" title="MCTS 蒙特卡洛搜索树——走子演算（Rollout）"></a>MCTS 蒙特卡洛搜索树——走子演算（Rollout）</h2><p>蒙特卡洛搜索树（Monte-Carlo Tree Search）是一种<em>大智若愚</em>的方法，它的基本思想是：</p><p>首先模拟一盘对决，使用的思路很简单，<strong>随机</strong></p><ul><li>面对一个空白棋盘 $\vec s_0$，最初我们对棋盘一无所知，假设所有落子的方法<strong>分值</strong>都相等，设为<code>1</code></li><li>之后，<strong>【随机】</strong>从<code>361</code>种方法中选一种走法 $\vec a_0$，在这一步后，棋盘状态变为 $\vec s_1$。之后假设对方也和自己一样，<strong>【随机】</strong>走了一步，此时棋盘状态变为 $\vec s_2$</li><li>重复以上步骤直到 $\vec s_n$并且双方分出胜负，此时便完整的模拟完了一盘棋，我们假设一个变量<code>r</code>，胜利记为1，失败则为0</li></ul><p>那么问题就来了，如果这一盘赢了，那意味着这一连串的下法至少比对面那个二逼要明智一些，毕竟我最后赢了，那么我把这次落子方法 $(\vec s_0, \vec a_0)$ 记下来，并把它的分值变化：<br>$$<br>\text{新分数} = \text{初始分数} + r \tag{2-2}<br>$$<br>同理，可以把之后所有随机出来的落子方法 $(\vec s_i, \vec a_i)$ 都应用2-2公式，即都加<code>1</code>分。之后开始第二次模拟，这一次，我们对棋盘不是一无所知了，至少在  $\vec s_0$ 状态我们知道落子方法  $\vec a_0$ 的分值是2，其他都是1，我们使用这个数据的方法是：在这次<strong>随机</strong>中，<strong>我们随机到  $\vec a_0$ 状态的概率要比其他方法高一点</strong>。</p><p>之后，我们不断重复以上步骤，这样，那些看起来不错（以最后的胜负来作为判断依据）的落子方案的分数就会越来越高，并且这些落子方案也是比较有前途的，会被更多的选择。</p>$$score(\vec s) = \begin{pmatrix}r_{11} & r_{12}  & \cdots & r_{1n} \\r_{21} & r_{22}  & \cdots & r_{2n} \\\vdots  & \vdots & \ddots & \vdots \\r_{n1} & r_{n2}  & \cdots & r_{nn} \end{pmatrix}$$<blockquote><p>如上述公式所述，<code>n=19</code>，每一个状态 $\vec s$ 都有一个对应的每个落子点的分数，只要模拟量足够多，那么可以覆盖到的 $\vec s$ 状态就越多，漏洞就越来越小（可以思考李世石的神之一手，是否触及到了AlphaGo1.0的软肋呢？即没有考虑到的状态 $\vec s$ ）</p></blockquote><p>最后，当进行了10万盘棋后，在此状态选择那个<strong>分数最高</strong>的方案落子，此时，才真正下了<strong>这步棋</strong>。这种过程在论文里被称为<strong>Rollout</strong></p><p>蒙特卡洛搜索树的方法十分的深刻精巧，充满的创造力，它有一些很有意思的特点：</p><ul><li>没有任何人工决策的<code>if else</code>逻辑，完全依照规则本身，通过不断的想象（随机）来进行自我对弈，最后提升这一步的质量。有意思的是，其实这也是遵照了人类下棋的思维模式（<strong>模仿</strong>，只是这一次模仿的不是下棋风格，而是人类思考的方式。十分奇妙，人从飞鸟中受到启发发明了飞机，从鱼身上受到启发发明了潜艇，现在，机器学习的程序，通过学习人类使自身发生进化），人类中，水平越高的棋手，算的棋越多，只是人类对于每一个落子的判断能力更加强大，思考中的棋路，也比<strong>随机</strong>方式有效的多，但是机器胜在量大，暴力的覆盖到了很多情况。<em>注意，这一个特点也为之后的提高提供了思路</em>。</li><li>MCTS可是持续运行。这种算法在对手思考对策的时候自己也可以思考对策。在对方思考落子的过程中，MCTS也可以继续进行演算，在对面落子后，在用现在棋盘的情况进行演算，并且之前计算的结果一定可以用在现在情况中，因为对手的下的这步棋，很可能也在之前演算的高分落子选择内。这一点十分像人类</li><li>MCTS是<strong>完全可并行</strong>的算法</li></ul><p><code>Aja Huang</code>很快意识到这种方法的缺陷在哪里：初始策略（或者说<strong>随机的落子方式</strong>）太过简单。就如同上面第一条特点所说，人类对每种  $\vec s$ （棋型）都要更强的判断能力，那么我们是否可以用 $P_{human}(\vec s)$ 来代替随机呢？</p><p><code>Aja Huang</code>改进了MCTS，每一步不使用随机，而是现根据 $P_{human}(\vec s)​$ 计算得到  $\vec a​$ 可能的概率分布，以这儿概率为准来挑选下一个  $\vec a​$。一次棋局下完之后，新分数按照下面的方式来更新<br>$$<br>\text{新分数} = \text{调整后的初始分} + \text{通过模拟的赢棋概率} \tag{2-3}<br>$$<br>如果某一步被随机到很多次，就应该主要依据模拟得到的概率而非 $P_{human}(\vec s)$ ，就是说当盘数不断的增加，模拟得到的结果可能会好于 $P_{human}(\vec s)$ 得到的结果。<br><a name="2-4"></a><br>所以 $P_{human}(\vec s)$ 的初始分会被打个折扣，这也是公式2-3中的调整后的初始分的由来<br> $$\text{调整后的初始分} = \frac{P_{human}(\vec s)}{(\text{被随机到的次数} + 1)} \tag{2-4}$$<br>如此一来，就在整张地图上利用 $P_{human}(\vec s)$ 快速定位了比较好的落子方案，也增加了其他位置的概率。实际操作中发现，此方案不可行，因为计算这个 $P_{human}(\vec s)$ <strong>太慢了太慢了</strong></p><p>一次 $P_{human}(\vec s)$ 的计算需要<code>3ms</code>，随机算法<code>1us</code>，慢了3000倍，所以，<code>Aja huang</code>训练了一个简化版本的 $P_{human-fast}(\vec s)$ ，把神经网络层数、输入特征减少，耗时下降到<code>2us</code>，基本满足了要求。</p><p>更多的，策略是，先以 $P_{human}(\vec s)$ 开局，走前面大概20步，之后再使用 $P_{human-fast}(\vec s)$ 走完剩下的到最后。兼顾速度和准确性。</p><p>综合了深度卷积神经网络和MCTS两种方案，此时的围棋程序已经可以战胜所有其他电脑，虽然和其他人类职业选手还有一定的差距。</p><p>2015年2月，<code>Aja Huang</code>在Deepmind的同事在顶级学术期刊nature上发表的文章 <a href="http://gnusha.org/~nmz787/pdf/Human-level_control_through_deep_reinforcement_learning.pdf" target="_blank" rel="noopener">Human-level control through deep reinforcement learning</a> 用神经网络打游戏。这篇文章，给AlphaGo提供的了新的方向</p><h2 id="强化学习——局面函数（Value-Network）"><a href="#强化学习——局面函数（Value-Network）" class="headerlink" title="强化学习——局面函数（Value Network）"></a>强化学习——局面函数（Value Network）</h2><p>强化学习（Reinforcement learning）用来实现<strong>左右互搏和自我进化</strong>，首先说说这篇论文干了一件什么事情，Deepmind团队的大牛们使用强化学习的方法在红白机上打通了200多个游戏，大多数得分都要比人好。</p><h3 id="什么是强化学习"><a href="#什么是强化学习" class="headerlink" title="什么是强化学习"></a>什么是强化学习</h3><p>那什么是强化学习呢？这里推荐莫烦大神的 <a href="https://zhuanlan.zhihu.com/p/24807239" target="_blank" rel="noopener">什么是强化学习</a> 系列教程的知乎专栏，以及另一篇<a href="http://geniferology.blogspot.hk/2015/04/what-is-reinforcement-learning.html" target="_blank" rel="noopener">强化学习指南</a> 后者对强化学习的基本概念，实现方法进行全面的讲解，含有公式推导。还有两篇我自己做的笔记，<a href="https://mubu.com/doc/WNKomuDNl" target="_blank" rel="noopener">什么是强化学习</a>，<a href="https://mubu.com/doc/2xNipOEK3l" target="_blank" rel="noopener">强化学习算法介绍</a></p><p>对于强化学习（Reinforcement learning），它是机器学习的一个分支，特别善於控制一只能够在某个环境下<strong>自主行动</strong>的个体 (autonomous <strong>agent</strong>)，透过和<strong>环境</strong>之间的互动，例如 sensory perception 和 rewards，而不断改进它的 <strong>行为</strong>。</p><p>比如，吃豆人游戏，自主行动的个体就是控制的吃豆人，环境就是迷宫，奖励就是吃到的豆子，行为就是上下左右的操作。</p><p>强化学习的输入是</p><ul><li><strong>状态</strong> (<u>S</u>tates) = 环境，例如迷宫的每一格是一个 state</li><li><strong>动作</strong> (<u>A</u>ctions) = 在每个状态下，有什么行动是容许的</li><li><strong>奖励</strong> (<u>R</u>ewards) = 进入每个状态时，能带来正面或负面的 <strong>价值</strong> (utility)</li></ul><p>输出是</p><ul><li><strong>方案</strong> (<u>P</u>olicy) = 在每个状态下，你会选择哪个行动？也是一个函数</li></ul><p>所以，我们需要根据S，A，R，来确定什么样的P是比较好的，通过不断的进行游戏，获得大量的交互数据，我们可以确定在每一个状态下，进行什么动作能获得最好的分数，而强化学习也就是利用神经网络来拟合这个过程。</p><p>例如，打砖块游戏有一个<strong>秘诀</strong>是把求打到墙后，这样球能自己反弹得分，强化学习程序在玩了600盘后，学到了这个秘诀。也就是说程序会在每一个状态下选择那个更容易把球打到墙后面去的操作。如下图，球快要把墙打穿的时候，评价函数 $v$ 的值会大幅度上升</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/RL.png" alt="打墙游戏的评价函数图" title="">                </div>                <div class="image-caption">打墙游戏的评价函数图</div>            </figure><p>我们可以发现，强化学习的基本思路和MCTS后异曲同工之妙，也是在对游戏完全没有了解的情况，通过不断的训练（进行多盘对弈，和获得进行行动后的分数反馈）来进行训练，自我提升。</p><h3 id="利用强化学习增强棋力"><a href="#利用强化学习增强棋力" class="headerlink" title="利用强化学习增强棋力"></a>利用强化学习增强棋力</h3><p>参考这种思路，<code>Aja Huang</code>给围棋也设计了一个评价函数 $v(\vec s)$ 。此函数的功能是：<strong>量化评估围棋局面</strong>。使用$v(\vec s)$可以让我们在MCTS的过程中<strong>不用走完全局</strong>（走完全盘耗时耗力，效率不高）就发现<strong>已经必败</strong>。</p><p>在利用 $P_{human}(\vec s)$ 走了开局的20步后，<strong>如果有一个 $v(\vec s_i)$ （i为当前状态）可以直接判断是否能赢，得到最后的结果<code>r</code></strong>，不需要搜索到底，可以从效率（剪枝，优化算法时间复杂度）上进一步增加MCTS的威力。</p><p>很可惜的，现有的人类棋谱不足以得出这个评价函数。所以<code>Aja Huang</code>决定用<strong>机器和机器对弈</strong>的方法来创造新的对局，也就是AlphaGo的左右互搏。</p><h3 id="自对弈"><a href="#自对弈" class="headerlink" title="自对弈"></a>自对弈</h3><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/RLArchitecture.png" alt="神经网络的训练过程和结构" title="">                </div>                <div class="image-caption">神经网络的训练过程和结构</div>            </figure><ul><li>先用 $P_{human}(\vec s)$ 和 $P_{human}(\vec s)$ 对弈，比如1万盘，得到1万个新棋谱，加入到训练集中，训练出 $P_{human-1}(\vec s)$ 。</li><li>使用$P_{human-1}(\vec s)$和$P_{human-1}(\vec s)$对弈，得到另1万个新棋谱，加入训练集，训练出$P_{human-2}(\vec s)$。</li><li>同理，进行多次的类似训练，训练出$P_{human-n}(\vec s)$，给最后的新策略命名为$P_{human-plus}(\vec s)$</li></ul><p>（感觉一下，这个$P_{human-plus}(\vec s)$ 应该挺强力的！这里回顾一下$P_{human}(\vec s)$是什么：是一个函数，$\vec a=f(\vec s)$ 可以计算出当前 $\vec s$ 下的落子 $\vec a$ 的分布概率）</p><p>使用$P_{human-plus}(\vec s)$和$P_{human}(\vec s)$进行对弈，发现$P_{human-plus}(\vec s)$胜率80%，自对弈的方法被证明是有效的。（这里有一个想法，我在之前，一直加粗随机，之所以自对弈有效，就是因为整过MCTS过程中从来没有放弃过<strong>随机</strong>，如此一来，大量的计算，就更可能覆盖到更多的可能性，对提高棋力可以产生有效的作用同时。因为概率的问题，不断的自我对弈肯定造成下棋的路数集中，后面也会有体现）</p><p>但是事实并没有那么美好，<code>Aja Huang</code>发现，使用$P_{human-plus}(\vec s)$来代替$P_{human}(\vec s)$进行MCTS反而<strong>棋力会下降</strong>。</p><p><code>Aja Huang</code>认为是$P_{human-plus}(\vec s)$走棋的路数太集中，而MCTS需要更加发散的选择才能有更好的效果。</p><h3 id="计算局部评价函数（Value-Network）"><a href="#计算局部评价函数（Value-Network）" class="headerlink" title="计算局部评价函数（Value Network）"></a>计算局部评价函数（Value Network）</h3><p>考虑到$P_{human-plus}(\vec s)$的下法太过集中，<code>Aja Huang</code>计算 $v(\vec s)$ 的策略是：</p><ul><li>开局先用$P_{human}(\vec s)$走<code>L</code>步，有利于生成更多局面</li><li>即使如此，<code>Aja Huang</code>还是觉得局面不够多样，为了进一步扩大搜索空间，在<code>L+1</code>步时，完全随机一个 $\vec a$ 落子，记下这个状态 $v(\vec s_{L+1})$ </li><li>之后使用$P_{human-plus}(\vec s)$来进行对弈，直到结束时获得结果<code>r</code>，如此不断对弈，由于<code>L</code>也是一个随机数，我们可以得到，<strong>开局、中盘、官子</strong>等不同阶段的很多局面 $\vec s$，和这些局面对应的结果<code>r</code></li><li><p>有了这些训练样本 $\langle \vec s,r\rangle$，还是使用<strong>神经网络</strong>，把最后一层改成<strong>回归</strong>而非<strong>分类</strong>（这里不是用的分类，而是用的<strong>回归，拟合</strong>），就得到了一个 $v(\vec s)$ 来输出<strong>赢棋的概率</strong></p><p><img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/Value Network.png" alt="Value Network"> </p></li></ul><p>如上图所示，$v(\vec s)$ 可以给出下一步落在棋盘上任意位置后，如果双方都用$P_{human-plus}(\vec s)$来走棋，我方赢棋的概率。实验表明，仅仅使用$P_{human}(\vec s)$来训练 $v(\vec s)$ 效果不如$P_{human-plus}(\vec s)$，强化学习是确实有效的。</p><p>总结，<strong>强化学习的$P_{human-plus}(\vec s)$主要是用来获得 $v(\vec s)$ 局部评估函数</strong>。表示的含义是</p><blockquote><p>在状态 $\vec s$ 下，<strong>局面的优劣程度，或者说此时的胜率是多少</strong></p><p> <strong>$v(\vec s)$ 局部评估函数拥有在线下不断自我进化的能力（这也是AlphaGo可以随时间越来越强的最重要的部分）</strong></p></blockquote><p>感谢你看到这里，我们已经拥有：</p><ul><li>$P_{human}(\vec s)$ <code>我的老师是人类！</code></li><li>MCTS <code>乱下，我只看输赢</code></li><li>$v(\vec s)$ <code>我能判断局势</code></li></ul><p>有了这些我们距离AlphaGo已经不远了</p><h2 id="AlphaGo"><a href="#AlphaGo" class="headerlink" title="AlphaGo"></a>AlphaGo</h2><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/MCTS.png" alt="MTCS流程图解" title="">                </div>                <div class="image-caption">MTCS流程图解</div>            </figure><p><code>Aja Huang</code>使用MCTS框架融合局面评估函数 $v(\vec s)$ 的策略是：<br><a name="3-1"></a></p><ul><li>使用$P_{human}(\vec s)$作为初始分开局，每局选择分数最高的方案落子</li><li><p>到第<code>L</code>步后，改用$P_{human-fast}(\vec s)$把剩下的棋局走完，同时调用 $v(\vec s_L)$，评估局面的获胜概率，按照如下规则更新整个树的分数<br>​<br>$$<br>\text{新分数} = \text{调整后的初始分} + 0.5*\text{通过模拟得到的赢棋概率} + 0.5*\text{局面评估分} \tag {3-1}<br>$$</p></li><li><p>前两项和原来一样</p><ul><li>如果待更新的节点就是叶子节点，局面评估分就是 $v(\vec s_L)$ </li><li>如果是待更新的节点是上级节点，局面评估分是该叶子节点 $v(\vec s)$ 的平均值</li></ul></li></ul><p>如果 $v(\vec s)$ 是表示大局观，$P_{human-fast}(\vec s)$表示快速演算，那么上面的方法就是二者的并重，并且<code>Aja Huang</code>团队已经用实验证明0.5 0.5的权重对阵其他权重有95%的胜率</p><h3 id="详解AlphaGo-VS-樊麾-对局走下某一步的计算过程"><a href="#详解AlphaGo-VS-樊麾-对局走下某一步的计算过程" class="headerlink" title="详解AlphaGo VS 樊麾 对局走下某一步的计算过程"></a>详解AlphaGo VS 樊麾 对局走下某一步的计算过程</h3><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/Result1.png" alt="详解AlphaGo走某一步棋的过程1" title="">                </div>                <div class="image-caption">详解AlphaGo走某一步棋的过程1</div>            </figure><p><code>a图</code>使用局部评估函数计算出 $\vec s$ 状态下<strong>其他落子点的胜率</strong></p><p><code>b图</code>MCTS中使用<strong>局部评估函数</strong>加 $P_{human}(\vec s)$ 得出的结果</p><p><code>c图</code>MCTS中使用$P_{human}(\vec s)$（复合算法）和$P_{human-fast}(\vec s)$走子走到底的结果</p><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/Result2.png" alt="详解AlphaGo走某一步棋的过程2" title="">                </div>                <div class="image-caption">详解AlphaGo走某一步棋的过程2</div>            </figure><p><code>d图</code>深度卷积神经网络使用<strong>策略函数</strong>计算出来的结果</p><p><code>e图</code>使用<a href="#3-1">公式3-1</a>和相关流程计算出的落子概率</p><p><code>f图</code>演示了AlphaGo和樊麾对弈的计算过程，AlphaGo执黑，樊麾执白。红圈是AlphaGo实际落子额地方。1，2，3和后面的数字表示他想象中的之后樊麾下一步落子的地方。<strong>白色方框</strong>是樊麾的实际落子。在复盘时，樊麾认为1的走法更好（这说明在樊麾落子后AlphaGo也在进行计算）</p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>由于<strong>状态数有限</strong>和<strong>不存在随机性</strong>，象棋和五子棋这类游戏理论上可以由终局自底向上的推算出每一个局面的胜负情况，从而得到最优策略。例如五子棋就被验证为<strong>先手必胜</strong>。</p><p>AlphaGo的MCTS属于<strong>启发式搜索算法</strong></p><blockquote><p>启发式搜索算法：由当前局面开始，尝试看起来<u>可靠的行动</u>，达到终局或一定步数后停止，根据后续<u>局面的优劣</u>反馈，选择最有行动。通俗来说，就是”手下一招子，心想三步棋“</p></blockquote><p>围棋是一个NP问题，要穷举的话，解空间巨大。现代优化算法的经典之处在于，从围棋的规则来看，在某一个状态，必定有一个或几个较优解，整个AlphaGo就是想方设法的去找这个较优解。<strong>利用局面评估函数来对MCTS进行剪枝的思路十分精彩</strong>。利用上面的3个算法，结合庞大的并行运算能力，还有<code>Aja Huang</code>团队的辛苦付出，造就了AlphaGo的奇迹。</p><h2 id="使用不同组件AlphGo1-0的棋力"><a href="#使用不同组件AlphGo1-0的棋力" class="headerlink" title="使用不同组件AlphGo1.0的棋力"></a>使用不同组件AlphGo1.0的棋力</h2><figure class="image-bubble">                <div class="img-lightbox">                    <div class="overlay"></div>                    <img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/Result.png" alt="最终棋力结果" title="">                </div>                <div class="image-caption">最终棋力结果</div>            </figure><p>上图显示了各种算法的棋力，Rollout是走棋演算，也就是<code>MCTS</code>，Value Network是 $v(\vec s)$ 局面评估函数，Policy Network 是结合$P_{human-plus}(\vec s)$和$P_{human}(\vec s)$后计算的策略函数（下一步走在哪里胜率高的深度卷积神经网络）</p><p>整个AlphaGo使用的技术，深度卷积网络，强化学习神经网络，都是炙手可热的领域，近年来发展迅猛，日新月异。AlphaGo已经完成了自己历史使命，<strong>借助棋类的巅峰【围棋】为叩门砖打开了机器学习自我进化的大门</strong></p><h2 id="李世石-VS-AlphaGo-1-0——第四局78手挖"><a href="#李世石-VS-AlphaGo-1-0——第四局78手挖" class="headerlink" title="李世石 VS AlphaGo 1.0——第四局78手挖"></a>李世石 VS AlphaGo 1.0——第四局78手挖</h2><p><img src="//charlesliuyx.github.io/2017/05/27/AlphaGo运行原理解析/78.png" width="400" align="center" alt="78"></p><p>赛后AlphaGo之父给出的关键信息：<code>李世石78手“挖”是AlphaGo认为概率极小的点</code>，这一手之后导致的状态 $\vec s$ 进入到了AlphaGo能处理的范围之外，即之前AlphaGo的<strong>自对弈</strong>都是建立用自己觉得好的下法来搜索的，那么如果这一手AlphaGo1.0感觉可能性极小，那么用$P_{human}(\vec s)$自对弈的棋谱中就更加难以覆盖。</p><p>但是也需要提到的是，根据比赛中柯洁等人的观战我们知道，如果不是后面AlphaGo进入了混乱模式，78手不一定是一个好棋。只能说这一手，顶到了AlphaGo的软肋，在真正和人的对局中不一定是“神之一手”</p><p>根据Deepmind团队给出的数据可以知道，一年前，AphaGo1.0的搜索空间，自对弈深度并不完美。所以Deepmind团队有意的在<strong>代码逻辑</strong>上让其<strong>避免打劫</strong>，或者说避免<strong>劫争</strong>，例如，有两个选择，一个胜率60%但需要打劫，另一个55%但不需要打劫，AlphaGo1.0会选择后者。</p><p>那么什么是打劫呢？解释这几个和”劫“有关的围棋术语是：</p><p><code>打劫</code>围棋术语，一方制造事端，和另一方讨价还价的行为。<br><code>劫材</code>可以用来做价格谈判的筹码。通常是走一手没戏，但对手若不予置理，再走第二手会出棋的局部。<br><code>寻劫</code>通过目数计算，寻找一些有价值的局部制造事端强迫对手应答。通常价值至少需要和打劫的地方相当或者小不太多，否则对方很容易消劫。<br><code>利用劫</code>劫胜可杀死对方或者得到利益，劫败也应该让对方付出代价，除非双方劫材大小和数量相差悬殊。</p><p>通俗的说是，我在这一片已经处于劣势，我换一个战场，发动进攻，你应不应？可能在另外战场的角力中对这边战场的局势产生影响。可以类比于，五子棋中的冲四。</p><p>如果有人观看了这一盘棋，我们也可以听到柯洁在强调，AlphaGo在避免打劫，出现了几手莫名其妙的落子。</p><p><strong>总结来说，AlphaGo依靠的是对局外的大量计算，无论是局部评估函数，还是$P_{human-plus}(\vec s)$都十分依赖<font color="#FF0000">对局外</font>的大量的计算。</strong>随着时间的推移，AlphaGo在对局过程需要的时间越来越固定，不需要在对局时进行太多的MCTS搜索就能获得AlphaGo的下一手位置，可以预见，MCTS的搜索深度不会太深。当计算量十分庞大的时候，依赖更多是那个120层的Policy Network。</p><p>从柯洁的第二盘可以发现，他已经努力的制造在中腹引入多方战斗的带劫争的复杂棋局，十分精彩。可惜，AlphaGo2.0貌似已经完善了自己的阿特留斯之踵。当真无敌，说到这里，我们来谈谈AlphaGo2.0</p><h2 id="AlphaGo-2-0-VS-柯洁——虽败犹荣"><a href="#AlphaGo-2-0-VS-柯洁——虽败犹荣" class="headerlink" title="AlphaGo 2.0 VS 柯洁——虽败犹荣"></a>AlphaGo 2.0 VS 柯洁——虽败犹荣</h2><p>三盘对局，感觉到AlphaGo在这一年内进行了极为深度的训练。最可怕的是AlphaGo通过时间<strong>验证了机器学习对于解决NP问题的强大潜力</strong>（通过这三盘可以看出已经无限接近解决了这个问题，至少在对人类上）。甚至：</p><ul><li>臆想一，是否可以利用AlphaGo来<strong>判断规则是否公平</strong>（中国和韩日规则的不同，7目半和6目半）。</li><li>臆想二，最终AlphaGo的自对弈是接近和棋。可惜AlphaGo已经退役。希望针对Deepmind放出的50盘自对弈棋谱可以研究出一些门道，使得围棋这门竞技本身有更大的突破。</li></ul><p><strong>局面函数</strong>和<strong>策略函数</strong>愈发强大，愈加的接近于”围棋之神“。</p><p>随着Google TPU的发布，跑在<code>TPU阵列</code>上的AlphaGo如虎添翼，MCTS的走子演算效率更高，速度更快（加速的其实就是$P_{human-plus}(\vec s)$的落子速度。</p><p>关于TPU的设计思路和原理可以参考 <a href="https://arxiv.org/pdf/1704.04760.pdf" target="_blank" rel="noopener">In-Datacenter Performance Analysis of a Tensor Processor</a></p><p>对于围棋这个策略单步游戏，是存在<strong>N步最优解</strong>（不存在<code>i+1</code>步最优解），AlphaGo已经在正确的道路上无限的接近于这个<strong>N步最优解</strong>，仿佛在某一步已经看到了你无论怎么下都能走到的N步最优解。</p><p>人类的每一次失误都会使局部评估函数往胜率移动一点，这一点是十分可怕的，因为算法本身的优越性，<strong>大局观</strong>对于AlphaGo的逻辑来说本身就是一种刻在骨子里的基因</p><ul><li>一是因为AlphaGo每次MCTS计算都会计算到接近分出胜负，具有<strong>前瞻性</strong></li><li>二是因为局面函数本身就是为了来统计大局形势定义的，具有<strong>判断局面优劣</strong>的能力</li></ul><p>所谓大局观，不就是这种<strong>走一步看N步的能力</strong>嘛。</p><h2 id="对未来的展望——从AlphaGo想开去"><a href="#对未来的展望——从AlphaGo想开去" class="headerlink" title="对未来的展望——从AlphaGo想开去"></a>对未来的展望——从AlphaGo想开去</h2><p>珍贵的并不是攻克了围棋问题本身，<strong>而是这种解决问题的基本模式</strong>，可以推而广之到很多领域。</p><p>先通过卷积网络学习人类的下法，算出策略函数（Policy Network），再通过<strong>模仿</strong>进行强化学习，左右互搏，不断自我进化，再加上MCTS的经典的解决问题的启发式搜索算法。</p><blockquote><p>这俨然是一个 <strong>模仿➜学习➜优化</strong>的过程</p></blockquote><p>或许，模仿人类，是机器学习最终的归途，至于应用领域方面</p><p>游戏AI是一个最容易想到的领域，只要能抽象出 <code>State</code> <code>Action</code> <code>Judgement</code>，那么这一套解决问题的方式就可以举一反三，让每一个1V1领域的游戏AI非常强大（OpenAI在Dota2 1V1 Solo上的结果更加证明了这一点），至于合作领域的AI可能需要更大的计算量去计算（OpenAI发布的论文<a href="https://blog.openai.com/learning-to-cooperate-compete-and-communicate/" target="_blank" rel="noopener">MultiAgent</a>很有启发性），对于实际问题来说获得这样的AI有多大的经济价值值得推敲。</p><p>游戏的乐趣就在于<strong>不确定性</strong>，适当的失误也是竞技类游戏的魅力所在，一个能看到<strong>N步最优解</strong>的AI会让一个游戏机制，游戏规则变得可数据化，这一点其实是游戏被创造出来的初衷相背离的。</p><p>其他方面，只要是人类可以学习出来的事物，比如翻译，编程，都是现在的这套体系可能解决的问题，我们期待未来这套<strong>解决问题的方法发挥出无穷的力量</strong>吧！</p><p>[Reference]<br>知乎<a href="https://www.zhihu.com/question/41176911" target="_blank" rel="noopener">Tao Lei大神的回答</a><br>知乎<a href="https://www.zhihu.com/question/41176911" target="_blank" rel="noopener">袁行远大神的回答</a><br>知乎<a href="https://www.zhihu.com/question/28655005/answer/61142081" target="_blank" rel="noopener">有关围棋打劫的回答</a><br>其他文章中引用的论文，链接已经给出</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读时间】15min 8506 words&lt;br&gt;【阅读内容】针对论文AlphaGo第一版本，进行了详细的说明和分析，力求用通俗移动的语言让读者明白：AlphaGo是如何下棋的&lt;/p&gt;
    
    </summary>
    
      <category term="Machine Learning" scheme="https://charlesliuyx.github.io/categories/Machine-Learning/"/>
    
    
      <category term="CNN" scheme="https://charlesliuyx.github.io/tags/CNN/"/>
    
      <category term="AlphaGo" scheme="https://charlesliuyx.github.io/tags/AlphaGo/"/>
    
      <category term="MCTS" scheme="https://charlesliuyx.github.io/tags/MCTS/"/>
    
      <category term="Deep Learning" scheme="https://charlesliuyx.github.io/tags/Deep-Learning/"/>
    
  </entry>
  
  <entry>
    <title>【摘抄】清欢 - 林清玄</title>
    <link href="https://charlesliuyx.github.io/2017/05/14/%E6%B8%85%E6%AC%A2/"/>
    <id>https://charlesliuyx.github.io/2017/05/14/清欢/</id>
    <published>2017-05-14T01:26:55.000Z</published>
    <updated>2018-03-03T22:26:28.369Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读内容】个人摘抄，林清玄散文（非常喜欢的散文家）</p><a id="more"></a><h2 id="1"><a href="#1" class="headerlink" title="1"></a>1</h2><p>少年时代读到苏轼的一阕词，非常喜欢，到现在还能背诵：</p><blockquote><p>细雨斜风作晓寒，淡烟疏柳媚晴滩，入淮清洛渐漫漫。<br>雪沫乳花浮午盏，蓼茸蒿笋试春盘，人间有味是清欢。</p></blockquote><!-- more --><p>这阕词，苏轼在旁边写着“元丰七年十二月二十四日，从泗州刘倩叔游南山”，原来是苏轼和朋友到郊外去玩，在南山里喝了浮着雪沫乳花的淡茶，配着春日山野里的蓼菜、茼蒿、新笋，以及野草的嫩芽等等，然后自己赞叹着：“人间有味是清欢！”</p><p>当时所以能深记这阕词，最主要的是爱极了后面这一句，因为试吃野菜的这种平凡的清欢，才使人间更有滋味。<strong>“清欢”是什么呢？清欢几乎是难以翻译的，可以说是“清淡的欢愉”，这种清淡的欢愉不是来自别处，正是来自对平静疏淡简朴生活的一种热爱。当一个人可以品味出野菜的清香胜过了山珍海味，或者一个人在路边的石头里看出了比钻石更引人的滋味，或者一个人听林间鸟鸣的声音感受到比提笼遛鸟更感动，或者体会了静静品一壶乌龙茶比起在喧闹的晚宴中更能清洗心灵……这些就是“清欢”。</strong></p><p>清欢之所以好，是因为它对生活的无求，是它不讲求物质的条件，只讲究心灵的品味。“清欢”的境界很高，它不同于李白的<code>人生在世不称意，明朝散发弄扁舟</code>那样的自我放逐；或者<code>人生得意须尽欢，莫使金樽空对月</code>那种尽情的欢乐。它也不同于杜甫的<code>人生有情泪沾臆，江水江花岂终极</code>这样悲痛的心事，或者<code>人生不相见，动如参与商；今夕复何夕，共此灯烛光</code>那种无奈的感叹。</p><p>活在这个世界上，有千百种人生，文天祥的是<code>人生自古谁无死，留取丹心照汗青</code>，我们很容易体会到他的壮怀激烈。欧阳修的是<code>人生自是有情痴，此恨不关风与月</code>，我们很能体会到他的绵绵情恨。纳兰性德的是<code>人到情多情转薄，而今真个不多情</code>，我们也不难会意到他无奈的哀伤。甚至于像王国维的<code>人生只似风前絮，欢也零星，悲也零星，都作连江点点萍！</code>那种对人生无常所发出的刻骨的感触，也依然能够知悉。</p><h2 id="2"><a href="#2" class="headerlink" title="2"></a>2</h2><p>可是“清欢”就难了！</p><p>尤其是生活在现代的人，差不多是没有清欢的。</p><p>什么样是清欢呢？我们想在路边好好的散个步，可是人声车声不断的呼吼而过，一天里，几乎没有纯然安静的一刻。</p><p>我们到馆子里，想要吃一些清淡的小菜，几乎是<strong>杳不可得</strong>，过多的油、过多的酱、过多的盐和味精已经成为中国菜最大的特色，有时害怕了那样的油腻，特别嘱咐厨子白煮一个菜，菜端出来时让人吓一跳，因为菜上挤的色拉比菜还多。</p><p>有时没有什么事，心情上只适合和朋友去<strong>啜一盅茶</strong>、饮一杯咖啡，可惜的是，心情也有了，朋友也有了，就是找不到地方，有茶有咖啡的地方总是嘈杂的。</p><p>俗世里没有清欢了，那么到山里去吧！到海边去吧！但是，<strong>山边和海湄</strong>也不纯净了，凡是人的足迹可以到的地方，就有了垃圾，就有了臭秽，就有了吵闹！</p><p>有几个地方我以前常去的，像阳明山的白云山庄，叫一壶兰花茶，俯望着台北盆地里堆叠着的高楼与人欲，自己饮着茶，可以品到茶中有清欢。像在北投和阳明山间的山路边有一个小湖，湖畔有小贩卖工夫茶，小小的茶几、藤制的躺椅，独自开车去，走过石板的小路，叫一壶茶，在躺椅上静静的靠着，有时湖中的荷花开了，<strong>真是惊艳一山的沉默</strong>。有一次和朋友去，在躺椅上静静喝茶，一下午竟说不到几句话，那时我想，这大概是“人间有味是清欢”了。</p><p>现在这两个地方也不能去了，去了只有伤心。湖里的不是荷花了，是飘荡着的汽水罐子，池畔也无法静静躺着，因为人比草多，石板也被踏损了。到假日的时候，走路都很难不和别人推挤，更别说坐下来喝口茶，如果运气更坏，会遇到呼啸而过的飞车党，还有带伴唱机来跳舞的青年，那时所有的感官全部电路走火，不要说清欢，连欢也不剩了。</p><p>要找清欢，一日比一日更困难了。</p><p>当学生的时候，有一位朋友住在中和圆通寺的山下，我常常坐着颠踬的公交车去找她，两个人沿着上山的石阶，漫无速度的，走走、坐坐、停停、看看，那时圆通寺山道石阶的两旁，杂乱的长着朱槿花，我们一路走，顺手拈下一朵熟透的朱槿花，吸着花朵底部的花露，其甜如蜜，而清香胜蜜，轻轻的含着一朵花的滋味，<strong>心里遂有一种只有春天才会有的欢愉</strong>。</p><h2 id="3"><a href="#3" class="headerlink" title="3"></a>3</h2><p>圆通寺是一座全由坚固的石头砌成的寺院，那些黑而坚强的石头坐在山里仿佛一座不朽的城堡，绿树掩映，清风徐徐，站在用石板铺成的前院里，看着正在生长的小市镇，那时的寺院是澄明而安静的，让人感觉走了那样高的山路，能在那平台上看着远方，就是人生里的清欢了。</p><p>后来，朋友嫁人，到国外去了。我去过一趟圆通寺，山道已经开辟出来，车子可以环山而上，小山路已经很少人走，就在寺院的门口摆着满满的摊贩，有一摊是儿童乘坐的机器马，叽哩咕噜的童歌震撼半山，有两摊是打香肠的摊子，烤烘香肠的白烟正往那古寺的大佛飘去，有一位母亲因为不准孩子吃香肠而揍打着两个孩子，激烈的哭声尖亢而急促……我连圆通寺的寺门都没有进去，就沉默的转身离开，山还是原来的山，寺还是原来的寺，为什么感觉完全不同了，失去了什么吗？失去的正是清欢。</p><p>下山时的心情是不堪的，想到星散的朋友，心情也不是悲伤，只是惆怅，浮起的是一阕词和一首诗，词是李煜的：<code>高楼谁与上？长记秋晴望。往事已成空，还如一梦中！</code>诗是李觏的：<code>人言落日是天涯，望极天涯不见家；已恨碧山相阻隔，碧山还被暮云遮！</code>那时正是黄昏，在都市烟尘蒙蔽了的落日中，真的看到了一种悲剧似的橙色。</p><p>我二十岁心情很坏的时候，就跑到青年公园对面的骑马场去骑马，那些马虽然因驯服而动作缓慢，却都年轻高大，有着光滑的毛色。双腿用力一夹，它也会如箭一般呼噜向前窜去，急忙的风声就从两耳掠过，我最记得的是马跑的时候，迅速移动着的草的青色，青茸茸的，仿佛饱含生命的汁液，跑了几圈下来，一切恶的心情也就在风中、在绿草里、在马的呼啸中消散了。</p><p>尤其是冬日的早晨，勒着绳，马就立在当地，踢踏着长腿，鼻孔中冒着一缕缕的白气，那些气可以久久不散，当马的气息在空气中消弭的时候，人也好像得到某些舒放了。</p><p>骑完马，到青年公园去散步，走到成行的树荫下，冷而强悍的空气在林间流荡，可以放纵的、深深的呼吸，品味着空气里所含的元素，那元素不是别的，正是清欢。</p><h2 id="4"><a href="#4" class="headerlink" title="4"></a>4</h2><p>最近有一天，突然想到骑马，已经有十几年没骑了。到青年公园的骑马场时差一点吓昏，原来偌大的马场已经没有一根草了，一根草也没有的马场大概只有台湾才有，马跑起来的时候，灰尘滚滚，弥漫在空气里的尽是令人窒息的黄土，蒙蔽了人的眼睛。马也老了，毛色斑剥而失去光泽。</p><p>最可怕的是，不知道什么时候在马场搭了一个塑料棚子，铺了水泥地，其丑无比，里面则摆满了机器的小马，让人骑用，其吵无比。为什么为了些微的小利，而牺牲了这个马场呢？</p><p>马会老是我知道的事，人会转变是我知道的事，而在有真马的地方放机器马，在马跑的地方没有一株草，则是我不能理解的事。</p><p>就在马场对面的青年公园，已经不能说是公园了，人比西门町还拥挤吵闹，空气比咖啡馆还坏，树也萎了，草也黄了，阳光也不灿烂了。从公园穿越过去，想到少年时代的这个公园，心痛如绞，别说清欢了，简直像极了佛经所说的“<strong>五浊恶世</strong>”！</p><p>生在这个时代，为何“清欢”如此难觅。眼要清欢，找不到青山绿水；耳要清欢，找不到宁静和谐；鼻要清欢，找不到干净空气；舌要清欢，找不到蓼茸蒿笋；身要清欢，找不到清凉净土；意要清欢，找不到<strong>智慧明心</strong>。如果要享受清欢，唯一的方法是守在自己小小的天地，洗涤自己的心灵，因为在我们拥有愈多的物质世界，我们的清淡的欢愉就日渐失去了。</p><p>现代人的欢乐，是到<strong>油烟爆起、卫生堪虑</strong>的啤酒屋去吃炒蟋蟀；是到黑天暗地、不见天日的卡拉OK去乱唱一气；是到乡村野店、胡乱搭成的土鸡山庄去豪饮一番；以及到狭小的房间里做方城之戏，永远重复着摸牌的一个动作……这些放逸的生活以为是欢乐，想起来<strong>毋宁</strong>是可悲的。为什么现代人不能过清欢的生活，反而以浊为欢，以清为苦呢？</p><p>一个人以浊为欢的时候，就很难体会到生命清明的滋味，而在欢乐已尽、浊心再起的时候，人间就愈来愈无味了。</p><h2 id="5"><a href="#5" class="headerlink" title="5"></a>5</h2><p>这使我想起东坡的另一首诗来：</p><blockquote><p>梨花淡白柳深青，柳絮飞时花满城；<br>惆怅东栏一株雪，人生看得几清明？</p></blockquote><p>苏轼凭着东栏看着栏杆外的梨花，满城都飞着柳絮时，梨花也开了遍地，东栏的那株梨花却从深青的柳树间伸了出来，仿佛雪一样的清丽，有一种惆怅之美，但是人生看这么清明可喜的梨花能有几回呢？这正是千古风流人物的性情，这正是清朝大画家盛大士在《溪山卧游录》中说的<code>凡人多熟一分世故，即多一分机智。多一分机智，即少却一分高雅。</code> 也有说<code>山中何所有？岭上多白云，只可自怡悦，不堪持赠君，自是第一流人物。</code></p><p>第一流人物是什么人物？</p><p>第一流人物是在<span style="color:red">清欢里也能体会人间有味</span>的人物！</p><p>第一流人物是<span style="color:red">在污浊滔滔的人间，也能找到清欢的人物！</span></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读内容】个人摘抄，林清玄散文（非常喜欢的散文家）&lt;/p&gt;
    
    </summary>
    
      <category term="Article" scheme="https://charlesliuyx.github.io/categories/Article/"/>
    
    
      <category term="Article" scheme="https://charlesliuyx.github.io/tags/Article/"/>
    
      <category term="Literature" scheme="https://charlesliuyx.github.io/tags/Literature/"/>
    
  </entry>
  
  <entry>
    <title>English-abbreviation</title>
    <link href="https://charlesliuyx.github.io/2017/05/13/English-abbreviation/"/>
    <id>https://charlesliuyx.github.io/2017/05/13/English-abbreviation/</id>
    <published>2017-05-13T09:29:00.000Z</published>
    <updated>2017-10-06T01:41:05.081Z</updated>
    
    <content type="html"><![CDATA[<p>一些常用的英语缩写的总结</p><a id="more"></a><h2 id="日常生活篇"><a href="#日常生活篇" class="headerlink" title="日常生活篇"></a>日常生活篇</h2><ol><li><code>R.S.V.P</code>: 源自于法语‘Répondez s’il vous plait’，英文解释为’Respond,if you please’.邀请函结尾写这个，表示‘敬请回复’；</li><li><code>P.S</code>: 意思是‘post script’,表示‘再多说一句’，一般写完要说的话之后结尾突然想起说什么可以写；</li><li><code>ASAP</code>: as soon as possible. 表示‘尽快’，注意听音频发音，可读成A-SAP;</li><li><code>ETA</code>: estimated time of arrival. 表示‘预计到达时间’；</li><li><code>BYOB</code>: bring your own bottle; 表示‘自带酒水，举办派对时常用’</li></ol><h2 id="吃饭做菜篇"><a href="#吃饭做菜篇" class="headerlink" title="吃饭做菜篇"></a>吃饭做菜篇</h2><ol><li><code>tsp or t</code> : teaspoon 一茶匙</li><li><code>tbs / tbsp/ T</code>: tablespoon 一汤匙</li><li><code>c</code>: cup 一杯</li><li><code>gal</code>: gallon 加仑</li><li><code>lb</code> : pound 磅</li><li><code>pt</code>：pint 品脱</li><li><code>qt</code>: quart 夸脱</li></ol><h2 id="出国地图篇"><a href="#出国地图篇" class="headerlink" title="出国地图篇"></a>出国地图篇</h2><ol><li><code>Ave</code>: avenue 大街</li><li><code>Blvd</code>: boulevard 大道</li><li><code>Ln</code>: lane 车道</li><li><code>Rd</code>: road 公路</li><li><code>St</code>: street 街道</li></ol><h2 id="教育工作篇"><a href="#教育工作篇" class="headerlink" title="教育工作篇"></a>教育工作篇</h2><ol><li><code>BA</code>: Bachelor of Arts 文学士</li><li><code>BS</code>: Bachelor of Science 理学士</li><li><code>MA</code>: Master of Arts 文科硕士</li><li><code>PA</code>: Personal Assistant 私人助理</li><li><code>VP</code>: Vice President 副总统;副总裁</li><li><code>CEO</code>: Chief Executive Officer 首席执行官</li><li><code>CFO</code>: Chief Financial Officer 首席财务官</li><li><code>COO</code>: Chief Operating Officer 首席运营官</li><li><code>CMO</code>: Chief Marketing Officer 首席营销官</li></ol><h2 id="社交聊天篇"><a href="#社交聊天篇" class="headerlink" title="社交聊天篇"></a>社交聊天篇</h2><ol><li><code>JK</code> :just kidding 跟你开玩笑呢</li><li><code>TBD</code>: to be determined 待定</li><li><code>AFAIK</code>: as far as I know 据我所知</li><li><code>BRB</code>: be right back 马上回来</li><li><code>CUL</code>: see you later 回见</li><li><code>TTYL</code>: talk to you later 回聊</li><li><code>CWYL</code>: chat with you later 回聊</li><li><code>LOL</code>: laugh out loud 哈哈</li><li><code>LMAO</code>: laugh my ass off 笑死我了</li><li><code>ROTFL/ ROFL</code>: rolling on the floor laughing 笑到在地上打滚</li><li><code>NP</code>: no problem 没问题,没关系,不客气</li><li><code>IDK</code>: I don’t know 我不知道</li><li><code>ILY</code>: I love you 我爱你</li><li><code>TMI</code>: too much information 信息量太大了； 说的太多了</li><li><code>OIC</code>: Oh, I see. 我明白了</li><li><code>FYI</code>: for your information 顺便告知你</li><li><code>BTW</code>: by the way 顺便说一下 顺便问一下</li><li><code>MYOB</code>: mind your own business 别多管闲事</li><li><code>FAQ</code>: frequently asked questions 经常被问的问题<br>20: <code>WTF</code>: what the fuck 搞毛阿…… 委婉的是WTH: what the hell/heck<br>21: <code>AKA</code>: also known as. 也叫做</li><li><code>TGIF</code>: thank god It’s Friday 谢天谢地又到礼拜五了</li><li><code>TBC</code>: to be continued; to be confirmed 未完待续/ 有待确认</li></ol><h2 id="数字字母篇"><a href="#数字字母篇" class="headerlink" title="数字字母篇"></a>数字字母篇</h2><p><code>2</code>: to/too<br><code>4</code>: for<br><code>B</code>: be<br><code>C</code>: see<br><code>I</code>: eye<br><code>O</code>: owe;<br><code>R</code>: are;<br><code>U</code>: you;<br><code>ur</code>: your/you’re<br><code>Y</code>: why</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;一些常用的英语缩写的总结&lt;/p&gt;
    
    </summary>
    
      <category term="Presentation" scheme="https://charlesliuyx.github.io/categories/Presentation/"/>
    
    
      <category term="Wiki" scheme="https://charlesliuyx.github.io/tags/Wiki/"/>
    
      <category term="English" scheme="https://charlesliuyx.github.io/tags/English/"/>
    
  </entry>
  
  <entry>
    <title>【原创】有关中国诗的那些事</title>
    <link href="https://charlesliuyx.github.io/2017/05/13/%E6%9C%89%E5%85%B3%E4%B8%AD%E5%9B%BD%E8%AF%97%E7%9A%84%E9%82%A3%E4%BA%9B%E4%BA%8B/"/>
    <id>https://charlesliuyx.github.io/2017/05/13/有关中国诗的那些事/</id>
    <published>2017-05-13T08:40:00.000Z</published>
    <updated>2018-03-03T22:27:28.149Z</updated>
    
    <content type="html"><![CDATA[<p>【阅读内容】个人高三作文水平巅峰时期写下的有关中国诗的散文一篇，献丑献丑</p><a id="more"></a><p>没有沉淀，文字永远上不了档次。难得空闲，读了些诗，有些感受。</p><h3 id="韦应物"><a href="#韦应物" class="headerlink" title="韦应物"></a>韦应物</h3><blockquote><p>独怜幽草涧边生，上有黄鹂深树鸣。春潮带雨晚来急，野渡无人舟自横。</p></blockquote><p>记起这《滁州西涧》，听过一个故事。话说一次国画比赛，题目是以<code>春潮带雨晚来急，野渡无人舟自横</code>这句诗作画。国学博大精深，国画作为其中一支配起诗来，别有遐想。此题甚好，不仅考及画技，更有对国学中诗词的体悟和见解。大家不妨也想想如果是你，你会怎么画？这里先卖个关子。</p><p>从诗的字面来说，是这样一种通感：春天近了，潮气依稀可嗅。但谁能像你这样，对一棵在水边生长的小草也充满爱怜？黄鹂在密林深处的低语你都能听到？这需要多么细腻的一颗心。华灯初上，渡口上已经没有人，舟独自横于水上，那是一种空阔的感觉。映照你一生步履，你的细腻出于岁月。你当年49岁，50载，可能不长，但是我知道你的与众不同，你的50载甚至顶得别人几辈子。</p><p>韦应物年少荒唐，并未认真读书。安史乱起，韦应物扈从不及，流落秦中。乱后，韦应物折节读书，痛改前非，从一个富贵无赖纨绔一变而为忠厚仁爱的儒者。有些官运，在地方（苏州）任官。韦应物勤于吏职，简政爱民，在苏州刺史届满之后，一贫如洗，寄居无定寺，客死他乡。 享年五十五岁。</p><p>别人些许看出的是你不在其位，不得其用的无奈，忧伤。但我看到的，更多是你的豁达，你心中总是美好多于忧伤。</p><p>通往远方的路，没有哪条是你不能走的；走在路上的人，没有谁是你不能结交的；结交的朋友，没有谁是你不能推心置腹的。虽然那个时代远没有现在的复杂，但是能捧出一颗完整的心也并不是一件容易的事。韦苏州，你是一个充满诗情的人。</p><p>回头看看开头提到的国画比赛优胜者的作品：弥蒙的雾气用模糊的淡墨衬托，远处的群山，夕阳露出半个头。远远的有几簇灯火，近处，一条小舟在几根芦苇中飘荡，船上有位着布衣的蓑翁，嘴里叼根芦苇，帽檐下压，不知是否在闭目养神，两只杜鹃立于船头。起初不懂，“无人”的野渡为何有人呢？其中深意，结合了韦苏州的履历才恍然大悟。</p><p>“无人”并不是一只孤舟。韦应物闲居，船上舟子，好似当时的韦应物，在船头打盹，闻着草香，听着鹂鸣。韦应物虽然赋闲苏州，但他并不排斥官场，若有机会，他还是会出仕，只是满足于闲暇。无奈忧伤可能有，但经历了顽劣，奋起，战乱，官场，贬谪，闲居的韦应物，更多的，是看破人生的豁达和满足。</p><h3 id="李白"><a href="#李白" class="headerlink" title="李白"></a>李白</h3><p>总觉中国诗总离不开一个“愁”字。思乡，思亲，忧国，羁旅等等，都和“愁”万缕千丝。我爱这些无奈，悲壮，不舍，甚至愤懑，嘲讽。他们仿佛缩影了人生，视角令人称奇，细腻的令你悸动。</p><p><strong>抽刀断水，是最无奈的神话；举杯消愁，是最动情的悲歌。</strong>李白潇洒一生，他豪放，甚至一直清贫，有了几个钱，就豪饮一番，将诗情挥洒，更是对“愁”下了如此入理的定义。</p><p><code>拣尽寒枝不肯栖，寂寞沙洲岭</code>李白就犹如谪仙，似乎从来没有受过来自这个世界的温暖。于是，在静夜里，李白写下了<code>床前明月光，疑是地上霜。举头望明月，低头思故乡</code>的千古“愁”词。可是李白的故乡在哪里呢？是陇西？是巴蜀？月华似霜的夜，浪迹天涯的游子李白在梦幻中寻觅故乡，但故乡却比梦幻更飘渺。</p><p>李白是复杂的，李白糅合着道家的“出世”和儒家的“入世”思想。所以，顺境时，他<code>仰天大笑出门去，我辈岂是蓬蒿人</code>的潇洒豪情；逆境时，他有<code>弃我去者昨日之日不可留，乱我心者今日之日多烦忧</code>的绵绵愁绪。   </p><h3 id="那些诗人"><a href="#那些诗人" class="headerlink" title="那些诗人"></a>那些诗人</h3><p>感动于张谓笔下早梅傲雪<code>不知近水花先发，疑是经冬雪未消</code>的玄妙；<br>陶醉于贺铸风中<code>一川烟草，满城风絮，梅子黄时雨</code>的飘愁；<br>哀婉于苏轼眼中<code>细看来，不是杨花，点点是，离人泪</code>的破碎。</p><p>说起苏东坡，一个传奇。</p><p><code>人生如梦</code>，东坡曾经迷惘过；<code>早生华发</code>，东坡曾经惋惜过；<code>十年生死两茫茫</code>，东坡曾经痛苦过。但他不屈，他平和，他豁达。</p><p><code>一蓑烟雨任平生</code>，他淡泊；<code>日啖荔枝三百颗，不辞长作岭南人</code>，他自定；<code>踏雪飞鸿</code>，他淡然。<code>问汝平生功业，黄州惠州儋州</code>，三贬之地，还恰恰就是他留下许多不朽之作的地方。</p><p>读着这些诗，深深思索，你会感到作为一个中国人学会了中文，有着五千年的浩瀚历史文化，是多么令你振奋和自豪；国学，遗留的东西，值得我们用一生去参悟。常说高考诗词理解令人头痛，如果怀着这样的心情读诗，你还会怕吗？</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;【阅读内容】个人高三作文水平巅峰时期写下的有关中国诗的散文一篇，献丑献丑&lt;/p&gt;
    
    </summary>
    
      <category term="Presentation" scheme="https://charlesliuyx.github.io/categories/Presentation/"/>
    
    
      <category term="Article" scheme="https://charlesliuyx.github.io/tags/Article/"/>
    
      <category term="Original" scheme="https://charlesliuyx.github.io/tags/Original/"/>
    
  </entry>
  
</feed>